

La esencia de la historia sobre el gestor de paquetes más popular para Kubernetes podría representarse con emojis:
- caja — esto es Helm (es lo más adecuado que hay en la última versión de Emoji);
- candado — seguridad;
- muñeco — solución del problema.
Sin embargo, en realidad, todo será un poco más complicado, y la historia está llena de detalles técnicos sobre cómo hacer Helm seguro.
- En resumen, qué es Helm, si no lo sabías o lo olvidaste. Qué problemas resuelve y dónde se encuentra en el ecosistema.
- Veamos la arquitectura de Helm. Ninguna conversación sobre seguridad y cómo hacer una herramienta o solución más segura puede hacerse sin comprender la arquitectura del componente.
- Discutiremos los componentes de Helm.
- La cuestión más apremiante — el futuro — la nueva versión Helm 3.
Todo en este artículo se refiere a Helm 2. Esta versión actualmente se encuentra en producción y, lo más probable, es la que estás utilizando ahora, y en la que existen amenazas de seguridad.
Sobre el ponente: Alexander Khayorov () tiene 10 años de experiencia en desarrollo, ayuda a mejorar el contenido y se unió al comité . Actualmente trabaja en Chainstack como líder de desarrollo — es un híbrido entre un jefe de desarrollo y una persona responsable de la entrega de versiones finales. Es decir, está en el campo de batalla, donde ocurre todo, desde la creación del producto hasta su operación.
Chainstack — una pequeña startup en rápido crecimiento, cuyo objetivo es permitir a los clientes olvidar la infraestructura y las complejidades de operar aplicaciones descentralizadas, el equipo de desarrollo se encuentra en Singapur. No pidas a Chainstack que venda o compre criptomonedas, pero sugiere hablar sobre marcos empresariales de blockchain, y te responderán con gusto.
Helm
Es un gestor de paquetes (charts) para Kubernetes. La forma más clara y universal de llevar aplicaciones al clúster de Kubernetes.
Por supuesto, se trata de un enfoque más estructurado e industrial que crear tus propios manifiestos YAML y escribir pequeñas utilidades.
Helm es lo mejor que hay disponible y popular en este momento.
¿Por qué Helm? Primero que nada, porque es respaldado por la CNCF. Cloud Native es una gran organización que es la empresa matriz de proyectos como Kubernetes, etcd, Fluentd y otros.
Otro hecho importante es que Helm es un proyecto muy popular. Cuando en enero de 2019 empecé a pensar en cómo hacer que Helm sea seguro, el proyecto contaba con mil estrellas en GitHub. Para mayo, ya tenía 12,000.
Muchos están interesados en Helm, así que incluso si aún no lo usas, te será útil aprender sobre su seguridad. La seguridad es importante.
El equipo principal de Helm es respaldado por Microsoft Azure, lo que lo convierte en un proyecto bastante estable en comparación con muchos otros. El lanzamiento de Helm 3 Alpha 2 a mediados de julio es un indicador de que hay muchas personas trabajando en el proyecto, y tienen el deseo y la capacidad de desarrollar y mejorar Helm.
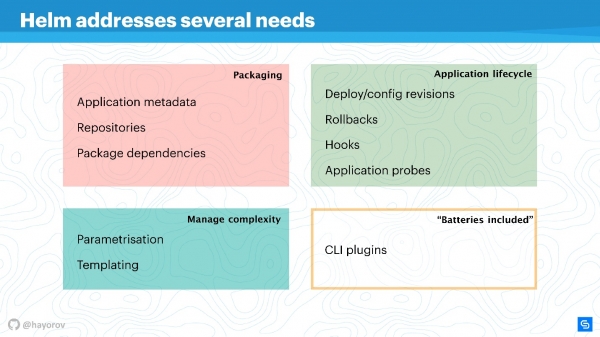
Helm aborda varios problemas fundamentales en la gestión de aplicaciones en Kubernetes.
- El empaquetado de aplicaciones. Incluso una aplicación simple como "Hello, World" en WordPress ya consta de varios servicios, y es deseable empaquetarlos juntos.
- La gestión de la complejidad que surge con la administración de estas aplicaciones.
- El ciclo de vida, que no termina después de la instalación o despliegue de la aplicación. Sigue viviendo, necesita ser actualizado, y Helm ayuda a esto, intentando aportar las medidas y políticas adecuadas.
Empaquetado está diseñado de manera comprensible: hay metadatos en plena conformidad con el funcionamiento de un gestor de paquetes típico para Linux, Windows o MacOS. Es decir, repositorios, dependencias de varios paquetes, metainformación para aplicaciones, configuraciones, características de configuración, indexación de información, etc. Todo esto Helm permite obtener y utilizar para las aplicaciones.
Gestión de la complejidad. Si tienes muchas aplicaciones similares, necesitas parametrización. De esto surgen las plantillas, pero para no inventar tu propia forma de crear plantillas, puedes utilizar lo que Helm ofrece de forma nativa.
Gestión del ciclo de vida de la aplicación — en mi opinión, esta es la cuestión más interesante y no resuelta. Es la razón por la que en su momento llegué a Helm. Necesitábamos supervisar el ciclo de vida de la aplicación, queríamos trasladar nuestro CI/CD y los ciclos de las aplicaciones a esta nueva paradigma.
Helm permite:
- gestionar despliegues, introduce la noción de configuración y revisión;
- realizar rollback con éxito;
- utilizar hooks en diferentes eventos;
- agregar verificaciones adicionales de aplicaciones y reaccionar a sus resultados.
Además Helm tiene «baterías» — una gran cantidad de cosas útiles que se pueden incluir como complementos, simplificando tu vida. Los complementos se pueden escribir por uno mismo, son bastante aislados y no requieren una arquitectura estructurada. Si deseas implementar algo, te recomiendo hacerlo como un complemento, y luego quizás incluirlo en upstream.
Helm se basa en tres conceptos fundamentales:
- Chart Repo — descripción y un conjunto de parámetros posibles para tu manifiesto.
- Configuración — es decir, los valores que serán aplicados (texto, valores numéricos, etc.).
- Release consolida los dos componentes superiores, y juntos se convierten en un Release. Las versiones de releases se pueden versionar, lo que permite organizar el ciclo de vida: pequeño en el momento de la instalación y grande en el momento de upgrade, downgrade o rollback.
Arquitectura de Helm
En el diagrama se refleja conceptualmente la arquitectura de alto nivel de Helm.
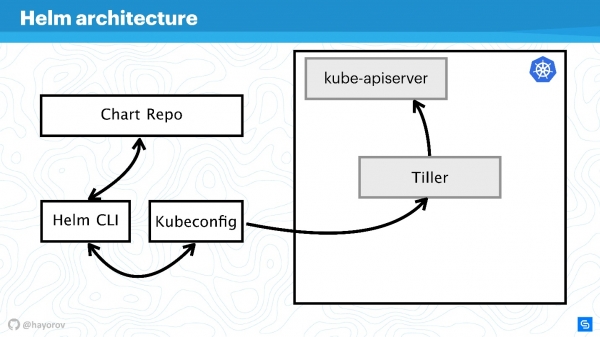
Recuerda que Helm está relacionado con Kubernetes. Por lo tanto, no podemos prescindir de un clúster de Kubernetes (rectángulo). El componente kube-apiserver se encuentra en el maestro. Sin Helm, tenemos Kubeconfig. Helm trae una pequeña utilidad binaria, por así decirlo, Helm CLI, que se instala en un ordenador, portátil, mainframe, en cualquier cosa.
Pero esto no es suficiente. Helm tiene un componente servidor llamado Tiller. Este representa los intereses de Helm dentro del clúster, es una aplicación dentro del clúster de Kubernetes, como cualquier otra.
El siguiente componente Chart Repo es un repositorio de charts. Hay un repositorio oficial, y puede haber un repositorio privado de la empresa o del proyecto.
Interacción
Veamos cómo interactúan los componentes de la arquitectura cuando queremos instalar una aplicación usando Helm.
- Decimos
Helm install, llamamos al repositorio (Chart Repo) y obtenemos el chart de Helm.
- La herramienta Helm (Helm CLI) interactúa con Kubeconfig para averiguar a qué clúster dirigirse.
- Con esta información, la herramienta se comunica con Tiller, que se encuentra en nuestro clúster, como una aplicación.
- Tiller se comunica con Kube-apiserver para realizar acciones en Kubernetes, crear ciertos objetos (servicios, pods, réplicas, secretos, etc.).
A continuación, complicaremos el esquema para ver el vector de ataques al que puede estar expuesta toda la arquitectura de Helm en general. Luego intentaremos protegerlo.
Vector de ataques
El primer punto potencialmente débil es el API privilegiado—usuarioDentro del esquema, este es un hacker que ha obtenido acceso de administrador al Helm CLI.
Un usuario API no privilegiado también puede representar un peligro si está cerca. Este usuario tendrá un contexto diferente; por ejemplo, puede estar registrado en un namespace del clúster en la configuración de Kubeconfig.
El vector de ataque más interesante puede ser un proceso que se encuentra dentro del clúster cerca de Tiller y puede interactuar con él. Esto puede ser un servidor web o un microservicio que ve el entorno de red del clúster.
Una opción exótica, pero en aumento, de ataque está relacionada con Chart Repo. Un chart creado por un autor malintencionado puede contener recursos inseguros y usted lo ejecutará confiando en él. O puede reemplazar el chart que descarga del repositorio oficial y, por ejemplo, crear recursos en forma de políticas y escalar su acceso.
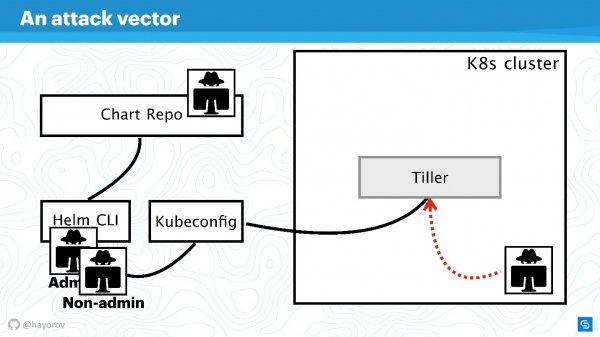
Intentaremos defendernos de ataques desde estos cuatro frentes y analizar dónde están los problemas en la arquitectura de Helm y dónde, tal vez, no los hay.
Simplifiquemos el esquema, añadamos más elementos, pero conservemos todos los componentes básicos.
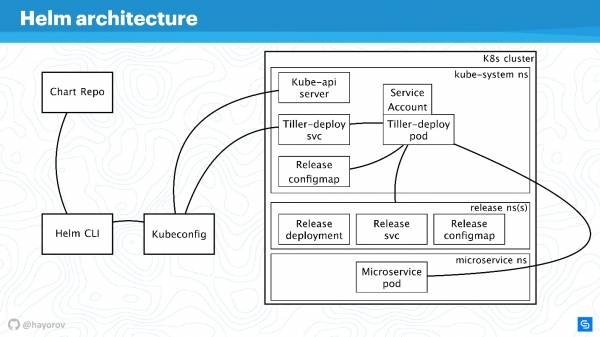
Helm CLI se comunica con Chart Repo, interactúa con Kubeconfig, y la operación se envía al clúster en el componente Tiller.
Tiller se presenta en dos objetos:
- Tiller-deploy svc, que expone un servicio;
- Tiller-deploy pod (en el esquema, un único ejemplar en una réplica), donde se ejecuta toda la carga de trabajo y que se comunica con el clúster.
Se utilizan diferentes protocolos y esquemas para la interacción. Desde el punto de vista de la seguridad, los más interesantes son:
- El mecanismo mediante el cual Helm CLI se conecta al chart repo: qué protocolo se utiliza, si hay autenticación y qué se puede hacer al respecto.
- El protocolo por el cual Helm CLI, usando kubectl, se comunica con Tiller. Este es un servidor RPC instalado dentro del clúster.
- El mismo Tiller está disponible para los microservicios que se encuentran en el clúster y interactúa con Kube-apiserver.
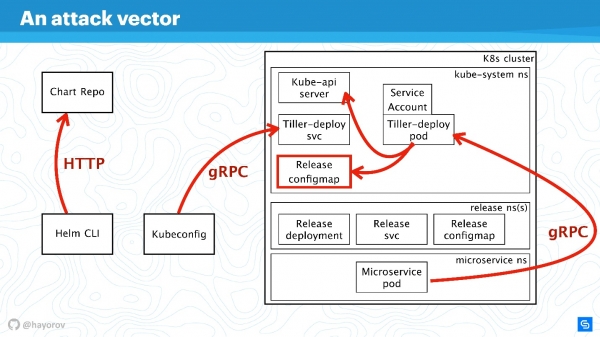
Discutamos todas estas direcciones por orden.
RBAC
Es inútil hablar de seguridad en Helm o cualquier otro servicio dentro del clúster si RBAC no está habilitado.
Parece que esta no es la recomendación más reciente, pero estoy seguro de que todavía muchos no han habilitado RBAC ni siquiera en producción, porque implica mucho trabajo y se necesita configurar muchas cosas. Sin embargo, insto a hacerlo.
— abogado del sitio para RBAC. Allí se reúne una gran cantidad de materiales interesantes que ayudarán a configurar RBAC, mostrarán por qué es bueno y cómo se puede vivir con él en producción.
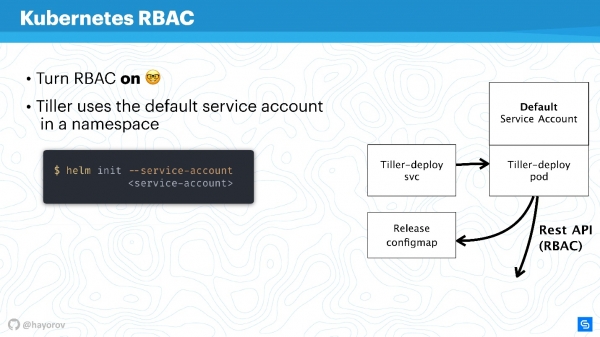
Intentaré explicar cómo funciona Tiller y RBAC. Tiller opera dentro del clúster bajo alguna cuenta de servicio. Como regla general, si RBAC no está configurado, será un superusuario. En la configuración básica, Tiller será el administrador. Por eso se dice a menudo que Tiller es un túnel SSH a su clúster. En realidad, es así, por lo que se puede usar una cuenta de servicio especializada en lugar de la Cuenta de Servicio Predeterminada en el esquema anterior.
Cuando inicializa Helm, al instalarlo por primera vez en el servidor, puede especificar la cuenta de servicio mediante --service-account. Esto permitirá usar un usuario con el conjunto mínimo de permisos necesarios. Sin embargo, tendrás que crear un "collar" así: Role y RoleBinding.
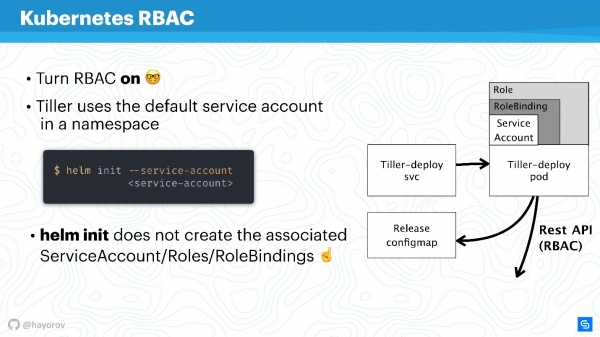
Desafortunadamente, Helm no hará esto por usted. Usted o su administrador del clúster de Kubernetes deben preparar de antemano un conjunto de Role y RoleBinding para la cuenta de servicio para pasar a Helm.
Surge la pregunta: ¿cuál es la diferencia entre Role y ClusterRole? La diferencia es que ClusterRole actúa para todos los namespaces, a diferencia de las Role y RoleBinding normales, que solo funcionan para un namespace específico. Se pueden configurar políticas tanto para todo el clúster y todos los namespaces, como de manera personalizada para cada namespace individualmente.
Cabe mencionar que RBAC también permite resolver otro gran problema. Muchos se quejan de que Helm, desafortunadamente, no es multitenancy (no soporta multiarrendamiento). Si varios equipos utilizan el clúster y usan Helm, en principio no es posible configurar políticas y restringir su acceso dentro de este clúster, porque hay una cuenta de servicio bajo la cual Helm opera, y crea todos los recursos en el clúster desde ahí, lo que a veces es muy inconveniente. Esto es cierto: tanto el archivo binario como el proceso, Helm Tiller no tiene concepto de multitenancy.
Sin embargo, hay una excelente manera de ejecutar Tiller en el clúster varias veces. No hay ningún problema con esto, Tiller se puede ejecutar en cada namespace. De esta forma, puede aprovechar RBAC, Kubeconfig como contexto y restringir el acceso a un Helm especial.
Esto se verá de la siguiente manera.
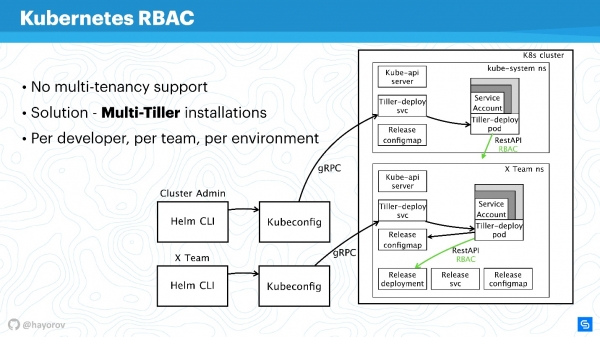
Por ejemplo, hay dos Kubeconfig con contexto para diferentes equipos (dos namespaces): el equipo X para el equipo de desarrollo y un clúster de administración. El clúster de administración tiene su propio Tiller amplio, que se encuentra en el espacio de nombres Kube-system, por lo tanto, una cuenta de servicio avanzada. Y un namespace separado para el equipo de desarrollo, que podrá desplegar sus servicios en un namespace específico.
Este es un enfoque práctico, Tiller no es tan voraz como para que esto afecte seriamente su presupuesto. Esta es una de las soluciones rápidas.
No dude en configurar Tiller por separado y proporcionar Kubeconfig con contexto para el equipo, para un desarrollador específico o para entornos: Dev, Staging, Production (aunque es poco probable que todo esté en un solo clúster, sin embargo, se puede hacer).
Continuando con nuestra historia, cambiemos de RBAC y hablemos sobre ConfigMaps.
ConfigMaps
Helm utiliza ConfigMaps como almacén de datos. Cuando hablamos de la arquitectura, no había ninguna base de datos donde se almacenara información sobre lanzamientos, configuraciones, retrocesos, etc. Para esto se utilizan ConfigMaps.
El principal problema con los ConfigMaps es conocido: no son seguros en principio, en ellos no se pueden almacenar datos sensibles. Se trata de todo lo que no debería salir del servicio, como contraseñas. El método más nativo para Helm actualmente es pasar del uso de ConfigMaps a secretos.
Esto se hace de manera muy sencilla. Sobrescribe la configuración de Tiller y especifica que el almacén serán secretos. Entonces, en cada despliegue recibirás no un ConfigMap, sino un secreto.
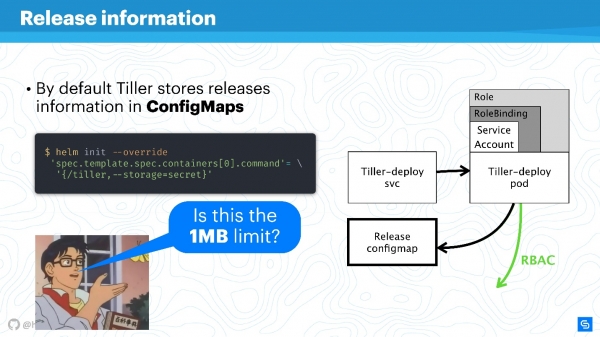
Puede objetar que los secretos en sí son un concepto extraño y que no es muy seguro. Sin embargo, hay que entender que esto lo manejan los mismos desarrolladores de Kubernetes. Desde la versión 1.10, es posible, al menos en nubes públicas, conectar un almacenamiento adecuado para almacenar secretos. Ahora, el equipo está trabajando para otorgar aún mejor acceso a secretos, a pods individuales u otras entidades.
Es mejor que el almacenamiento de Helm pase a ser secretos, y estos, a su vez, se aseguren de forma centralizada.
Por supuesto, quedará un límite de almacenamiento de datos de 1 MB. Helm utiliza etcd aquí como un almacén distribuido para ConfigMaps. Allí se consideró que este era un fragmento de datos adecuado para replicaciones, etc. Hay una discusión interesante al respecto en Reddit; recomiendo encontrar esta lectura divertida para el fin de semana o leer un resumen. .
Repositorios de Chart
Los charts son los más vulnerables socialmente y pueden convertirse en una fuente de "Man in the middle", especialmente si se utiliza una solución estándar. Esto se refiere principalmente a los repositorios que están expuestos a través de HTTP.
Definitivamente, es necesario exponer el Helm Repo a través de HTTPS; es la mejor opción y no es costosa.
Presta atención a mecanismo de firmas de charts. La tecnología es increíblemente simple. Es lo mismo que usas en GitHub, una máquina PGP ordinaria con claves públicas y privadas. Configúralo y estarás seguro, siempre que tengas las claves necesarias y firmes todo, asegurándote de que realmente sea tu chart.
Además, El cliente de Helm soporta TLS (no en el sentido de HTTP desde el servidor, sino TLS mutuo). Puedes usar claves del servidor y del cliente para comunicarte. Debo decir honestamente que no utilizo este mecanismo debido a mi desagrado por los certificados mutuos. En principio, — la herramienta principal para exponer Helm Repo para Helm 2, también soporta autenticación básica. Se puede usar autenticación básica si eso es más conveniente y tranquilizador.
También hay un plugin , que permite alojar Chart Repos en Google Cloud Storage. Esto es bastante conveniente, funciona perfectamente y es bastante seguro, ya que se utilizan todos los mecanismos descritos.
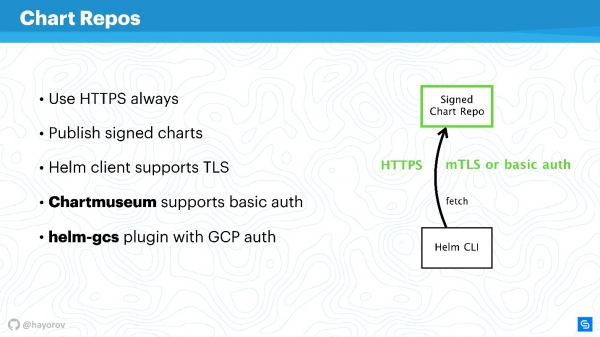
Si habilitas HTTPS o TLS, usas mTLS, y conectas autenticación básica para reducir aún más los riesgos, se obtiene un canal de comunicación seguro entre Helm CLI y Chart Repo.
API gRPC
El siguiente paso es muy responsable: asegurar Tiller, que se encuentra en el clúster y que, por un lado, es el servidor, y por otro, se comunica con otros componentes y trata de hacerse pasar por otro.
Como ya mencioné, Tiller es un servicio que expone gRPC; el cliente de Helm se conecta a él a través de gRPC. Por defecto, por supuesto, TLS está desactivado. La razón de esto es un tema debatible; creo que se hizo para simplificar la configuración al principio.
Para producción e incluso para staging, recomiendo habilitar TLS en gRPC.
En mi opinión, a diferencia de mTLS para charts, aquí es apropiado y se hace muy fácilmente: se genera infraestructura PQI, se crea un certificado, se inicia Tiller, y se pasa el certificado durante la inicialización. Después de esto, se pueden ejecutar todos los comandos de Helm, presentándose con el certificado generado y la clave privada.
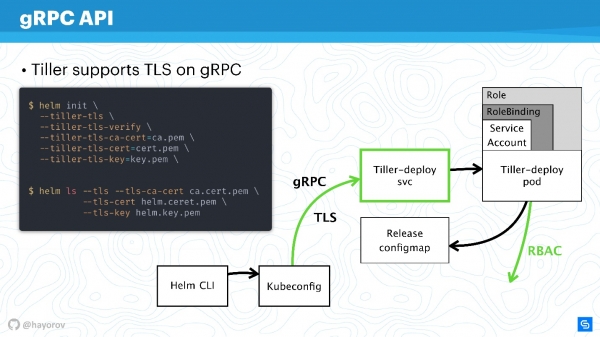
De esta manera, te protegerás de todas las solicitudes a Tiller desde fuera del clúster.
Así que hemos asegurado el canal de conexión a Tiller, ya hemos discutido RBAC y ajustado los permisos del apiserver de Kubernetes, y hemos reducido el dominio con el que puede interactuar.
Helm Seguro
Veamos el esquema final. Es la misma arquitectura con las mismas flechas.
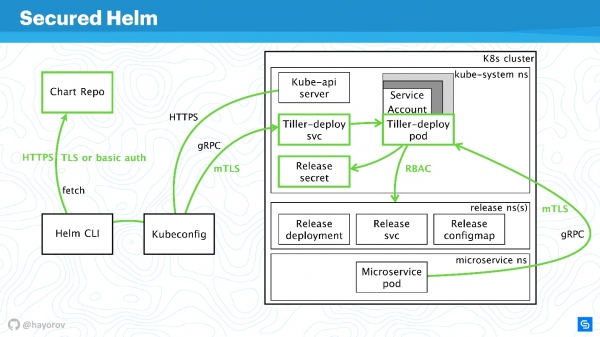
Todas las conexiones ahora se pueden dibujar con confianza en verde:
- para Chart Repo usamos TLS o mTLS y autenticación básica;
- mTLS para Tiller, que se presenta como un servicio gRPC con TLS, usando certificados;
- en el clúster se utiliza una cuenta de servicio especial con Role y RoleBinding.
Hemos asegurado notablemente el clúster, pero alguien inteligente dijo:
«La única solución absolutamente segura puede ser una — un ordenador apagado, que se encuentra en una caja de concreto y es custodiado por soldados».
Existen diferentes formas de manipular datos y encontrar nuevos vectores de ataque. Sin embargo, estoy seguro de que estas recomendaciones permitirán implementar un estándar de seguridad industrial básico.
Bono
Esta parte no se relaciona directamente con la seguridad, pero también será útil. Mostraré algunas cosas interesantes que pocos conocen. Por ejemplo, cómo buscar charts — oficiales y no oficiales.
En el repositorio en este momento hay alrededor de 300 charts y dos flujos: stable e incubator. Quien contribuye sabe lo difícil que es pasar de incubator a stable, y lo fácil que es salir de stable. Sin embargo, no es la mejor herramienta para buscar charts para Prometheus y todo lo que te guste, por una simple razón: no es un portal donde sea conveniente buscar paquetes.
Pero hay un servicio , con el que encontrar charts es mucho más conveniente. Lo más importante es que hay muchos más repositorios externos y están disponibles casi 800 charts. Además, puedes conectar tu propio repositorio si, por alguna razón, no quieres enviar tus charts a stable.
Intenta hub.helm.sh y desarrollemos juntos. Este servicio está bajo el proyecto Helm, y puedes contribuir incluso en su UI, si eres frontend y solo quieres mejorar la apariencia.
También quiero llamar su atención sobre la integración de Open Service Broker API. Suena complicado y confuso, pero resuelve problemas con los que todos se enfrentan. Permítanme explicarlo con un ejemplo simple.
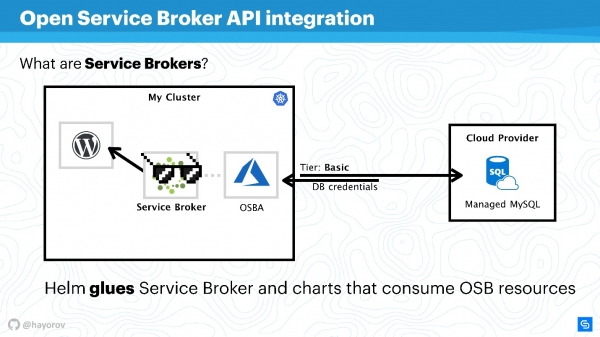
Hay un clúster de Kubernetes en el que queremos ejecutar una aplicación clásica: WordPress. Por lo general, para el funcionamiento completo se necesita una base de datos. Hay muchas soluciones diferentes, por ejemplo, se puede ejecutar su servicio stateful. Esto no es muy conveniente, pero muchos lo hacen.
Otros, como nosotros en Chainstack, utilizan bases de datos gestionadas, como MySQL o PostgreSQL, para servidores. Por lo tanto, nuestra base de datos se encuentra en la nube.
Pero surge un problema: es necesario vincular nuestro servicio con la base de datos, crear un sabor de base de datos, pasar las credenciales y gestionarlas de alguna manera. Todo esto se suele hacer manualmente por un administrador del sistema o un desarrollador. No hay problema cuando hay pocas aplicaciones. Cuando hay muchas, se necesita un combinado. Ese combinado existe: es el Service Broker. Permite utilizar un complemento especial para el clúster de la nube pública y solicitar recursos al proveedor a través del Broker, como si fuera una API. Para ello se pueden utilizar los medios nativos de Kubernetes.
Es muy simple. Se puede solicitar, por ejemplo, Managed MySQL en Azure con un nivel básico (esto se puede configurar). Utilizando la API de Azure, la base de datos será creada y preparada para su uso. No necesitará intervenir en esto, el complemento se encargará. Por ejemplo, OSBA (el complemento de Azure) devolverá las credenciales al servicio y se las pasará a Helm. Podrá utilizar WordPress con MySQL en la nube, sin preocuparse por las bases de datos gestionadas ni por los servicios stateful internos.
Se puede decir que Helm actúa como el pegamento que, por un lado, permite desplegar servicios y, por otro, consumir recursos de los proveedores de la nube.
Se puede escribir su propio complemento y utilizar toda esta historia on-premise. Entonces simplemente tendrá su propio complemento para el proveedor de nube corporativa. Recomiendo probar este enfoque, especialmente si tiene un gran volumen y desea desplegar rápidamente dev, staging o toda la infraestructura para una función. Esto facilitará la vida a sus operaciones o DevOps.
Otro hallazgo que ya mencioné es el complemento helm-gcs, que permite utilizar Google-buckets (almacenamiento de objetos) para almacenar gráficos de Helm.
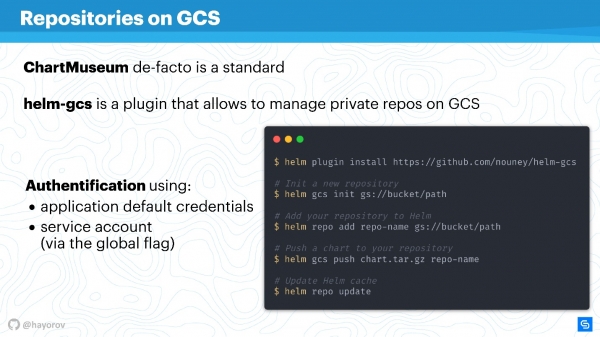
Se necesitan solo cuatro comandos para empezar a usarlo:
- instalar el complemento;
- inicializarlo;
- establecer la ruta al bucket que se encuentra en gcp;
- publicar los gráficos de la manera estándar.
La belleza es que se utilizará el método nativo de gcp para la autorización. Puede usar una cuenta de servicio, una cuenta de desarrollador, lo que sea. Esto es muy conveniente y no tiene costo en la operación. Si usted, al igual que yo, promueve la filosofía opsless, esto será muy útil, especialmente para equipos pequeños.
Alternativas
Helm no es la única solución para la gestión de servicios. Tiene muchas preguntas, probablemente por eso rápidamente apareció la tercera versión. Claro, hay alternativas.
Pueden ser soluciones especializadas, como Ksonnet o Metaparticle. También puede utilizar sus herramientas clásicas de gestión de infraestructura (Ansible, Terraform, Chef, etc.) para los mismos fines de los que hablé.
Finalmente, hay una solución , cuya popularidad está creciendo.
Operator Framework es la principal alternativa a Helm, a la que se debe prestar atención.
Es más nativa para CNCF y Kubernetes, pero la barrera de entrada es mucho más alta, se necesita programar más y describir menos manifiestos.
Hay varios complementos, como Draft, Scaffold. Facilitan enormemente la vida, por ejemplo, simplificando el ciclo de envío y ejecución de Helm para desplegar entornos de prueba. Los llamaría potenciadores.
Aquí hay un gráfico ilustrativo sobre dónde se encuentra cada cosa.
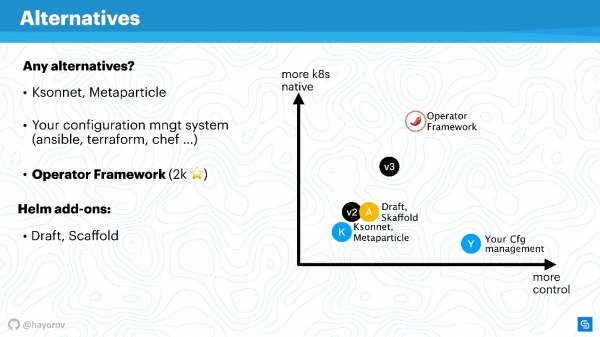
En el eje x, el nivel de su control personal sobre lo que sucede, en el eje y, el nivel de natividad de Kubernetes. Helm versión 2 se encuentra en algún lugar a medio camino. En la versión 3, aunque no es colosal, se han mejorado tanto el control como el nivel de natividad. Las soluciones de Ksonnet aún quedan atrás incluso de Helm 2. Sin embargo, vale la pena echarles un vistazo para saber qué más hay en este mundo. Claro, su gestor de configuraciones estará bajo control, pero no es absolutamente nativo para Kubernetes.
Operator Framework es absolutamente nativo para Kubernetes y permite gestionarlo de manera mucho más elegante y meticulosa (pero recordemos el nivel de entrada). Más bien, esto se adapta a aplicaciones especializadas y a la creación de su gestión, en lugar de ser una planta de uso masivo para empaquetar una gran cantidad de aplicaciones con Helm.
Los potenciadores simplemente mejoran un poco el control, complementan el flujo de trabajo o acortan los ángulos de los pipelines de CI/CD.
El futuro de Helm
La buena noticia es que Helm 3 ya está aquí. Se ha lanzado la versión alpha 3.0.0-alpha.2 de Helm, y ya se puede probar. Es bastante estable, pero la funcionalidad todavía está limitada.
¿Para qué se necesita Helm 3? En primer lugar, se trata de la desaparición de Tiller, como componente. Esto, como ya pueden entender, es un gran avance, ya que desde el punto de vista de la seguridad de la arquitectura, todo se simplifica.
Cuando se creó Helm 2, que fue en los tiempos de Kubernetes 1.8 o incluso antes, muchas de las concepciones eran inmaduras. Por ejemplo, la concepción de CRD se está implementando activamente ahora, y Helm va a usar CRD, para almacenar estructuras. Será posible usar solo el cliente y no tener la parte del servidor. Por lo tanto, se podrán utilizar comandos nativos de Kubernetes para trabajar con las estructuras y recursos. Esto es un gran avance.
Habrá soporte nativo para repositorios OCI (Open Container Initiative). Esta es una gran iniciativa, y Helm le interesa principalmente para alojar sus charts. Llega al punto de que, por ejemplo, Docker Hub soporta muchos estándares OCI. No quiero adelantarme, pero es posible que los proveedores clásicos de repositorios Docker comiencen a permitirte alojar tus Helm charts.
Una historia controvertida para mí es el soporte para Lua, como motor de plantillas para escribir scripts. No soy un gran fan de Lua, pero será una opción completamente opcional. Lo he verificado tres veces: el uso de Lua no será obligatorio. Así que aquellos que quieran usar Lua, bienvenidos; quienes prefieren Go, únanse a nuestro gran grupo y usen go-tmpl para eso.
Finalmente, lo que definitivamente me hacía falta es la aparición de esquemas y la validación de tipos de datos. Ya no habrá problemas con int o string, no será necesario envolver cero entre comillas dobles. Habrá un esquema JSON que permitirá describirlo claramente para los values.
Se revisará por completo el modelo basado en eventos. Ya está descrito conceptualmente. Miren la rama Helm 3, y verán cuántos eventos, hooks y otras cosas se han añadido, lo que simplificará y, por otro lado, proporcionará más control sobre los procesos de despliegue y sus reacciones.
Helm 3 será más simple, seguro e interesante no porque no nos guste Helm 2, sino porque Kubernetes se está volviendo más avanzado. Por lo tanto, Helm podrá aprovechar los avances de Kubernetes y crear excelentes gestores para Kubernetes.
Otra buena noticia es que en Alexandr Haërov explicará, Cabe recordar que la conferencia sobre la integración de procesos de desarrollo, prueba y operación se llevará a cabo en Moscú el 30 de septiembre y 1 de octubre. Hasta el 20 de agosto aún puedes y compartir tu experiencia en la resolución de retos del enfoque DevOps.
Sigue los puntos clave de la conferencia y las noticias en y .
Fuente: habr.com
