

Imaginemos. En una habitación hay 5 gatos encerrados, y para ir a despertar a su dueño, necesitan ponerse de acuerdo entre ellos, ya que solo pueden abrir la puerta si empujan todos juntos. Si uno de los gatos es el gato de Schrödinger, y los demás no saben sobre su decisión, surge la pregunta: "¿Cómo pueden lograrlo?"
En este artículo, explicaré en términos sencillos la parte teórica del mundo de los sistemas distribuidos y los principios de su funcionamiento. También examinaré superficialmente la idea principal que subyace en Paxos.
Cuando los desarrolladores utilizan infraestructuras en la nube, diversas bases de datos y trabajan en clústeres de muchos nodos, están seguros de que los datos serán íntegros, seguros y siempre accesibles. Pero, ¿de dónde vienen esas garantías?
En esencia, las garantías que tenemos son las garantías del proveedor. Están descritas en la documentación de la siguiente manera: "Este servicio es lo suficientemente confiable, tiene un SLA establecido, no se preocupe, todo funcionará distribuido como usted espera."
Tendemos a creer en lo mejor, ya que los directores de grandes empresas nos aseguraron que todo estará bien. No nos hacemos la pregunta: ¿por qué, en realidad, esto puede funcionar? ¿Hay alguna justificación formal para el correcto funcionamiento de tales sistemas?
Recientemente fui a y me inspiré mucho en esta temática. Las conferencias en la escuela se parecían más a clases de análisis matemático que a algo relacionado con sistemas informáticos. Pero así es como se demostraron los algoritmos más importantes que usamos todos los días, sin que siquiera lo sospechemos.
En la mayoría de los sistemas distribuidos modernos se usa el algoritmo de consenso Paxos y sus diversas modificaciones. Lo más impresionante es que la fundamentación y, en principio, la posibilidad misma de la existencia de este algoritmo pueden demostrarse fácilmente con solo un bolígrafo y papel. Al mismo tiempo, el algoritmo se aplica en grandes sistemas que funcionan en un gran número de nodos en la nube.
Una ilustración ligera de lo que se tratará a continuación: el problema de los dos generalesPara calentar, analicemos .
Tenemos dos ejércitos: el rojo y el blanco. Las tropas blancas están acantonadas en la ciudad sitiada. Las tropas rojas, lideradas por los generales A1 y A2, se encuentran a ambos lados de la ciudad. La tarea de los rojos es atacar la ciudad blanca y ganar. Sin embargo, el ejército de cada general rojo es más pequeño que el de los blancos.
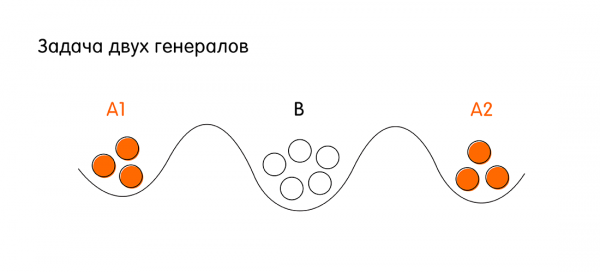
Las condiciones para que los rojos ganen son: ambos generales deben atacar al mismo tiempo para tener superioridad numérica sobre los blancos. Para ello, los generales A1 y A2 necesitan llegar a un acuerdo entre ellos. Si cada uno ataca por separado, los rojos perderán.
Para llegar a un acuerdo, los generales A1 y A2 pueden enviar mensajeros a través del territorio de la ciudad blanca. Un mensajero puede llegar con éxito al general aliado o puede ser interceptado por el enemigo. La pregunta es: ¿existe una secuencia de comunicaciones entre los generales rojos (una secuencia de envíos de mensajeros de A1 a A2 y viceversa, de A2 a A1) en la que se aseguren de acordar un ataque a la hora X? Aquí, por garantías se entiende que ambos generales tendrán una confirmación inequívoca de que su aliado (el otro general) atacará exactamente a la hora acordada X.
Supongamos que A1 envía un mensajero a A2 con el mensaje: '¡Atacamos hoy a la medianoche!'. El general A1 no puede atacar sin la confirmación del general A2. Si el mensajero de A1 llega, el general A2 envía su confirmación con el mensaje: 'Sí, vamos a derribar a los blancos hoy'. Pero ahora el general A2 no sabe si su mensajero llegó o no, no tiene garantías de que el ataque sea simultáneo. Ahora, el general A2 necesita otra vez una confirmación.
Si se detalla aún más su comunicación, se descubrirá lo siguiente: por mucho que haya ciclos de intercambio de mensajes, no hay forma de garantizar que ambos generales sean notificados de que sus mensajes han sido recibidos (suponiendo que cualquiera de los mensajeros pueda ser interceptado).
La tarea de los dos generales es una excelente ilustración de un sistema distribuido muy simple, donde hay dos nodos con comunicación poco fiable. Así que no tenemos una garantía del 100% de que se sincronicen. Sobre problemas similares, pero en una escala mayor, se hablará más adelante en el artículo.
Introducimos el concepto de sistemas distribuidos.
Un sistema distribuido es un conjunto de computadoras (a partir de ahora las llamaremos nodos) que pueden intercambiar mensajes. Cada nodo individual es una entidad autónoma. Un nodo puede procesar tareas de manera independiente, pero para interactuar con otros nodos, necesita enviar y recibir mensajes.
Cómo se implementan exactamente los mensajes y qué protocolos se utilizan no nos interesa en este contexto. Lo importante es que los nodos del sistema distribuido pueden intercambiar datos entre sí enviando mensajes.
La propia definición no parece muy complicada, pero hay que tener en cuenta que un sistema distribuido tiene una serie de atributos que serán importantes para nosotros.
Atributos de los sistemas distribuidos
- Concurrencia es la posibilidad de que ocurran eventos simultáneos o concurrentes en el sistema. Más aún, consideraremos que los eventos que ocurren en dos nodos diferentes son potencialmente concurrentes hasta que tengamos un orden claro en el que esos eventos suceden. Y, por lo general, no lo tenemos.
- Ausencia de relojes globales. No tenemos un orden claro de los eventos debido a la ausencia de relojes globales. En el mundo normal de los humanos, estamos acostumbrados a tener relojes y tiempo absoluto. Todo cambia cuando hablamos de sistemas distribuidos. Incluso los relojes atómicos más precisos tienen un desvío, y pueden surgir situaciones en las que no podemos decir cuál de los dos eventos ocurrió primero. Por lo tanto, también no podemos confiar en el tiempo.
- Fallo independiente de los nodos del sistema. Hay otro problema: algo puede salir mal simplemente porque nuestros nodos no son eternos. Un disco duro puede fallar, una máquina virtual en la nube puede reiniciarse, puede haber un parpadeo en la red y los mensajes se pierden. Además, es posible que haya situaciones en las que los nodos funcionen, pero en contra del sistema. Esta última clase de problemas incluso tiene un nombre específico: el problema de . El ejemplo más popular de un sistema distribuido con este problema es el Blockchain. Pero hoy no vamos a considerar esta clase especial de problemas. Nos interesarán las situaciones en las que uno o varios nodos pueden fallar.
- Modelos de comunicación (modelos de intercambio de mensajes) entre nodos. Ya hemos determinado que los nodos se comunican mediante el intercambio de mensajes. Hay dos modelos de intercambio de mensajes conocidos: síncrono y asíncrono.
Modelos de comunicación entre nodos en sistemas distribuidos
Modelo síncrono – sabemos con certeza que hay una delta de tiempo finita conocida, durante la cual el mensaje llega garantizado de un nodo a otro. Si este tiempo ha pasado y no ha llegado el mensaje, podemos afirmar con confianza que el nodo ha fallado. En este modelo, tenemos un tiempo de espera predecible.
Modelo asíncrono – en los modelos asíncronos consideramos que el tiempo de espera es finito, pero no existe tal delta de tiempo después de la cual se puede garantizar que un nodo ha fallado. Es decir, el tiempo de espera del mensaje de un nodo puede ser arbitrariamente largo. Esta es una definición importante, y hablaremos de ello más adelante.
El concepto de consenso en sistemas distribuidos
Antes de definir formalmente el concepto de consenso, consideremos un ejemplo de situación en la que lo necesitamos, a saber – Replicación de Máquina de Estado.
Tenemos un registro distribuido. Nos gustaría que fuera consistente y contuviera datos idénticos en todos los nodos del sistema distribuido. Cuando alguno de los nodos conoce un nuevo valor que va a registrar en el log, su tarea es proponer este valor a todos los demás nodos, para que el log se actualice en todos los nodos, y el sistema pase a un nuevo estado consistente. Es importante que los nodos se pongan de acuerdo: todos los nodos deben estar de acuerdo en que el nuevo valor propuesto es correcto, todos los nodos deben aceptar este valor, y solo en este caso todos pueden registrar el nuevo valor en el log.
En otras palabras: ninguno de los nodos objetó que tuviera información más actualizada, ni que el valor propuesto fuera incorrecto. El acuerdo entre los nodos y el consenso sobre el valor único correcto aceptado es el consenso en el sistema distribuido. Más adelante hablaremos sobre los algoritmos que permiten al sistema distribuido alcanzar el consenso de manera garantizada.
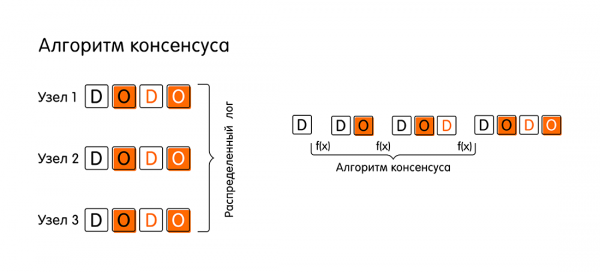
De manera más formal, podemos definir el algoritmo de consenso (o simplemente el algoritmo de consenso) como una función que lleva a un sistema distribuido de un estado A a un estado B. Además, este estado es aceptado por todos los nodos, y todos los nodos pueden confirmarlo. Como se descubre, esta tarea no es tan trivial como parece a primera vista.
Propiedades del algoritmo de consenso
Un algoritmo de consenso debe poseer tres propiedades para que el sistema continúe existiendo y tenga algún progreso al pasar de un estado a otro:
- Acuerdo – todos los nodos que funcionan correctamente deben aceptar el mismo valor (en los artículos, esta propiedad también se conoce como propiedad de seguridad). Todos los nodos que están funcionando en este momento (que no han fallado y no han perdido conexión con los demás) deben llegar a un acuerdo y aceptar un valor común final.
Aquí es importante entender que los nodos en el sistema distribuido que estamos considerando quieren llegar a un acuerdo. Es decir, estamos hablando de sistemas donde algo puede fallar (por ejemplo, un nodo puede fallar), pero en este sistema no hay nodos que intencionalmente trabajen en contra de otros (la tarea de los generales bizantinos). Por esta propiedad, el sistema se mantiene consistente.
- Integridad — si todos los nodos que funcionan correctamente proponen el mismo valor v, entonces cada nodo que funcione correctamente debe aceptar este valor v.
- Terminación – todos los nodos que funcionan correctamente eventualmente aceptarán algún valor (propiedad de vivacidad), lo que permite que el algoritmo tenga progreso en el sistema. Cada nodo que funcione correctamente debe, tarde o temprano, aceptar un valor final y confirmarlo: "Para mí, este valor es verdadero, estoy de acuerdo con todo el sistema".
Ejemplo del funcionamiento del algoritmo de consenso
Mientras que las propiedades del algoritmo pueden no ser del todo claras. Por lo tanto, ilustraremos con un ejemplo las etapas que pasa el algoritmo de consenso más simple en un sistema con un modelo de intercambio de mensajes síncrono, donde todos los nodos funcionan como se espera, los mensajes no se pierden y nada se rompe (¿realmente sucede eso?).
- Todo comienza con una proposición de mano y corazón (Propose). Supongamos que un cliente se ha conectado al nodo llamado "Nodo 1" y ha comenzado una transacción, enviando un nuevo valor al nodo: O. A partir de este momento, llamaremos a "Nodo 1" proposer. Como proposer, "Nodo 1" ahora debe notificar a todo el sistema que tiene nuevos datos, y envía mensajes a todos los demás nodos: "¡Miren! He recibido el valor "O", ¡y quiero que lo guarden! Por favor, confirmen que ustedes también guardarán "O" en su registro."

- La siguiente etapa es la votación del valor propuesto (Voting). ¿Para qué sirve? Puede suceder que otros nodos hayan recibido información más reciente y tengan datos sobre esta misma transacción.
Cuando el nodo "Nodo 1" envía su propuesta, los demás nodos revisan sus registros para este evento. Si no hay inconsistencias, los nodos declaran: "Sí, no tengo otros datos sobre este evento. El valor "O" es la información más reciente que hemos recibido."En cualquier otro caso, los nodos pueden responder a "Nodo 1": "¡Escucha! Tengo datos más recientes sobre esta transacción. No es "O", sino algo mejor."
Durante la fase de votación, los nodos llegan a una decisión: o todos aceptan un único valor, o alguno de ellos vota en contra, indicando que tiene datos más recientes.
- Si la ronda de votación ha sido exitosa y todos estuvieron a favor, el sistema pasa a una nueva etapa: la aceptación del valor (Accept). "Nodo 1" reúne todas las respuestas de los otros nodos y declara: "¡Todos han aceptado el valor "O"! Ahora anuncio oficialmente que "O" es nuestro nuevo valor, ¡el mismo para todos! Anoten en su cuadernito, no se olviden. ¡Regístrenlo en su log!"
- Los demás nodos envían una confirmación (Accepted) de que han registrado el valor "O", sin que haya llegado nada nuevo en este tiempo (una especie de compromiso de dos fases). Después de este evento significativo, consideramos que la transacción distribuida se ha completado.
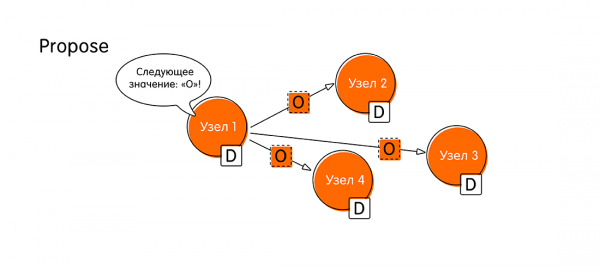
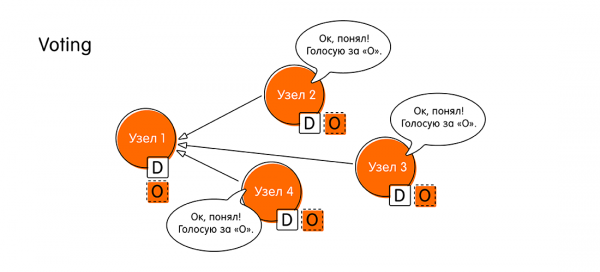
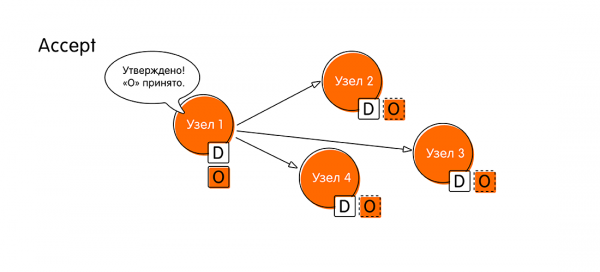
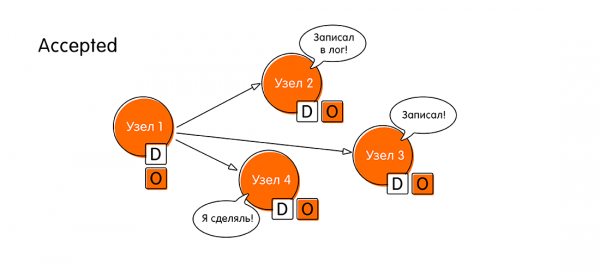
Así, el algoritmo de consenso en un caso simple consta de cuatro pasos: proponer, votar (voting), aceptar (accept) y confirmar aceptación (accepted).
Si en algún paso no logramos alcanzar un consenso, el algoritmo se reinicia, teniendo en cuenta la información que proporcionarán los nodos que se negaron a confirmar el valor propuesto.
El algoritmo de consenso en un sistema asíncrono
Hasta ahora, todo había sido simple, ya que estábamos hablando de un modelo de intercambio de mensajes sincrónico. Pero sabemos que en el mundo moderno estamos acostumbrados a hacer todo de manera asíncrona. ¿Cómo funciona un algoritmo similar en un sistema con un modelo de intercambio de mensajes asíncrono, donde consideramos que el tiempo de espera para recibir una respuesta de un nodo puede ser indefinidamente largo? (Por cierto, la falla de un nodo también se puede considerar un ejemplo en el que un nodo puede responder durante un tiempo indefinido).
Ahora que entendemos cómo funciona, en términos generales, el algoritmo de consenso, planteo una pregunta a los lectores curiosos que han llegado hasta aquí: ¿cuántos nodos en un sistema de N nodos con un modelo de mensajes asíncrono pueden fallar para que el sistema aún pueda alcanzar el consenso?
La respuesta correcta y su justificación se encuentran tras el spoiler.La respuesta correcta es: 0. Si al menos un nodo en un sistema asíncrono falla, el sistema no podrá alcanzar consenso. Esta afirmación está demostrada en un teorema bien conocido en ciertos círculos, el teorema FLP (1985, Fischer, Lynch, Paterson, enlace al original al final del artículo): "La imposibilidad de alcanzar consenso distribuido con la falla de al menos un nodo".
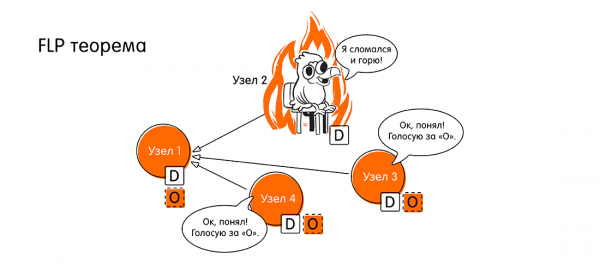
Chicos, entonces tenemos un problema, estamos acostumbrados a que todo sea asíncrono. ¿Y ahora qué hacemos? ¿Cómo seguimos adelante?
Ahora estábamos hablando de teoría, de matemáticas. ¿Qué significa "el consenso no puede ser alcanzado" cuando lo traducimos de lenguaje matemático a nuestro lenguaje ingenieril? Significa que "no siempre puede ser alcanzado", es decir, existe un caso en el que el consenso no es alcanzable. ¿Y cuál es este caso?
Eso es precisamente lo que se describe como la violación de la propiedad de liveness, mencionada anteriormente. No tenemos un acuerdo común, y el sistema no puede tener progreso (no puede completarse en un tiempo finito) si no recibimos respuestas de todos los nodos. Porque en un sistema asíncrono no tenemos un tiempo de respuesta predecible, y no podemos saber si un nodo ha fallado o simplemente está respondiendo lentamente.
Pero en la práctica podemos encontrar una solución. Supongamos que nuestro algoritmo puede funcionar durante mucho tiempo en caso de fallos (potencialmente puede funcionar indefinidamente). Pero en la mayoría de las situaciones, cuando la mayoría de los nodos están funcionando correctamente, tendremos progreso en el sistema.
En la práctica, tratamos con modelos de comunicación parcialmente síncronos. La parcialidad de la sincronización se entiende así: en términos generales, tenemos un modelo asíncrono, pero se introduce formalmente el concepto de "tiempo de estabilización global" para un momento dado.
Este momento puede no llegar durante mucho tiempo, pero tarde o temprano debe llegar. Sonará una alarma virtual y a partir de ese momento podemos predecir la delta de tiempo que tomará llegar los mensajes. A partir de ese momento, el sistema pasa de ser asíncrono a síncrono. En la práctica, tratamos precisamente con esos tipos de sistemas.
El algoritmo Paxos resuelve problemas de consenso.
Es una familia de algoritmos que resuelven el problema de consenso para sistemas parcialmente síncronos, siempre que algunos nodos puedan fallar. El autor de Paxos es . Propuso una prueba formal de la existencia y corrección del algoritmo en 1989.
Sin embargo, la prueba resultó ser nada trivial. La primera publicación salió solo en 1998 (33 páginas) describiendo el algoritmo. Resultó ser extremadamente difícil de entender, y en 2001 se publicó una aclaración al artículo que ocupó 14 páginas. Las extensiones de las publicaciones se proporcionan para demostrar que, en realidad, el problema de consenso no es simple, y detrás de dichos algoritmos hay un enorme esfuerzo de las mentes más brillantes.
Curiosamente, el mismo Leslie Lamport mencionó en su conferencia que en el segundo artículo de aclaración hay una afirmación, una línea (no especificó cuál), que puede ser interpretada de diferentes maneras. Debido a esto, muchas implementaciones modernas de Paxos no funcionan de manera completamente correcta.
Un análisis detallado del funcionamiento de Paxos no se puede resumir en un solo artículo, por lo que intentaré transmitir brevemente la idea principal del algoritmo. En los enlaces al final de mi artículo encontrarás materiales para profundizar en este tema.
Roles en Paxos
En el algoritmo Paxos, hay un concepto de roles. Consideremos tres roles principales (hay modificaciones con roles adicionales):
- Proposers (también pueden encontrarse los términos: líderes o coordinadores). Estos son chicos que descubren un nuevo valor a partir del usuario y asumen el papel de líder. Su tarea es iniciar una ronda de propuestas de un nuevo valor y coordinar las acciones posteriores de los nodos. Además, Paxos permite que haya múltiples líderes en determinadas situaciones.
- Aceptores (Votantes). Son nodos que votan a favor o en contra de la aceptación de un determinado valor. Su papel es muy importante, porque de ellos depende la decisión: a qué estado pasará (o no) el sistema después de la siguiente etapa del algoritmo de consenso.
- Aprendices. Nodos que simplemente reciben y registran el nuevo valor aceptado cuando el estado del sistema cambia. No toman decisiones, solo reciben datos y pueden entregarlos al usuario final.
Un nodo puede combinar varios roles en diferentes situaciones.
El concepto de quórum
Suponemos que tenemos un sistema de N nodos. Y de ellos, como máximo, F nodos pueden fallar. Si F nodos fallan, entonces en nuestro clúster debe haber, como mínimo, 2F + 1 nodos aceptores.
Esto es necesario para que siempre, incluso en la peor situación, los nodos 'buenos', que funcionan correctamente, tengan la mayoría. Es decir, F + 1 nodos 'buenos' que hayan coincidido, y el valor final será aceptado. De lo contrario, podría haber una situación en la que diferentes grupos locales adopten valores diferentes y no puedan llegar a un acuerdo entre sí. Por lo tanto, necesitamos una mayoría absoluta para ganar en la votación.
La idea general del funcionamiento del algoritmo de consenso Paxos
El algoritmo Paxos implica dos grandes fases, las cuales se dividen en dos pasos cada una:
- Fase 1a: Preparar. En la etapa de preparación, el líder (proposer) informa a todos los nodos: «Comenzamos una nueva fase de votación. Tenemos una nueva ronda. El número de esta ronda es n. Ahora comenzaremos a votar». Por ahora, solo comunica el inicio de un nuevo ciclo, pero no revela un nuevo valor. La tarea de esta etapa es iniciar una nueva ronda y comunicar a todos su número único. El número de ronda es importante; debe ser un valor mayor que todos los números de votaciones anteriores de todos los líderes anteriores. Esto se debe a que, gracias al número de ronda, otros nodos en el sistema comprenderán cuán recientes son los datos del líder. Probablemente, otros nodos ya tienen resultados de votaciones de rondas mucho más recientes y simplemente le dirán al líder que está desactualizado.
- Fase 1b: Promesa. Cuando los nodos acceptores han recibido el número de la nueva etapa de votación, pueden ocurrir dos resultados:
- El número n de la nueva votación es mayor que el número de cualquier votación anterior en la que participó el aceptador. Entonces, el aceptador envía al líder una promesa de que no participará en ninguna votación con un número menor que n. Si el aceptador ya ha votado por algún valor (es decir, ya ha aceptado un valor en la segunda fase), adjunta a su promesa el valor aceptado y el número de votación en el que participó.
- Por otra parte, si el aceptador ya sabe de una votación con un número mayor, puede simplemente ignorar la etapa de preparación y no responder al líder.
- Fase 2a: Aceptar. El líder necesita esperar la respuesta de un quórum (mayoría de los nodos en el sistema) y, si recibe el número necesario de respuestas, tiene dos opciones:
- Algunos de los aceptadores han enviado valores por los que ya han votado. En este caso, el líder elige el valor de la votación con el número máximo. Llamaremos a este valor x, y envía a todos los nodos un mensaje del tipo: «Aceptar (n, x)», donde el primer valor es el número de la votación de su propio paso Propose, y el segundo valor es el propósito por el cual todos se reunieron, es decir, el valor por el que, en esencia, se está votando.
- Si ninguno de los aceptadores ha enviado ningún valor y simplemente han prometido votar en esta ronda, el líder puede proponerles que voten por su valor, el valor por el cual se convirtió en líder. Llamémoslo y. Envía a todos los nodos un mensaje del tipo: «Accept (n, y)», de manera similar al resultado anterior.
- Fase 2b: Aceptado. Luego, los nodos aceptadores, al recibir el mensaje «Accept(…)» del líder, se ponen de acuerdo (envían a todos los nodos una confirmación de que están de acuerdo con el nuevo valor) solo si no han prometido a otro líder participar en las votaciones de la ronda número n’ > n, de lo contrario, ignoran la solicitud de confirmación.
Si el líder recibe la respuesta de la mayoría de los nodos y todos confirman el nuevo valor, entonces el nuevo valor se considera aceptado. ¡Hurra! Si no se alcanza la mayoría o hay nodos que se han negado a aceptar el nuevo valor, todo comienza de nuevo.
Así es como funciona el algoritmo Paxos. Cada una de estas etapas tiene muchas sutilezas, prácticamente no hemos abordado los diferentes tipos de fallos, problemas de múltiples líderes y mucho más, pero el objetivo de este artículo es simplemente familiarizar al lector en un nivel alto con el mundo de la computación distribuida.
También vale la pena señalar que Paxos no es el único en su tipo; existen otros algoritmos, por ejemplo, , pero eso ya es tema para otro artículo.
Enlaces a materiales para un estudio más profundo
Nivel «principiante»:
- , Preethi Kasireddy, artículo de blog en Medium
- , Adi Kancherla, artículo de blog en Medium
- , Ittai Abraham, blog
- , Ittai Abraham, artículo de blog
Nivel «Leslie Lamport»:
- , Fischer, Lynch y Paterson, documento de investigación, 1985
- , Leslie Lamport, documento de investigación, 1998
- , Leslie Lamport, documento de investigación, 2001
Fuente: habr.com
