

Nota de traducción.: El autor de este material es Cindy Sridharan, ingeniera de la empresa imgix, que se ocupa del desarrollo de API y, en particular, de la prueba de microservicios. En este material, comparte su visión detallada sobre los problemas actuales en el área de la trazabilidad distribuida, donde, en su opinión, hay una falta de herramientas realmente efectivas para abordar los problemas apremiantes.
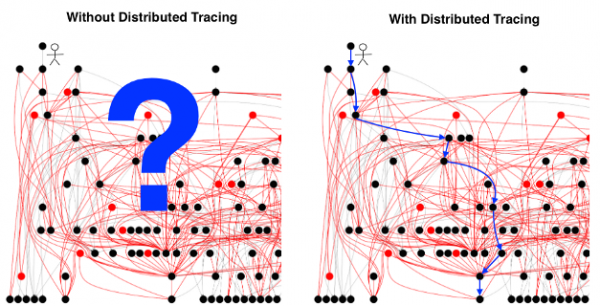
[La ilustración es tomada de sobre trazabilidad distribuida.]
Se considera que es difícil de implementar, y además, su rendimientos . La «problemática» de la trazabilidad se atribuye a múltiples razones, a menudo se menciona la complejidad de configurar cada componente del sistema para transmitir los encabezados adecuados con cada solicitud. Aunque este problema ciertamente existe, no se puede llamar insuperable. De hecho, no explica por qué a los desarrolladores no les gusta mucho la trazabilidad (incluso la que ya está funcionando).
La principal dificultad con la trazabilidad distribuida no es la recopilación de datos, ni la estandarización de los formatos de distribución y presentación de resultados, ni la determinación de cuándo, dónde y cómo realizar la toma de muestras. De ninguna manera intento presentar como triviales estos «problemas de usabilidad» — en realidad, existen desafíos técnicos bastante significativos y (si consideramos estándares y protocolos verdaderamente Open Source Sin embargo, suponiendo que todos estos problemas estén resueltos, es probable que nada cambie sustancialmente en términos de
la experiencia del usuario final . La trazabilidad aún puede no aportar beneficios prácticos en los escenarios de depuración más comunes, incluso después de haber sido implementada.Una trazabilidad tan diferente
La trazabilidad distribuida incluye varios componentes dispares:
dotar a las aplicaciones y middleware de herramientas de control;
- la transmisión de contexto distribuido;
- la recopilación de trazas;
- el almacenamiento de trazas;
- su extracción y visualización.
- su extracción y visualización.
Muchas de las conversaciones sobre el trazado distribuido se reducen a considerarlo como una operación unaria cuyo único objetivo es ayudar en el diagnóstico completo del sistema. Esto está muy relacionado con cómo se han formado históricamente las ideas sobre el trazado distribuido. En , cuando se abrieron los fuentes de Zipkin, se mencionó que él [Zipkin] hace que Twitter sea más rápido. Las primeras ofertas comerciales para el trazado también se promocionaban como .
Nota de traducción.: Para que el texto siguiente sea mejor comprendido, definamos dos términos básicos según :
- Span — el elemento básico del trazado distribuido. Representa una descripción de un proceso de trabajo (por ejemplo, una solicitud a la base de datos) con un nombre, tiempo de inicio y finalización, etiquetas, registros y contexto.
- Los Span suelen contener enlaces a otros span, lo que permite agrupar múltiples span en Trace — una visualización de la vida de la solicitud a medida que se mueve por un sistema distribuido.
Los Trace contienen datos increíblemente valiosos que pueden ayudar en tareas como: pruebas en producción, realización de pruebas de recuperación ante desastres, pruebas con inserción de errores, etc. De hecho, algunas empresas ya están utilizando el trazado para tales fines. Comencemos con que tiene otras aplicaciones además de simplemente trasladar los span al sistema de almacenamiento:
- Por ejemplo, Uber usa los resultados del trazado para distinguir entre tráfico de prueba y tráfico de producción.
- Facebook los datos de trace para analizar la ruta crítica y para redirigir el tráfico durante las pruebas regulares de recuperación ante desastres.
- También la red social los cuadernos de Jupyter, que permiten a los desarrolladores realizar solicitudes arbitrarias sobre los resultados del trazado.
- Los adherentes de (Inyección de Fallos Guiada por Linaje) los trazados distribuidos para pruebas con inserción de errores.
Ninguna de las opciones mencionadas anteriormente se refiere completamente a un escenario de depuración, donde un ingeniero intenta resolver un problema observando el trazado.
Cuando se trata de hecho del escenario de depuración, la interfaz primaria sigue siendo el diagrama traceview (aunque algunos también lo llaman «diagrama de Gantt» o «diagrama de cascada»). Bajo traceview yo todos los span y los metadatos asociados que en conjunto conforman un trace. Cada sistema de trazado de código abierto, así como cada solución comercial para trazado, ofrece una base en traceview una interfaz de usuario para la visualización, detallar y filtrar traces.
El problema con todos los sistemas de trazado que he tenido la oportunidad de revisar hasta ahora es que la visualización final visualización (traceview) refleja prácticamente por completo las características del proceso de generación de traces. Incluso cuando se ofrecen visualizaciones alternativas: mapas de intensidad (heatmap), topologías de servicios, histogramas de latencia, al final, todas se reducen a traceview.
En el pasado, yo de que la mayoría de las "innovaciones" en el área de trazado en cuanto a UI/UX parecen limitarse a metadatos adicionales en el trace, incorporando información de alta cardinalidad (high-cardinality) o proporcionando la capacidad de detallar spans específicos o realizar consultas entre y dentro de los traces. A partir de esto, traceview sigue siendo el principal medio de visualización. Mientras persista esta situación, la trazabilidad distribuida ocupará (en el mejor de los casos) el cuarto lugar como herramienta de depuración, después de las métricas, registros y stack traces, y en el peor de los casos, será una pérdida de dinero y tiempo.
El problema con traceview
Propósito traceview es ofrecer una imagen completa del recorrido de una solicitud individual a través de todos los componentes del sistema distribuido a los que está relacionada. Algunos sistemas de trazado más avanzados permiten detallar spans individuales y ver el desglose por tiempo dentro de un proceso (cuando los spans tienen límites funcionales).
La premisa básica de la arquitectura de microservicios es la idea de que la estructura organizativa crece junto con las necesidades de la empresa. Los defensores de los microservicios afirman que la distribución de diversas tareas empresariales en servicios individuales permite que pequeños equipos de desarrollo autónomos controlen todo el ciclo de vida de dichos servicios, otorgándoles la capacidad de crear, probar y desplegar estos servicios de forma independiente. Sin embargo, la desventaja de tal distribución es la pérdida de información sobre cómo cada servicio interactúa con los demás. En tales condiciones, el seguimiento distribuido reclama ser una herramienta indispensable para de depuración interacciones complejas entre servicios.
Si realmente tienes una , ninguna persona es capaz de mantener en mente su imagen completa. En realidad, desarrollar una herramienta partiendo de la suposición de que esto es posible, es algo así como un antipatrón (un enfoque ineficaz e improductivo). Idealmente, para depurar se necesita una herramienta que ayude a restringir el área de búsqueda , para que los ingenieros puedan centrarse en un subconjunto de métricas (servicios/usuarios/anfitriones, etc.) que son relevantes para el escenario del problema. Al determinar la causa de una falla, los ingenieros no están obligados a entender lo que ocurrió entodos los servicios a la vez , ya que tal requisito contradiría la misma idea de la arquitectura de microservicios.Sin embargo, el traceview representa
justamente esto. Sí, algunos sistemas de seguimiento ofrecen traceviews comprimidos cuando el número de spans en un trace es tan grande que no se puede visualizar en una sola representación. Sin embargo, debido a la gran cantidad de información contenida incluso en tal visualización recortada, los ingenieros aún se ven obligados a filtrarla manualmente, reduciendo la muestra a un conjunto de servicios que son la fuente de los problemas. Lamentablemente, en este campo, las máquinas son significativamente más rápidas que los humanos, menos propensas a errores y sus resultados son más repetibles. Otra razón por la que considero que el método traceview es incorrecto está relacionada con el hecho de que no es adecuado para la depuración basada en hipótesis. En su esencia, la depuración es un
proceso iterativo iterativo un proceso que comienza con una hipótesis, seguido por la verificación de diversas observaciones y hechos obtenidos del sistema a través de diferentes vectores, conclusiones/resúmenes y una posterior evaluación de la veracidad de la hipótesis.
Posibilidad rápido y barato probar hipótesis y mejorar el modelo mental en consecuencia es fundamental para la depuración. Cualquier herramienta de depuración debe ser interactiva y reducir el espacio de búsqueda o, en caso de una pista falsa, permitir al usuario retroceder y enfocarse en otra área del sistema. La herramienta ideal hará esto proactivamente, capturando de inmediato la atención del usuario hacia áreas potencialmente problemáticas.
Lamentablemente, traceview no se puede considerar como una herramienta con una interfaz interactiva. Lo mejor que se puede esperar al usarla es descubrir alguna fuente de latencias elevadas y revisar varios tags y logs relacionados. Esto no ayuda al ingeniero a identificar patrones en el tráfico, como la especificidad de la distribución de latencias, o detectar correlaciones entre diversas mediciones. puede ayudar a eludir algunos de estos problemas. De hecho, de análisis exitoso utilizando aprendizaje automático para identificar spans anómalos e identificar un subconjunto de tags que pueden estar relacionados con comportamientos anómalos. Sin embargo, aún no me he encontrado con visualizaciones contundentes de los hallazgos realizados mediante aprendizaje automático o análisis de datos aplicados a los spans que difieran significativamente de traceview o DAG (gráfico acíclico dirigido).
Los spans son demasiado de bajo nivel
El problema fundamental con traceview es que los spans son primitivas demasiado de bajo nivel tanto para el análisis de latencias como para el análisis de las causas raíz. Es como analizar instrucciones individuales del procesador en un intento de resolver una excepción, sabiendo que hay herramientas de nivel superior como backtrace, que son mucho más cómodas de usar.
Además, me atreveré a afirmar lo siguiente: en ideal, no necesitamos en absoluto una visión completa que ocurre durante el ciclo de vida de la solicitud, que representan las herramientas modernas de trazado. En su lugar, se requiere algún tipo de abstracción de nivel superior que contenga información sobre qué salió mal (por analogía con el backtrace), junto con algo de contexto. En lugar de observar todo el trace, prefiero ver su parte, donde sucede algo interesante o inusual. Actualmente, la búsqueda se realiza de forma manual: el ingeniero recibe el trace y analiza los spans en busca de algo interesante. El enfoque, donde las personas se quedan mirando los spans en diferentes traces con la esperanza de detectar actividad sospechosa, no es escalable (especialmente cuando tienen que comprender todos los metadatos codificados en varios spans, como el ID del span, el nombre del método RPC, la duración del span, los logs, las etiquetas, etc.).
Alternativas a traceview
Los resultados de trazado son más útiles cuando se pueden visualizar de tal manera que se obtenga una representación no trivial de lo que ocurre en las partes interrelacionadas del sistema. Hasta que esto no se logre, el proceso de depuración sigue siendo en gran medida inercial y depende de la capacidad del usuario para notar las correlaciones correctas, verificar las partes adecuadas del sistema o juntar las piezas del rompecabezas, a diferencia de la herramienta, que ayuda al usuario a formular estas hipótesis.
No soy un diseñador visual ni un especialista en UX, pero en la siguiente sección quiero compartir algunas ideas sobre cómo podrían verse estas visualizaciones.
Enfoque en servicios específicos
En un contexto donde la industria se consolida en torno a las ideas de , parece razonable que los equipos individuales deban enfocarse principalmente en asegurar que sus servicios cumplan con estos objetivos. De esto se deduce que una visualización orientada al servicio es la más adecuada para dichos equipos.
Los traces, especialmente sin muestreo, son una mina de información sobre cada componente de un sistema distribuido. Esta información se puede proporcionar a un inteligente procesador que entregará a los usuarios hallazgos orientados al servicio. Pueden ser identificados de antemano, incluso antes de que el usuario mire los traces:
- Diagramas de distribución de latencias solo para solicitudes altamente destacadas (outlier requests);
- Diagramas de distribución de latencias en situaciones donde no se alcanzan los objetivos de SLO del servicio;
- Las etiquetas más "comunes", "interesantes" y "extrañas" en solicitudes que se repiten con mayor frecuencia repetidas;
- Desglose de latencias para situaciones donde dependencias del servicio no alcanzan los objetivos de SLO establecidos;
- Desglose de latencias por diferentes servicios downstream.
Algunas de estas preguntas simplemente no pueden ser respondidas por las métricas incorporadas, obligando a los usuarios a examinar cuidadosamente los spans. Al final, tenemos un mecanismo extremadamente hostil hacia el usuario.
En este sentido, surge la pregunta: ¿qué pasa con las interacciones complejas entre diversos servicios, controlados por diferentes equipos? ¿No se considera traceview la herramienta más adecuada para iluminar dicha situación?
Los desarrolladores móviles, los propietarios de servicios sin estado, los propietarios de servicios con estado gestionados (como bases de datos) y los propietarios de plataformas pueden estar interesados en una representación diferente de un sistema distribuido; este es un enfoque demasiado universal para estas necesidades fundamentalmente diferentes. Incluso en una arquitectura de microservicios muy compleja, los propietarios de servicios no necesitan un conocimiento profundo de más de dos o tres servicios upstream y downstream. En esencia, en la mayoría de los escenarios, a los usuarios les basta con responder preguntas relacionadas con traceview un conjunto limitado de servicios Esto es comparable a mirar un pequeño subconjunto de servicios a través de una lupa para un estudio minucioso. Esto permitirá al usuario formular preguntas más urgentes sobre la interacción compleja entre estos servicios y sus dependencias directas. Es similar a un backtrace en el ámbito de los servicios, donde el ingeniero sabe.
qué no está bien, y también tiene cierta comprensión de lo que ocurre en los servicios circundantes para entender, que no así, sino que también tiene cierta idea de lo que ocurre en los servicios circundantes para entender, por la cual.
El enfoque que propongo es completamente opuesto al enfoque "de arriba hacia abajo", basado en traceview, donde el análisis comienza con el trace completo y luego se desglosa gradualmente en spans individuales. En cambio, el enfoque "de abajo hacia arriba" comienza con el análisis de una pequeña área, cercana a la posible causa del incidente, y luego se amplía el espacio de búsqueda según sea necesario (con la posible participación de otros equipos para analizar un espectro más amplio de servicios). Este segundo enfoque está mejor adaptado para verificar rápidamente las hipótesis iniciales. Una vez que se obtienen resultados concretos, se puede pasar a un análisis más dirigido y detallado.
Construcción de topología
Las vistas vinculadas a un servicio específico pueden ser increíblemente útiles si el usuario sabe qué servicio o grupo de servicios está causando el aumento de latencias o es la fuente de errores. Sin embargo, en un sistema complejo, identificar el servicio infractor puede ser una tarea no trivial durante una falla, especialmente si no se han recibido mensajes de error de los servicios.
La construcción de la topología de servicios puede ayudar mucho a determinar qué servicio está mostrando un aumento en la frecuencia de errores o un incremento en la latencia, lo que lleva a un deterioro notable del rendimiento del servicio. Hablando de la construcción de la topología, me refiero no a un mapa de servicios, que muestra cada servicio disponible en el sistema y es conocido por sus . Esta representación no es mejor que un traceview basado en un grafo acíclico dirigido. En cambio, me gustaría ver una topología de servicios generada dinámicamente, basada en ciertos atributos, como la frecuencia de errores, el tiempo de respuesta o cualquier parámetro definido por el usuario que ayude a aclarar la situación en torno a servicios específicos sospechosos.
Tomemos un ejemplo. Imaginemos un hipotético sitio de noticias. El servicio de la página principal (front page) intercambia datos con Redis, con el servicio de recomendaciones, con el servicio de publicidad y el servicio de video. El servicio de video toma los videos de S3, mientras que los metadatos provienen de DynamoDB. El servicio de recomendaciones obtiene metadatos de DynamoDB, carga datos de Redis y MySQL, y envía mensajes a Kafka. El servicio de publicidad obtiene datos de MySQL y envía mensajes a Kafka.
A continuación se muestra un diagrama esquemático de esta topología (muchos programas comerciales para trazar construyen esta topología). Puede ser útil si se necesita entender las dependencias de los servicios. Sin embargo, durante de depuración, cuando un servicio (digamos, el servicio de video) muestra un tiempo de respuesta elevado, tal topología no es muy útil.
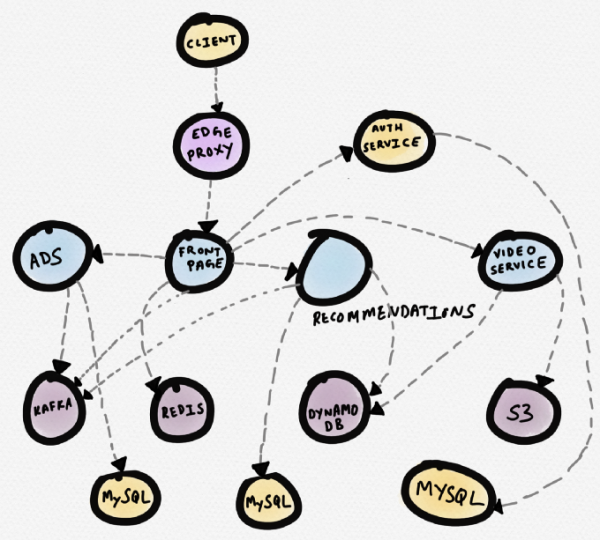
Esquema de servicios de un hipotético sitio de noticias
Sería más adecuado un diagrama como el que se muestra a continuación. En él, el servicio problemático (video) está representado justo en el centro. El usuario lo nota de inmediato. Esta visualización deja claro que el servicio de video está funcionando anómalamente debido al aumento en el tiempo de respuesta de S3, lo que afecta la velocidad de carga de parte de la página principal.
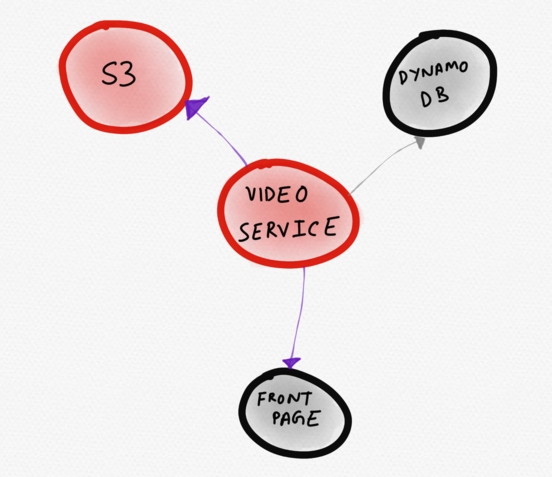
Topología dinámica que muestra solo los servicios «interesantes»
Los esquemas topológicos generados dinámicamente pueden resultar más efectivos que los mapas estáticos de servicios, especialmente en infraestructuras elásticas y con escalado automático. La capacidad de comparar y correlacionar las topologías de los servicios permite al usuario hacer preguntas más relevantes. Preguntas más precisas sobre el sistema tienen más probabilidades de llevar a una mejor comprensión de cómo funciona el sistema.
Visualización comparativa
Otra visualización útil sería la visualización comparativa. Actualmente, los trazados no se adaptan bien para comparaciones lado a lado, por lo que generalmente se comparan los spans. La idea principal de este artículo es que los spans son demasiado de bajo nivel como para extraer la información más valiosa de los resultados de trazado.
Comparar dos trazados no requiere visualizaciones fundamentalmente nuevas. De hecho, es suficiente con algo como un histograma que represente la misma información que un traceview. Sorprendentemente, incluso este método simple puede generar mucho más valor que simplemente examinar dos trazados por separado. La capacidad de hacerlo sería aún más poderosa. visualizar comparación de trazas en conjunto. Sería extremadamente útil ver cómo un reciente cambio en la configuración de la base de datos con la inclusión de GC (recolección de basura) afecta al tiempo de respuesta del servicio downstream durante varias horas. Si lo que describo aquí parece similar a un análisis A/B del impacto de los cambios en la infraestructura en múltiples servicios con la ayuda de los resultados de trazado, no estás demasiado lejos de la verdad.
Conclusión
No cuestiono la utilidad del trazado en sí. Creo sinceramente que no existe otro método para recopilar datos tan ricos, casuales y contextuales como los que se encuentran en una traza. Sin embargo, también creo que todas las soluciones de trazado utilizan estos datos de manera extremadamente ineficiente. Mientras las herramientas de trazado se centren en la vista de trazas, estarán limitadas en su capacidad para aprovechar al máximo la valiosa información que se puede extraer de los datos de las trazas. Además, existe el riesgo de desarrollar una interfaz visual completamente poco amigable e intuitiva, que limitará enormemente la capacidad del usuario para depurar la aplicación.
Depurar sistemas complejos, incluso utilizando las herramientas más nuevas, es increíblemente complicado. Las herramientas deben ayudar al desarrollador a formular y verificar hipótesis, proporcionando activamente información relevante, identificando outliers y señalando características en la distribución de latencias. Para que el trazado se convierta en la herramienta preferida por los desarrolladores al solucionar fallos en producción o resolver problemas que abarcan varios servicios, se requieren interfaces de usuario originales y visualizaciones que se alineen más estrechamente con el modelo mental de los desarrolladores que crean y operan estos servicios.
Se requerirán serios esfuerzos mentales para diseñar un sistema que represente diversas señales disponibles en los resultados de trazado de una manera optimizada para facilitar el análisis y la deducción. Se debe considerar cómo abstraer la topología del sistema durante la depuración de tal manera que ayude al usuario a superar las áreas ciegas sin tener que examinar trazas o spans individuales.
Necesitamos buenas capacidades de abstracción y segmentación (especialmente en la interfaz de usuario). Estas deben integrarse bien en el proceso de depuración basado en hipótesis, donde se pueden formular preguntas de manera iterativa y verificar las hipótesis. No resolverán automáticamente todos los problemas de observabilidad, pero ayudarán a los usuarios a agudizar su intuición y a formular preguntas más ponderadas. Hago un llamado a un enfoque más reflexivo e innovador en el ámbito de la visualización. Hay una perspectiva real para expandir los horizontes.
P.D. del traductor
También puedes leer en nuestro blog:
- «»;
- «»;
- «».
Fuente: habr.com
