

Se dice que en la vida todo vale la pena probar al menos una vez. Y si estás acostumbrado a trabajar con bases de datos relacionales, conocer NoSQL en la práctica es algo que deberías hacer, al menos para tu desarrollo personal. Actualmente, debido al rápido avance de esta tecnología, hay muchas opiniones contradictorias y acalorados debates al respecto, lo que aumenta aún más el interés.
Si profundizas en la esencia de todos estos debates, podrás ver que surgen debido a un enfoque incorrecto. Aquellos que utilizan bases de datos NoSQL en los lugares que realmente necesitan están satisfechos y obtienen todas las ventajas de esta solución. En cambio, los experimentadores que ven esta tecnología como una panacea en situaciones donde no es aplicable se sienten decepcionados, perdiendo las fortalezas de las bases de datos relacionales sin obtener beneficios significativos.
Les contaré sobre nuestra experiencia en la implementación de una solución basada en la base de datos Cassandra: con qué nos encontramos, cómo superamos situaciones difíciles, si logramos obtener beneficios del uso de NoSQL y dónde tuvimos que invertir esfuerzos adicionales.
La tarea inicial era construir un sistema que registre llamadas en un almacén.
El principio de funcionamiento del sistema es el siguiente. Se reciben archivos con una estructura específica que describe la llamada. Luego, la aplicación se encarga de guardar esa estructura en las columnas correspondientes. Posteriormente, las llamadas almacenadas se utilizan para mostrar información sobre el consumo de tráfico para los abonados (cobros, llamadas, historial de saldo).
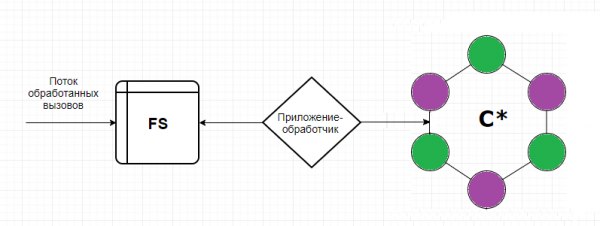
Por qué elegimos Cassandra es bastante claro: escribe como una ametralladora, es fácilmente escalable y tolerante a fallos.
Así que, esto es lo que nos trajo la experiencia
Sí, un nodo caído no es una tragedia. Esa es la esencia de la tolerancia a fallos de Cassandra. Pero un nodo puede estar en funcionamiento y aún así experimentar una disminución en el rendimiento.. Como se ha descubierto, esto afecta inmediatamente al rendimiento de todo el clúster.
Cassandra no protegerá donde Oracle salvaba con sus restricciones.. Y si el autor de la aplicación no lo entendió de antemano, entonces el duplicado que llega para Cassandra es tan bueno como el original. Si llegó, lo insertamos.
La versión gratuita de Cassandra ‘de fábrica’ no fue bien recibida por la seguridad de la información: no hay registro de las acciones de los usuarios, tampoco hay diferenciación de derechos.La información sobre las llamadas se refiere a datos personales, lo que significa que todos los intentos de solicitarlos/modificarlos deben ser registrados con la posibilidad de auditoría posterior. También es necesario reconocer la importancia de separar los derechos en diferentes niveles para diferentes usuarios. Un ingeniero de operaciones y un superadministrador, que pueden eliminar todo el keyspace sin restricciones, son roles diferentes, con distintas responsabilidades y competencias. Sin esta delimitación de los derechos de acceso, el valor y la integridad de los datos estarán en cuestión más rápidamente que con un nivel de consistencia ANY.
No tuvimos en cuenta que se requiere una análisis seria de las llamadas, así como muestreos periódicos bajo diversas condiciones. Dado que se prevé eliminar y sobrescribir los registros seleccionados (en el marco de la tarea, debemos mantener el proceso de actualización de datos ante datos incorrectos inicialmente recibidos), Cassandra no es la mejor opción aquí. Cassandra, como alcancía, es conveniente para almacenar, pero no puede realizar cálculos.
Nos encontramos con un problema al transferir datos a zonas de prueba. (5 nodos en la prueba frente a 20 en producción). No se podrá utilizar un volcado en este caso.
Problema con las actualizaciones del esquema de datos de la aplicación que escribe en Cassandra. Una reversión generará una gran cantidad de tumbas, lo que puede afectar nuestro rendimiento de manera impredecible.Cassandra está optimizada para escritura, y antes de escribir, no piensa mucho. Cualquier operación con datos existentes en ella también es una escritura. Es decir, al eliminar lo innecesario, simplemente generamos más registros, y solo una parte de ellos será marcada como tumbas.
Tiempo de espera en las inserciones. Cassandra es excelente en escritura, pero a veces el flujo de entrada puede complicarla considerablemente.Esto sucede cuando la aplicación comienza a repetir varios registros que no se pueden insertar por alguna razón. Y necesitaremos un verdadero DBA que supervise gc.log, los registros del sistema y de depuración en busca de consultas lentas, y métricas sobre la compactación pendiente.
Varios centros de datos en el clúster. ¿De dónde leer y a dónde escribir?
¿Es posible dividir entre lectura y escritura? Y si es así, ¿debería el DC para escritura o lectura estar más cerca de la aplicación? ¿Podríamos tener un verdadero split brain si elegimos incorrectamente el nivel de consistencia? Hay muchas preguntas, muchas configuraciones desconocidas, posibilidades que realmente queremos explorar.
Cómo lo resolvimos
Para que el nodo no se desacelere, desactivamos SWAP. Y ahora, cuando falte memoria, el nodo debería caer, en lugar de generar largas pausas de recolección de basura.
Así que ya no confiamos en la lógica en la base de datos. Los desarrolladores de la aplicación están reentrenándose y comenzando a protegerse activamente en su propio código. Una separación clara y perfecta entre el almacenamiento y el procesamiento de datos.
Compramos soporte de DataStax. Ya han dejado de desarrollar Cassandra de caja (el último commit fue en febrero de 2018). Al mismo tiempo, Datastax ofrece un excelente servicio y una gran cantidad de soluciones mejoradas y adaptadas a los sistemas existentes.
También quiero señalar que Cassandra no es muy cómoda para las consultas de selección. Por supuesto, CQL es un gran paso hacia los usuarios (en comparación con Thrift). Pero si tienes departamentos completos acostumbrados a tales uniones convenientes, a la filtración libre por cualquier campo y a las posibilidades de optimización de consultas, y estos departamentos trabajan para cerrar reclamos y emergencias, la solución en Cassandra les parece hostil y tonta. Y comenzamos a buscar cómo nuestros colegas pueden realizar selecciones.
Se consideraron dos opciones. En la primera opción, escribimos las llamadas no solo en C*, sino también en la base de datos archivada de Oracle. Sin embargo, a diferencia de C*, en esta base de datos solo se almacenan las llamadas del mes actual (una profundidad de almacenamiento suficiente para los casos de re-etiquetado). Aquí se vislumbró de inmediato el siguiente problema: si escribimos de forma sincrónica, perdemos todas las ventajas de C*, relacionadas con la inserción rápida; si lo hacemos de forma asincrónica, no hay garantía de que todas las llamadas necesarias realmente hayan sido ingresadas en Oracle. Pero había una ventaja significativa: para la operación, sigue siendo el mismo PL/SQL Developer familiar, es decir, prácticamente realizamos el patrón de
Al final, nos decidimos por la segunda opción. Para las selecciones de diferentes bancos, utilizamos Apache Spark. La esencia del mecanismo se redujo a un código en Java, que, según las claves especificadas (suscriptor, hora de la llamada - claves de la sección), extrae datos de C*, así como los datos necesarios para enriquecer desde cualquier otra base de datos. Luego, los une en su memoria y muestra el resultado en una tabla de resultados. Sobre Spark, dibujamos una interfaz web y resultó ser bastante adecuada para la operación.
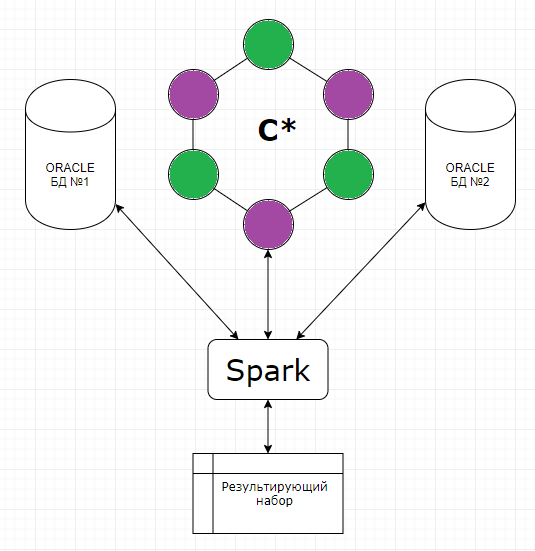
Al abordar la tarea de actualización de datos, el equipo de producción volvió a evaluar varias soluciones. Tanto la transferencia a través de Sstloader como la opción de dividir el clúster en el área de prueba en dos partes, cada una de las cuales se alterna en un clúster con el de producción, con este último alimentándolo. Al actualizar la prueba, se planeaba intercambiarlas: la parte que trabajaba en la prueba se limpiaría e introduciría en producción, mientras que la otra comenzaría a trabajar con los datos por separado. Sin embargo, tras una segunda reflexión, evaluamos de manera más racional qué datos vale la pena transferir y nos dimos cuenta de que las llamadas en sí son una entidad inconsistente para las pruebas, generándose rápidamente en caso de necesidad, y precisamente el conjunto de datos de producción no tiene valor para ser transferido a pruebas. Hay varios objetos acumuladores que vale la pena transferir, pero son literalmente un par de tablas, y no son muy pesadas. Así que, como solución, Spark volvió a ayudar, con el cual escribimos y comenzamos a utilizar de manera activa un script para la transferencia de datos entre las tablas de producción y prueba.
Nuestra política actual de despliegue nos permite trabajar sin retrocesos. Antes de proceder a producción, se requiere un despliegue obligatorio en pruebas, donde el error no tiene tanto costo. En caso de fracaso, siempre se puede eliminar el caso y aplicar todo el esquema desde el principio.
Para garantizar la disponibilidad continua de Cassandra se necesita un DBA y no solo él. Todos los que trabajan con la aplicación deben entender dónde y cómo ver la situación actual y cómo diagnosticar problemas de manera oportuna. Para ello, utilizamos activamente DataStax OpsCenter (Administración y monitoreo de cargas de trabajo), métricas del sistema del controlador de Cassandra (número de timeouts de escritura en C*, número de timeouts de lectura desde C*, latencia máxima, etc.), y monitoreamos la operación de la propia aplicación que trabaja con Cassandra.
Al reflexionar sobre la pregunta anterior, nos dimos cuenta de dónde podría estar el principal riesgo. Este riesgo radica en las formas de visualización de datos que extraen información de múltiples consultas independientes a la base de datos. De este modo, podríamos obtener información bastante inconsistente. Sin embargo, este problema también sería relevante si solo estuviéramos trabajando con un solo centro de datos. Por lo tanto, la opción más sensata aquí es, por supuesto, implementar una función de lectura de datos por lotes en una aplicación externa, que asegure la obtención de datos dentro de un mismo período de tiempo. En lo que respecta a la separación entre lectura y escritura en términos de rendimiento, nos detuvo el riesgo de que, ante alguna pérdida de conexión entre los centros de datos, pudiéramos obtener dos clústeres completamente inconsistentes entre sí.
En resumen, actualmente nos hemos decidido por un nivel de consistencia de escritura de EACH_QUORUM y de lectura de LOCAL_QUORUM
Impresiones y conclusiones breves
Para evaluar la solución obtenida desde el punto de vista del soporte operativo y las perspectivas de desarrollo futuro, decidimos pensar en dónde más podría aplicarse tal desarrollo.
Si pensamos rápidamente, sería el scoring de datos para programas tipo 'Paga cuando te convenga' (cargamos información en C* y realizamos cálculos en scripts de Spark), la gestión de reclamaciones con agregación por categorías, almacenamiento de roles y cálculo basado en la matriz de roles de acceso de los usuarios.
Como podemos ver, el repertorio es amplio y variado. Y si tenemos que elegir un bando entre los defensores y opositores de NoSQL, nos uniremos a los defensores, ya que hemos obtenido sus beneficios, especialmente donde los esperábamos.
Incluso la opción de Cassandra lista para usar permite realizar escalabilidad horizontal en tiempo real, resolviendo de manera absolutamente indolora la cuestión del aumento de datos en el sistema. Logramos llevar a cabo un mecanismo de cálculo de agregados de llamadas altamente cargado en un contorno separado, además de dividir el esquema y la lógica de la aplicación, eliminando la práctica perjudicial de escribir trabajos y objetos personalizados directamente en la base de datos. Obtuvimos la posibilidad de elegir y configurar, para acelerar, en qué centros de datos vamos a realizar los cálculos y en cuáles se registrarán los datos, asegurándonos contra caídas tanto de nodos individuales como del centro de datos en su conjunto.
Al aplicar nuestra arquitectura a nuevos proyectos, y ya teniendo cierta experiencia, quisiera tener en cuenta los aspectos mencionados anteriormente de inmediato y evitar ciertos errores, suavizando algunos puntos críticos que no pudimos evitar inicialmente.
Por ejemplo, monitorear oportunamente las actualizaciones de Cassandra, porque muchos de los problemas que enfrentamos ya eran conocidos y se habían solucionado.
No colocar tanto la base de datos como Spark en los mismos nodos (o mantener estrictamente separados los recursos permitidos), ya que Spark puede consumir más memoria RAM de la permitida, y rápidamente obtendremos el problema número 1 de nuestra lista.
Mejorar el monitoreo y la competencia operativa ya en la etapa de pruebas del proyecto. Inicialmente tener en cuenta al máximo todos los posibles consumidores de nuestra solución, porque de esto dependerá la estructura final de la base de datos.
Revisar varias veces el esquema resultante en busca de posibles optimizaciones. Identificar qué campos se pueden serializar. Entender qué tablas adicionales necesitamos crear para considerar de manera más precisa y óptima, y luego devolver la información requerida a través de las consultas (por ejemplo, suponiendo que los mismos datos se pueden almacenar en diferentes tablas, considerando diferentes desagregaciones por diferentes criterios, se puede ahorrar tiempo del procesador en las consultas de lectura).
No está mal prever desde el principio la asignación de TTL y la limpieza de datos obsoletos.
Al exportar datos de Cassandra la lógica de la aplicación debe funcionar bajo el principio de FETCH, para que no todas las filas se carguen en memoria de una vez, sino que se seleccionen por lotes.
Es recomendable verificar la resistencia a fallos del sistema antes de la migración del proyecto a la solución descrita realizando una serie de pruebas de estrés, como la pérdida de datos en un centro de datos, la recuperación de datos dañados durante un período, caídas de red entre centros de datos. Estas pruebas no solo permitirán evaluar los pros y los contras de la arquitectura propuesta, sino que también proporcionarán una buena práctica a los ingenieros que las realicen, y la habilidad adquirida no será en vano si los fallos del sistema se reproducen en producción.
Si trabajamos con información crítica (como datos para la facturación o el cálculo de deudas del suscriptor), también debemos prestar atención a las herramientas que permitan reducir los riesgos derivados de las particularidades de la base de datos. Por ejemplo, utilizar la utilidad nodesync (Datastax), desarrollando una estrategia óptima para su uso, para no generar una carga excesiva en Cassandra por razones de consistencia y utilizarla solo para ciertas tablas en un periodo específico.
¿Qué tal, después de medio año de vida con Cassandra? En general, no hay problemas sin resolver. No hemos sufrido accidentes graves ni pérdidas de datos. Sí, tuvimos que pensar en la compensación de algunos problemas que antes no existían, pero al final esto no afectó gravemente nuestra solución arquitectónica. Si estás dispuesto a probar algo nuevo y no te asusta la idea de experimentar, ten en cuenta que no hay nada gratuito. Tendrás que investigar, sumergirte en la documentación y recolectar tus propios obstáculos más que con una solución heredada antigua, y ninguna teoría te podrá decir de antemano qué obstáculos te esperan a ti en particular.
Fuente: habr.com
