

A lo largo de los años, Pinterest ha reunido 300 millones de usuarios que han creado más de 200 mil millones de pins en más de 4 mil millones de tableros. Para atender a este ejército de usuarios y a su vasta base de contenido, el portal ha desarrollado miles de servicios, desde microservicios que pueden manejar varios CPU, hasta gigantescos monolitos que operan en todo un parque de máquinas virtuales. Y llegó el momento en que la compañía puso su mirada en k8s. ¿Qué es lo que atrajo a «Pinterest» hacia «el cubo»? De esto te enterarás en nuestra traducción del artículo reciente de .
Así que, cientos de millones de usuarios y cientos de miles de pins. Para atender a este ejército de usuarios y a su vasta base de contenido, hemos desarrollado miles de servicios, desde microservicios que pueden manejar varios CPU, hasta gigantescos monolitos que operan en un parque completo de máquinas virtuales. Además, contamos con diversos frameworks que también pueden requerir recursos de CPU, memoria o acceso a operaciones de entrada/salida.
En el proceso de mantener este zoológico de herramientas, el equipo de desarrollo enfrenta varios problemas:
- Los ingenieros no tienen un método unificado para lanzar entornos de trabajo. Los servicios sin estado, los servicios con estado y los proyectos en desarrollo se basan en pilas tecnológicas completamente diferentes. Esto ha llevado a la creación de todo un curso de capacitación para ingenieros, complicando seriamente el trabajo de nuestro equipo de infraestructura.
- Los desarrolladores, que disponen de su propio parque de máquinas virtuales, generan una carga enorme para los administradores internos. Como resultado, operaciones tan simples como la actualización del sistema operativo o de AMI se alargan a semanas y meses. Esto lleva a un aumento de la carga en situaciones que, a primera vista, parecen ordinarias.
- Dificultades en la creación de herramientas de gestión de infraestructura global sobre soluciones ya existentes. La situación se complica aún más por el hecho de que no es sencillo encontrar a los propietarios de las máquinas virtuales. Es decir, no sabemos si es seguro liberar esos recursos para trabajar en otras áreas de nuestra infraestructura.
Los sistemas de orquestación de contenedores son una forma de unificar la gestión de la carga de trabajo. Le abren el camino para aumentar la velocidad de desarrollo y simplifican la gestión de la infraestructura, ya que todos los recursos involucrados en el proyecto son gestionados por un único sistema centralizado.
Figura 1: Prioridades de la infraestructura (fiabilidad, rendimiento de los desarrolladores y eficiencia).
El equipo de Cloud Management Platform en Pinterest se familiarizó con K8s en 2017. Para la primera mitad de 2017, documentamos la mayor parte de nuestra capacidad productiva, incluidos los API y todos nuestros servidores web. Luego realizamos una evaluación minuciosa de varios sistemas de orquestación de soluciones de contenedores, creación de clústeres y su funcionamiento. A finales de 2017, decidimos utilizar Kubernetes. Era lo suficientemente flexible y contaba con un amplio soporte en la comunidad de desarrolladores.
En la actualidad, hemos creado nuestras propias herramientas de inicialización del clúster basadas en Kops y hemos migrado a Kubernetes los componentes existentes de la infraestructura, como la red, la seguridad, las métricas, la gestión de registros, la gestión de identidades y el tráfico. También hemos implementado un sistema de modelado de cargas de trabajo para nuestro recurso, cuya complejidad está oculta a los desarrolladores. Ahora estamos enfocados en garantizar la estabilidad del clúster, su escalabilidad y la incorporación de nuevos clientes.
Kubernetes: el camino de Pinterest
Comenzar a trabajar con Kubernetes a gran escala en Pinterest como una plataforma que será apreciada por nuestros ingenieros presentó numerosos desafíos.
Como empresa grande, hemos invertido grandes cantidades de dinero en herramientas de infraestructura. Por ejemplo, herramientas de seguridad que procesan certificados y distribuyen claves, componentes de control de tráfico, sistemas de descubrimiento de servicios, componentes de visibilidad y envío de registros y métricas. Todo esto se reunió no por casualidad: pasamos por un camino normal de prueba y error, y por ello queríamos integrar todo esto en la nueva infraestructura sobre Kubernetes en lugar de reinventar la rueda antigua en una nueva plataforma. Este enfoque, en general, simplificó la migración, ya que todo el soporte de aplicaciones ya existe y no necesita ser creado desde cero.
Por otro lado, los modelos de pronóstico de carga en Kubernetes (como implementaciones, trabajos y conjuntos de Daemon) son insuficientes para nuestro proyecto. Estos problemas de usabilidad son enormes obstáculos en el camino hacia la adopción de Kubernetes. Por ejemplo, hemos escuchado a desarrolladores de servicios quejándose de la falta o la configuración incorrecta de las entradas. También hemos encontrado un uso inadecuado de los generadores de plantillas, cuando se crearon cientos de copias con la misma especificación y tarea, lo que resultó en problemas de depuración aterradores.
También fue muy difícil mantener diferentes versiones en un mismo clúster. Imagina la complejidad del soporte al cliente, si necesitas trabajar en múltiples versiones del mismo entorno de ejecución, lidiando con todos sus problemas, errores y actualizaciones.
Recursos personalizados y controladores de Pinterest
Para facilitar el proceso de implementación de Kubernetes para nuestros ingenieros, así como para simplificar la infraestructura y acelerar su funcionamiento, hemos desarrollado nuestras propias definiciones de recursos personalizados (CRD).
Las CRD proporcionan las siguientes funcionalidades:
- Unificación de varios recursos nativos de Kubernetes para que funcionen como una única carga. Por ejemplo, el recurso PinterestService incluye la implementación, el servicio de entrada y el mapa de configuración. Esto permite a los desarrolladores no preocuparse por la configuración de DNS.
- Implementación del soporte de aplicaciones necesario. El usuario debe centrarse únicamente en la especificación del contenedor según su lógica de negocio, mientras que el controlador de la CRD implementa todos los init-containers, variables de entorno y especificaciones de pod necesarias. Esto proporciona un nivel de comodidad completamente diferente para los desarrolladores.
- Los controladores de la CRD también gestionan el ciclo de vida de sus propios recursos y mejoran la disponibilidad de depuración. Esto incluye la conciliación de las especificaciones deseadas y reales, la actualización del estado de la CRD y el registro de eventos, entre otros. Sin la CRD, los desarrolladores tendrían que gestionar un conjunto numeroso de recursos, lo que aumentaría la probabilidad de errores.
Aquí hay un ejemplo de PinterestService y un recurso interno que es gestionado por nuestro controlador:
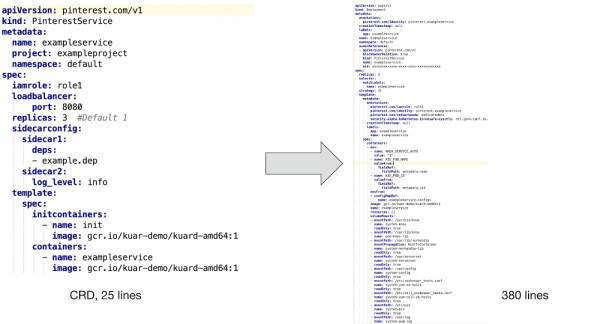
Como se puede ver arriba, para apoyar el contenedor personalizado, necesitamos integrar en él un contenedor de inicialización y varios complementos para asegurar la seguridad, la visibilidad y el manejo del tráfico de red. Además, hemos creado plantillas de configuración y hemos implementado el soporte para plantillas de PVC para trabajos por lotes, así como el seguimiento de múltiples variables de entorno para monitorear la identificación, el consumo de recursos y la recolección de 'basura'.
Es difícil imaginar que los desarrolladores quieran escribir estos archivos de configuración manualmente sin soporte de CRD, sin mencionar el mantenimiento y depuración adicionales de las configuraciones.
Flujo de trabajo de despliegue de aplicaciones
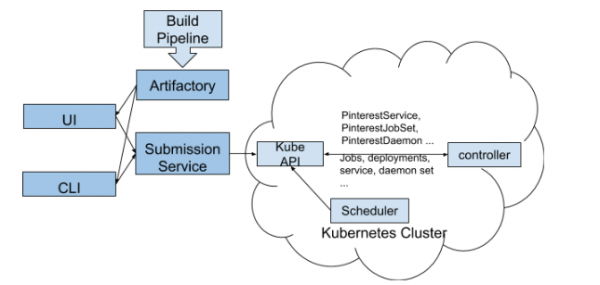
En la imagen anterior se muestra cómo desplegar un recurso personalizado de Pinterest en un clúster de Kubernetes:
- Los desarrolladores interactúan con nuestro clúster de Kubernetes a través de CLI e interfaz de usuario.
- Las herramientas CLI / UI extraen archivos YAML de configuración del flujo de trabajo y otras propiedades de construcción (la misma identificación de versión) de Artifactory, luego los envían al Servicio de Sometimiento de Trabajo. Este paso garantiza que solo se implementen versiones funcionales en el clúster.
- JSS actúa como un gateway para diversas plataformas, incluyendo Kubernetes. Aquí se lleva a cabo la autenticación del usuario, la asignación de cuotas y la verificación parcial de la configuración de nuestro CRD.
- Después de validar el CRD en el lado de JSS, la información se envía a la API de la plataforma k8s.
- Nuestro controlador CRD supervisa los eventos en todos los recursos personalizados. Convierte el CR en recursos nativos de k8s, añade los módulos necesarios, establece las variables de entorno apropiadas y realiza otras tareas auxiliares, garantizando así un apoyo infraestructural adecuado a las aplicaciones personalizadas en contenedores.
- Luego, el controlador CRD envía los datos recibidos a la API de Kubernetes para ser procesados por el scheduler y ser puestos en marcha.
Nota: este flujo de trabajo de implementación en pre-lanzamiento fue creado para los primeros usuarios de la nueva plataforma k8s. Actualmente, estamos en el proceso de perfeccionar este proceso para integrarnos completamente con nuestro nuevo CI/CD. Esto significa que no podemos compartir toda la información relacionada con Kubernetes. Esperamos con ansias la oportunidad de compartir nuestra experiencia y hablar sobre el progreso del equipo en este sentido en nuestra próxima entrada de blog 'Construyendo una plataforma CI/CD para Pinterest'.
Tipos de recursos especiales
Según las necesidades específicas de Pinterest, hemos desarrollado los siguientes CRD que son adecuados para varios flujos de trabajo:
- PinterestService son servicios stateless que han estado funcionando durante mucho tiempo. Muchos de nuestros sistemas principales se basan en un conjunto de estos servicios.
- PinterestJobSet modela trabajos por lotes de ciclo completo. En Pinterest, hay un caso de uso común donde múltiples trabajos ejecutan los mismos contenedores en paralelo, independientemente de otros procesos similares.
- PinterestCronJob se usa ampliamente en conjunto con cargas de trabajo periódicas menores. Esta es una capa para trabajar de manera nativa con cron, con mecanismos de soporte de Pinterest que manejan seguridad, tráfico, registros y métricas.
- PinterestDaemon incluye demonios de infraestructura. Esta familia continúa creciendo, ya que agregamos más soporte para nuestros clústeres.
- PinterestTrainingJob abarca procesos de TensorFlow y PyTorch, proporcionando el mismo nivel de soporte durante la ejecución que todos los demás CRD. Dado que Pinterest utiliza activamente TensorFlow y otros sistemas de aprendizaje automático, teníamos motivos para construir un CRD separado en torno a ellos.
También estamos trabajando en PinterestStatefulSet, que pronto será adaptado para almacenamiento de datos y otros sistemas stateful.
Soporte para el entorno de ejecución
Cuando se lanza un módulo de aplicaciones en Kubernetes, automáticamente recibe un certificado para identificarse a sí mismo. Este certificado se utiliza para acceder al almacén de secretos o para comunicarse con otros servicios a través de mTLS. Mientras tanto, el configurador de inicialización de contenedores y el Daemon cargarán todas las dependencias necesarias antes de iniciar la aplicación en contenedor. Cuando todo esté listo, el sidecar de tráfico y el Daemon registrarán la dirección IP del módulo en nuestro Zookeeper, para que los clientes puedan detectarlo. Todo esto funcionará, ya que el módulo de red se configuró antes de iniciar la aplicación.
Arriba se presentan ejemplos típicos de soporte para cargas de trabajo durante la ejecución. Para otros tipos de cargas de trabajo, puede requerirse un soporte algo diferente, pero todos se presentan en forma de sidecar a nivel de pod, nodos o Daemons a nivel de máquinas virtuales. Nos aseguramos de que todo esto esté desplegado dentro de la infraestructura de gestión y se coordine entre aplicaciones, lo que en última instancia reduce significativamente la carga en términos de trabajos técnicos y soporte al cliente.
Pruebas y QA
Hemos construido un pipeline de pruebas end-to-end sobre la infraestructura de pruebas de Kubernetes ya existente. Estas pruebas se distribuyen entre todos nuestros clústeres. Nuestro pipeline ha pasado por muchas revisiones antes de convertirse en parte del clúster de productos.
Además de los sistemas de prueba, tenemos sistemas de monitoreo y alerta que supervisan continuamente el estado de los componentes del sistema, el consumo de recursos y otros indicadores importantes, notificándonos solo cuando es necesaria la intervención humana.
Alternativas
Hemos considerado algunas alternativas a los recursos personalizados, como controladores de acceso mutacionales y sistemas de plantillas. Sin embargo, todos ellos conllevan serias dificultades operativas, por lo que elegimos el camino de CRD.
El controlador de acceso mutacional se utilizó para introducir sidecars, variables de entorno y otro soporte durante la ejecución. Sin embargo, se encontró con varios problemas, como la vinculación de recursos y la gestión de su ciclo de vida, mientras que en CRD no se presentan tales problemas.
Nota: Los sistemas de plantillas, como los diagramas de Helm, son ampliamente utilizados para lanzar aplicaciones con configuraciones similares. Sin embargo, nuestras aplicaciones de trabajo son demasiado diversas para ser gestionadas mediante plantillas. Además, durante el despliegue continuo al usar plantillas, surgirán demasiados errores.
Trabajo futuro
Actualmente lidiamos con una carga mixta en todos nuestros clústeres. Para mantener este tipo de procesos de diferentes tipos y tamaños, estamos trabajando en las siguientes áreas:
- Un conjunto de clústeres distribuye grandes aplicaciones entre diferentes clústeres para garantizar escalabilidad y estabilidad.
- Garantizar la estabilidad, escalabilidad y visibilidad del clúster para establecer la conexión entre la aplicación y su SLA.
- Gestión de recursos y cuotas, para que las aplicaciones no entren en conflicto entre sí, y para que la escala del clúster sea controlada de nuestra parte.
- Nueva plataforma CI/CD para soportar y desplegar aplicaciones en Kubernetes.
Fuente: habr.com
