

En Mail.ru Group tenemos Tarantool, que es un servidor de aplicaciones en Lua, que además es una base de datos (¿o al revés?). Es rápido y genial, pero las capacidades de un solo servidor aún no son ilimitadas. La escalabilidad vertical tampoco es una panacea, por lo que en Tarantool hay herramientas para la escalabilidad horizontal: el módulo vshard. . Permite particionar datos entre varios servidores, pero tendrás que esforzarte para configurarlo y ajustarlo a la lógica de negocio.
Buenas noticias: hemos aprendido de nuestros tropiezos (por ejemplo , ) y hemos desarrollado un nuevo marco que facilita notablemente la resolución de este problema.
es un nuevo marco para el desarrollo de sistemas distribuidos complejos. Permite centrarse en escribir la lógica de negocio en lugar de resolver problemas de infraestructura. A continuación, explicaré cómo está estructurado este marco y cómo utilizarlo para escribir servicios distribuidos.
¿Y cuál es, en realidad, el problema?
Tenemos Tarantool, tenemos vshard — ¿qué más se puede desear?
En primer lugar, está la comodidad. La configuración de vshard se establece a través de tablas Lua. Para que un sistema distribuido de varios procesos Tarantool funcione correctamente, la configuración debe ser igual en todas partes. Nadie quiere hacer esto manualmente. Por ello, se utilizan diversos scripts, Ansible y sistemas de despliegue.
Cartridge gestiona automáticamente la configuración de vshard, lo hace basándose en su propia configuración distribuida.En esencia, es un simple archivo YAML, cuya copia se almacena en cada instancia de Tarantool. La simplificación radica en que el marco se encarga de su configuración y de asegurarse de que sea la misma en todas partes.
En segundo lugar, nuevamente se trata de la comodidad. La configuración de vshard no tiene nada que ver con el desarrollo de la lógica de negocio y solo distrae al programador de su trabajo. Cuando discutimos la arquitectura de un proyecto, lo más común es hablar sobre componentes individuales y su interacción. Pensar en desplegar un clúster en 3 centros de datos es prematuro.
Hemos enfrentado estos problemas repetidamente, y en algún momento logramos desarrollar un enfoque que simplifica el trabajo con la aplicación a lo largo de todo su ciclo de vida: creación, desarrollo, prueba, CI/CD y mantenimiento.
El Cartridge introduce el concepto de roles para cada proceso de Tarantool. Los roles son esa concepción que permite al desarrollador centrarse en escribir código. Todas las roles existentes en el proyecto se pueden ejecutar en una sola instancia de Tarantool, y para las pruebas será suficiente.
Las principales características de Tarantool Cartridge:
- orquestación automática de clústeres;
- ampliación de la funcionalidad de la aplicación mediante nuevos roles;
- plantilla de aplicación para desarrollo y despliegue;
- sharding automático incorporado;
- integración con el marco de prueba Luatest;
- gestión del clúster a través de WebUI y API;
- herramientas de empaquetado y despliegue.
¡Hola, mundo!
No puedo esperar para mostrar el marco en sí, así que dejemos la charla sobre la arquitectura para más tarde y comencemos con lo simple. Suponiendo que Tarantool ya está instalado, solo queda hacer lo siguiente:
$ tarantoolctl rocks install cartridge-cli
$ export PATH=$PWD/.rocks/bin/:$PATH
Estos dos comandos instalarán las utilidades de línea de comandos y permitirán crear tu primera aplicación a partir de la plantilla:
$ cartridge create --name myappY esto es lo que obtendremos:
myapp/
├── .git/
├── .gitignore
├── app/roles/custom.lua
├── deps.sh
├── init.lua
├── myapp-scm-1.rockspec
├── test
│   ├── helper
│   │   ├── integration.lua
│   │   └── unit.lua
│   ├── helper.lua
│   ├── integration/api_test.lua
│   └── unit/sample_test.lua
└── tmp/
Este es un repositorio git con una aplicación lista de "Hello, World!". Vamos a intentar ejecutarla de inmediato, instalando las dependencias primero (incluido el propio marco):
$ tarantoolctl rocks make
$ ./init.lua --http-port 8080
Así que tenemos un nodo funcionando de la futura aplicación shardeada. Un curioso podría abrir inmediatamente la interfaz web, configurar el clúster de un solo nodo con el ratón y disfrutar del resultado, pero aún no es el momento de alegrarse. Por ahora, la aplicación no puede hacer nada útil, así que hablaré sobre el despliegue más adelante, y ahora es el momento de escribir código.
Desarrollo de aplicaciones
Imagina que estamos diseñando un proyecto que debe recibir datos, almacenarlos y generar un informe una vez al día.
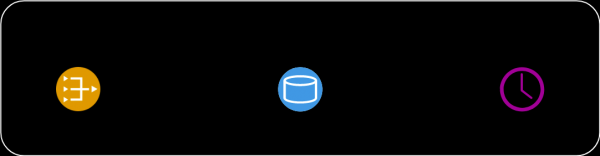
Comenzamos a dibujar un esquema y colocamos tres componentes en él: gateway, storage y scheduler. Trabajamos más en la arquitectura. Dado que estamos utilizando vshard como almacenamiento, añadimos al esquema vshard-router y vshard-storage. Ni el gateway ni el scheduler accederán al almacenamiento directamente, para eso está el router, que es para lo que fue creado.
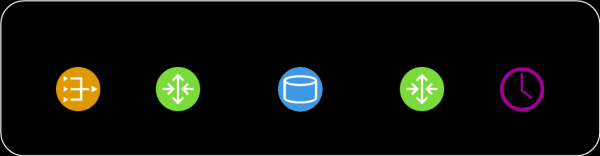
Este esquema aún no refleja con precisión lo que vamos a crear en el proyecto, porque los componentes se ven abstractos. Necesitamos ver cómo se proyectará esto en un Tarantool real: agruparemos nuestros componentes por procesos.
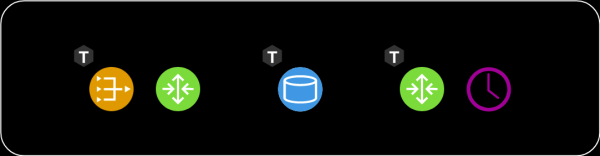
No tiene mucho sentido mantener vshard-router y gateway en instancias separadas. ¿Por qué deberíamos recorrer la red innecesariamente, si eso ya es parte de las responsabilidades del router? Deben ejecutarse dentro de un mismo proceso. Es decir, tanto gateway como vshard.router.cfg se inicializan en un mismo proceso, y que interactúen localmente.
En la etapa de diseño era conveniente trabajar con tres componentes, pero como desarrollador, mientras escribo código, no quiero preocuparme por iniciar tres instancias de Tarantool. Necesito ejecutar pruebas y verificar que he escrito correctamente el gateway. O tal vez quiera mostrar una función a mis colegas. ¿Por qué tendría que lidiar con el despliegue de tres instancias? Así nació el concepto de roles. Un rol es un módulo Lua normal, cuyo ciclo de vida es gestionado por Cartridge. En este ejemplo, hay cuatro: gateway, router, storage, scheduler. En otro proyecto podría haber más. Todos los roles se pueden ejecutar en un mismo proceso, y eso será suficiente.
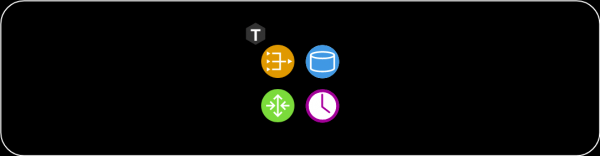
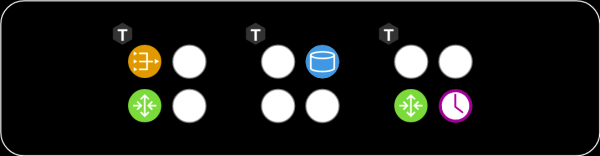
Y cuando se trate de desplegar en staging o en producción, asignaremos a cada proceso de Tarantool su propio conjunto de roles según las capacidades de hardware:
Gestión de la topología
La información sobre dónde están ejecutándose los roles debe almacenarse en algún lugar. Y ese 'algún lugar' es la configuración distribuida, de la que ya he hablado anteriormente. Lo más importante en ella es la topología del clúster. Aquí se representan 3 grupos de replicación de 5 procesos de Tarantool:
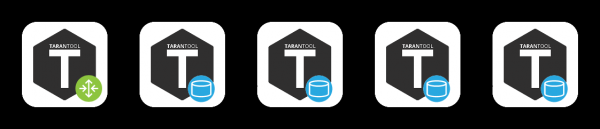
No queremos perder datos, por lo que tratamos con cuidado la información sobre los procesos en ejecución. Cartridge supervisa la configuración mediante un compromiso de dos fases. Tan pronto como queramos actualizar la configuración, primero verifica la disponibilidad de todas las instancias y su capacidad para aceptar la nueva configuración. Después, en la segunda fase, se aplica la configuración. De este modo, incluso si una instancia queda temporalmente inalcanzable, no pasará nada grave. Simplemente, la configuración no se aplicará y verás un error con anticipación.
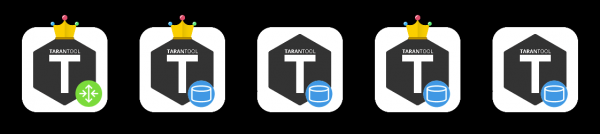
En la sección de topología también se especifica un parámetro tan importante como el líder de cada grupo de replicación. Normalmente, este es el nodo donde se realizan las escrituras. Los demás suelen ser de solo lectura, aunque puede haber excepciones. A veces, los desarrolladores audaces no temen a los conflictos y pueden escribir en múltiples réplicas simultáneamente, pero hay algunas operaciones que, a pesar de todo, no deben ejecutarse dos veces. Para esto existe el indicador de líder.
Vida de los roles
Para que un rol abstracto pueda existir en una arquitectura así, el marco debe gestionarlos de alguna manera. Por supuesto, la gestión ocurre sin reiniciar el proceso de Tarantool. Para gestionar roles, existen 4 callbacks. Cartridge los invocará dependiendo de lo que tenga escrito en la configuración distribuida, aplicando así la configuración a roles específicos.
function init()
function validate_config()
function apply_config()
function stop()
Cada rol tiene una función init. Se llama una vez, ya sea al activar el rol o al reiniciar Tarantool. Allí es conveniente, por ejemplo, inicializar box.space.create, o el scheduler puede iniciar algún fiber en segundo plano que realizará tareas a intervalos específicos.
Una función init puede ser insuficiente. Cartridge permite a los roles utilizar la configuración distribuida que usa para almacenar la topología. En esta misma configuración podemos declarar una nueva sección y almacenar en ella un fragmento de configuración comercial. En mi ejemplo, esto podría ser un esquema de datos o configuraciones de programación para el rol de scheduler.
El clúster invoca validate_config y apply_config en cada cambio de la configuración distribuida. Cuando la configuración se aplica mediante un commit en dos fases, el clúster verifica que cada rol esté listo para aceptar esta nueva configuración y, de ser necesario, informa al usuario sobre un error. Cuando todos están de acuerdo en que la configuración es normal, se ejecuta apply_config.
Los roles también tienen un método stop, que es necesario para limpiar los resultados de la actividad del rol. Si decimos que el scheduler ya no es necesario en este servidor, puede detener aquellos fibers que había iniciado. init.
Los roles pueden interactuar entre sí. Estamos acostumbrados a escribir llamadas a funciones en Lua, pero puede ocurrir que no tengamos el rol que necesitamos en ese proceso. Para facilitar las solicitudes a través de la red, utilizamos un módulo auxiliar rpc (llamada a procedimiento remoto), que se basa en el estándar netbox integrado en Tarantool. Esto puede ser útil, por ejemplo, si su gateway desea solicitar directamente al scheduler que realice una tarea de inmediato, en lugar de esperar un día.
Otro punto importante es garantizar la alta disponibilidad. Para monitorear la salud, Cartridge utiliza el protocolo SWIM. . En pocas palabras, los procesos intercambian entre sí 'noticias' a través de UDP: cada proceso le cuenta a sus vecinos las últimas novedades, y ellos responden. Si por alguna razón no llega una respuesta, Tarantool comienza a sospechar que algo no está bien, y después de un tiempo, declara la muerte y comienza a contar a todos los cercanos esta noticia.
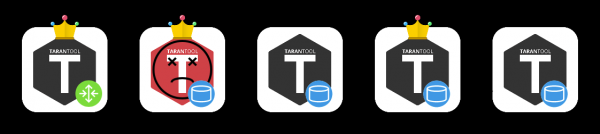
Basándose en este protocolo, Cartridge organiza el manejo automático de fallos. Cada proceso observa su entorno, y si el líder deja de responder, una réplica puede asumir su rol, mientras que Cartridge configura las funciones iniciadas de manera adecuada.
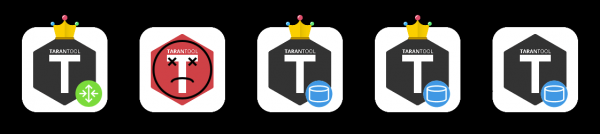
Aquí se debe tener cuidado, porque un cambio frecuente de un lado a otro puede conducir a conflictos de datos durante la replicación. Por supuesto, no se debe activar el failover automático al azar. Hay que tener claro lo que está sucediendo y estar seguros de que la replicación no se romperá después de que el líder se recupere y le devuelvan la corona.
De lo que se ha dicho, podría parecer que los roles son similares a los microservicios. En cierto sentido, lo son, pero como módulos dentro de los procesos de Tarantool. Sin embargo, hay varias diferencias fundamentales. En primer lugar, todos los roles del proyecto deben vivir en una sola base de código. Y todos los procesos de Tarantool deben iniciarse desde una misma base de código, para evitar sorpresas como aquellas que ocurren cuando intentamos inicializar el scheduler y simplemente no está. También hay que evitar diferencias en las versiones de código, porque el comportamiento del sistema en tal situación es muy difícil de predecir y depurar.
A diferencia de Docker, no podemos simplemente tomar la "imagen" de un rol, trasladarla a otra máquina y ejecutarla allí. Nuestros roles no están tan aislados como los contenedores de Docker. Además, no podemos ejecutar dos roles idénticos en una misma instancia. Un rol o está presente o no, en cierto sentido es un singleton. Y, en tercer lugar, dentro de todo el grupo de réplicas, los roles deben ser idénticos, porque sería absurdo — los datos son iguales, mientras que la configuración es diferente.
Herramientas de despliegue
Prometí mostrar cómo Cartridge ayuda a desplegar aplicaciones. Para facilitar la vida a los demás, el framework empaqueta paquetes RPM:
$ cartridge pack rpm myapp -- empaquetará para nosotros .\/myapp-0.1.0-1.rpm
$ sudo yum install .\/myapp-0.1.0-1.rpm
El paquete instalado incluye casi todo lo necesario: tanto la aplicación como las dependencias de Lua instaladas. Tarantool también se incluirá en el servidor como una dependencia del paquete RPM, y nuestro servicio estará listo para ejecutarse. Esto se hace a través de systemd, pero primero necesitamos escribir algo de configuración. Como mínimo, debemos especificar el URI de cada proceso. Tres serán suficientes como ejemplo.
$ sudo tee \/etc\/tarantool\/conf.d\/demo.yml <<CONFIG
myapp.router: {"advertise_uri": "localhost:3301", "http_port": 8080}
myapp.storage_A: {"advertise_uri": "localhost:3302", "http_enabled": False}
myapp.storage_B: {"advertise_uri": "localhost:3303", "http_enabled": False}
CONFIG
Hay un matiz interesante aquí. En lugar de especificar solo el puerto del protocolo binario, indicamos la dirección pública del proceso completa incluyendo el hostname. Esto es necesario para que los nodos del clúster sepan cómo conectarse entre sí. Es una mala idea usar como advertise_uri la dirección 0.0.0.0; debe ser la dirección IP externa, no la dirección de enlace del socket. Sin él, nada funcionará, por lo que Cartridge simplemente no permitirá iniciar un nodo con un advertise_uri incorrecto.
Ahora que la configuración está lista, podemos iniciar los procesos. Dado que una unidad normal de systemd no permite iniciar más de un proceso, las aplicaciones en Cartridge utilizan unidades llamadas instantiated, que funcionan de la siguiente manera:
$ sudo systemctl start myapp@router
$ sudo systemctl start myapp@storage_A
$ sudo systemctl start myapp@storage_B
En la configuración, indicamos el puerto HTTP en el que Cartridge sirve la interfaz web — 8080. Vamos a acceder y echar un vistazo:
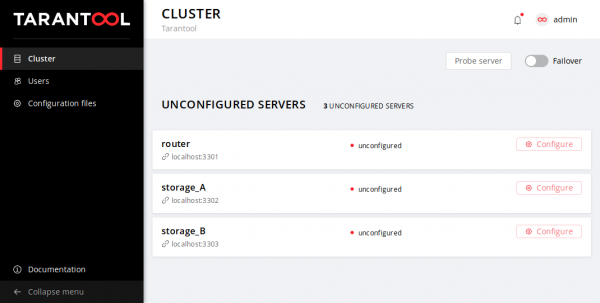
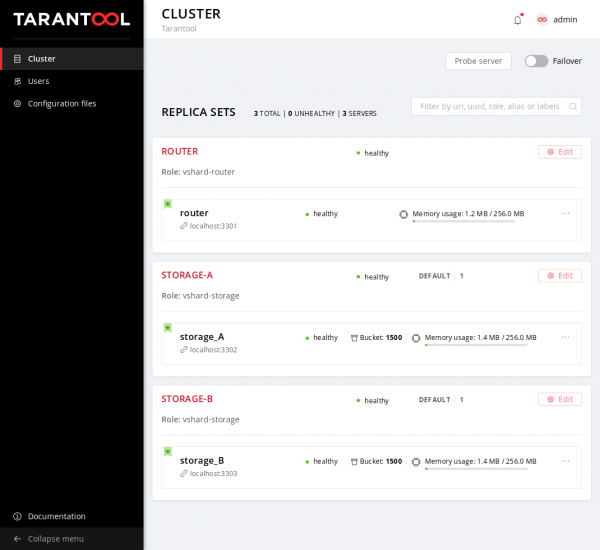
Vemos que los procesos están iniciados, pero aún no configurados. El cartucho todavía no sabe quién debe replicarse con quién y no puede tomar decisiones por sí mismo, por lo que está esperando nuestras acciones. Y nuestra elección no es grande: la vida de un nuevo clúster comienza con la configuración del primer nodo. Luego añadiremos el resto al clúster, les asignaremos roles, y con eso podemos considerar el despliegue como exitosamente completado.
Serviremos una taza de nuestra bebida favorita y nos relajaremos después de una larga semana de trabajo. La aplicación se puede utilizar.
Resultados
¿Y cuáles son los resultados? Prueben, utilicen, dejen sus comentarios, abran tickets en GitHub.
Enlaces
[1]
[2]
[3]
[4]
[5]
[6]
Fuente: habr.com
