

Hola a todos. En este artículo les contaré por qué en Avito elegimos Kafka hace nueve meses y qué es exactamente. Compartiré uno de los casos de uso: el corredor de mensajes. Y, por último, hablaremos sobre cuáles son los beneficios que hemos obtenido al aplicar el enfoque de Kafka como servicio.
Problema
Para comenzar, un poco de contexto. Hace algún tiempo comenzamos a alejarnos de la arquitectura monolítica, y ahora en Avito ya hay varios cientos de servicios diferentes. Cada uno tiene su propio almacenamiento, su propio stack tecnológico y es responsable de su parte de la lógica del negocio.
Uno de los problemas con un gran número de servicios son las comunicaciones. El servicio A a menudo quiere conocer información que tiene el servicio B. En este caso, el servicio A se comunica con el servicio B a través de una API síncrona. El servicio C quiere saber qué está sucediendo en los servicios D y E, mientras que estos, a su vez, están interesados en los servicios A y B. Cuando hay muchos servicios “curiosos”, las conexiones entre ellos se convierten en un complicado ovillo.
En cualquier momento, el servicio A puede volverse inaccesible. ¿Qué deberían hacer el servicio B y todos los demás servicios vinculados a él en este caso? Y si para llevar a cabo una operación comercial es necesario realizar una cadena de llamadas síncronas consecutivas, la probabilidad de que falle toda la operación se eleva aún más (y es mayor cuanto más larga sea esta cadena).
Selección de tecnología
Está bien, los problemas están claros. Se pueden resolver creando un sistema centralizado de intercambio de mensajes entre los servicios. Ahora, cada servicio solo necesita conocer este sistema de intercambio de mensajes. Además, el propio sistema debe ser resistente a fallos y escalable horizontalmente, y en caso de una emergencia, debe acumular un búfer de las solicitudes para su posterior procesamiento.
Ahora elijamos la tecnología sobre la cual se implementará la entrega de mensajes. Para ello, primero entendamos qué esperamos de ella:
- los mensajes entre servicios no deben perderse;
- los mensajes pueden duplicarse;
- los mensajes se pueden almacenar y leer durante varios días (búfer persistente);
- los servicios pueden suscribirse a los datos que les interesan;
- varios servicios pueden leer los mismos datos;
- los mensajes pueden contener un payload detallado y voluminoso (transferencia de estado mediante eventos);
- a veces se necesita una garantía del orden de los mensajes.
Además, era crucial para nosotros elegir un sistema que fuera lo más escalable y confiable posible, con un alto ancho de banda (al menos 100k mensajes de varios kilobytes por segundo).
En esta etapa, dijimos adiós a RabbitMQ (difícil de mantener estable a altos rps), PGQ de SkyTools (no lo suficientemente rápido y poco escalable) y NSQ (no persistente). Todas estas tecnologías se utilizan en nuestra empresa, pero no se adaptaban a la tarea que debíamos resolver.
Luego comenzamos a explorar nuevas tecnologías para nosotros: Apache Kafka, Apache Pulsar y NATS Streaming.
Primero descartamos Pulsar. Decidimos que Kafka y Pulsar eran soluciones bastante similares. A pesar de que Pulsar ha sido probado por grandes empresas, es más nuevo y ofrece una latencia más baja (en teoría), elegimos dejar Kafka entre las dos, como el estándar de facto para tales tareas. Es probable que volvamos a Apache Pulsar en el futuro.
Y así nos quedaron dos candidatos: NATS Streaming y Apache Kafka. Estudiamos ambos soluciones en detalle, y ambas eran adecuadas para la tarea. Sin embargo, al final nos preocupó la relativa juventud de NATS Streaming (y que uno de los desarrolladores principales, Tyler Treat, decidió abandonar el proyecto y comenzar el suyo propio — Liftbridge). Además, el modo de Clustering de NATS Streaming no permitía un fuerte escalado horizontal (probablemente ya no sea un problema tras la adición del modo de particionamiento en 2017).
Sin embargo, NATS Streaming es una tecnología impresionante, escrita en Go y respaldada por la Cloud Native Computing Foundation. A diferencia de Apache Kafka, no necesita Zookeeper para funcionar (posiblemente, ), ya que internamente implementa RAFT. Además, NATS Streaming es más fácil de administrar. No descartamos que en el futuro volvamos a esta tecnología.
Aun así, hoy en día, nuestro ganador es Apache Kafka. En nuestras pruebas, demostró ser lo suficientemente rápido (más de un millón de mensajes por segundo en lectura y escritura con un volumen de mensajes de 1 kilobyte), bastante confiable, bien escalable y probado en producción por grandes empresas. Además, Kafka es respaldado por al menos varias grandes empresas comerciales (por ejemplo, nosotros utilizamos la versión de Confluent), y también Kafka tiene un ecosistema desarrollado.
Revisión de Kafka
Antes de comenzar, recomiendo inmediatamente un excelente libro — «Kafka: The Definitive Guide» (hay también en la traducción al ruso, pero los términos pueden resultar confusos). En ella se puede encontrar información necesaria para una comprensión básica de Kafka e incluso un poco más. La documentación de Apache y el blog de Confluent también están muy bien escritos y son fáciles de leer.
Así que, echemos un vistazo a cómo está estructurada Kafka desde una perspectiva general. La topología básica de Kafka consiste en productor, consumidor, corredor y zookeeper.
Corredor
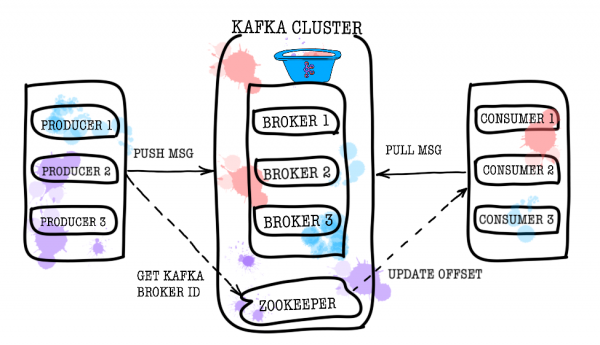
El corredor (broker) es responsable del almacenamiento de sus datos. Todos los datos se almacenan en formato binario, y el corredor sabe poco sobre lo que representan y cuál es su estructura.
Cada tipo lógico de eventos generalmente se encuentra en su propio tema (topic) separado. Por ejemplo, un evento de creación de un anuncio podría ir al tema item.created, y un evento de su modificación al item.changed. Los temas pueden considerarse como clasificadores de eventos. A nivel de tema, se pueden establecer parámetros de configuración como:
- volumen de datos almacenados y/o su antigüedad (retention.bytes, retention.ms);
- factor de redundancia de datos (replication factor);
- tamaño máximo de un mensaje (max.message.bytes);
- número mínimo de réplicas alineadas necesarias para poder escribir datos en el tema (min.insync.replicas);
- posibilidad de realizar failover a una réplica rezagada no alineada con posible pérdida de datos (unclean.leader.election.enable);
- y muchos otros ().
A su vez, cada tema se divide en una o más particiones (partition). Es en las particiones donde finalmente se almacenan los eventos. Si hay más de un corredor en el clúster, las particiones se distribuirán uniformemente entre todos los corredores (en la medida de lo posible), lo que permitirá escalar la carga de escritura y lectura en un tema a varios corredores al mismo tiempo.
En el disco, los datos de cada partición se almacenan en forma de archivos de segmentos, que por defecto tienen un tamaño de un gigabyte (controlado a través de log.segment.bytes). Una característica importante es que la eliminación de datos de las particiones (cuando se activa la retención) ocurre en segmentos (no se puede eliminar un solo evento de una partición, solo se puede eliminar todo un segmento, y este debe ser inactivo).
Zookeeper
Zookeeper actúa como un almacén de metadatos y coordinador. Es capaz de decir si los corredores están vivos (se puede observar esto a través de zookeeper con el comando zookeeper-shell ls /brokers/ids), qué corredor es el controlador (get /controller), ¿están las particiones en estado sincronizado con sus réplicas (get /brokers/topics/topic_name/partitions/partition_number/state). Además, es a zookeeper donde primero irán el productor y el consumidor para averiguar en qué corredor se almacenan los temas y particiones. En los casos en que el factor de replicación para un tema se establece en más de 1, zookeeper indicará qué particiones son líderes (donde se realizará la escritura y de donde también se leerá). En caso de que un corredor caiga, será en zookeeper donde se registrará la información sobre las nuevas particiones líderes (desde la versión 1.1.0, de forma asincrónica, ).
En versiones anteriores de Kafka, zookeeper también se encargaba de almacenar los offsets, pero ahora se almacenan en un tema especial __consumer_offsets en el corredor (aunque todavía puedes seguir utilizando zookeeper para estos fines).
La forma más sencilla de convertir tus datos en calabaza es precisamente perder información de zookeeper. En tal escenario, será muy complicado entender qué y de dónde necesitas leer.
Producer
El productor es, en la mayoría de los casos, un servicio que realiza la escritura de datos en Apache Kafka. El productor elige el tema en el que se almacenarán sus mensajes temáticos y comienza a registrar información en él. Por ejemplo, un productor puede ser un servicio de anuncios. En tal caso, enviará eventos a los temas temáticos como "anuncio creado", "anuncio actualizado", "anuncio eliminado", etc. Cada evento representa un par clave-valor.
Por defecto, todos los eventos se distribuyen entre las particiones del tema en un esquema round-robin si no se especifica una clave (perdiendo el orden), y a través de MurmurHash (clave) si se proporciona una clave (manteniendo el orden dentro de una partición).
Aquí cabe mencionar que Kafka garantiza el orden de los eventos solo dentro de una partición. Pero, en realidad, a menudo esto no es un problema. Por ejemplo, se puede garantizar que todos los cambios de un mismo anuncio se añadan a una partición (manteniendo así el orden de estos cambios en relación al anuncio). También se puede pasar un número de secuencia en uno de los campos del evento.
Consumidor
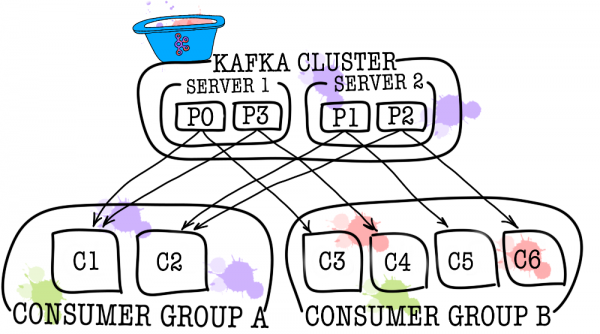
El consumidor es responsable de obtener datos de Apache Kafka. Volviendo al ejemplo anterior, el consumidor podría ser un servicio de moderación. Este servicio estará suscrito al tema del servicio de anuncios y, cuando aparezca un nuevo anuncio, lo recibirá y lo analizará en función de ciertas políticas establecidas.
Apache Kafka recuerda cuáles fueron los últimos eventos que recibió el consumidor (para esto se utiliza un tema de control __consumer__offsets ), asegurando así que, al leer con éxito, el consumidor no reciba el mismo mensaje dos veces. Sin embargo, si se utiliza la opción enable.auto.commit = true y se delega completamente el seguimiento de la posición del consumidor en el tema a Kafka, se puedeperder datos En los casos en que un solo consumidor no es suficiente (por ejemplo, cuando el flujo de nuevos eventos es muy grande), se puede agregar varios consumidores, vinculándolos en un grupo de consumidores. Un grupo de consumidores representa lógicamente al mismo consumidor, pero con la distribución de datos entre los miembros del grupo. Esto permite que cada uno de los participantes tome su parte de los mensajes, escalando así la velocidad de lectura.
Resultados de las pruebas
No voy a escribir mucho texto explicativo aquí, solo compartiré los resultados obtenidos. Las pruebas se realizaron en 3 máquinas físicas (12 CPU, 384GB RAM, 15k SAS DISK, 10GBit/s Net), los brokers y zookeeper se desplegaron en lxc.
Durante las pruebas se obtuvieron los siguientes resultados.
Prueba de rendimiento
La velocidad de escritura de mensajes de 1KB simultáneamente por 9 productores es de 1300000 eventos por segundo.
- La velocidad de lectura de mensajes de 1KB simultáneamente por 9 consumidores es de 1500000 eventos por segundo.
- Pruebas de resistencia
Durante las pruebas se obtuvieron los siguientes resultados (3 brokers, 3 zookeeper).
La caída inesperada de uno de los brokers no provoca la detención o inaccesibilidad del clúster. La operación continúa normalmente, pero la carga recae más en los brokers restantes.
- La finalización inesperada de uno de los brokers no provoca la detención o inaccesibilidad del clúster. El funcionamiento continúa de manera normal, pero los brokers restantes asumen una mayor carga.
- La terminación anómala de dos brokers en un clúster de tres brokers y min.isr = 2 provoca la indisponibilidad del clúster para la escritura, pero mantiene la disponibilidad para la lectura. En el caso de que min.isr = 1, el clúster sigue estando disponible tanto para lectura como para escritura. Sin embargo, este modo contradice el requisito de alta integridad de los datos.
- La terminación anómala de uno de los servidores Zookeeper no provoca la detención ni la indisponibilidad del clúster. El funcionamiento continúa normalmente.
- La terminación anómala de dos servidores Zookeeper provoca la indisponibilidad del clúster hasta que al menos uno de los servidores Zookeeper se recupere. Esta afirmación es válida para un clúster Zookeeper de 3 servidores. Como resultado de estas investigaciones, se decidió aumentar el clúster Zookeeper a 5 servidores para mejorar la resistencia a fallos.
Kafka como servicio
Hemos comprobado que Kafka es una excelente tecnología que nos permite resolver el desafío planteado (la implementación de un broker de mensajes). Sin embargo, decidimos prohibir que los servicios accedan directamente a Kafka y la cerramos a través del servicio data-bus. ¿Por qué hicimos esto? En realidad, hay varias razones.
Data-bus asumió todas las tareas relacionadas con la integración con Kafka (implementación y configuración de consumidores y productores, monitoreo, alertas, registro, escalado, etc.). De esta manera, la integración con el broker de mensajes se realiza de la forma más sencilla posible.
Data-bus permitió la abstracción del lenguaje o la biblioteca concreta para trabajar con Kafka.
Data-bus permitió que otros servicios se abstrajeran de la capa de almacenamiento. Puede que en algún momento cambiemos Kafka por Pulsar, y nadie se dará cuenta (todos los servicios solo conocen la API de data-bus).
Data-bus asumió la validación de los esquemas de eventos.
Con data-bus se implementó la autenticación.
Bajo la protección de data-bus, podemos actualizar las versiones de Kafka de manera centralizada y sin tiempo de inactividad, gestionando de forma centralizada las configuraciones de productores, consumidores, brokers, etc.
Data-bus permitió añadir las funciones necesarias que no están disponibles en Kafka (como la auditoría de temas, el control de anomalías en el clúster, la creación de DLQ, etc.).
Data-bus permite implementar el failover de manera centralizada para todos los servicios.
En este momento, para comenzar a enviar eventos a un corredor de mensajes, es suficiente con conectar una pequeña biblioteca al código de su servicio. Eso es todo. Tiene la posibilidad de escribir, leer y escalar con una línea de código. Toda la implementación está oculta de usted; solo quedan a la vista algunas configuraciones como el tamaño del lote. En segundo plano, el servicio data-bus genera en Kubernetes la cantidad necesaria de instancias de productores y consumidores y les proporciona la configuración necesaria, pero todo esto es transparente para su servicio.
Por supuesto, no existe una solución mágica, y este enfoque tiene sus limitaciones.
- Data-bus necesita ser mantenido por su cuenta, a diferencia de las bibliotecas de terceros.
- Data-bus incrementa el número de interacciones entre servicios y el corredor de mensajes, lo que resulta en una disminución del rendimiento comparado con Kafka directamente.
- No todo se puede ocultar tan fácilmente de los servicios; no queremos duplicar la funcionalidad de KSQL o Kafka Streams en data-bus, por lo que a veces es necesario permitir que los servicios accedan directamente.
En nuestro caso, los beneficios superaron a los inconvenientes, y la decisión de cubrir el corredor de mensajes con un servicio separado resultó ser correcta. Durante un año de operación, no hemos tenido incidentes o problemas graves.
P.D. Gracias a mi novia, Ekaterina Obalayeva, por las increíbles ilustraciones de este artículo. Si te han gustado, habrá aún más ilustraciones.
Fuente: habr.com
