

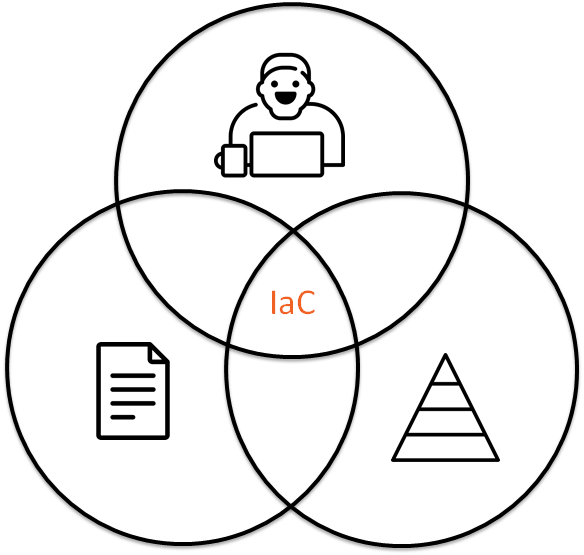
Enfoque IaC (Infrastructure as Code) no solo consiste en el código que se almacena en un repositorio, sino también en las personas y procesos que rodean ese código. ¿Es posible reutilizar enfoques del desarrollo de software en la gestión y descripción de la infraestructura? No estará de más tener esta idea en mente mientras lee el artículo.
Esta es la transcripción de mi en .
Presentaciones y videos
- Prueba en seco 2019-04-24
Infraestructura como historial de bash
Supongamos que llegas a un nuevo proyecto y te dicen: «tenemos Infrastructure as Code«. En la realidad, resulta que Infraestructura como historial de bash o por ejemplo Documentación como historial de bash. Esta es una situación bastante real, por ejemplo, un caso similar fue descrito por Denis Lysenko en su presentación , contó cómo a partir del historial de bash lograron obtener una infraestructura ordenada en el proyecto.
Con un poco de deseo, se podría decir que Infraestructura como historial de bash es como código:
- la reproducibilidad: puedes tomar el historial de bash, ejecutar los comandos de allí y, posiblemente, obtendrás una configuración funcional al final.
- versionado: sabes quién se conectó y qué hizo, aunque no es un hecho que te lleve a una configuración funcional al final.
- historia: la historia de quién hizo qué. Pero no podrás usarla si pierdes el servidor.
¿Qué debemos hacer?
Infrastructure as Code
Incluso un caso tan extraño como Infraestructura como historial de bash puede adaptarse forzadamente a Infrastructure as Code, pero cuando queramos hacer algo más complicado que un viejo servidor LAMP, llegaremos a la conclusión de que este código debe ser de alguna manera modificado, cambiado, mejorado. A continuación, queremos considerar las paralelas entre Infrastructure as Code y el desarrollo de software.
D.R.Y.
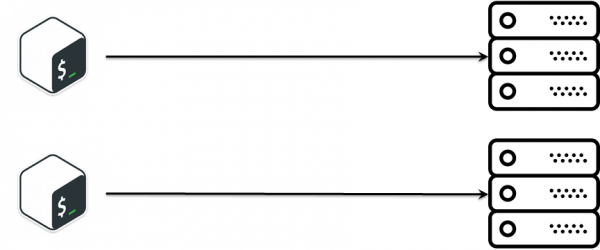
En el proyecto de desarrollo de sistemas de almacenamiento de datos, había una subtarea : lanzamos una nueva versión y es necesario implementarla para las pruebas posteriores. La tarea es extremadamente simple:
- entra aquí por ssh y ejecuta el comando.
- copia el archivo allí.
- corrige la configuración aquí.
- inicia el servicio allí.
- …
- ¡BENEFICIO!
Para la lógica descrita, bash es más que suficiente, especialmente en las primeras etapas del proyecto, cuando apenas está comenzando. Es , pero con el tiempo surgen solicitudes para desplegar algo similar, pero ligeramente diferente. Lo primero que se me ocurre: copiar y pegar. Y así ya tenemos dos scripts muy similares que hacen casi lo mismo. Con el tiempo, el número de scripts creció, y nos enfrentamos a la necesidad de sincronizar una cierta lógica empresarial de despliegue de instalación entre diferentes scripts, lo cual es bastante complicado.
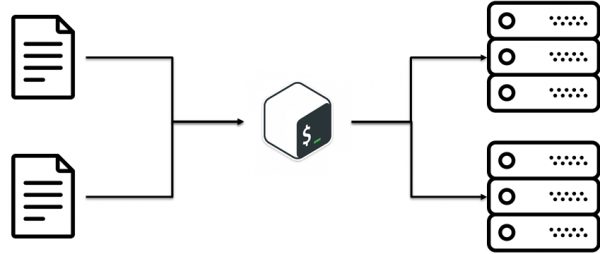
Resulta que existe una práctica llamada D.R.Y. (No te Repitas). La idea es reutilizar el código existente. Suena simple, pero no llegamos a esto de inmediato. En nuestro caso, fue una idea banal: separar las configuraciones de los scripts. Es decir, la lógica empresarial de cómo se despliega la instalación por un lado, las configuraciones por otro.
S.O.L.I.D. para CFM
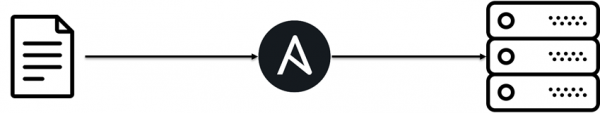
Con el tiempo, el proyecto creció y apareció Ansible. La razón principal de su aparición es que había experiencia en el equipo y que bash no está destinado para lógicas complejas. Ansible también llegó a contener lógica compleja. Para que la lógica compleja no se convierta en caos, existen principios en el desarrollo de software para organizar el código. S.O.L.I.D. Así, por ejemplo, Grigory Petrov en su charla "¿Por qué un profesional de TI necesita una marca personal?" tocó el tema de que la naturaleza humana hace que sea más fácil operar con ciertas entidades sociales; en el desarrollo de software, estas son los objetos. Si unimos estas dos ideas y continuamos desarrollándolas, se puede notar que en la descripción de la infraestructura también se puede usar S.O.L.I.D. para que en el futuro sea más fácil mantener y modificar esta lógica.
El Principio de Responsabilidad Única
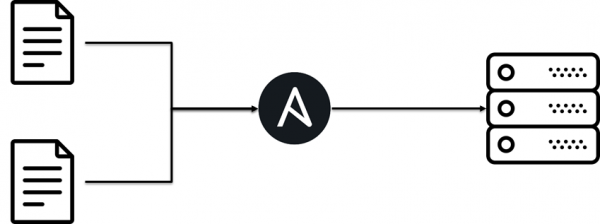
Cada clase realiza solo una tarea.
No hay que mezclar código y crear monolitos divinos que sean un monstruo espagueti. La infraestructura debe consistir en bloques simples. Resulta que si fragmentamos el playbook de Ansible en trozos pequeños, léase roles de Ansible, es más fácil de mantener.
El Principio Abierto-Cerrado
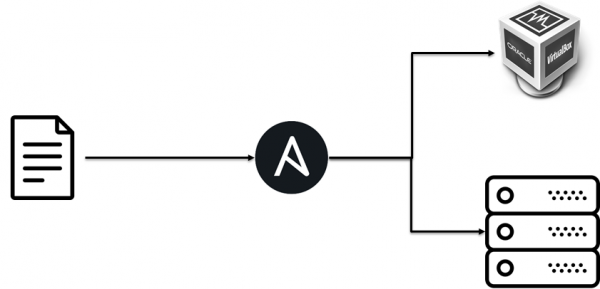
Principio de apertura/cierre.
- Abiertos para la extensión: significa que el comportamiento de una entidad puede ser ampliado creando nuevos tipos de entidades.
- Cerrados para la modificación: como resultado de la extensión del comportamiento de la entidad, no deben realizarse cambios en el código que utiliza estas entidades.
Inicialmente, desplegamos la infraestructura de prueba en máquinas virtuales, pero dado que la lógica de negocio del despliegue estaba separada de la implementación, añadimos fácilmente la configuración en baremetal.
El Principio de Sustitución de Liskov
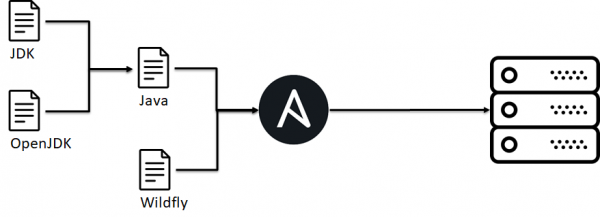
El principio de sustitución de Barbara Liskov establece que los objetos en un programa deben ser reemplazables por instancias de sus subtipos sin alterar la corrección de la ejecución del programa.
Si se mira desde una perspectiva más amplia, no es una característica de un proyecto específico que se puede aplicar. S.O.L.I.D., trata en general sobre CFM, por ejemplo, en otro proyecto es necesario implementar una aplicación Java empaquetada sobre diferentes servidores Java, bases de datos, sistemas operativos, etc. En este ejemplo, consideraré los principios posteriores. S.O.L.I.D.
En nuestro caso, dentro del equipo de infraestructura existe un acuerdo de que si hemos instalado el rol imbjava o oraclejava, entonces tenemos un archivo ejecutable binario java. Esto es necesario porque los roles superiores dependen de este comportamiento, esperan la presencia de java. Al mismo tiempo, esto nos permite reemplazar una implementación/version de java por otra sin alterar la lógica de implementación de la aplicación.
El problema aquí radica en que en Ansible no se puede implementar esto, como consecuencia, dentro del equipo surgen ciertos acuerdos.
El Principio de Segregación de Interfaces
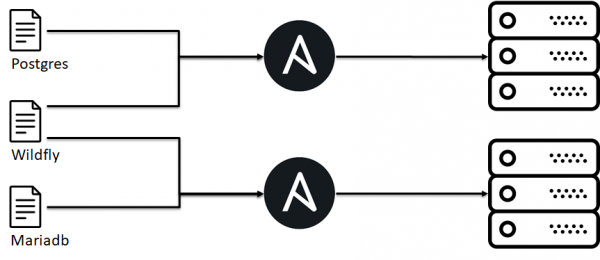
El principio de segregación de interfaces sugiere que 'muchas interfaces diseñadas específicamente para los clientes son mejores que una interfaz de propósito general.'
Inicialmente, intentamos concentrar toda la variabilidad del despliegue de la aplicación en un único playbook de Ansible, pero esto era difícil de mantener, y el enfoque en el que especificamos la interfaz externa (el cliente espera el puerto 443) permite componer la infraestructura a partir de bloques individuales para una implementación concreta.
El Principio de Inversión de Dependencias
El principio de inversión de dependencias establece que los módulos de niveles superiores no deben depender de módulos de niveles inferiores. Ambos tipos de módulos deben depender de abstracciones. Las abstracciones no deben depender de detalles. Los detalles deben depender de abstracciones.
Aquí, el ejemplo se basará en un antipatrón.
- Uno de nuestros clientes tenía una nube privada.
- Dentro de la nube, solicitábamos máquinas virtuales.
- Pero debido a las características de la nube, el despliegue de la aplicación estaba ligado a qué hipervisor recibía la VM.
Es decir, la lógica de despliegue de la aplicación a alto nivel y las dependencias fluían hacia los niveles subyacentes del hipervisor, lo que significaba problemas al reutilizar esta lógica. No hay necesidad de eso.
Interacción
La infraestructura como código no solo se trata de código, sino también de la relación entre el código y las personas, así como de las interacciones entre los desarrolladores de infraestructura.
Factor de autobús
Supongamos que tienes a Vasya en tu proyecto. Vasya sabe todo sobre tu infraestructura, ¿qué pasará si de repente Vasya desaparece? Esta es una situación muy real, ya que podría ser atropellado por un autobús. A veces esto sucede. Si esto ocurre y el conocimiento sobre el código, su estructura, cómo funciona, credenciales y contraseñas no está distribuido en el equipo, se pueden enfrentar a una serie de situaciones desagradables. Para minimizar estos riesgos y distribuir el conocimiento dentro del equipo, se pueden usar varios enfoques.
Desarrollo en pareja
No es como , donde los administradores bebían cerveza, cambiaban contraseñas, y es análogo a la programación en pareja. Es decir, dos ingenieros se sientan frente a una computadora, una sola teclado y comienzan a configurar juntos tu infraestructura: configurando un servidor, escribiendo un rol de Ansible, etc. Suena bien, pero no funcionó en nuestro caso. Sin embargo, hay casos específicos en que esta práctica sí ha funcionado. Un nuevo empleado, su mentor toma una tarea real junto con él, trabaja — transfiere conocimiento.
Otro caso específico es la llamada de incidentes. Durante un problema, se reúne un grupo de guardias y personas involucradas, se designa un líder que comparte su pantalla y verbaliza su línea de pensamiento. Los demás participantes siguen el pensamiento del líder, observan trucos en la consola, verifican si se saltó alguna línea en el log, aprenden cosas nuevas sobre el sistema. Este enfoque, en general, funcionó más que no.
Revisión de código
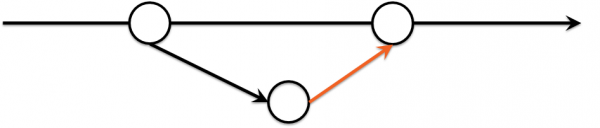
Subjetivamente, la difusión de conocimientos sobre la infraestructura y cómo está estructurada fue más efectiva a través de la revisión de código:
- La infraestructura se describe mediante código en el repositorio.
- Los cambios ocurren en una rama separada.
- En el pull request, se puede ver la delta de cambios en la infraestructura.
La peculiaridad aquí fue que los revisores se elegían por turno, según un calendario, es decir, con cierta probabilidad te adentrarías en una nueva sección de la infraestructura.
Estilo de código
Con el tiempo, comenzaron a surgir disputas durante las revisiones, ya que los revisores tenían su propio estilo y la rotación de revisores los enfrentaba a diferentes estilos: 2 espacios o 4, camelCase o snake_case. No fue fácil implementar esto desde el principio.
- La primera idea fue recomendar el uso de un linter, pues al final son ingenieros y todos son inteligentes. Pero diferentes editores y sistemas operativos lo complicaban.
- Esto evolucionó hacia un bot que enviaba un mensaje en Slack por cada commit problemático, adjuntando la salida del linter. Pero en la mayoría de los casos, había asuntos más importantes y el código permanecía sin corregirse.
Green Build Master
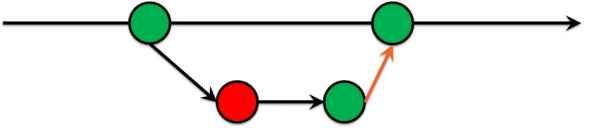
El tiempo pasó, y llegamos a la conclusión de que no se podían permitir commits en master que no pasaran ciertos tests. ¡Voilà! Inventamos el Green Build Master, que ya se practicaba en el desarrollo de software desde hace tiempo:
- El desarrollo se realiza en una rama independiente.
- Las pruebas se ejecutan en esa rama.
- Si las pruebas no pasan, el código no llegará a master.
Aceptar esta decisión fue bastante doloroso, ya que generó muchas discusiones, pero valió la pena, ya que las solicitudes de fusión comenzaron a llegar sin desacuerdos sobre el estilo y, con el tiempo, la cantidad de problemas disminuyó.
Pruebas IaC
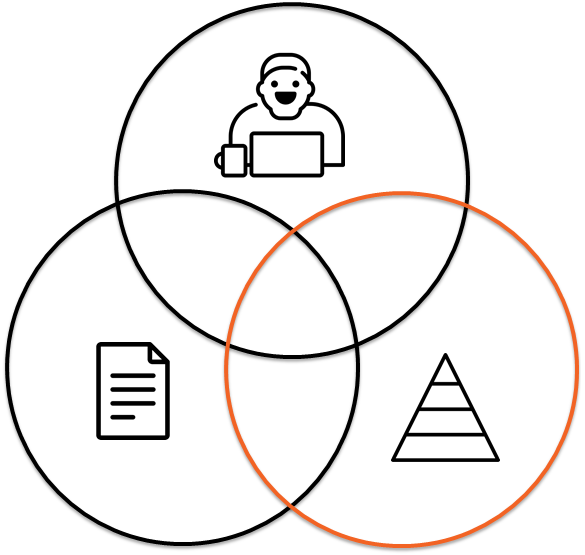
Además de verificar el estilo, se pueden utilizar otras herramientas, por ejemplo, comprobar que tu infraestructura realmente puede desplegarse. O verificar que los cambios en la infraestructura no resulten en pérdidas monetarias. ¿Por qué puede ser necesario? La pregunta es compleja y filosófica, es mejor responder con una anécdota: había una vez un auto-escalador en Powershell que, al no verificar condiciones límite, creó más máquinas virtuales de las que se necesitaban, lo que hizo que el cliente gastara más dinero del que había previsto. No es agradable, pero este error podría haberse detectado en etapas más tempranas.
Se puede preguntar, ¿por qué hacer que una infraestructura complicada sea aún más complicada? Las pruebas para la infraestructura, al igual que para el código, no son sobre simplificación, sino sobre saber cómo debería funcionar tu infraestructura.
Pirámide de Pruebas IaC
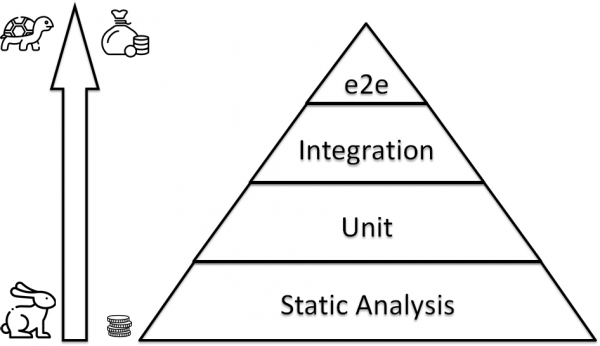
Pruebas IaC: Análisis Estático
Si desplegas toda la infraestructura de inmediato y verificas que funcione, puede resultar que toma mucho tiempo y requiere un gran esfuerzo. Por eso, debe haber algo que funcione rápidamente, que sea abundante y que cubra muchos lugares primitivos.
Bash es complicado
Veamos un ejemplo sencillo. seleccionar todos los archivos en el directorio actual y copiarlos a otro lugar. Lo primero que se me ocurre:
for i in * ; do
    cp $i /some/path/$i.bak
done
¿Y si hay un espacio en el nombre del archivo? Bueno, está bien, somos inteligentes, sabemos usar comillas:
for i in * ; do cp "$i" "/some/path/$i.bak" ; done¿Son buenos? ¡No! ¿Qué pasa si no hay nada en el directorio, es decir, el globbing no funciona?
find . -type f -exec mv -v {} dst/{}.bak ;¿Ahora son buenos? Nope… Olvidaron que puede haber n.
touch x
mv x "$(printf "foonbar")"
find . -type f -print0 | xargs -0 mv -t /path/to/target-dir
Herramientas de análisis estático
El problema del paso anterior se pudo detectar cuando olvidamos las comillas, para esto hay muchos medios en la naturaleza. , en realidad hay muchos, y probablemente puedas encontrar un linter para tu stack en tu IDE.
Idioma
Herramienta
bash
Ruby
python
ansible
Pruebas IaC: Pruebas unitarias
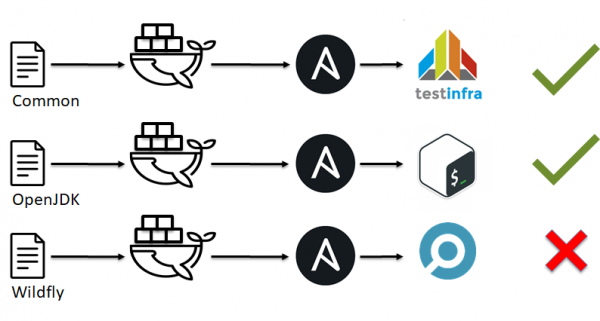
Como hemos visto en el ejemplo anterior, los linters no son todopoderosos y no pueden señalar todos los lugares problemáticos. A continuación, a modo de analogía con las pruebas en el desarrollo de software, podemos recordar las pruebas unitarias. Aquí inmediatamente vienen a la mente , , , . Pero, ¿qué hacer con ansible, chef, saltstack y similares?
Al principio hablamos sobre S.O.L.I.D. y que nuestra infraestructura debería consistir en pequeños bloques. Ha llegado su momento.
- La infraestructura se descompone en pequeños bloques, por ejemplo, roles de Ansible.
- Se despliega algún entorno, ya sea docker o una VM.
- Aplicamos nuestro rol de Ansible a este entorno de prueba.
- Verificamos que todo funcionó como esperábamos (ejecutamos las pruebas).
- Decidimos si está bien o no.
Pruebas IaC: Herramientas de pruebas unitarias
La pregunta es, ¿qué son las pruebas para CFM? se puede simplemente ejecutar un script, o se pueden utilizar soluciones listas para esto:
CFM
Herramienta
Ansible
Chef
Chef
saltstack
Ejemplo para testinfra, verificamos que los usuarios test1, test2 existen y pertenecen al grupo sshusers:
def test_default_users(host):
    users = ['test1', 'test2' ]
    for login in users:
        assert host.user(login).exists
        assert 'sshusers' in host.user(login).groups
¿Qué elegir? la pregunta es complicada y no tiene una respuesta sencilla, aquí hay un ejemplo de cambios en proyectos en github durante 2018-2019:
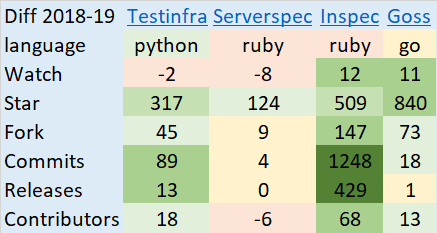
Frameworks de pruebas IaC
Surge la pregunta de cómo juntar todo esto y ejecutarlo. Puedes con suficiente cantidad de ingenieros. O puedes optar por soluciones listas, aunque no hay muchas:
CFM
Herramienta
Ansible
Chef
Terraform
Ejemplo de cambios en proyectos en github durante 2018-2019:
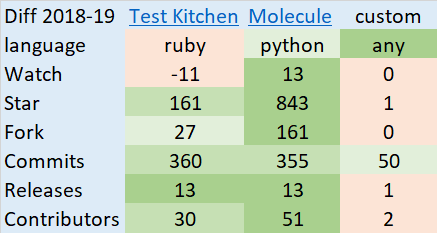
Molecule vs. Testkitchen
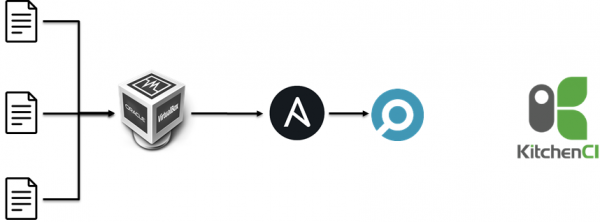
Inicialmente intentamos usar testkitchen :
- Создать ВМ в параллель.
- Aplicar roles de Ansible.
- Ejecutar inspec.
Para 25-35 roles, tomó de 40 a 70 minutos, lo cual fue largo.
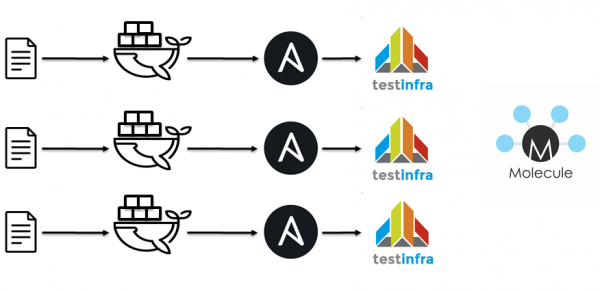
El siguiente paso fue migrar a jenkins / docker / ansible / molecule. Ideológicamente, todo es lo mismo.
- Lintar playbooks.
- Lintar roles.
- Iniciar contenedor.
- Aplicar roles de Ansible.
- Ejecutar testinfra.
- Verificar idempotencia.
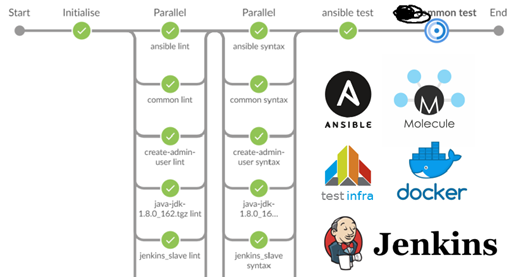
La linting para 40 roles y las pruebas para una decena tomaron alrededor de 15 minutos.
Qué elegir depende de muchos factores, como la pilas utilizada, la experiencia del equipo, etc. aquí cada uno decide cómo abordar el tema de las pruebas Unit.
Pruebas IaC: Pruebas de Integración.
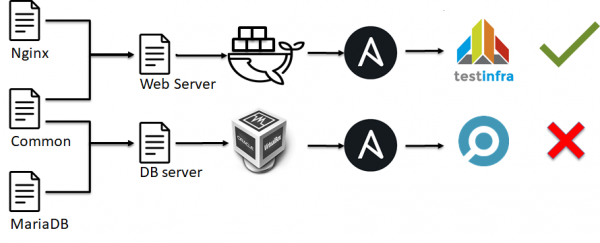
En el siguiente nivel de la pirámide de pruebas de infraestructura, están las pruebas de integración. Son similares a las pruebas Unit:
- La infraestructura se divide en pequeños bloques, como roles de Ansible.
- Se despliega algún entorno, ya sea docker o una VM.
- Este entorno de prueba aplica una gran cantidad roles de Ansible.
- Verificamos que todo funcionó como esperábamos (ejecutamos las pruebas).
- Decidimos si está bien o no.
En términos generales, no estamos verificando la funcionalidad de un solo elemento del sistema como en las pruebas unitarias, sino verificamos cómo está configurado el servidor en su totalidad.
Pruebas IaC: Pruebas de Extremo a Extremo.
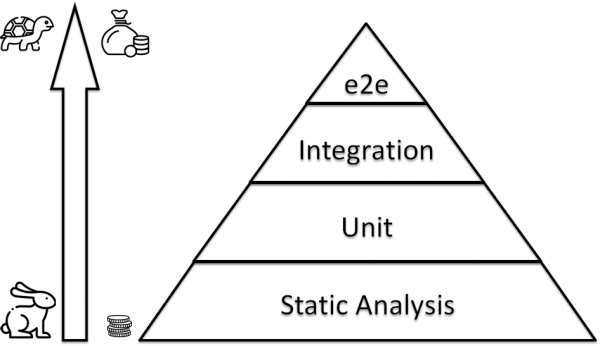
En la cima de la pirámide nos encontramos con pruebas de Extremo a Extremo. Es decir, no estamos revisando la funcionalidad de un solo servidor, un solo script, un solo bloque de nuestra infraestructura. Verificamos que múltiples servidores, unidos, nuestra infraestructura funcione como esperamos. Lamentablemente, no he visto soluciones preempaquetadas, probablemente porque la infraestructura es a menudo única y es difícil estandarizarla y crear un marco para su prueba. Como resultado, todos crean sus propias soluciones. Hay demanda, pero no hay respuestas. Por lo tanto, compartiré lo que hay, para inspirar a otros a reflexionar o señalarme que todo ya fue inventado antes que nosotros.
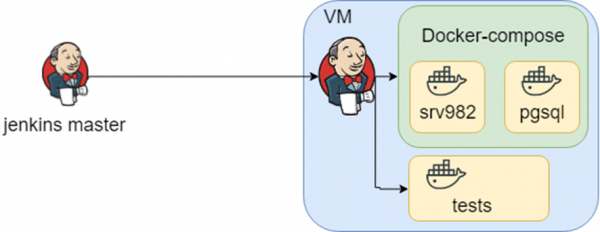
Un proyecto con una rica historia. Es utilizado en grandes organizaciones y probablemente cada uno de ustedes ha tenido algo que ver de manera indirecta. La aplicación soporta múltiples bases de datos, integraciones, etc. Saber cómo puede lucir la infraestructura implica múltiples archivos docker-compose, y saber qué pruebas ejecutar en qué entorno es Jenkins.
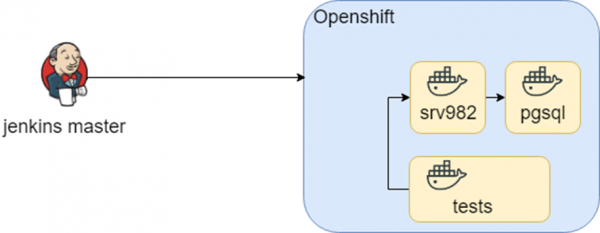
Este esquema funcionó durante mucho tiempo, hasta que dentro de intentamos migrarlo a Openshift. Los contenedores permanecieron los mismos, pero el entorno de ejecución cambió (hola D.R.Y. de nuevo).
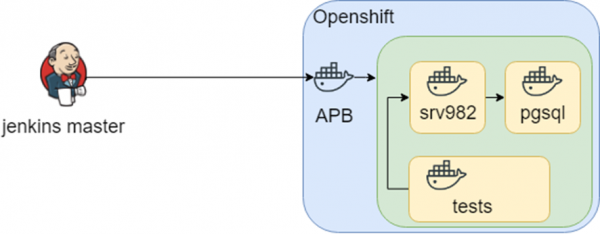
La idea de la investigación ha ido más allá, y en openshift se encontró algo llamado APB (Ansible Playbook Bundle), que permite empaquetar el conocimiento sobre cómo desplegar la infraestructura en un contenedor. Es decir, hay un punto de conocimiento reproducible y verificable sobre cómo desplegar la infraestructura.
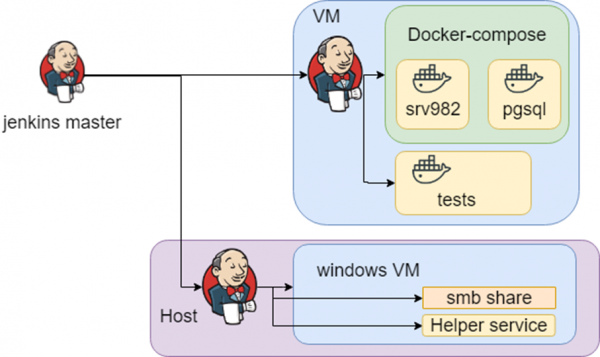
Todo esto sonaba bien, hasta que nos topamos con la infraestructura heterogénea: necesitamos Windows para las pruebas. Al final, el conocimiento sobre qué, dónde y cómo desplegar y probar se encuentra en jenkins.
Conclusión
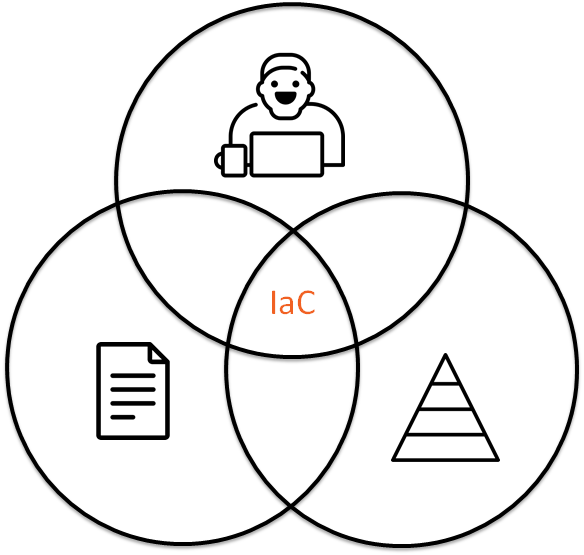
La Infraestructura como Código es
- Código en el repositorio.
- Interacción entre personas.
- Pruebas de infraestructura.
enlaces
- Prueba en seco 2019-04-24
- &
Fuente: habr.com
