

Como parte de un proyecto de investigación se ha comenzado a trabajar en la incorporación en GCC de una capacidad que permite dividir el proceso de compilación en varios hilos ejecutándose en paralelo. Actualmente, para aumentar la velocidad de compilación en sistemas multinúcleo, se utiliza la ejecución de procesos separados del compilador a nivel de la herramienta make, cada uno de los cuales compila un archivo de código individual. El nuevo proyecto experimenta con la provisión de paralelización a nivel de compilador, lo que potencialmente podría mejorar la eficiencia en sistemas multinúcleo.
Para las pruebas una rama separada de GCC para la paralelización, en la que se ha propuesto un nuevo parámetro «—param=num-threads=N» para establecer el número de hilos. En una fase inicial, se ha implementado la separación en hilos individuales de las optimizaciones interprocedurales, que se llaman cíclicamente para cada función y son adecuadas para ser paralelizadas. Se han trasladado a hilos independientes las operaciones GIMPLE, encargadas de optimizaciones independientes del hardware que evalúan las interacciones entre funciones.
En la siguiente etapa, también se planea trasladar a hilos separados las optimizaciones RTL interprocedurales, que tienen en cuenta las características de la plataforma de hardware. Después de esto, se prevé implementar la paralelización de las optimizaciones intraprocedurales (IPA), aplicadas al código dentro de la función, independientemente de las particularidades de la llamada. Actualmente, el limitante es el recolector de basura, al que se le ha añadido un bloqueo global que desactiva las operaciones de recolección de basura durante la ejecución en modo multihilo (en el futuro, el recolector de basura será adaptado para la ejecución multihilo de GCC).
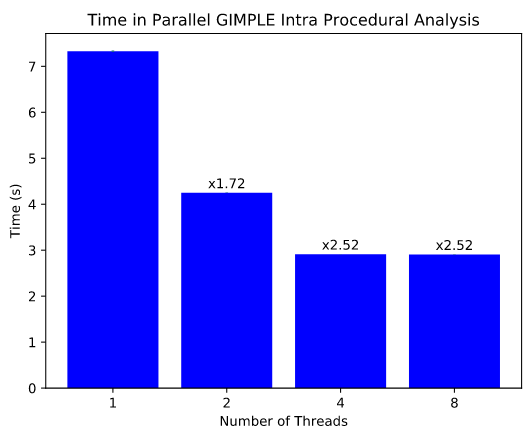
Para evaluar el cambio en el rendimiento, se preparó un conjunto de pruebas que compila el archivo gimple-match.c, que incluye más de 100,000 líneas de código y 1,700 funciones. Las pruebas en un sistema con CPU Intel Core i5-8250U con 4 núcleos físicos y 8 núcleos virtuales (Hyperthreading) mostraron una disminución en el tiempo de ejecución de las optimizaciones Intra Procedural GIMPLE de 7 a 4 segundos al ejecutar 2 hilos y a 3 segundos al ejecutar 4 hilos, es decir, se logró un aumento de velocidad en la fase de compilación considerada de 1.72 y 2.52 veces, respectivamente. Las pruebas también mostraron que el uso de núcleos virtuales con Hyperthreading no conduce a un aumento del rendimiento.
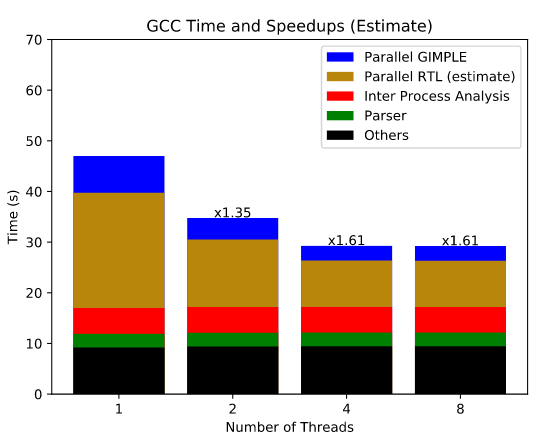
El tiempo total de compilación se redujo aproximadamente en un 10%, pero se prevé que la paralelización de las optimizaciones RTL permitirá obtener resultados más significativos, ya que esta etapa consume considerablemente más tiempo durante la compilación. Se estima que después de la paralelización de RTL, el tiempo total de compilación se reducirá en 1.61 veces. Después de esto, se podrá reducir el tiempo de compilación en un 5-10% más mediante la paralelización de las optimizaciones IPA.
Fuente: opennet.ru
