

Continuación de la traducción de un pequeño libro:
«Entendiendo los intermediarios de mensajes»,
autor: Jakub Korab, editorial: O’Reilly Media, Inc., fecha de publicación: junio de 2017, ISBN: 9781492049296.
Parte traducida anteriormente:
CAPÍTULO 3
Kafka
Kafka fue desarrollado en LinkedIn para superar algunas de las limitaciones de los intermediarios de mensajes tradicionales y evitar la necesidad de configurar varios intermediarios de mensajes para diferentes interacciones «punto a punto», lo que se describe en este libro en la sección «Escalado vertical y horizontal» en la página 28. Los escenarios de uso en LinkedIn se basaron principalmente en la absorción unidireccional de grandes volúmenes de datos, como clics en páginas y registros de acceso, al mismo tiempo que permitían que múltiples sistemas usaran estos datos sin afectar el rendimiento de los productores o de otros consumidores. De hecho, la razón de ser de Kafka es lograr una arquitectura de intercambio de mensajes como la descrita en el Universal Data Pipeline.
Con este objetivo final en mente, naturalmente surgieron otros requisitos. Kafka debe:
- Ser extremadamente rápida
- Ofrecer una alta capacidad de procesamiento en el manejo de mensajes
- Soportar modelos de «Publicador-Subscriptores» y «Punto a Punto»
- No disminuir la velocidad al agregar consumidores. Por ejemplo, el rendimiento de las colas y de los tópicos en ActiveMQ se deteriora con el aumento en el número de consumidores en el destinatario
- Ser escalable horizontalmente; si un intermediario que almacena (persiste) mensajes solo puede hacerlo a la velocidad máxima del disco, tiene sentido exceder un único ejemplar de intermediario para aumentar el rendimiento
- Restringir el acceso al almacenamiento y a la recuperación de mensajes
Para lograr todo esto, Kafka ha adoptado una arquitectura que ha redefinido los roles y responsabilidades de los clientes y los brokers de mensajería. El modelo JMS está muy orientado al broker, donde este se encarga de la distribución de mensajes, mientras que los clientes solo deben preocuparse por enviar y recibir mensajes. Kafka, por otro lado, está centrado en el cliente, haciendo que este asuma muchas de las funciones del broker tradicional, como la distribución justa de mensajes relevantes entre los consumidores, a cambio de recibir un broker extremadamente rápido y escalable. Para aquellos que han trabajado con sistemas de mensajería tradicionales, trabajar con Kafka requiere cambios fundamentales en la perspectiva.
Esta dirección de ingeniería ha llevado a la creación de una infraestructura de mensajería capaz de aumentar la capacidad de procesamiento en órdenes de magnitud en comparación con un broker convencional. Como veremos, este enfoque implica compensaciones que significan que Kafka no es adecuado para ciertos tipos de cargas y software establecido.
Modelo unificado del destinatario
Para cumplir con los requisitos descritos anteriormente, Kafka ha combinado mensajería tipo 'publicación-suscripción' y 'punto a punto' bajo un único tipo de destinatario - tema. Esto confunde a las personas que han trabajado con sistemas de mensajería donde la palabra 'tema' se refiere a un mecanismo de difusión del que (del tema) la lectura no es confiable (es no duradera). Los temas de Kafka deben ser considerados como un tipo híbrido de destinatario, de acuerdo con la definición que se presenta en la introducción de este libro.
En el resto de este capítulo, a menos que indiquemos lo contrario, el término 'tema' se referirá al tema de Kafka.
Para entender completamente cómo se comportan los temas y qué garantías ofrecen, primero debemos considerar cómo están implementados en Kafka.
Cada tema en Kafka tiene su propio registro.
Los productores que envían mensajes a Kafka anotan en este registro, mientras que los consumidores leen del registro utilizando punteros que se mueven continuamente hacia adelante. Periódicamente, Kafka elimina las partes más antiguas del registro, independientemente de si los mensajes en esas partes han sido leídos o no. Una parte central del diseño de Kafka es que el corredor no se preocupa por si los mensajes han sido leídos o no; esa es la responsabilidad del cliente.
Los términos "registro" y "puntero" no aparecen en . Estos términos bien conocidos se utilizan aquí para ayudar a la comprensión.
Este modelo es completamente diferente de ActiveMQ, donde los mensajes de todas las colas se almacenan en un solo registro, y el corredor marca los mensajes como eliminados después de que han sido leídos.
Ahora profundicemos un poco y consideremos el registro del tema más en detalle.
El registro de Kafka consiste en varias particiones (). Kafka garantiza un orden estricto en cada partición. Esto significa que los mensajes escritos en una partición en un orden específico se leerán en el mismo orden. Cada partición se implementa como un archivo de registro cíclico (rolling) que contiene un subconjunto (subset) de todos los mensajes enviados al tema por sus productores. El tema creado contiene por defecto una partición. La idea de las particiones es la idea central de Kafka para la escalabilidad horizontal.
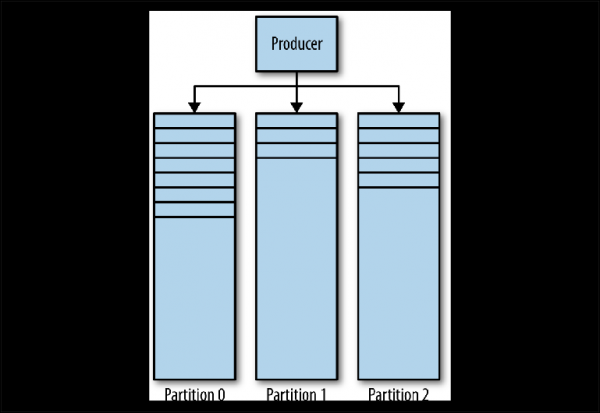
Figura 3-1. Particiones de Kafka
Cuando un productor envía un mensaje al tema de Kafka, decide en qué partición enviar el mensaje. Lo consideraremos más detalladamente más adelante.
Lectura de mensajes
El cliente que desea leer mensajes gestiona un puntero nombrado, llamado grupo de consumidores (consumer group), que apunta a el desplazamiento (offset) del mensaje en la partición. El desplazamiento es una posición con un número creciente que comienza en 0 al comienzo de la partición. Este grupo de consumidores, al que se hace referencia en la API a través de un identificador definido por el usuario group_id, corresponde a un único consumidor lógico o sistema.
La mayoría de los sistemas que utilizan mensajería leen datos de los destinatarios a través de varias instancias y flujos para el procesamiento paralelo de mensajes. Así, generalmente habrá muchas instancias de consumidores compartiendo el mismo grupo de consumidores.
El problema de lectura se puede representar de la siguiente manera:
- Un tema tiene varias particiones.
- Varios grupos de consumidores pueden utilizar el mismo tema simultáneamente.
- Un grupo de consumidores puede tener varias instancias separadas.
Este es un problema no trivial de «muchos a muchos». Para entender cómo Kafka maneja las relaciones entre grupos de consumidores, instancias de consumidores y particiones, consideremos una serie de escenarios de lectura que se complican gradualmente.
Consumidores y grupos de consumidores.
Tomemos como punto de partida un tema con una partición ().
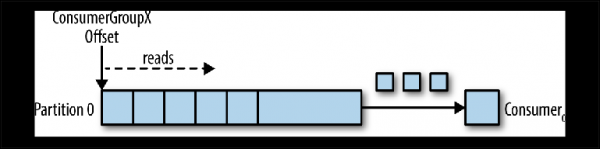
Figura 3-2. El consumidor lee de la partición.
Cuando una instancia de consumidor se conecta a este tema con su propio group_id, se le asigna una partición para leer y un desplazamiento en esa partición. La posición de este desplazamiento se configura en el cliente como un puntero a la posición más reciente (el mensaje más nuevo) o la posición más antigua (el mensaje más antiguo). El consumidor solicita (polls) mensajes del tema, lo que lleva a su lectura secuencial desde el registro.
La posición del desplazamiento se confirma regularmente de nuevo en Kafka y se guarda como mensajes en el tema interno _consumer_offsets. Los mensajes leídos no se eliminan, a diferencia de un corredor normal, y el cliente puede retroceder (rewind) el desplazamiento para volver a procesar los mensajes ya vistos.
Cuando se conecta un segundo consumidor lógico, utilizando otro group_id, gestiona un segundo puntero que no depende del primero (). Por lo tanto, el tema Kafka actúa como una cola, donde existe un único consumidor y, como un tema típico de publicador-suscriptor (pub-sub), al que están suscritos varios consumidores, con la ventaja adicional de que todos los mensajes se conservan y pueden ser procesados varias veces.
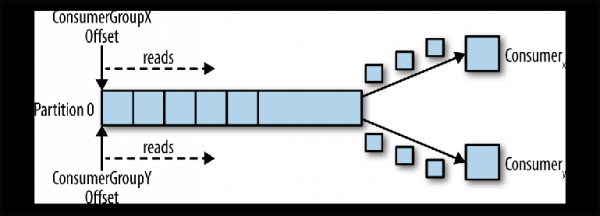
Figura 3-3. Dos consumidores en diferentes grupos de consumidores leen de una partición.
Consumidores en un grupo de consumidores.
Cuando una instancia de consumidor lee datos de una partición, controla completamente el puntero y procesa los mensajes como se describe en la sección anterior.
Si varias instancias de consumidores se han conectado con el mismo group_id a un tema con una partición, la instancia que se conectó por última vez asumirá el control del puntero y a partir de ese momento recibirá todos los mensajes ().
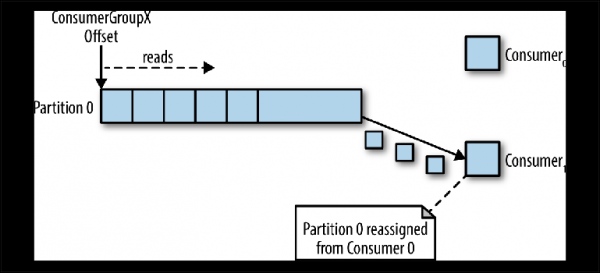
Figura 3-4. Dos consumidores en el mismo grupo de consumidores leen de una partición
Este modo de procesamiento, en el que el número de instancias de consumidores supera el número de particiones, puede considerarse una variedad de consumidor monopolista. Esto puede ser útil si necesita una agrupación de sus instancias de consumidores de "activo-pasivo" (o "caliente-tibia"), aunque es mucho más típica la operación paralela de varios consumidores ("activo-activo" o "caliente-caliente") que los consumidores en modo de espera.
Este comportamiento de distribución de mensajes, descrito anteriormente, puede resultar sorprendente en comparación con el comportamiento de una cola JMS tradicional. En este modelo, los mensajes enviados a la cola se distribuirán equitativamente entre dos consumidores.
A menudo, cuando creamos varias instancias de consumidores, lo hacemos para el procesamiento paralelo de mensajes, para aumentar la velocidad de lectura o para mejorar la resiliencia del proceso de lectura. Dado que solo una instancia de consumidor puede leer datos de una partición a la vez, ¿cómo se logra esto en Kafka?
Una forma de hacerlo es utilizar una instancia de consumidor para leer todos los mensajes y pasarlos a un pool de hilos. Aunque este enfoque aumenta la capacidad de procesamiento, también incrementa la complejidad de la lógica de los consumidores y no contribuye a mejorar la resiliencia del sistema de lectura. Si una instancia de consumidor se desconecta debido a un fallo en la alimentación o un evento similar, la lectura se detiene.
La forma canónica de abordar este problema en Kafka es utilizar unAmayor número de particiones.
Particionado
Las particiones son el mecanismo principal para paralelizar la lectura y escalar un tema más allá de la capacidad de un solo broker. Para comprenderlo mejor, consideremos la situación en la que existe un tema con dos particiones y un consumidor se suscribe a este tema ().
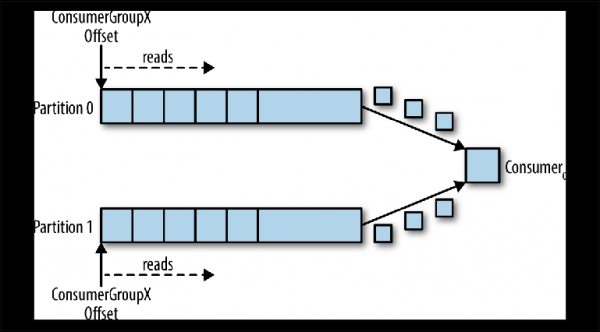
Figura 3-5. Un consumidor lee de múltiples particiones
En este escenario, al consumidor se le da control sobre los punteros que corresponden a su group_id en ambas particiones, y comienza a leer mensajes de ambas particiones.
Cuando se agrega un consumidor adicional a este tema para el mismo group_id, Kafka reasigna (reallocate) una de las particiones del primer al segundo consumidor. Después de eso, cada instancia del consumidor leerá de una partición del tema ().
Para procesar mensajes en paralelo en 20 hilos, necesitará al menos 20 particiones. Si hay menos particiones, tendrá consumidores que no tendrán nada que hacer, como se describió anteriormente en la discusión sobre los consumidores monopolistas.
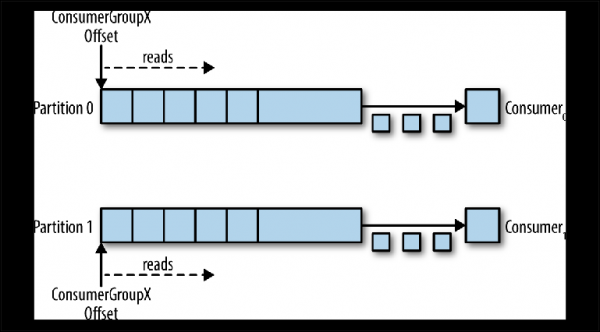
Figura 3-6. Dos consumidores en el mismo grupo de consumidores leen de diferentes particiones
Este esquema reduce significativamente la complejidad del broker de Kafka en comparación con la distribución de mensajes requerida para soportar la cola JMS. Aquí no hay necesidad de preocuparse por los siguientes aspectos:
- Qué consumidor debería recibir el siguiente mensaje, basándose en la distribución en ciclo (round-robin), la capacidad actual de los buffers de lectura anticipada o los mensajes anteriores (como para los grupos de mensajes JMS).
- Qué mensajes se enviaron a qué consumidores y si deben ser entregados nuevamente en caso de fallo.
Todo lo que el broker de Kafka debe hacer es transmitir mensajes de manera secuencial al consumidor cuando este los solicita.
Sin embargo, los requisitos para paralelizar la lectura y reenvío de mensajes fallidos no desaparecen; la responsabilidad por ellos simplemente pasa del broker al cliente. Esto significa que deben ser considerados en su código.
Envío de mensajes
La responsabilidad de decidir a qué partición enviar un mensaje recae en el productor de ese mensaje. Para entender el mecanismo a través del cual se hace esto, primero debemos considerar qué es lo que realmente estamos enviando.
Mientras que en JMS usamos una estructura de mensaje con metadatos (encabezados y propiedades) y un cuerpo que contiene la carga útil (payload), en Kafka el mensaje es un par 'clave-valor'. La carga útil del mensaje se envía como valor (value). La clave, por otro lado, se utiliza principalmente para la partición y debe contener una clave específica de la lógica empresarial, para colocar mensajes relacionados en la misma partición.
En el Capítulo 2 discutimos el escenario de apuestas en línea, donde los eventos relacionados deben procesarse en orden por un único consumidor:
- La cuenta de usuario está configurada.
- El dinero se abona en la cuenta.
- Se realiza una apuesta que retira dinero de la cuenta.
Si cada evento representa un mensaje enviado a un tópico, entonces la clave natural será el identificador de la cuenta.
Cuando se envía un mensaje utilizando la Kafka Producer API, este se pasa a la función de particionamiento, que, considerando el mensaje y el estado actual del clúster de Kafka, devuelve el identificador de la partición a la que debe enviarse el mensaje. Esta función está implementada en Java a través de la interfaz Partitioner.
Esta interfaz se ve de la siguiente manera:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
La implementación de Partitioner para determinar la partición utiliza por defecto un algoritmo de hash de clave (general-purpose hashing algorithm over the key) o un algoritmo round-robin, si no se especifica una clave. Este valor por defecto funciona bien en la mayoría de los casos. Sin embargo, en el futuro querrás escribir tu propio.
Escribir tu propia estrategia de particionamiento
Veamos un ejemplo en el que deseas enviar metadatos junto con la carga útil del mensaje. La carga útil en nuestro ejemplo es una instrucción para realizar un depósito en la cuenta de juego. La instrucción es algo que queremos asegurarnos de no modificar al transmitir y queremos estar seguros de que solo un sistema de confianza puede iniciar esta instrucción. En este caso, los sistemas emisor y receptor acuerdan el uso de una firma para verificar la autenticidad del mensaje.
En un JMS normal, simplemente definimos la propiedad 'firma del mensaje' y la añadimos al mensaje. Sin embargo, Kafka no nos proporciona un mecanismo para transmitir metadatos: solo clave y valor.
Dado que el valor es la carga útil de la transferencia bancaria (bank transfer payload), cuya integridad deseamos mantener, no tenemos más opción que definir la estructura de datos para usar en la clave. Suponiendo que necesitamos un identificador de cuenta para la partición, ya que todos los mensajes relacionados con la cuenta deben procesarse en orden, idearemos la siguiente estructura JSON:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Dado que el valor de la firma variará dependiendo de la carga útil, la estrategia de hashing predeterminada de la interfaz Partitioner no agrupará de manera confiable los mensajes relacionados. Por lo tanto, necesitaremos escribir nuestra propia estrategia, que analizará esta clave y separará (partition) el valor accountId.
Kafka incluye sumas de verificación para detectar la corrupción de mensajes en el almacenamiento y tiene un conjunto completo de funciones de seguridad. Aun así, a veces surgen requisitos específicos de la industria, como el que se menciona arriba.
La estrategia de partición personalizada debe garantizar que todos los mensajes relacionados se encuentren en una sola partición. Aunque esto parece sencillo, el requisito puede complicarse debido a la importancia de mantener el orden de los mensajes relacionados y a cuán fijo está el número de particiones en el tema.
El número de particiones en un tema puede cambiar con el tiempo, ya que se pueden añadir si el tráfico supera las expectativas iniciales. Así, las claves de los mensajes pueden estar relacionadas con la partición a la que fueron enviadas originalmente, implicando parte del estado que debe ser distribuido entre las instancias del productor.
Otro factor a considerar es la uniformidad de la distribución de mensajes entre las particiones. Como regla general, las claves no se distribuyen de manera uniforme en los mensajes, y las funciones de hash no garantizan una distribución justa de los mensajes para un conjunto pequeño de claves.
Es importante señalar que, independientemente de cómo decida dividir los mensajes, es posible que deba reutilizar el propio delimitador.
Consideremos el requisito de replicación de datos entre clústeres de Kafka en diferentes ubicaciones geográficas. Para este propósito, Kafka viene con una herramienta de línea de comandos llamada MirrorMaker, que se utiliza para leer mensajes de un clúster y transferirlos a otro.
MirrorMaker debe entender las claves del tema a replicar para mantener el orden relativo de los mensajes durante la replicación entre clústeres, ya que el número de particiones para este tema puede no coincidir en los dos clústeres.
Las estrategias de particionamiento personalizadas son relativamente raras, ya que el hash predeterminado o el redondeo funcionan con éxito en la mayoría de los escenarios. Sin embargo, si necesita garantías estrictas de ordenamiento o necesita extraer metadatos de las cargas útiles, entonces el particionamiento es algo en lo que debe profundizar.
Las ventajas de escalabilidad y rendimiento de Kafka se deben al traslado de algunas responsabilidades tradicionales del corredor al cliente. En este caso, se toma la decisión de distribuir mensajes potencialmente relacionados entre varios consumidores que operan en paralelo.
Los corredores de JMS también deben lidiar con tales requisitos. Curiosamente, el mecanismo de envío de mensajes relacionados al mismo consumidor, implementado a través de JMS Message Groups (una variante de la estrategia de balanceo de carga adhesivo (SLB)), también requiere que el remitente etiquete los mensajes como relacionados. En el caso de JMS, el corredor es responsable de enviar este grupo de mensajes relacionados a un consumidor de muchos y de transferir la propiedad del grupo si el consumidor falla.
Acuerdos del productor
El particionamiento no es lo único que se debe considerar al enviar mensajes. Vamos a revisar los métodos send() de la clase Producer en la API de Java:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
Es importante señalar que ambos métodos devuelven un Future, lo que indica que la operación de envío no se lleva a cabo de inmediato. Como resultado, el mensaje (ProducerRecord) se escribe en el búfer de envío para cada partición activa y se envía al corredor en segundo plano por un hilo en la biblioteca del cliente de Kafka. Aunque esto hace que el trabajo sea increíblemente rápido, significa que una aplicación mal escrita puede perder mensajes si su proceso se detiene.
Como siempre, hay una forma de hacer la operación de envío más confiable a expensas del rendimiento. Se puede establecer el tamaño de este búfer en 0, y el hilo de la aplicación de envío se verá obligado a esperar hasta que se complete la transmisión del mensaje al corredor, de la siguiente manera:
RecordMetadata metadata = producer.send(record).get();Una vez más sobre la lectura de mensajes
Leer mensajes conlleva complicaciones adicionales que deben considerarse. A diferencia de la API JMS, que puede iniciar un oyente de mensajes (message listener) en respuesta a la llegada de un mensaje, la interfaz Consumidor Kafka solo realiza polling. Analicemos más a fondo el método poll (), que se utiliza para este propósito:
ConsumerRecords poll(long timeout);El valor devuelto por el método es una estructura contenedora que contiene varios objetos ConsumerRecord de potencialmente varias particiones. ConsumerRecord es en sí misma un objeto contenedor para un par clave-valor con los metadatos correspondientes, como la partición de la que se obtuvo.
Como se discutió en el Capítulo 2, debemos recordar constantemente qué sucede con los mensajes después de que han sido procesados exitosamente o no, por ejemplo, si el cliente no puede procesar un mensaje o si se detiene. En JMS, esto se manejaba a través del modo de confirmación (acknowledgement mode). El corredor eliminará el mensaje procesado exitosamente o volverá a entregar el que no se procesó o falló (si se utilizaron transacciones).
Kafka funciona de manera muy diferente. Los mensajes no se eliminan en el corredor después de ser leídos y la responsabilidad de lo que ocurre en caso de fallo recae en el propio código de lectura.
Como ya mencionamos, un grupo de consumidores está asociado con un desplazamiento en el registro. La posición en el registro asociada con este desplazamiento corresponde al siguiente mensaje que se emitirá en respuesta a poll ()El momento en que se produce este desplazamiento es crucial para la lectura.
Volviendo al modelo de lectura mencionado anteriormente, el procesamiento del mensaje consta de tres etapas:
- Extraer el mensaje para leer.
- Procesar el mensaje.
- Confirmar el mensaje.
El consumidor de Kafka viene con una opción de configuración enable.auto.commit. Esta es una configuración predeterminada comúnmente utilizada, como suele ser el caso con las configuraciones que contienen la palabra 'auto'.
Hasta Kafka 0.10, el cliente que utilizaba este parámetro enviaba el desplazamiento del último mensaje leído en la siguiente llamada poll () después del procesamiento. Esto significaba que cualquier mensaje que ya hubiera sido extraído podría ser procesado nuevamente si el cliente ya lo había procesado, pero fue destruido inesperadamente antes de la llamada poll (). Dado que el corredor no mantiene ningún estado sobre cuántas veces se ha leído un mensaje, el siguiente consumidor que extrae este mensaje no sabrá que ocurrió algo malo. Este comportamiento era pseudo-transaccional. El desplazamiento se confirmaba solo en caso de que el mensaje se procesara con éxito, pero si el cliente se interrumpía, el corredor enviaba nuevamente el mismo mensaje a otro cliente. Este comportamiento se alineaba con la garantía de entrega de mensajes 'al menos una vez«.
En Kafka 0.10, el código del cliente se modificó de tal manera que la confirmación comenzaba a ejecutarse periódicamente por la biblioteca del cliente, de acuerdo con la configuración auto.commit.interval.ms. Este comportamiento se encuentra en algún lugar entre los modos JMS AUTO_ACKNOWLEDGE y DUPS_OK_ACKNOWLEDGE. Al utilizar la confirmación automática, los mensajes podían ser confirmados independientemente de si habían sido procesados realmente — esto podría ocurrir en el caso de un consumidor lento. Si el consumidor se interrumpía, los mensajes eran extraídos por el siguiente consumidor, comenzando desde la posición confirmada, lo que podría llevar a la omisión de mensajes. En este caso, Kafka no perdía mensajes, simplemente el código de lectura no los procesaba.
Este modo tiene las mismas perspectivas que en la versión 0.9: los mensajes pueden ser procesados, pero en caso de falla, el desplazamiento puede no estar confirmado, lo que potencialmente puede llevar a la duplicación de entregas. Cuantos más mensajes extraigas al realizar poll (), más grande es este problema.
Como se discutió en la sección 'Lectura de mensajes de la cola' en la página 21, en el sistema de mensajería no existe el concepto de entrega única de un mensaje, considerando los modos de falla.
En Kafka, hay dos formas de confirmar (comprometer) un desplazamiento (offset): automática y manualmente. En ambos casos, los mensajes pueden ser procesados varias veces si un mensaje se procesó, pero hubo un fallo antes del compromiso. También puede no procesar un mensaje en absoluto si el compromiso se realizó en segundo plano y su código se completó antes de que comenzara el procesamiento (posiblemente en Kafka 0.9 y versiones anteriores).
Usted puede gestionar el proceso de compromiso de desplazamiento manualmente en la API del consumidor de Kafka, estableciendo el parámetro enable.auto.commit en false y llamando explícitamente a uno de los siguientes métodos:
void commitSync();
void commitAsync();
Si desea procesar un mensaje 'al menos una vez', debe comprometer el desplazamiento manualmente usando commitSync(), ejecutando este comando inmediatamente después de procesar los mensajes.
Estos métodos no permiten confirmar (acknowledged) los mensajes hasta que sean procesados, pero no hacen nada para abordar la posible duplicación del procesamiento, al mismo tiempo que crean la apariencia de transacciones. En Kafka no existen transacciones. El cliente no puede hacer lo siguiente:
- Revertir automáticamente (roll back) un mensaje fallido. Los consumidores deben manejar las excepciones que surgen de cargas problemáticas y desconexiones del backend, ya que no pueden confiar en la reentrega de mensajes por parte del corredor.
- Enviar mensajes a múltiples temas como parte de una sola operación atómica. Como veremos pronto, el control sobre diferentes temas y particiones puede encontrarse en diferentes máquinas en el clúster de Kafka, las cuales no coordinan transacciones al enviar. Hasta el momento de redactar este artículo, se había realizado un trabajo considerable para hacer esto posible a través de KIP-98.
- Vincular la lectura de un mensaje de un tema con el envío de otro mensaje a otro tema. Nuevamente, la arquitectura de Kafka depende de muchas máquinas independientes que operan como un solo bus y no se hacen esfuerzos para ocultar esto. Por ejemplo, no existen componentes de API que permitan vincular Consumidor y Productor en la transacción. En JMS, esto es garantizado por el objeto Session, del cual se crean MessageProducers y MessageConsumers.
Si no podemos confiar en las transacciones, ¿cómo podemos garantizar una semántica más cercana a la que proporcionan los sistemas de mensajería tradicionales?
Si hay una posibilidad de que el desplazamiento del consumidor pueda aumentar antes de que se procese el mensaje, por ejemplo, durante una falla del consumidor, entonces el consumidor no tiene forma de saber si su grupo de consumidores ha perdido mensajes al asignarles una partición. Así, una de las estrategias consiste en rebobinar el desplazamiento a la posición anterior. La API del consumidor de Kafka proporciona los siguientes métodos para esto:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
El método seek () puede ser usado junto con el método
offsetsForTimes (Map timestampsToSearch) para rebobinar a un estado en un momento determinado en el pasado.
Implícitamente, el uso de este enfoque significa que, muy probablemente, algunos mensajes que ya fueron procesados serán leídos y procesados nuevamente. Para evitar esto, podemos usar la lectura idempotente, como se describe en el Capítulo 4, para rastrear los mensajes previamente vistos y excluir duplicados.
Como alternativa, el código de su consumidor puede ser simple si se permite la pérdida o duplicación de mensajes. Cuando consideramos escenarios de uso para los que generalmente se utiliza Kafka, como el procesamiento de eventos de registros, métricas, seguimiento de clics, etc., entendemos que la pérdida de mensajes individuales probablemente no tendrá un impacto significativo en las aplicaciones circundantes. En tales casos, los valores predeterminados son completamente aceptables. Por otro lado, si su aplicación necesita procesar pagos, debe cuidar cuidadosamente cada mensaje individual. Todo se reduce al contexto.
Observaciones personales muestran que a medida que aumenta la intensidad de los mensajes, el valor de cada mensaje individual disminuye. Mensajes de gran volumen se vuelven, por lo general, valiosos si se consideran en forma agregada.
Alta disponibilidad (High Availability)
El enfoque de Kafka en cuanto a alta disponibilidad es significativamente diferente al de ActiveMQ. Kafka está diseñada sobre la base de clústeres horizontalmente escalables, donde todas las instancias del broker reciben y entregan mensajes simultáneamente.
Un clúster de Kafka consiste en varias instancias de brokers que funcionan en diferentes servidores. Kafka fue diseñada para operar en hardware autónomo común, donde cada nodo tiene su propio almacenamiento dedicado. No se recomienda el uso de almacenamiento en red (SAN), ya que múltiples nodos de cómputo pueden competir por intervalos temporales de almacenamiento y crear conflictos.ЫLos
Kafka es un sistema siempre activo. Muchos grandes usuarios de Kafka nunca apagan sus clústeres y el software siempre actualiza mediante reinicios secuenciales. Esto se logra garantizando la compatibilidad con versiones anteriores para los mensajes y las interacciones entre brokers.
Los brokers están conectados al clúster de servidores , que actúa como un registro de datos de configuración y se utiliza para coordinar los roles de cada broker. ZooKeeper en sí es un sistema distribuido que asegura alta disponibilidad mediante la replicación de información al establecer un quórum..
En su caso básico, un tema se crea en el clúster de Kafka con las siguientes propiedades:
- Número de particiones. Como se discutió anteriormente, el valor exacto utilizado aquí depende del nivel deseado de lectura paralela.
- El factor de replicación determina cuántas instancias de brokers en el clúster deben contener los logs para esta partición.
Usando ZooKeepers para la coordinación, Kafka intenta distribuir de manera justa nuevas particiones entre los brokers en el clúster. Esto se hace mediante una instancia que cumple el rol de Controlador.
En tiempo de ejecución, para cada partición del tema, Controlador asigna roles de broker líder (leader, maestro, principal) y seguidores. (seguidores, esclavos, subordinados). El corredor que actúa como líder para esta partición es responsable de recibir todos los mensajes enviados por los productores y distribuir los mensajes a los consumidores. Al enviar mensajes a la partición del tema, se replican en todos los nodos del corredor que actúan como seguidores para esta partición. Cada nodo que contiene registros para la partición se llama réplica. El corredor puede actuar como líder para algunas particiones y como seguidor para otras.
El seguidor que contiene todos los mensajes almacenados en el líder se llama réplica sincronizada (réplica en estado sincronizado, in-sync replica). Si el corredor que actúa como líder para la partición se apaga, cualquier corredor que esté en estado actualizado o sincronizado para esta partición puede asumir el papel de líder. Este es un diseño increíblemente resistente.
Una parte de la configuración del productor es el parámetro acks, que define cuántas réplicas deben confirmar (acknowledge) la recepción de un mensaje antes de que el flujo de la aplicación continúe enviando: 0, 1 o todos. Si se establece el valor todo, al recibir un mensaje, el líder enviará una confirmación (confirmation) de vuelta al productor tan pronto como reciba confirmaciones (acknowledgements) de varias réplicas (incluyéndose a sí mismo), definidas por la configuración del tema min.insync.replicas (por defecto 1). Si el mensaje no puede ser replicado con éxito, el productor lanzará una excepción para la aplicación (NotEnoughReplicas o NotEnoughReplicasAfterAppend).
En una configuración típica, se crea un tema con un factor de replicación de 3 (1 líder, 2 seguidores para cada partición) y el parámetro min.insync.replicas se establece en 2. En este caso, el clúster permitirá que uno de los corredores que gestionan la partición del tema se apague sin afectar a las aplicaciones cliente.
Esto nos lleva de vuelta al compromiso ya conocido entre rendimiento y confiabilidad. La replicación ocurre a costa de un tiempo adicional esperando confirmaciones (acknowledgments) de los seguidores. Sin embargo, dado que se realiza en paralelo, la replicación en al menos tres nodos tiene el mismo rendimiento que en dos (ignorando el aumento del uso del ancho de banda de la red).
Al utilizar este esquema de replicación, Kafka elude hábilmente la necesidad de garantizar la grabación física de cada mensaje en disco mediante la operación sync (). Cada mensaje enviado por el productor se registrará en el registro de la partición, pero, como se discutió en el Capítulo 2, la grabación en el archivo se realiza inicialmente en el búfer del sistema operativo. Si este mensaje se replica en otra instancia de Kafka y está en su memoria, la pérdida de líder no significa que el mensaje en sí se haya perdido; puede ser tomado por una réplica sincronizada.
Renunciar a la necesidad de ejecutar la operación sync () significa que Kafka puede aceptar mensajes a la velocidad a la que puede grabarlos en memoria. Y viceversa, cuanto más tiempo se pueda evitar el volcado (flushing) de memoria a disco, mejor. Por esta razón, no es raro que a los brokers de Kafka se les asigne 64 GB de memoria o más. Este uso de memoria significa que una instancia de Kafka puede funcionar fácilmente a velocidades miles de veces más rápidas que un broker de mensajes tradicional.
Kafka también se puede configurar para aplicar la operación sync () a lotes de mensajes. Dado que todo en Kafka está orientado al trabajo con lotes, esto en realidad funciona bastante bien para muchos escenarios de uso y es una herramienta útil para los usuarios que requieren garantías muy sólidas. Gran parte del rendimiento puro de Kafka está asociado con los mensajes que se envían al broker en forma de lotes, y con el hecho de que estos mensajes se leen del broker en bloques consecutivos mediante operaciones (operaciones en las que no se realiza la tarea de copiar datos de una área de memoria a otra). Esto último es una gran ganancia en términos de rendimiento y recursos, y es posible solo gracias al uso de la estructura de datos de registro subyacente que define el esquema de partición.
En un clúster de Kafka, se puede lograr un rendimiento mucho más alto que al usar un único broker de Kafka, ya que las particiones del tema pueden escalar horizontalmente en múltiples máquinas individuales.
Resultados
En este capítulo, hemos explorado cómo la arquitectura de Kafka redefine las relaciones entre clientes y brokers para proporcionar un canal de mensajería increíblemente resistente, con un ancho de banda muchas veces mayor que el de un broker de mensajes convencional. Discutimos las funcionalidades que utiliza para lograr este objetivo y revisamos brevemente la arquitectura de las aplicaciones que ofrecen dicha funcionalidad. En el siguiente capítulo, abordaremos los problemas comunes que las aplicaciones basadas en mensajería deben resolver y discutiremos estrategias para solucionarlos. Finalizaremos el capítulo esbozando cómo razonar sobre las tecnologías de mensajería en general, para que pueda evaluar su idoneidad para sus escenarios de uso.
Parte traducida anteriormente:
Traducción realizada por:
Continuará...
Solo los usuarios registrados pueden participar en la encuesta. , por favor.
¿Se utiliza Kafka en su organización?
Sí
No
Se utilizó anteriormente, ahora no
Planeamos utilizarlo
38 usuarios votaron. 8 usuarios se abstuvieron.
Fuente: habr.com
