

En el analizador PVS-Studio para los lenguajes C y C++ en Linux y macOS, a partir de la versión 7.04, se añadió una función de prueba para verificar la lista de archivos especificados. Con el nuevo modo, se puede configurar el analizador para comprobar commits y pull requests. En este artículo, se explicará cómo configurar la verificación de la lista de archivos modificados en un proyecto de GitHub en sistemas CI (Integración Continua) populares como Travis CI, Buddy y AppVeyor.
Modo de verificación de la lista de archivos
es una herramienta para detectar errores y vulnerabilidades potenciales en el código fuente de programas escritos en los lenguajes C, C++, C# y Java. Funciona en sistemas de 64 bits en Windows, Linux y macOS.
En la versión PVS-Studio 7.04 para Linux y macOS se introdujo el modo de verificación de la lista de archivos fuente. Esto funciona para proyectos cuya sistema de compilación permite generar un archivo . Este archivo es necesario para que el analizador extraiga información sobre la compilación de los archivos especificados. Si su sistema de compilación no admite la generación del archivo compile_commands.json, puede intentar generar dicho archivo con la herramienta .
El modo de verificación de la lista de archivos también se puede utilizar junto con el registro de seguimiento de strace para los lanzamientos del compilador (pvs-studio-analyzer trace). Para ello, primero deberá realizar una compilación completa del proyecto y rastrearla para que el analizador recopile toda la información sobre los parámetros de compilación de todos los archivos verificados.
Sin embargo, esta opción tiene una desventaja significativa: será necesario o realizar un seguimiento completo de la compilación de todo el proyecto en cada ejecución, lo cual contradice la idea de una verificación rápida del commit. O, si se almacenan en caché los resultados del seguimiento, las ejecuciones posteriores del analizador pueden resultar incompletas si la estructura de dependencias de los archivos fuente cambia después del seguimiento (por ejemplo, si se añade un nuevo #include a uno de los archivos fuente).
Por lo tanto, no recomendamos utilizar el modo de verificación de la lista de archivos con el registro de seguimiento para verificar commits o pull requests. Si puede hacer una compilación incremental al verificar el commit, considere la posibilidad de utilizar el modo .
La lista de archivos fuente para análisis se guarda en un archivo de texto y se pasa al analizador mediante el parámetro -S:
pvs-studio-analyzer analyze ... -f build/compile_commands.json -S check-list.txtEste archivo especifica rutas relativas o absolutas a archivos, cada nuevo archivo debe estar en una nueva línea. Se puede indicar no solo los nombres de archivos para el análisis, sino también texto variado. El analizador verá que no es un archivo y ignorará la línea. Esto puede ser útil para comentarios si los archivos se especifican manualmente. Sin embargo, a menudo la lista de archivos se generará durante el análisis en CI, por ejemplo, pueden ser archivos de un commit o de un pull request.
Ahora, con este modo, se puede verificar rápidamente nuevo código antes de que llegue a la rama principal de desarrollo. Para que el sistema de verificación reaccione a la presencia de advertencias del analizador, en la utilidad plog-converter se ha añadido la bandera —indicate-warnings:
plog-converter ... --indicate-warnings ... -o /path/to/report.tasks ...Con esta bandera, el convertidor devolverá un código no nulo si en el informe del analizador hay advertencias. A partir del código de retorno se puede bloquear el hook de pre-commit, el commit o pull request, y el informe generado del analizador mostrarlo en pantalla, compartirlo o enviarlo por correo.
Nota. En la primera ejecución del análisis de la lista de archivos, se analizará todo el proyecto, ya que el analizador necesita generar un archivo de dependencias de los archivos de origen del proyecto respecto a los archivos de encabezado. Esta es una característica del análisis de archivos C y C++. En adelante, el archivo de dependencias se puede almacenar en caché y se actualizará automáticamente por el analizador. La ventaja de verificar commits al utilizar el modo de verificación de lista de archivos sobre el uso del modo de análisis incremental es que solo se necesita caching de este archivo, no de los archivos objeto.
Principios generales del análisis de pull request
Analizar todo el proyecto toma bastante tiempo, por lo que tiene sentido verificar solo una parte de él. El problema es que se deben separar los nuevos archivos de los demás archivos del proyecto.
Consideremos un ejemplo de árbol de commits con dos ramas:
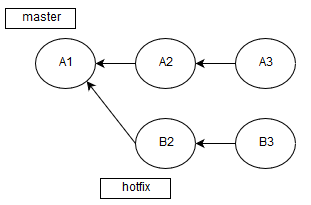
Imaginemos que el commit A1 contiene una cantidad considerable de código que ya ha sido revisado. Un poco antes hicimos una rama del commit A1 y modificamos algunos archivos.
Seguramente notaron que después de A1 hubo otros dos commits, pero también fueron fusiones de otras ramas, ya que no estamos haciendo commits en master. Y ahora ha llegado el momento, en el que hotfix listo. Por eso se creó un pull request para la fusión B3 y A3.
Por supuesto, se podría haber revisado todo el resultado de su fusión, pero eso sería demasiado prolongado y poco justificado, ya que solo se modificaron algunos archivos. Por lo tanto, es más eficiente analizar solo los cambiados.
Para esto, obtendremos la diferencia entre las ramas, estando en la rama HEAD de la que queremos fusionar en master:
git diff --name-only HEAD origin/$MERGE_BASE > .pvs-pr.list$MERGE_BASE lo discutiremos en detalle más adelante. En realidad, no todos los servicios de CI proporcionan la información necesaria sobre la base para la fusión, por lo que cada vez hay que idear nuevas formas de obtener estos datos. Esto se describirá detalladamente a continuación en cada uno de los servicios web mencionados.
Así que hemos obtenido la diferencia entre las ramas, más precisamente, una lista de nombres de archivos que han sido modificados. Ahora necesitamos pasar el archivo .pvs-pr.list (donde hemos redirigido la salida anteriormente) al analizador:
pvs-studio-analyzer analyze -j8
                            -o PVS-Studio.log
                            -S .pvs-pr.list
Después del análisis, necesitamos convertir el archivo de logs (PVS-Studio.log) a un formato más comprensible:
plog-converter -t errorfile PVS-Studio.log --cerr -wEste comando generará una lista de errores en (flujo estándar de salida de mensajes de error).
Solo que necesitamos no solo mostrar los errores, sino también informar a nuestro servicio de compilación y prueba sobre la existencia de problemas. Para esto, se ha añadido una bandera al conversor -W (—indicate-warnings). Si hay al menos una advertencia del analizador, el código de retorno de la utilidad plog-converter cambiará a 2, lo que a su vez informará al servicio de CI sobre la existencia de posibles errores en los archivos del pull request.
Travis CI
La configuración se realiza en forma de un archivo .travis.yml. Para facilitar, recomiendo llevar todo a un script bash separado con funciones que se llamarán desde el archivo .travis.yml (bash nombre_script.sh nombre_función).
Iremos añadiendo el código necesario al script en bash, de este modo obtendremos una mayor funcionalidad. En la sección install escribiremos lo siguiente:
install:
  - bash .travis.sh travis_install
Si tienes alguna instrucción, puedes trasladarlas al script, eliminando los guiones.
Abriremos el archivo .travis.sh y añadiremos la instalación del analizador a la función travis_install():
travis_install() {
  wget -q -O - https://files.viva64.com/etc/pubkey.txt
    | sudo apt-key add -
  sudo wget -O /etc/apt/sources.list.d/viva64.list
    https://files.viva64.com/etc/viva64.list

  sudo apt-get update -qq
  sudo apt-get install -qq pvs-studio
}
Ahora añadamos en la sección script el inicio del análisis:
script:
  - bash .travis.sh travis_script
Y en el script bash:
travis_script() {
  pvs-studio-analyzer credentials $PVS_USERNAME $PVS_KEY

  if [ "$TRAVIS_PULL_REQUEST" != "false" ]; then
    git diff --name-only origin/HEAD > .pvs-pr.list
    pvs-studio-analyzer analyze -j8
                                -o PVS-Studio.log
                                -S .pvs-pr.list
                                --disableLicenseExpirationCheck
  else
    pvs-studio-analyzer analyze -j8
                                -o PVS-Studio.log
                                --disableLicenseExpirationCheck
  fi

  plog-converter -t errorfile PVS-Studio.log --cerr -w
}
Este código debe ejecutarse después de construir el proyecto, por ejemplo, si tuvo una construcción en CMake:
travis_script() {
  CMAKE_ARGS="-DCMAKE_EXPORT_COMPILE_COMMANDS=On ${CMAKE_ARGS}"
  cmake $CMAKE_ARGS CMakeLists.txt
  make -j8
}
Quedará así:
travis_script() {
  CMAKE_ARGS="-DCMAKE_EXPORT_COMPILE_COMMANDS=On ${CMAKE_ARGS}"
  cmake $CMAKE_ARGS CMakeLists.txt
  make -j8

  pvs-studio-analyzer credentials $PVS_USERNAME $PVS_KEY

  if [ "$TRAVIS_PULL_REQUEST" != "false" ]; then
    git diff --name-only origin/HEAD > .pvs-pr.list
    pvs-studio-analyzer analyze -j8
                                -o PVS-Studio.log
                                -S .pvs-pr.list
                                --disableLicenseExpirationCheck
  else
    pvs-studio-analyzer analyze -j8
                                -o PVS-Studio.log
                                --disableLicenseExpirationCheck
  fi

  plog-converter -t errorfile PVS-Studio.log --cerr -w
}
Probablemente ya ha notado las variables de entorno mencionadas $TRAVIS_PULL_REQUEST y $TRAVIS_BRANCH. Travis CI las declara automáticamente:
- $TRAVIS_PULL_REQUEST almacena el número de la solicitud de extracción o false, si es una rama normal;
- $TRAVIS_REPO_SLUG almacena el nombre del repositorio del proyecto.
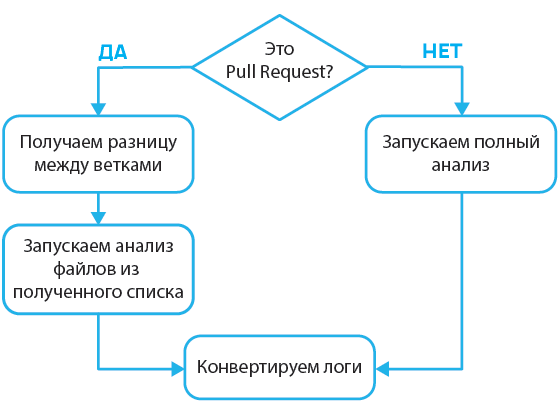
El algoritmo de funcionamiento de esta función:
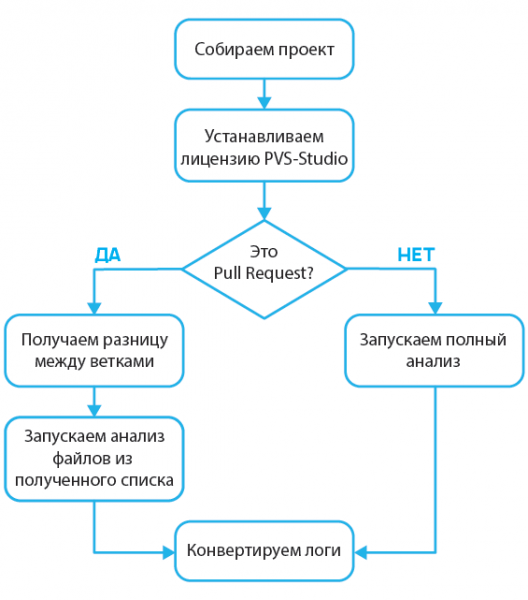
Travis CI reacciona a los códigos de retorno, por lo que la presencia de advertencias indicará al servicio que marque el commit como que contiene errores.
Ahora analicemos más de cerca esta línea de código:
git diff --name-only origin/HEAD > .pvs-pr.listEl hecho es que Travis CI fusiona automáticamente las ramas durante el análisis de la solicitud de extracción:
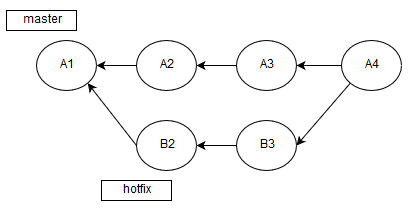
Por lo tanto, estamos analizando A4, y no B3->A3. Debido a esta particularidad, necesitamos calcular la diferencia con A3, que es precisamente el vértice de la rama de origen.
Queda un detalle importante: la caché de las dependencias de los archivos de encabezado de las unidades de traducción compilables (*.c, *.cc, *.cpp, etc.). Estas dependencias son calculadas por el analizador en la primera ejecución en modo de verificación de la lista de archivos y luego se guardan en el directorio .PVS-Studio. Travis CI permite almacenar en caché las carpetas, por lo que guardaremos los datos del directorio .PVS-Studio/:
cache:
  directories:
    - .PVS-Studio/
Este código debe añadirse al archivo .travis.yml. Este directorio almacena diferentes datos recopilados después del análisis, lo que acelerará significativamente las siguientes ejecuciones del análisis de la lista de archivos o del análisis incremental. Si no lo hacemos, el analizador efectivamente analizará todos los archivos cada vez.
Buddy
Al igual que Travis CI, ofrece la posibilidad de construcción y prueba automatizadas de proyectos alojados en GitHub. A diferencia de Travis CI, se configura a través de una interfaz web (se admite bash), por lo que no es necesario almacenar archivos de configuración en el proyecto.
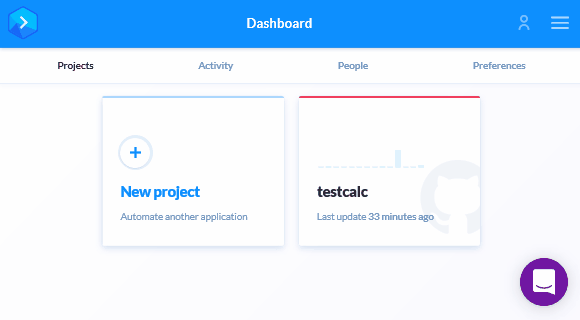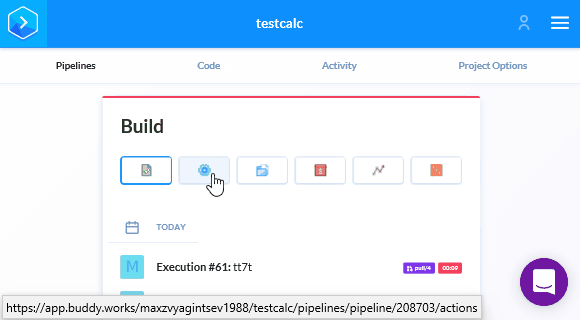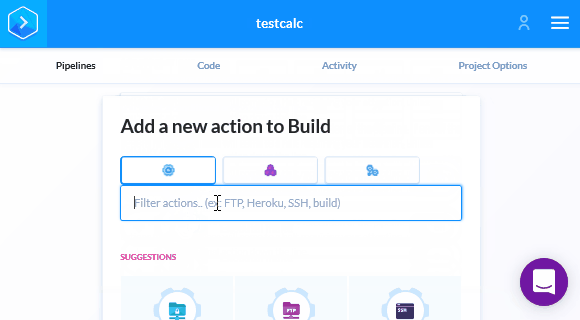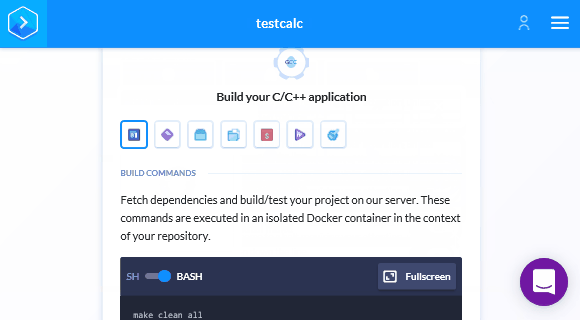
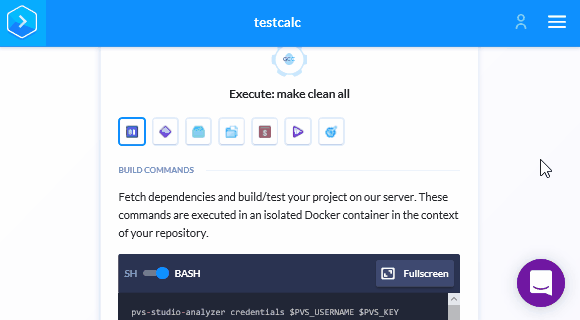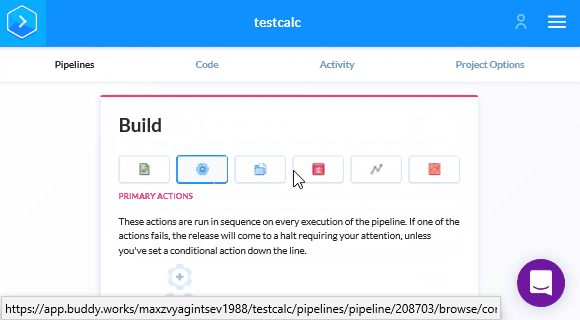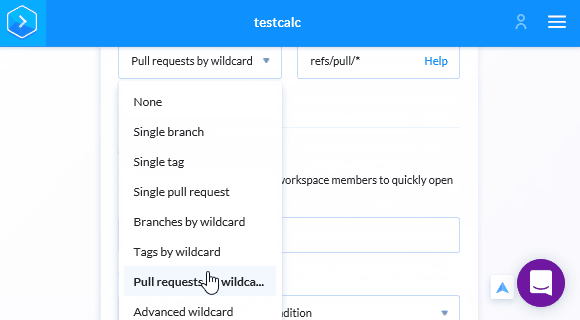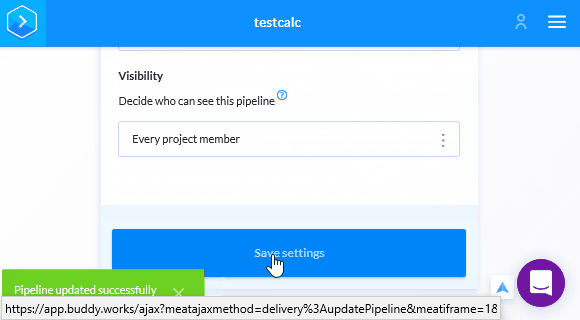
En primer lugar, necesitamos agregar una nueva acción a la línea de construcción:
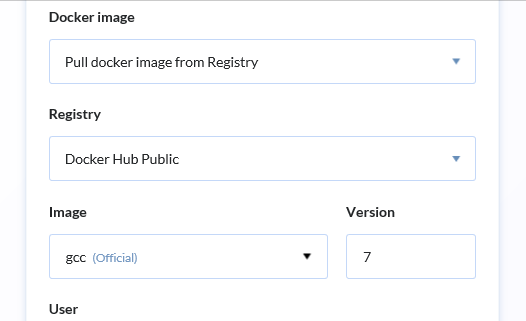
Especificaremos el compilador que se utilizó para construir el proyecto. Tenga en cuenta el contenedor de Docker que se establece en esta acción. Por ejemplo, para GCC hay un contenedor específico:
Ahora instalemos PVS-Studio y las utilidades necesarias:
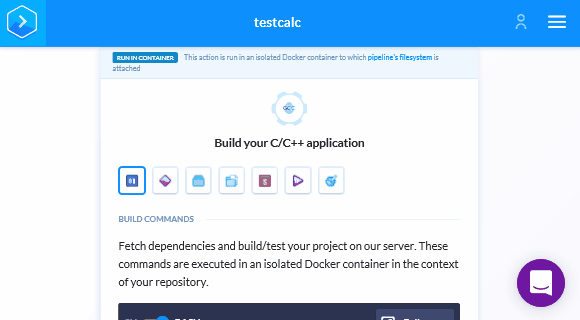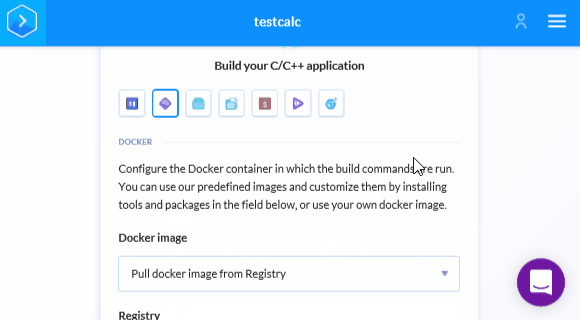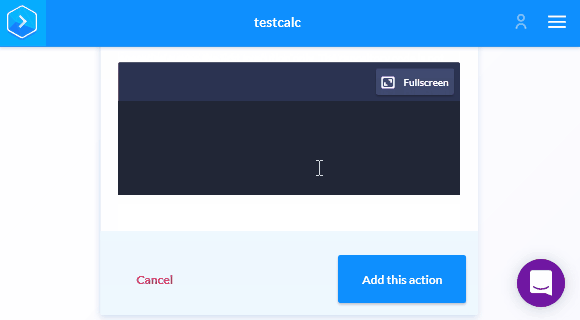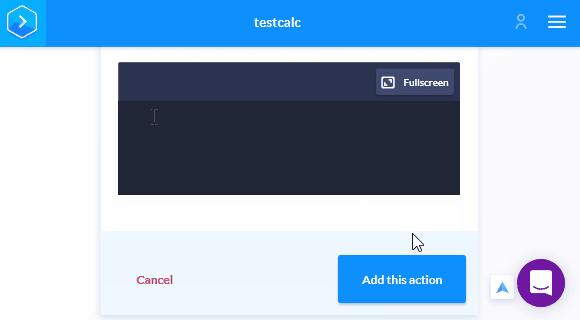
Agreguemos las siguientes líneas al editor:
apt-get update && apt-get -y install wget gnupg jq

wget -q -O - https://files.viva64.com/etc/pubkey.txt | apt-key add -
wget -O /etc/apt/sources.list.d/viva64.list
  https://files.viva64.com/etc/viva64.list

apt-get update && apt-get -y install pvs-studio
Ahora vayamos a la pestaña Ejecutar (el primer icono) y en el campo correspondiente del editor agreguemos el siguiente código:
pvs-studio-analyzer credentials $PVS_USERNAME $PVS_KEY

if [ "$BUDDY_EXECUTION_PULL_REQUEST_NO" != '' ]; then
  PULL_REQUEST_ID="pulls/$BUDDY_EXECUTION_PULL_REQUEST_NO"
  MERGE_BASE=`wget -qO -
    https://api.github.com/repos/${BUDDY_REPO_SLUG}/${PULL_REQUEST_ID}
    | jq -r ".base.ref"`

  git diff --name-only HEAD origin/$MERGE_BASE > .pvs-pr.list
  pvs-studio-analyzer analyze -j8
                              -o PVS-Studio.log
                              --disableLicenseExpirationCheck
                              -S .pvs-pr.list
else
  pvs-studio-analyzer analyze -j8
                              -o PVS-Studio.log
                              --disableLicenseExpirationCheck
fi

plog-converter -t errorfile PVS-Studio.log --cerr -w
Si leíste la sección dedicada a Travs-CI, este código te resultará familiar, sin embargo, ahora ha surgido una nueva etapa:
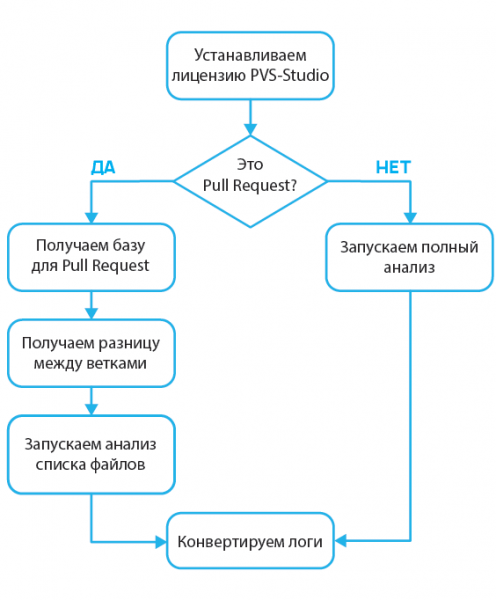
La cuestión es que ahora estamos analizando no el resultado de la fusión, sino HEAD de la rama de la que se realiza el pull request:
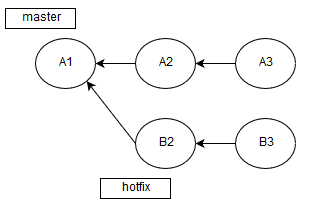
Así que estamos en un commit condicional B3 y necesitamos obtener la diferencia con A3:
PULL_REQUEST_ID="pulls/$BUDDY_EXECUTION_PULL_REQUEST_NO"
  MERGE_BASE=`wget -qO -
    https://api.github.com/repos/${BUDDY_REPO_SLUG}/${PULL_REQUEST_ID}
    | jq -r ".base.ref"`
git diff --name-only HEAD origin/$MERGE_BASE > .pvs-pr.list
Para determinar A3 utilizaremos la API de GitHub:
https://api.github.com/repos/${USERNAME}/${REPO}/pulls/${PULL_REQUEST_ID}Hemos utilizado las siguientes variables que proporciona Buddy:
- $BUDDY_EXECUTION_PULL_REQEUST_NO — el número del pull request;
- $BUDDY_REPO_SLUG — la combinación del nombre de usuario y el repositorio (por ejemplo, max/test).
Ahora guardemos los cambios utilizando el botón de abajo, y activemos el análisis del pull request:
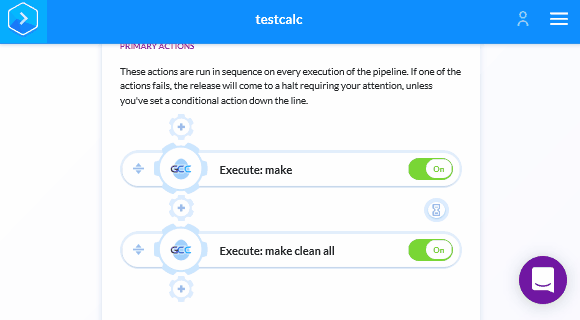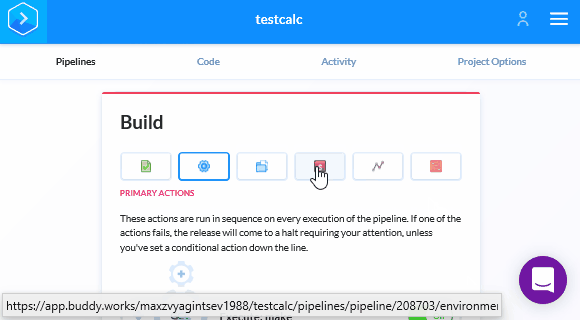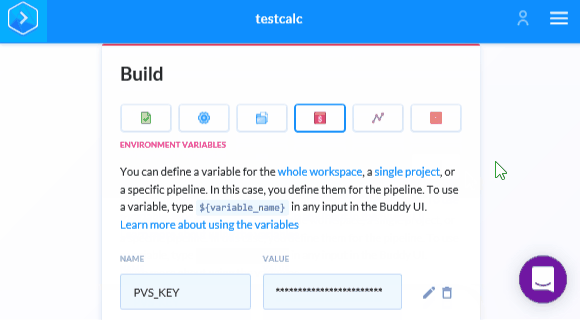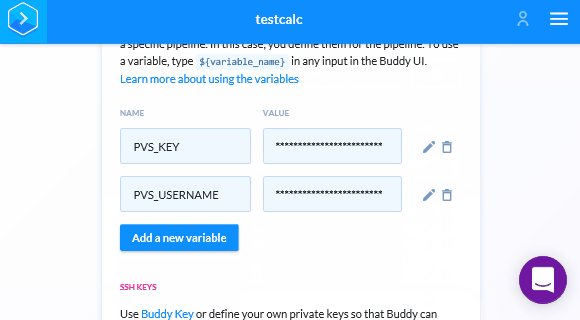
A diferencia de Travis CI, no necesitamos especificar .pvs-studio para la caché, ya que Buddy almacena en caché todos los archivos para ejecuciones posteriores. Así que solo queda lo último: guardar el inicio de sesión y la contraseña para PVS-Studio en Buddy. Después de guardar los cambios, volveremos a Pipeline. Debemos ir a la configuración de variables y agregar el nombre de usuario y la clave para PVS-Studio:
Después de esto, la aparición de un nuevo pull request o commit activará la verificación. Si el commit contiene errores, Buddy lo indicará en la página del pull request.
AppVeyor
La configuración de AppVeyor es similar a Buddy, ya que todo ocurre en la interfaz web y no es necesario agregar un archivo *.yml al repositorio del proyecto.
Vamos a la pestaña Configuración en la vista del proyecto:
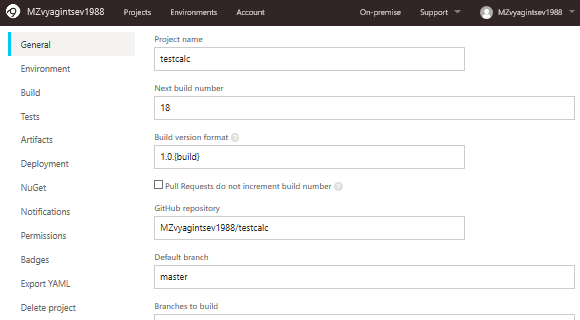
Desplazaremos esta página hacia abajo y activaremos la caché para la construcción de pull requests:
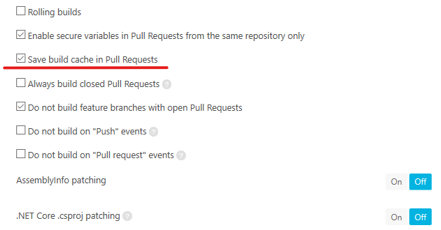
Ahora nos dirigimos a la pestaña Entorno, donde indicaremos la imagen para la construcción y las variables de entorno necesarias:
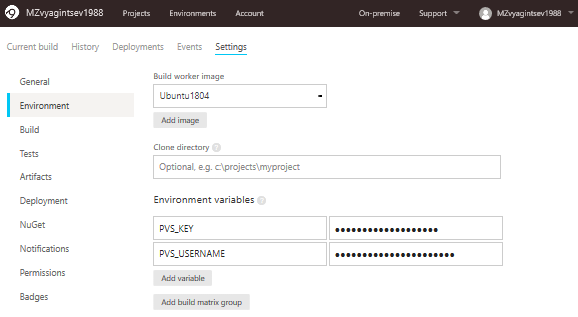
Si has leído las secciones anteriores, ya estás familiarizado con estas dos variables — PVS_KEY y PVS_USERNAME. Si no, te recuerdo que son necesarias para la verificación de la licencia del analizador PVS-Studio. Más adelante nos encontraremos con ellas de nuevo en scripts Bash.
En esta misma página, al final, indicaremos la carpeta para la caché:
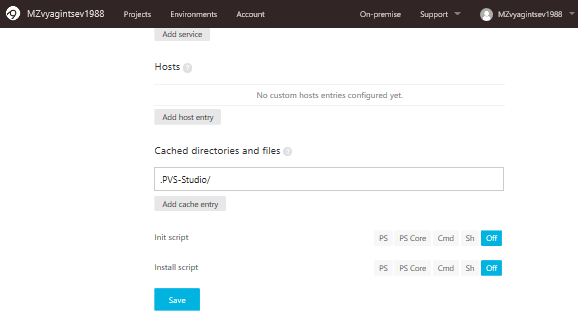
Si no lo hacemos, analizaremos en lugar de un par de archivos todo el proyecto, pero la salida se obtendrá de los archivos especificados. Por lo tanto, es importante ingresar el nombre correcto del directorio.
Ahora ha llegado el momento del script de verificación. Abramos la pestaña Pruebas y seleccionemos Script:
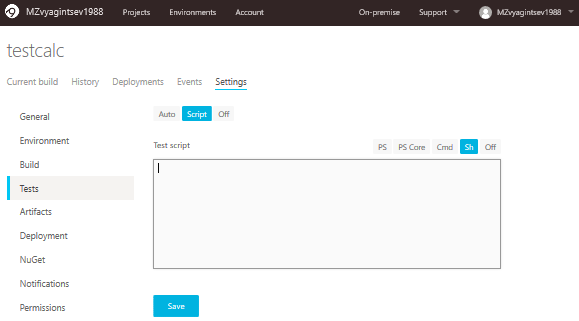
En este formulario debe insertar el siguiente código:
sudo apt-get update && sudo apt-get -y install jq

wget -q -O - https://files.viva64.com/etc/pubkey.txt
  | sudo apt-key add -
sudo wget -O /etc/apt/sources.list.d/viva64.list
  https://files.viva64.com/etc/viva64.list

sudo apt-get update && sudo apt-get -y install pvs-studio

pvs-studio-analyzer credentials $PVS_USERNAME $PVS_KEY

PWD=$(pwd -L)
if [ "$APPVEYOR_PULL_REQUEST_NUMBER" != '' ]; then
  PULL_REQUEST_ID="pulls/$APPVEYOR_PULL_REQUEST_NUMBER"
  MERGE_BASE=`wget -qO -
    https://api.github.com/repos/${APPVEYOR_REPO_NAME}/${PULL_REQUEST_ID}
    | jq -r ".base.ref"`

  git diff --name-only HEAD origin/$MERGE_BASE > .pvs-pr.list
  pvs-studio-analyzer analyze -j8
                              -o PVS-Studio.log
                              --disableLicenseExpirationCheck
                              --dump-files --dump-log pvs-dump.log
                              -S .pvs-pr.list
else
  pvs-studio-analyzer analyze -j8
                              -o PVS-Studio.log
                              --disableLicenseExpirationCheck
fi

plog-converter -t errorfile PVS-Studio.log --cerr -w
Presten atención a la siguiente parte del código:
PWD=$(pwd -L)
if [ "$APPVEYOR_PULL_REQUEST_NUMBER" != '' ]; then
  PULL_REQUEST_ID="pulls/$APPVEYOR_PULL_REQUEST_NUMBER"
  MERGE_BASE=`wget -qO -
   https://api.github.com/repos/${APPVEYOR_REPO_NAME}/${PULL_REQUEST_ID}
   | jq -r ".base.ref"`

  git diff --name-only HEAD origin/$MERGE_BASE > .pvs-pr.list
  pvs-studio-analyzer analyze -j8
                              -o PVS-Studio.log
                              --disableLicenseExpirationCheck
                              --dump-files --dump-log pvs-dump.log
                              -S .pvs-pr.list
else
  pvs-studio-analyzer analyze -j8
                              -o PVS-Studio.log
                              --disableLicenseExpirationCheck
fi
Aunque a primera vista, asignar el valor del comando pwd a una variable que debería almacenarlo por defecto parece extraño, ahora lo explicaré.
Durante la configuración del analizador en AppVeyor, me encontré con un comportamiento bastante extraño del analizador. Por un lado, todo funcionaba correctamente, pero el análisis no se iniciaba. Pasé bastante tiempo dándome cuenta de que estábamos en el directorio /home/appveyor/projects/testcalc/, mientras que el analizador estaba convencido de que estábamos en /opt/appveyor/build-agent/. Entonces comprendí que la variable $PWD estaba mintiendo un poco. Por esta razón, la actualicé manualmente antes de iniciar el análisis.
Y luego todo es como antes:
Ahora consideremos el siguiente fragmento:
PULL_REQUEST_ID="pulls/$APPVEYOR_PULL_REQUEST_NUMBER"
MERGE_BASE=`wget -qO -
  https://api.github.com/repos/${APPVEYOR_REPO_NAME}/${PULL_REQUEST_ID}
  | jq -r ".base.ref"`
En él, obtenemos la diferencia entre las ramas sobre las cuales se ha declarado el pull request. Para esto, necesitamos las siguientes variables de entorno:
- $APPVEYOR_PULL_REQUEST_NUMBER — número del pull request;
- $APPVEYOR_REPO_NAME — nombre de usuario y repositorio del proyecto.
Conclusión
Por supuesto, no hemos revisado todos los servicios de integración continua, sin embargo, todos ellos tienen especificidades de funcionamiento muy similares entre sí. A excepción del almacenamiento en caché, cada servicio hace su "bicicleta", así que siempre es diferente.
En algunos, como en Travis-CI, un par de líneas de código hacen que el almacenamiento en caché funcione sin problemas; en otros, como en AppVeyor, solo hay que indicar la carpeta en la configuración; pero en otros, hay que crear claves únicas y tratar de convencer al sistema de que te permita sobrescribir el fragmento almacenado en caché. Por lo tanto, si deseas configurar el análisis de los pull requests en un servicio de integración continua que no se ha mencionado arriba, asegúrate primero de que no tendrás problemas con el almacenamiento en caché.
Gracias por tu atención. Si algo no funciona, no dudes en escribirnos a . Te ayudaremos y asesoraremos.
Si desea compartir este artículo con una audiencia de habla inglesa, le pido que utilice el enlace a la traducción: Maxim Zvyagintsev. .
Fuente: habr.com
