

Pavel Selivanov, arquitecto de soluciones de Southbridge y docente de Slyurm, presentó una charla en DevOpsConf 2019. Esta charla es parte de uno de los temas del curso avanzado sobre Kubernetes "Slyurm Mega".
se llevará a cabo en Moscú del 18 al 20 de noviembre.
— Moscú, del 22 al 24 de noviembre.
están disponibles siempre.
Debajo de la línea — transcripción de la charla.
Buenos días, colegas y simpatizantes. Hoy hablaré sobre seguridad.
Veo que hay muchos especialistas en seguridad en la sala hoy. Me disculpo de antemano si utilizo términos del mundo de la seguridad de una manera que no es estándar para ustedes.
Sucedió que hace aproximadamente seis meses me encontré con un clúster público de Kubernetes. Público significa que hay una cantidad n de namespaces, en estos namespaces hay usuarios, aislados en su propio namespace. Todos estos usuarios pertenecen a diferentes empresas. Se suponía que este clúster debía utilizarse como CDN. Es decir, se te proporciona un clúster, se te asigna un usuario, tú entras en tu namespace y despliegas tus frontales.
A mi empresa anterior intentaron venderle un servicio así. Y me pidieron que probara el clúster para ver si tal solución era adecuada o no.
Entré en este clúster. Me dieron permisos limitados, un namespace restringido. Allí los chicos entendían qué era la seguridad. Habían leído sobre el control de acceso basado en roles (RBAC) de Kubernetes, y lo configuraron de tal manera que no podía lanzar pods por separado de los deployments. No recuerdo qué tarea estaba intentando resolver al lanzar un pod sin un deployment, pero realmente quería lanzar simplemente un pod. Decidí ver por suerte qué permisos tenía en el clúster, qué podía hacer, qué no podía hacer, qué habían configurado allí. También comentaré lo que tenían mal configurado en RBAC.
Sucedió que en dos minutos obtuve acceso de administrador a su clúster, miré en todos los namespaces vecinos y vi allí frontales de producción de empresas que ya habían adquirido el servicio y se habían desplegado. Me costó mucho detenerme para no entrar en el frontal de alguien y no colocar una palabra obscena en la página principal.
Voy a contar con ejemplos cómo lo hice y cómo se debe proteger de esto.
Pero primero déjenme presentarme. Mi nombre es Pavel Selivanov. Soy arquitecto en la empresa Southbridge. Entiendo de Kubernetes, DevOps y todo tipo de tendencias. Junto a los ingenieros de Southbridge, construimos todo esto, mientras que yo ofrezco consultoría.
Además de nuestras actividades principales, recientemente lanzamos proyectos llamados Slërmy. Intentamos llevar nuestra habilidad en el trabajo con Kubernetes a las masas, enseñando a otros a trabajar también con K8s.
Sobre lo que hablaré hoy. El tema de la presentación es evidente: la seguridad de un clúster de Kubernetes. Pero quiero aclarar desde el principio que este es un tema muy amplio y, por lo tanto, debo especificar lo que no abordaré. No hablaré de términos ya manidos que han sido tratados en Internet muchas veces, como RBAC y certificados.
Voy a hablar sobre lo que a mí y a mis colegas nos preocupa respecto a la seguridad en un clúster de Kubernetes. Vemos estos problemas tanto en los proveedores que ofrecen clústeres de Kubernetes como en los clientes que vienen a nosotros. E incluso en clientes que llegan a nosotros de otras empresas de consultoría administrativa. Así que, en realidad, la magnitud de la tragedia es bastante grande.
Literalmente tres puntos que abordaré hoy:
- Derechos de los usuarios vs derechos de los pods. Los derechos de los usuarios y los derechos de los pods no son lo mismo.
- Recopilación de información sobre el clúster. Mostraré cómo se puede recopilar toda la información del clúster que sea necesaria sin tener derechos especiales en este clúster.
- Ataque DoS al clúster. Si no podemos recopilar información, aún así podemos colapsar el clúster. Hablaré sobre ataques DoS a los componentes de control del clúster.
Otra cosa general que mencionaré es sobre qué he estado realizando todas estas pruebas, y de lo que puedo afirmar que funciona.
Tomamos como base la instalación de un clúster de Kubernetes usando Kubespray. Si alguien no lo sabe, es, de hecho, un conjunto de roles para Ansible. Lo utilizamos constantemente en nuestro trabajo. Es bueno porque se puede implementar en cualquier lugar: en hardware local o en la nube. Un método de instalación es adecuado en principio para todo.
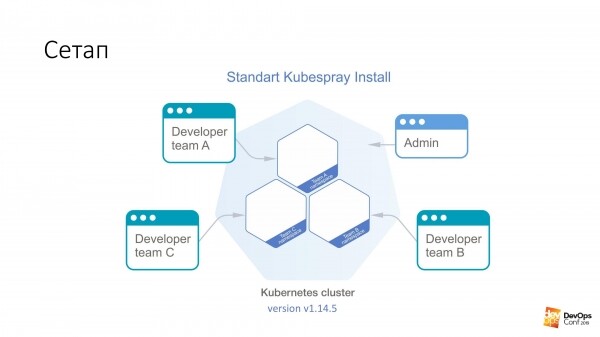
En este clúster tendré Kubernetes v1.14.5. Todo el clúster de Kube que vamos a considerar está dividido en namespaces, cada namespace pertenece a un equipo distinto y solo los miembros de ese equipo tienen acceso a su namespace. No pueden acceder a otros namespaces, solo al suyo. Pero hay una cuenta de administrador que tiene derechos sobre todo el clúster.
Prometí que lo primero que haríamos sería obtener derechos de administrador en el clúster. Necesitamos un pod específicamente preparado que romperá el clúster de Kubernetes. Todo lo que necesitamos hacer es aplicarlo en el clúster de Kubernetes.
kubectl apply -f pod.yamlEste pod llegará a uno de los masters del clúster de Kubernetes. Y después de esto, el clúster felizmente nos devolverá un archivo llamado admin.conf. En Kube, este archivo almacena todos los certificados del administrador y además configura la API del clúster. Así de fácil se puede obtener acceso de administrador, creo que en el 98% de los clústeres de Kubernetes.
Reitero, este pod fue creado por un desarrollador en su clúster, que tiene acceso para desplegar sus propuestas en un pequeño namespace, y está totalmente restringido por RBAC. No tenía ningún permiso. Sin embargo, el certificado fue devuelto.
Ahora hablemos del pod especialmente preparado. Lo ejecutamos en cualquier imagen. Para este ejemplo, tomaremos debian:jessie.
Tenemos algo así:
tolerations:
-   effect: NoSchedule
    operator: Exists
nodeSelector:
    node-role.kubernetes.io/master: ""
¿Qué es una tolerancia? Los masters en el clúster de Kubernetes generalmente están marcados con algo que se llama taint ("contaminación" en inglés). Y la esencia de esta "contaminación" es que no se pueden asignar pods a los nodos master. Pero nadie impide que se indique en cualquier pod que es tolerante a esta "contaminación". La sección Toleration dice que si en algún nodo hay NoSchedule, nuestro pod es tolerante a esta contaminación — y no habrá problema.
Luego, decimos que nuestro pod no solo es tolerante, sino que también quiere ser asignado específicamente a un master. Porque en los masters se encuentra lo más valioso que necesitamos: todos los certificados. Por lo tanto, indicamos nodeSelector — y tenemos una etiqueta estándar en los masters que permite seleccionar entre todos los nodos del clúster aquellos que son masters.
Con esas dos secciones, el pod definitivamente llegará al master. Y se le permitirá residir allí.
Pero simplemente llegar al master no es suficiente. Eso no nos dará nada. Por lo tanto, a continuación tenemos estas dos cosas:
hostNetwork: true
hostPID: true
Indicamos que nuestro pod, que vamos a ejecutar, vivirá en el espacio de nombres del núcleo, en el espacio de nombres de la red y en el espacio de nombres de PID. Una vez que el pod se inicie en el maestro, podrá ver todas las interfaces reales y activas de este nodo, escuchar todo el tráfico y ver el PID de todos los procesos.
Luego, solo queda poco. Toma etcd y lee lo que quieras.
Lo más interesante es esta capacidad de Kubernetes, que está presente por defecto.
volumeMounts:
- mountPath: /host
  name: host
volumes:
- hostPath:
    path: /
    type: Directory
  name: host
Y la esencia de esto es que podemos en el pod que estamos ejecutando, incluso sin tener derechos en este clúster, decir que queremos crear un volumen de tipo hostPath. Es decir, tomar la ruta del host en el que vamos a ejecutarnos y usarla como volumen. Luego lo llamamos name: host. Montamos todo este hostPath dentro del pod. En este ejemplo, en el directorio /host.
Reitero. Hemos dicho al pod que venga al maestro, obtenga hostNetwork y hostPID, y monte todo el root del maestro dentro de este pod.
Entiendes que en Debian tenemos bash en ejecución, y este bash trabaja bajo root. Es decir, acabamos de obtener acceso root en el maestro, sin tener algún tipo de derechos en el clúster de Kubernetes.
Luego, la tarea es entrar en el pod en el directorio /host /etc/kubernetes/pki, si no me equivoco, y recoger todos los certificados maestros del clúster y, por lo tanto, convertirnos en administradores del clúster.
Si lo miramos así, estos son algunos de los permisos más peligrosos en los pods, a pesar de los derechos que tenga el usuario:
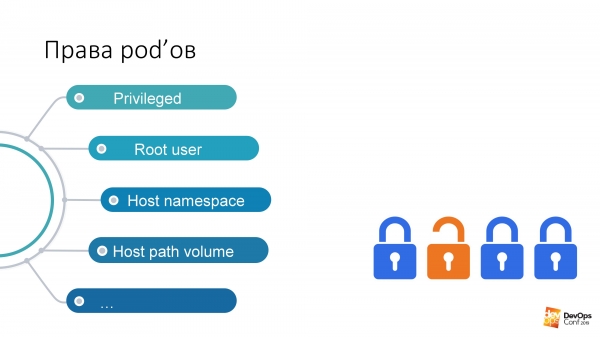
Si tengo permiso para ejecutar un pod en algún espacio de nombres del clúster, entonces el pod tiene esos permisos por defecto. Puedo ejecutar pods privilegiados, y eso es prácticamente tener acceso root en el nodo.
Mi favorito es el usuario root. Y Kubernetes tiene una opción llamada Run As Non-Root. Es una especie de protección contra hackers. ¿Saben qué es el 'virus moldavo'? Si eres un hacker y llegas a mi clúster de Kubernetes, nosotros, los pobres administradores, pedimos: 'Por favor, especifiquen en sus pods, que usarán para hackear mi clúster, run as non-root. De lo contrario, podrías iniciar un proceso en tu pod como root y sería muy fácil hackearme. Protégete, por favor, a ti mismo'.
El volumen de ruta del host, en mi opinión, es la forma más rápida de obtener el resultado deseado del clúster de Kubernetes.
¿Pero qué hacer con todo esto?
Pensamientos que deberían venir a cualquier administrador normal que se enfrenta a Kubernetes: "Ah, ya lo dije, Kubernetes no funciona. Tiene fallos. Y todo Kubernetes es una tontería". En realidad, hay algo llamado documentación, y si se mira, hay una sección .
Es un objeto yaml que podemos crear en el clúster de Kubernetes, que controla los aspectos de seguridad específicamente en la descripción de los pods. Es decir, de hecho, controla los derechos para utilizar diversos hostNetwork, hostPID y ciertos tipos de volúmenes que existen en los pods al iniciar. Con la Política de Seguridad de Pods todo esto se puede describir.
Lo más interesante de la Política de Seguridad de Pods es que en el clúster de Kubernetes, la PSP no está simplemente descrita en ninguna parte, está desactivada por defecto. La Política de Seguridad de Pods se activa a través de un plugin de admisión.
Bien, desplegaremos la Política de Seguridad de Pods en el clúster, digamos que tenemos ciertos pods de servicio en un namespace al que solo tienen acceso los administradores. Digamos que en todos los demás, los pods tienen derechos limitados. Porque probablemente los desarrolladores no necesitan ejecutar pods privilegiados en su clúster.
Y parece que todo va bien. Y nuestro clúster de Kubernetes no puede ser hackeado en dos minutos.
Hay un problema. Lo más probable es que si tienes un clúster de Kubernetes, tienes algún tipo de monitoreo instalado. Me atrevo a predecir que si hay un monitoreo en tu clúster, se llama Prometheus.
Lo que voy a contar ahora será válido tanto para el operador de Prometheus como para Prometheus instalado en su forma pura. La cuestión es que si no puedo conseguir un administrador rápidamente en el clúster, significa que necesito buscar más. Y puedo buscar usando tu monitoreo.
Probablemente todos han leído los mismos artículos en Habr, y el monitoreo se encuentra en el namespace monitoring. El gráfico de Helm de todos se llama aproximadamente igual. Supongo que si haces helm install stable/prometheus, tendrás nombres aproximadamente iguales. Y es muy probable que no tenga que adivinar el nombre DNS en tu clúster. Porque es estándar.
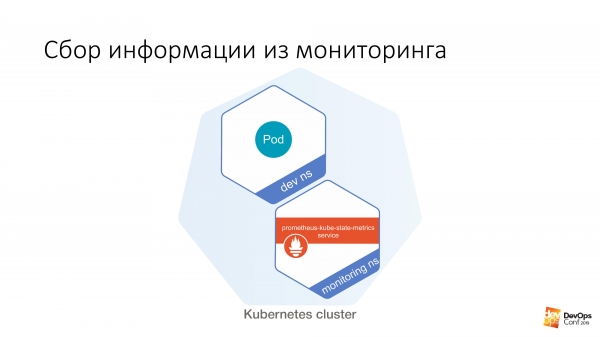
Luego tenemos algún namespace dev, en el que se puede lanzar un pod. Y desde ese pod es muy fácil hacer lo siguiente:
$ curl http://prometheus-kube-state-metrics.monitoring prometheus-kube-state-metrics es un exportador de Prometheus que recopila métricas de la API de Kubernetes. Hay mucha información sobre lo que está ejecutándose en su clúster, qué es y qué problemas puede tener.
Como un ejemplo sencillo:
kube_pod_container_info{namespace="kube-system",pod="kube-apiserver-k8s-1",container="kube-apiserver",image=
"gcr.io/google-containers/kube-apiserver:v1.14.5"
,image_id="docker-pullable://gcr.io/google-containers/kube-apiserver@sha256:e29561119a52adad9edc72bfe0e7fcab308501313b09bf99df4a9638ee634989",container_id="docker://7cbe7b1fea33f811fdd8f7e0e079191110268f2853397d7daf08e72c22d3cf8b"} 1
Al realizar una simple solicitud curl desde un pod no privilegiado, se puede obtener esta información. Si no sabes en qué versión de Kubernetes estás ejecutando, él te lo dirá fácilmente.
Y lo más interesante es que, además de consultar kube-state-metrics, puedes consultar Prometheus directamente con el mismo éxito. Puedes recopilar métricas de allí. Incluso puedes construir métricas desde allí. Teóricamente, podrías hacer una consulta desde el clúster a Prometheus que simplemente lo apague. Y tu monitoreo dejaría de funcionar completamente.
Y aquí surge la pregunta: ¿monitorea algún monitoreo externo tu monitoreo? Acabo de obtener la capacidad de actuar en el clúster de Kubernetes sin ninguna consecuencia para mí. Ni siquiera te darás cuenta de que estoy actuando allí, ya que no hay monitoreo.
De la misma manera que con PSP, da la sensación de que el problema es que todas estas tecnologías de moda — Kubernetes, Prometheus — simplemente no funcionan y están llenas de fallas. En realidad, no es así.
Hay algo llamado — .
Si eres un administrador normal, probablemente sepas que la Política de Red es otro yaml más, de los que hay muchísimos en el clúster. Y algunas Políticas de Red definitivamente no son necesarias. Y aunque hayas leído qué es una Política de Red, que es un cortafuegos yaml de Kubernetes que permite limitar los permisos de acceso entre espacios de nombres y entre pods, definitivamente decidirías que un cortafuegos en formato yaml en Kubernetes es solo otra abstracción... No, no. Esto definitivamente no es necesario.
Incluso si sus especialistas en seguridad no les han dicho que se puede construir un firewall muy granular de manera muy fácil y sencilla con su Kubernetes. Si aún no lo saben y no les están diciendo: «Bueno, denme, denme...». De todos modos, necesita la Network Policy para restringir el acceso a ciertos lugares de servicio, que se pueden consultar desde su clúster sin ningún tipo de autorización.
Como en el ejemplo que mencioné, se puede consultar kube state metrics desde cualquier namespace en el clúster de Kubernetes sin tener derechos para ello. Las políticas de red cerraron el acceso desde todos los demás namespaces al namespace de monitoreo y así es todo: sin acceso, sin problemas. En todos los charts que están, tanto en el Prometheus estándar como en aquel que está en el operador, simplemente hay una opción en los values del helm para activar las políticas de red para ellos. Solo es necesario activarlas y funcionarán.
Sin embargo, hay un problema aquí. Siendo un buen administrador con barba, probablemente decidió que las políticas de red no son necesarias. Y tras leer varios artículos en recursos como Habr, decidió que flannel, especialmente en modo host-gateway, es lo mejor que puede elegir.
¿Qué hacer?
Puede intentar redeplegar la solución de red que tiene en su clúster de Kubernetes, intentar reemplazarla por algo más funcional. Por ejemplo, Calico. Pero quiero decir de inmediato que cambiar la solución de red en un clúster de Kubernetes en producción es una tarea bastante no trivial. Yo lo he hecho dos veces (ambas veces, sin embargo, de manera teórica), pero incluso en Slurm mostramos cómo hacerlo. A nuestros estudiantes les mostramos cómo cambiar la solución de red en el clúster de Kubernetes. En principio, puede intentar hacerlo de tal manera que en el clúster de producción no haya tiempo de inactividad. Pero probablemente no tendrá éxito.
Y el problema, en realidad, se resuelve de manera muy simple. En el clúster hay certificados, y usted sabe que los certificados se caducarán en un año. Bueno, y generalmente la solución normal con certificados en el clúster es: ¿por qué molestarnos?, levantaremos un nuevo clúster al lado, dejaremos que el antiguo se caduque, y lo reaplicaremos todo. Es cierto que, cuando se caduque, estaremos un día sin nada, pero al menos tendremos un nuevo clúster.
Cuando levante el nuevo clúster, también inserte Calico en lugar de flannel.
¿Qué hacer si tiene certificados emitidos por cien años y no tiene planes de redeplegar el clúster? Hay una herramienta llamada Kube-RBAC-Proxy. Es un desarrollo excelente que permite integrarse como un contenedor sidecar a cualquier pod en el clúster de Kubernetes. Y, de hecho, agrega autorización a ese pod a través del RBAC de Kubernetes.
Sin embargo, hay un problema. Antes, la solución Kube-RBAC-Proxy estaba integrada en el operador de Prometheus. Pero luego desapareció. Actualmente, las versiones modernas se basan en que tenga políticas de red y las use para cerrarlas. Por lo tanto, será necesario reescribir un poco el chart. De hecho, si accede a , hay ejemplos de cómo utilizarlo como sidecars, y los charts tendrán que ser reescritos de forma mínima.
Hay otro pequeño problema. No solo Prometheus entrega sus métricas a cualquiera. Todos los componentes del clúster de Kubernetes también pueden emitir sus propias métricas.
Pero como ya mencioné, si no puede acceder al clúster y recopilar información, al menos puede causar algo de daño.
Así que rápidamente mostraré dos formas en las que se puede perjudicar la salud de un clúster de Kubernetes.
Se reirá cuando le cuente esto, son dos casos de la vida real.
Método uno. Agotamiento de recursos.
Iniciamos otro pod especial. Tendrá la siguiente sección.
resources:
    requests:
        cpu: 4
        memory: 4Gi
Como saben, los requests son la cantidad de CPU y memoria que se reserva en el host para los pods específicos con requests. Si tenemos un host de cuatro núcleos en el clúster de Kubernetes, y llega un pod con requests de cuatro por CPU, significa que no podrá llegar ningún otro pod con requests a este host.
Si inicio este pod, luego ejecutaré el comando:
$ kubectl scale special-pod --replicas=...Entonces, nadie más podrá desplegarse en el clúster de Kubernetes. Porque en todos los nodos se agotarán los requests. Y de esta manera detendré su clúster de Kubernetes. Si hago esto por la noche, puedo detener los despliegues por un tiempo bastante largo.
Si volvemos a consultar la documentación de Kubernetes, veremos algo que se llama Limit Range. Establece los recursos para los objetos del clúster. Puede escribir un objeto Limit Range en yaml, aplicarlo a ciertos namespaces y, a partir de ahí, en ese namespace puede decir que tiene recursos predeterminados, máximos y mínimos para los pods.
Con esta herramienta, podemos restringir a los usuarios en ciertos namespaces de producto de las capacidades de especificar en sus pods cualquier cosa no deseada. Pero, desafortunadamente, incluso si le dice al usuario que no puede lanzar pods con solicitudes superiores a un CPU, hay un comando maravilloso llamado scale, o a través del dashboard pueden escalar.
Y de aquí surge la segunda forma. Lanzamos 11 111 111 111 111 pods. Eso son once mil millones. No es porque haya inventado ese número, sino porque lo he visto.
Una historia real. Tarde en la noche, ya estaba preparado para salir de la oficina. Miré y vi a un grupo de desarrolladores en una esquina haciendo algo apresuradamente con sus computadoras portátiles. Me acerqué a ellos y pregunté: "¿Qué les sucedió?"
Un poco antes, alrededor de las nueve de la noche, uno de los desarrolladores se estaba preparando para irse a casa. Y decidió: "Ahora escalaré mi aplicación a uno". Presionó uno, pero internet se ralentizó un poco. Volvió a presionar uno, presionó con fuerza uno, hizo clic en Enter. Tocó todo lo que pudo. En ese momento, internet revivió y todo comenzó a escalar hasta ese número.
De hecho, esta historia no ocurrió en Kubernetes, en ese momento era Nomad. Terminó con que después de una hora de intentos de detener a Nomad de sus tenaces intentos de escalar, Nomad respondió que no dejaría de escalar y no haría nada más. "Estoy cansado, me voy". Y se cerró.
Naturalmente, intenté hacer lo mismo en Kubernetes. Once mil millones de pods no le agradaron, dijo: "No puedo. Supera las limitaciones internas". Pero 1 000 000 000 de pods fue capaz de manejar.
En respuesta a un millón de Pods en sí mismo no se fue. Realmente comenzó a escalar. Cuanto más avanzaba el proceso, más tiempo le llevaba crear nuevos Pods. Pero aún así, el proceso seguía adelante. El único problema es que si puedo lanzar Pods sin limitaciones en mi espacio de nombres, incluso sin solicitudes y límites, puedo lanzar una cantidad de Pods con ciertas tareas que hará que los nodos comiencen a colapsar en memoria y CPU. Cuando inicio tantos Pods, la información de ellos debe llegar al almacenamiento, es decir, etcd. Y cuando llega demasiada información allí, el almacenamiento comienza a dar resultados muy lentamente, y Kubernetes empieza a tener problemas.
Y otro problema... Como saben, los componentes de gestión de Kubernetes no son una sola cosa central, sino varios componentes. En particular, hay un controlador de gestión, un programador, etcétera. Todos estos chicos comenzarán a realizar simultáneamente trabajos inútiles y sin sentido que con el tiempo ocuparán cada vez más y más tiempo. El controlador de gestión creará nuevos Pods. El programador intentará encontrarles un nuevo nodo. Es probable que pronto se acaben los nuevos nodos en tu clúster. El clúster de Kubernetes comenzará a funcionar cada vez más lento.
Pero decidí ir un paso más allá. Como saben, en Kubernetes hay algo que se llama servicio. Bueno, en sus clústeres, por defecto, el servicio probablemente funciona mediante IP tables.
Si lanzas miles de millones de Pods, por ejemplo, y luego con un pequeño script haces que Kubernetes cree nuevos servicios:
for i in {1..1111111}; do
    kubectl expose deployment test --port 80
        --overrides="{"apiVersion": "v1",
           "metadata": {"name": "nginx$i"}}";
done
En todos los nodos del clúster, aproximadamente al mismo tiempo, se generarán continuamente más y más reglas de iptables. Y se generarán mil millones de reglas de iptables por cada servicio.
Verifiqué todo esto con varios miles, hasta decenas. Y el problema es que ya en ese umbral, hacer un ssh en el nodo se vuelve bastante problemático. Porque los paquetes, al pasar por tal cantidad de cadenas, comienzan a no sentirse muy bien.
Y esto también se resuelve con Kubernetes. Hay un objeto llamado Resource quota. Establece la cantidad de recursos y objetos disponibles para el namespace en el clúster. Podemos crear un objeto yaml en cada namespace del clúster de Kubernetes. Con este objeto, podemos decir que hemos asignado una cierta cantidad de requests y limits para este namespace, y luego podemos indicar que en este namespace se pueden crear 10 servicios y 10 pods. Y el desarrollador podría intentar asustarse por las noches. Kubernetes le dirá: "No se puede escalar tus pods a esa cantidad, porque excede la cuota de recursos". Listo, problema resuelto. .
Surge un problema relacionado con esto. Sientes lo difícil que se vuelve crear un namespace en Kubernetes. Para crearlo, necesitamos tomar en cuenta un montón de cosas.
Resource quota + Limit Range + RBAC
• Creamos el namespace
• Creamos dentro el limitrange
• Creamos dentro el resourcequota
• Creamos un serviceaccount para CI
• Creamos un rolebinding para CI y usuarios
• Opcionalmente, lanzamos los pods de servicio necesarios
Por lo tanto, aprovechando la ocasión, me gustaría compartir mis desarrollos. Hay una herramienta llamada operador SDK. Es una manera de escribir operadores para el clúster de Kubernetes. Puedes escribir operadores usando Ansible.
Primero escribimos usando Ansible, y luego vi que existe el operador SDK y reescribí el rol de Ansible como un operador. Este operador permite crear dentro del clúster de Kubernetes un objeto llamado comando. Dentro del comando, permite describir en yaml el entorno para este comando. Y dentro del entorno del comando permite describir cuántos recursos estamos asignando.
Pequeña .
Y en conclusión. ¿Qué hacer con todo esto?
Primero. Pod Security Policy — esto es bueno. Y a pesar de que ninguno de los instaladores de Kubernetes los utiliza hasta ahora, aún así deberías usarlos en tus clústeres.
Network Policy — no es otra característica innecesaria. Es algo realmente necesario en el clúster.
LimitRange/ResourceQuota — ya es hora de usarlos. Hace tiempo que comenzamos a utilizarlos y estaba seguro de que todos los aplicaban. Resultó ser bastante raro.
Además de lo que mencioné durante la presentación, hay características no documentadas que permiten atacar el clúster. Salió recientemente .
Algunas cosas son tan tristes y dolorosas. Como, por ejemplo, en ciertas condiciones, los kubelets en el clúster de Kubernetes pueden entregar el contenido del directorio de warlocks a un usuario no autorizado.
hay instrucciones sobre cómo reproducir todo lo que conté. Allí están los archivos con ejemplos de producción, como se ven ResourceQuota y Pod Security Policy. Y todo esto se puede tocar.
Gracias a todos.
Fuente: habr.com
