

Aleksey Lizunov, director of the competence center for remote service channels in the IT department of MKB
Alternativamente al stack ELK (ElasticSearch, Logstash, Kibana), estamos realizando investigaciones sobre el uso de la base de datos ClickHouse como almacén de datos para logs.
En este artículo nos gustaría contarles sobre nuestra experiencia con la base de datos ClickHouse y los resultados preliminares tras la explotación piloto. Cabe destacar que los resultados han sido impresionantes.
A continuación, describiremos con más detalle cómo hemos configurado el sistema y de qué componentes consta. Pero ahora nos gustaría hablar un poco sobre esta base de datos en general y por qué vale la pena prestarle atención. La base de datos ClickHouse es una base de datos analítica de columnas de alto rendimiento desarrollada por Yandex. Se utiliza en los servicios de Yandex, inicialmente como el principal almacén de datos para Yandex.Metrica. Es un sistema de código abierto, gratuito. Desde la perspectiva de un desarrollador, siempre me ha interesado cómo lo han implementado, dado que manejan datos increíblemente grandes. Y la propia interfaz de usuario de Metrica es muy flexible y funciona rápidamente. En el primer encuentro con esta base de datos, la impresión es: '¡Finalmente! ¡Hecho para las personas! Desde el proceso de instalación hasta el envío de consultas'.
Esta base de datos tiene un umbral de entrada muy bajo. Incluso un desarrollador de nivel medio puede instalar esta base de datos en cuestión de minutos y empezar a utilizarla. Todo funciona perfectamente. Incluso personas que no están familiarizadas con Linux pueden manejar la instalación y realizar operaciones básicas rápidamente. Antes, al escuchar Big Data, Hadoop, Google BigTable, HDFS, los desarrolladores comunes pensaban en terabytes, petabytes, y que la configuración y el desarrollo para estos sistemas eran tarea de superhombres; con la llegada de la base de datos ClickHouse, hemos recibido una herramienta simple y clara, con la cual podemos abordar tareas previamente inalcanzables. Solo se necesita una máquina bastante promedio y cinco minutos para la instalación. Es decir, hemos tenido una base de datos similar a MySql, pero capaz de almacenar miles de millones de registros. Es como si se les hubiera entregado a las personas un arma de alienígenas.
Sobre nuestro sistema de recopilación de logs
Para la recopilación de información se utilizan archivos de registro IIS de aplicaciones web en un formato estándar (actualmente también estamos trabajando en el análisis de registros de aplicaciones, pero el objetivo principal en la fase de pruebas piloto es la recopilación de registros IIS).
No hemos podido renunciar por completo al stack ELK por diversas razones, y seguimos utilizando los componentes LogStash y Filebeat, los cuales han demostrado ser confiables y funcionan de manera bastante predecible.
El esquema general de registro se presenta en la figura a continuación:
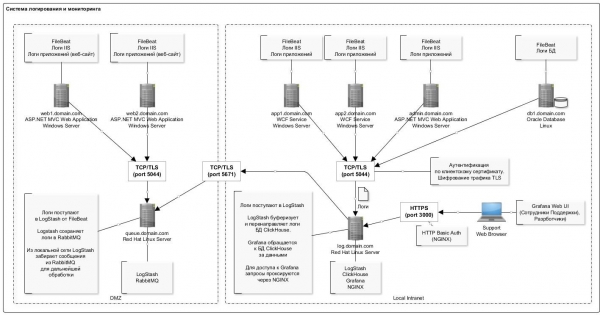
Una característica del registro de datos en la base de datos ClickHouse es la inserción poco frecuente (una vez por segundo) de registros en grandes lotes. Esta, aparentemente, es la parte más 'problemática' con la que uno se encuentra en la primera experiencia trabajando con la base de datos ClickHouse: el esquema se complica un poco.
Aquí ayudó mucho el plug-in para LogStash que inserta datos directamente en ClickHouse. Este componente se despliega en el mismo servidor que la propia base de datos. Generalmente, no se recomienda hacer esto, pero desde un punto de vista práctico, para evitar crear servidores separados mientras esté desplegado en el mismo servidor. No hemos observado fallos ni conflictos de recursos con la base de datos. Además, es importante mencionar que el plug-in cuenta con un mecanismo de reintento en caso de errores. En caso de errores, el plug-in escribe en el disco un lote de datos que no se pudo insertar (el formato del archivo es conveniente: tras la corrección, se puede insertar fácilmente el lote corregido con el clickhouse-client).
La lista completa del software que se utiliza en el esquema se presenta en la tabla:
Lista de software utilizado
Nombre
Descripción
Enlace al distribuidor
NGINX
Proxy inverso para limitar el acceso por puertos y organizar la autorización
Actualmente no se utiliza en el esquema
FileBeat
Transmisión de archivos de registro.
(distribuidor para Windows 64bit).
LogStash
Reunidor de registros.
Se utiliza para recoger registros de FileBeat, así como para recoger registros de la cola RabbitMQ (para servidores que están en DMZ).
Logstash- output- clickhouse
Plug-in Logstash para transmitir registros a la base de datos ClickHouse en lotes
/usr/share/logstash/bin/logstash-plugin install logstash-output-clickhouse
/usr/share/logstash/bin/logstash-plugin install logstash-filter-prune
/usr/share/logstash/bin/logstash-plugin install logstash-filter-multiline
ClickHouse
Almacén de registros
Nota. Desde agosto de 2018, en el repositorio de Yandex aparecieron versiones 'normales' rpm para RHEL, por lo que se pueden probar. En el momento de la instalación, utilizamos paquetes creados por Altinity.
Grafana
Visualización de registros. Configuración de paneles
RedHat & CentOS (64 Bit) - última versión
Origen de datos ClickHouse para Grafana 4.6+
Plug-in para Grafana con origen de datos ClickHouse
LogStash
Enrutador de logs de FileBeat a la cola RabbitMQ.
Nota. Lamentablemente, FileBeat no tiene una salida directa a RabbitMQ, por lo que se requiere un intermediario en forma de Logstash.
RabbitMQ
Cola de mensajes. Este es un búfer de registros de logs en DMZ.
Erlang Runtime (Necesario para RabbitMQ)
Entorno de ejecución Erlang. Requerido para el funcionamiento de RabbitMQ.
La configuración del servidor con la base de datos ClickHouse se presenta en la siguiente tabla:
Nombre
Valor
Nota
Configuración
HDD: 40GB
RAM: 8GB
Procesador: Core 2 2Ghz
Es importante prestar atención a los consejos sobre el uso de la base de datos ClickHouse ()
Software del sistema
OS: Red Hat Enterprise Linux Server (Maipo)
JRE (Java 8)
Como se puede ver, esta es una estación de trabajo normal.
La estructura de la tabla para almacenar los logs es la siguiente:
log_web.sql
CREATE TABLE log_web (
  logdate Date,
  logdatetime DateTime CODEC(Delta, LZ4HC),

  fld_log_file_name LowCardinality( String ),
  fld_server_name LowCardinality( String ),
  fld_app_name LowCardinality( String ),
  fld_app_module LowCardinality( String ),
  fld_website_name LowCardinality( String ),

  serverIP LowCardinality( String ),
  method LowCardinality( String ),
  uriStem String,
  uriQuery String,
  port UInt32,
  username LowCardinality( String ),
  clientIP String,
  clientRealIP String,
  userAgent String,
  referer String,
  response String,
  subresponse String,
  win32response String,
  timetaken UInt64

  , uriQuery__utm_medium String
  , uriQuery__utm_source String
  , uriQuery__utm_campaign String
  , uriQuery__utm_term String
  , uriQuery__utm_content String
  , uriQuery__yclid String
  , uriQuery__region String

) Engine = MergeTree()
PARTITION BY toYYYYMM(logdate)
ORDER BY (fld_app_name, fld_app_module, logdatetime)
SETTINGS index_granularity = 8192;
Usamos valores predeterminados para la partición (por meses) y la granularidad del índice. Todos los campos corresponden prácticamente a los registros de logs de IIS para el registro de solicitudes http. Cabe señalar algunos campos para almacenar las etiquetas utm (se analizan en el momento de la inserción en la tabla desde el campo de la cadena de consulta).
También se han agregado varios campos del sistema a la tabla para almacenar información sobre los sistemas, componentes y servidores. La descripción de estos campos se encuentra a continuación en la tabla. En una sola tabla almacenamos logs de varios sistemas.
Nombre
Descripción
Ejemplo
fld_app_name
Nombre de la aplicación/sistema
Valores permitidos:
- site1.domain.com Sitio externo 1
- site2.domain.com Sitio externo 2
- internal-site1.domain.local Sitio interno 1
site1.domain.com
fld_app_module
Módulo del sistema
Valores permitidos:
- web — Sitio web
- svc — Servicio web del sitio
- intgr — Servicio web de integración
- bo — Admin (BackOffice)
web
fld_website_name
Nombre del sitio en IIS
En un solo servidor pueden desplegarse varios sistemas, o incluso varias instancias de un módulo del sistema.
web-main
fld_server_name
Nombre del servidor
web1.domain.com
fld_log_file_name
Ruta al archivo de log en el servidor
C:\inetpub\logs\LogFiles
W3SVC1u_ex190711.log
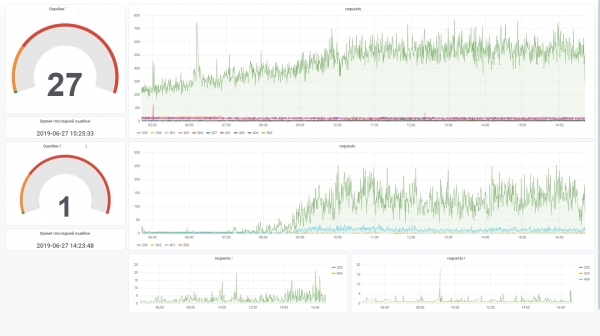
Esto permite construir gráficos de manera efectiva en Grafana. Por ejemplo, visualizar las consultas del frontend de un sistema específico. Esto es similar a un contador de sitio en Yandex.Metrica.
Aquí hay algunas estadísticas sobre el uso de la base de datos en los últimos dos meses.
Número de registros desglosados por sistemas y sus componentes
SELECT
    fld_app_name,
    fld_app_module,
    count(fld_app_name) AS rows_count
FROM log_web
GROUP BY
    fld_app_name,
    fld_app_module
    WITH TOTALS
ORDER BY
    fld_app_name ASC,
    rows_count DESC

┌─fld_app_name─────┬─fld_app_module─┬─rows_count─┐
│ site1.domain.ru  │ web            │     131441 │
│ site2.domain.ru  │ web            │    1751081 │
│ site3.domain.ru  │ web            │  106887543 │
│ site3.domain.ru  │ svc            │   44908603 │
│ site3.domain.ru  │ intgr          │    9813911 │
│ site4.domain.ru  │ web            │     772095 │
│ site5.domain.ru  │ web            │   17037221 │
│ site5.domain.ru  │ intgr          │     838559 │
│ site5.domain.ru  │ bo             │       7404 │
│ site6.domain.ru  │ web            │     595877 │
│ site7.domain.ru  │ web            │   27778858 │
└──────────────────┴────────────────┴────────────┘

Totals:
┌─fld_app_name─┬─fld_app_module─┬─rows_count─┐
│              │                │  210522593 │
└──────────────┴────────────────┴────────────┘

11 rows in set. Elapsed: 4.874 sec. Processed 210.52 million rows, 421.67 MB (43.19 million rows/s., 86.51 MB/s.)
Tamaño de los datos en disco
SELECT
    formatReadableSize(sum(data_uncompressed_bytes)) AS uncompressed,
    formatReadableSize(sum(data_compressed_bytes)) AS compressed,
    sum(rows) AS total_rows
FROM system.parts
WHERE table = 'log_web'

┌─uncompressed─┬─compressed─┬─total_rows─┐
│ 54.50 GiB    │ 4.86 GiB   │  211427094 │
└──────────────┴────────────┴────────────┘

1 rows in set. Elapsed: 0.035 sec.
Tasa de compresión de datos en columnas
SELECCIONAR
    nombre,
    formatReadableSize(data_uncompressed_bytes) COMO descomprimido,
    formatReadableSize(data_compressed_bytes) COMO comprimido,
    data_uncompressed_bytes / data_compressed_bytes COMO ratio_compresion
DE system.columns
DONDE tabla = 'log_web'

┌─nombre────────────────────┬─descomprimido─┬─comprimido─┬─────ratio_compresion────┐
│ logdate                  │ 401.53 MiB     │ 1.80 MiB   │ 223.16665968777315       │
│ logdatetime              │ 803.06 MiB     │ 35.91 MiB  │ 22.363966401202305       │
│ fld_log_file_name        │ 220.66 MiB     │ 2.60 MiB   │ 84.99905736932571        │
│ fld_server_name          │ 201.54 MiB     │ 50.63 MiB  │ 3.980924816977078        │
│ fld_app_name             │ 201.17 MiB     │ 969.17 KiB │ 212.55518183686877       │
│ fld_app_module           │ 201.17 MiB     │ 968.60 KiB │ 212.67805817411906       │
│ fld_website_name         │ 201.54 MiB     │ 1.24 MiB   │ 162.7204926761546        │
│ serverIP                 │ 201.54 MiB     │ 50.25 MiB  │ 4.010824061219731        │
│ method                   │ 201.53 MiB     │ 43.64 MiB  │ 4.617721053304486        │
│ uriStem                  │ 5.13 GiB       │ 832.51 MiB │ 6.311522291936919        │
│ uriQuery                 │ 2.58 GiB       │ 501.06 MiB │ 5.269731450124478        │
│ port                     │ 803.06 MiB     │ 3.98 MiB   │ 201.91673864241824       │
│ username                 │ 318.08 MiB     │ 26.93 MiB  │ 11.812513794583598       │
│ clientIP                 │ 2.35 GiB       │ 82.59 MiB  │ 29.132328640073343       │
│ clientRealIP             │ 2.49 GiB       │ 465.05 MiB │ 5.478382297052563        │
│ userAgent                │ 18.34 GiB      │ 764.08 MiB │ 24.57905114484208        │
│ referer                  │ 14.71 GiB      │ 1.37 GiB   │ 10.736792723669906       │
│ response                 │ 803.06 MiB     │ 83.81 MiB  │ 9.582334090987247        │
│ subresponse              │ 399.87 MiB     │ 1.83 MiB   │ 218.4831068635027        │
│ win32response            │ 407.86 MiB     │ 7.41 MiB   │ 55.050315514606815       │
│ timetaken                │ 1.57 GiB       │ 402.06 MiB │ 3.9947395692010637       │
│ uriQuery__utm_medium     │ 208.17 MiB     │ 12.29 MiB  │ 16.936148912472955       │
│ uriQuery__utm_source     │ 215.18 MiB     │ 13.00 MiB  │ 16.548367623199912       │
│ uriQuery__utm_campaign   │ 381.46 MiB     │ 37.94 MiB  │ 10.055156353418509       │
│ uriQuery__utm_term       │ 231.82 MiB     │ 10.78 MiB  │ 21.502540454070672       │
│ uriQuery__utm_content    │ 441.34 MiB     │ 87.60 MiB  │ 5.038260760449327        │
│ uriQuery__yclid          │ 216.88 MiB     │ 16.58 MiB  │ 13.07721335008116        │
│ uriQuery__region         │ 204.35 MiB     │ 9.49 MiB   │ 21.52661903446796        │
└──────────────────────────┴────────────────┴────────────┴────────────────────────┘

28 filas en conjunto. Tiempo transcurrido: 0.005 seg.
Descripción de los componentes utilizados
FileBeat. Transmisión de registros de archivos
Este componente rastrea los cambios en los archivos de registro en el disco y transmite la información a LogStash. Se instala en todos los servidores donde se escriben archivos de registro (generalmente, IIS). Funciona en modo tail (es decir, solo transmite las entradas añadidas al archivo). Sin embargo, también se puede configurar para transmitir archivos completos. Esto es útil cuando se necesita cargar datos de meses anteriores. Simplemente coloque el archivo de registro en la carpeta y él lo leerá completamente.
Al detener el servicio, los datos dejan de enviarse al almacenamiento.
Un ejemplo de configuración es el siguiente:
filebeat.yml
filebeat.inputs:
- type: log
  enabled: true
  paths:
    - C:/inetpub/logs/LogFiles/W3SVC1/*.log
  exclude_files: ['.gz$', '.zip$']
  tail_files: true
  ignore_older: 24h
  fields:
    fld_server_name: "site1.domain.ru"
    fld_app_name: "site1.domain.ru"
    fld_app_module: "web"
    fld_website_name: "web-main"

- type: log
  enabled: true
  paths:
    - C:/inetpub/logs/LogFiles/__Import/access_log-*
  exclude_files: ['.gz$', '.zip$']
  tail_files: false
  fields:
    fld_server_name: "site2.domain.ru"
    fld_app_name: "site2.domain.ru"
    fld_app_module: "web"
    fld_website_name: "web-main"
    fld_logformat: "logformat__apache"


filebeat.config.modules:
  path: ${path.config}/modules.d/*.yml
  reload.enabled: false
  reload.period: 2s

output.logstash:
  hosts: ["log.domain.com:5044"]

  ssl.enabled: true
  ssl.certificate_authorities: ["C:/filebeat/certs/ca.pem", "C:/filebeat/certs/ca-issuing.pem"]
  ssl.certificate: "C:/filebeat/certs/site1.domain.ru.cer"
  ssl.key: "C:/filebeat/certs/site1.domain.ru.key"

#================================ Procesadores =====================================

processors:
  - add_host_metadata: ~
  - add_cloud_metadata: ~
LogStash. Recolector de registros
Este componente está diseñado para recibir registros de logs de FileBeat (ya sea a través de una cola RabbitMQ), parsear e insertar en lotes en la base de datos ClickHouse.
Para la inserción en ClickHouse se utiliza el plugin Logstash-output-clickhouse. El plugin de Logstash tiene un mecanismo de reintento de solicitudes, pero al detenerse normalmente, es mejor detener el servicio. Al detenerse, los mensajes se acumularán en la cola de RabbitMQ, por lo que si la detención es por un tiempo prolongado, es mejor detener los Filebeats en los servidores. En el esquema donde no se utiliza RabbitMQ (en la red local, Filebeat envía los logs directamente a Logstash), los Filebeats funcionan de manera bastante aceptable y segura, por lo que la indisponibilidad del output pasa sin consecuencias.
Un ejemplo de configuración es el siguiente:
log_web__filebeat_clickhouse.conf
input {

    beats {
        port => 5044
        type => 'iis'
        ssl => true
        ssl_certificate_authorities => ["/etc/logstash/certs/ca.cer", "/etc/logstash/certs/ca-issuing.cer"]
        ssl_certificate => "/etc/logstash/certs/server.cer"
        ssl_key => "/etc/logstash/certs/server-pkcs8.key"
        ssl_verify_mode => "peer"

            add_field => {
                "fld_server_name" => "%{[fields][fld_server_name]}"
                "fld_app_name" => "%{[fields][fld_app_name]}"
                "fld_app_module" => "%{[fields][fld_app_module]}"
                "fld_website_name" => "%{[fields][fld_website_name]}"
                "fld_log_file_name" => "%{source}"
                "fld_logformat" => "%{[fields][fld_logformat]}"
            }
    }

    rabbitmq {
        host => "queue.domain.com"
        port => 5671
        user => "q-reader"
        password => "password"
        queue => "web_log"
        heartbeat => 30
        durable => true
        ssl => true
        #ssl_certificate_path => "/etc/logstash/certs/server.p12"
        #ssl_certificate_password => "password"

        add_field => {
            "fld_server_name" => "%{[fields][fld_server_name]}"
            "fld_app_name" => "%{[fields][fld_app_name]}"
            "fld_app_module" => "%{[fields][fld_app_module]}"
            "fld_website_name" => "%{[fields][fld_website_name]}"
            "fld_log_file_name" => "%{source}"
            "fld_logformat" => "%{[fields][fld_logformat]}"
        }
    }

}

filter {

      if [message] =~ "^#" {
        drop {}
      }

      if [fld_logformat] == "logformat__iis_with_xrealip" {

          grok {
            match => ["message", "%{TIMESTAMP_ISO8601:log_timestamp} %{IP:serverIP} %{WORD:method} %{NOTSPACE:uriStem} %{NOTSPACE:uriQuery} %{NUMBER:port} %{NOTSPACE:username} %{IPORHOST:clientIP} %{NOTSPACE:userAgent} %{NOTSPACE:referer} %{NUMBER:response} %{NUMBER:subresponse} %{NUMBER:win32response} %{NUMBER:timetaken} %{NOTSPACE:xrealIP} %{NOTSPACE:xforwarderfor}"]
          }
      } else {

          grok {
             match => ["message", "%{TIMESTAMP_ISO8601:log_timestamp} %{IP:serverIP} %{WORD:method} %{NOTSPACE:uriStem} %{NOTSPACE:uriQuery} %{NUMBER:port} %{NOTSPACE:username} %{IPORHOST:clientIP} %{NOTSPACE:userAgent} %{NOTSPACE:referer} %{NUMBER:response} %{NUMBER:subresponse} %{NUMBER:win32response} %{NUMBER:timetaken}"]
          }

      }

      date {
        match => [ "log_timestamp", "YYYY-MM-dd HH:mm:ss" ]
          timezone => "Etc/UTC"
        remove_field => [ "log_timestamp", "@timestamp" ]
        target => [ "log_timestamp2" ]
      }

        ruby {
            code => "tstamp = event.get('log_timestamp2').to_i
                        event.set('logdatetime', Time.at(tstamp).strftime('%Y-%m-%d %H:%M:%S'))
                        event.set('logdate', Time.at(tstamp).strftime('%Y-%m-%d'))"
        }

      if [bytesSent] {
        ruby {
          code => "event['kilobytesSent'] = event['bytesSent'].to_i / 1024.0"
        }
      }


      if [bytesReceived] {
        ruby {
          code => "event['kilobytesReceived'] = event['bytesReceived'].to_i / 1024.0"
        }
      }


        ruby {
            code => "event.set('clientRealIP', event.get('clientIP'))"
        }
        if [xrealIP] {
            ruby {
                code => "event.set('clientRealIP', event.get('xrealIP'))"
            }
        }
        if [xforwarderfor] {
            ruby {
                code => "event.set('clientRealIP', event.get('xforwarderfor'))"
            }
        }

      mutate {
        convert => ["bytesSent", "integer"]
        convert => ["bytesReceived", "integer"]
        convert => ["timetaken", "integer"]
        convert => ["port", "integer"]

        add_field => {
            "clientHostname" => "%{clientIP}"
        }
      }

        useragent {
            source => "useragent"
            prefix => "browser"
        }

        kv {
            source => "uriQuery"
            prefix => "uriQuery__"
            allow_duplicate_values => false
            field_split => "&"
            include_keys => [ "utm_medium", "utm_source", "utm_campaign", "utm_term", "utm_content", "yclid", "region" ]
        }

        mutate {
            join => { "uriQuery__utm_source" => "," }
            join => { "uriQuery__utm_medium" => "," }
            join => { "uriQuery__utm_campaign" => "," }
            join => { "uriQuery__utm_term" => "," }
            join => { "uriQuery__utm_content" => "," }
            join => { "uriQuery__yclid" => "," }
            join => { "uriQuery__region" => "," }
        }

}

output {
  #stdout {codec => rubydebug}
    clickhouse {
      headers => ["Authorization", "Basic abcdsfks..."]
      http_hosts => ["http://127.0.0.1:8123"]
      save_dir => "/etc/logstash/tmp"
      table => "log_web"
      request_tolerance => 1
      flush_size => 10000
      idle_flush_time => 1
        mutations => {
            "fld_log_file_name" => "fld_log_file_name"
            "fld_server_name" => "fld_server_name"
            "fld_app_name" => "fld_app_name"
            "fld_app_module" => "fld_app_module"
            "fld_website_name" => "fld_website_name"

            "logdatetime" => "logdatetime"
            "logdate" => "logdate"
            "serverIP" => "serverIP"
            "method" => "method"
            "uriStem" => "uriStem"
            "uriQuery" => "uriQuery"
            "port" => "port"
            "username" => "username"
            "clientIP" => "clientIP"
            "clientRealIP" => "clientRealIP"
            "userAgent" => "userAgent"
            "referer" => "referer"
            "response" => "response"
            "subresponse" => "subresponse"
            "win32response" => "win32response"
            "timetaken" => "timetaken"

            "uriQuery__utm_medium" => "uriQuery__utm_medium"
            "uriQuery__utm_source" => "uriQuery__utm_source"
            "uriQuery__utm_campaign" => "uriQuery__utm_campaign"
            "uriQuery__utm_term" => "uriQuery__utm_term"
            "uriQuery__utm_content" => "uriQuery__utm_content"
            "uriQuery__yclid" => "uriQuery__yclid"
            "uriQuery__region" => "uriQuery__region"
        }
    }

}
pipelines.yml
# This file is where you define your pipelines. You can define multiple.
# For more information on multiple pipelines, see the documentation:
#   https://www.elastic.co/guide/en/logstash/current/multiple-pipelines.html

- pipeline.id: log_web__filebeat_clickhouse
  path.config: "/etc/logstash/log_web__filebeat_clickhouse.conf"
ClickHouse. Almacenamiento de registros
Los registros de todos los sistemas se almacenan en una sola tabla (ver al principio del artículo). Está destinada a almacenar información sobre las solicitudes: todos los parámetros son similares para diferentes formatos, como los registros de IIS, los registros de Apache y Nginx. Para los registros de aplicaciones, en los que se registran, por ejemplo, errores, mensajes informativos y advertencias, habrá una tabla separada con la estructura correspondiente (actualmente en fase de diseño).
Al diseñar la tabla, es muy importante definir la clave primaria (por la cual se ordenarán los datos al almacenarlos). De esto depende el grado de compresión de los datos y la velocidad de las consultas. En nuestro ejemplo, la clave es
ORDER BY (fld_app_name, fld_app_module, logdatetime)
Es decir, por el nombre del sistema, el nombre del componente del sistema y la fecha del evento. Inicialmente, la fecha del evento estaba en primer lugar. Después de moverla al último lugar, las consultas comenzaron a funcionar aproximadamente el doble de rápido. Cambiar la clave primaria requerirá recrear la tabla y recargar los datos para que ClickHouse vuelva a ordenar los datos en el disco. Esta es una operación pesada, por lo que es recomendable planificar con anticipación qué debe incluirse en la clave de ordenación.
También es necesario mencionar que en las versiones más recientes ha aparecido el tipo de datos LowCardinality. Al utilizarlo, se reduce drásticamente el tamaño de los datos comprimidos para aquellos campos que tienen baja cardinalidad (pocas opciones).
Actualmente se utiliza la versión 19.6, y planeamos intentar actualizar a la última versión. En ellas han aparecido funciones tan maravillosas como Adaptive Granularity, Skipping indices y el códec DoubleDelta, por ejemplo.
Por defecto, al instalarse, se establece el nivel de registro en trace. Los registros se rotan y archivan, pero se expanden hasta un gigabyte. Si no es necesario, se puede establecer el nivel en warning, lo que reduce drásticamente el tamaño del registro. La configuración del registro se establece en el archivo config.xml:
<!-- Posibles niveles: https://github.com/pocoproject/poco/blob/develop/Foundation/include/Poco/Logger.h#L105 -->
<level>warning<\/level>
Algunos comandos útiles
Dado que los paquetes de instalación originales se compilan a partir de Debian, para otras versiones de Linux es necesario usar paquetes compilados por Altinity.

Aquí hay un enlace con instrucciones y vínculos a su repositorio: https://www.altinity.com/blog/2017/12/18/logstash-with-clickhouse
sudo yum search clickhouse-server
sudo yum install clickhouse-server.noarch

1. verificación del estado
sudo systemctl status clickhouse-server

2. detener el servidor
sudo systemctl stop clickhouse-server

3. iniciar el servidor
sudo systemctl start clickhouse-server

Ejecutar consultas en modo de múltiples líneas (ejecución después del signo ";")
clickhouse-client --multiline
clickhouse-client --multiline --host 127.0.0.1 --password pa55w0rd
clickhouse-client --multiline --host 127.0.0.1 --port 9440 --secure --user default --password pa55w0rd

El plugin ClickHouse para Logstash, en caso de error en una línea, guarda todo el lote en el archivo /tmp/log_web_failed.json
Se puede corregir manualmente este archivo y tratar de cargarlo en la base de datos manualmente:
clickhouse-client --host 127.0.0.1 --password password --query="INSERT INTO log_web FORMAT JSONEachRow" < /tmp/log_web_failed__fixed.json

sudo mv /etc/logstash/tmp/log_web_failed.json /etc/logstash/tmp/log_web_failed__fixed.json
sudo chown user_dev /etc/logstash/tmp/log_web_failed__fixed.json
sudo clickhouse-client --host 127.0.0.1 --password password --query="INSERT INTO log_web FORMAT JSONEachRow" < /etc/logstash/tmp/log_web_failed__fixed.json
sudo mv /etc/logstash/tmp/log_web_failed__fixed.json /etc/logstash/tmp/log_web_failed__fixed_.json

salir de la línea de comandos
quit;
## Configuración de TLS
https://www.altinity.com/blog/2019/3/5/clickhouse-networking-part-2

openssl s_client -connect log.domain.com:9440 < /dev/null
LogStash. Enrutador de logs desde FileBeat a la cola RabbitMQ
Este componente se utiliza para enrutar los logs que llegan desde FileBeat a la cola RabbitMQ. Aquí hay dos puntos:
- Desafortunadamente, FileBeat no tiene un plugin de salida para escribir directamente en RabbitMQ. Y tal funcionalidad, según los problemas en su GitHub, no está planeada para su implementación. Hay un plugin para Kafka, pero por razones específicas no podemos usarlo.
- Existen requisitos para la recolección de logs en la DMZ. Según ellos, los logs deben acumularse primero en la cola y luego LogStash lee los registros desde fuera de la cola.
Por lo tanto, en el caso de ubicar servidores en la DMZ, es necesario utilizar un esquema algo más complicado. Un ejemplo de configuración es el siguiente:
iis_w3c_logs__filebeat_rabbitmq.conf
entrada {

    beats {
        puerto => 5044
        tipo => 'iis'
        ssl => true
        autoridades_certificado_ssl => ["/etc/pki/tls/certs/app/ca.pem", "/etc/pki/tls/certs/app/ca-issuing.pem"]
        certificado_ssl => "/etc/pki/tls/certs/app/queue.domain.com.cer"
        clave_ssl => "/etc/pki/tls/certs/app/queue.domain.com-pkcs8.key"
        modo_verificacion_ssl => "peer"
    }

}

salida {
  #stdout {codec => rubydebug}

    rabbitmq {
        host => "127.0.0.1"
        puerto => 5672
        intercambio => "monitor.direct"
        tipo_intercambio => "direct"
        clave => "%{[fields][fld_app_name]}"
        usuario => "q-writer"
        contrasena => "password"
        ssl => false
    }
}
RabbitMQ. Cola de mensajes
Este componente se utiliza para almacenar registros de logs en la DMZ. La escritura se realiza a través de la combinación Filebeat → LogStash. La lectura se lleva a cabo desde fuera de la DMZ a través de LogStash. En operación a través de RabbitMQ, se manejan alrededor de 4,000 mensajes por segundo.
El enrutamiento de mensajes está configurado por el nombre del sistema, es decir, basado en los datos de configuración de FileBeat. Todos los mensajes llegan a una sola cola. Si por alguna razón el servicio de colas se detiene, no habrá pérdida de mensajes: los FileBeat recibirán errores de conexión y pausarán temporalmente el envío. LogStash, que lee de la cola, también recibirá errores de red y esperará a que se restablezca la conexión. Los datos, por supuesto, dejarán de escribirse en la base de datos.
Las siguientes instrucciones se utilizan para crear y configurar colas:
sudo /usr/local/bin/rabbitmqadmin/rabbitmqadmin declare exchange --vhost=/ name=monitor.direct type=direct
sudo /usr/local/bin/rabbitmqadmin/rabbitmqadmin declare queue --vhost=/ name=web_log durable=true
sudo /usr/local/bin/rabbitmqadmin/rabbitmqadmin --vhost="/" declare binding source="monitor.direct" destination_type="queue" destination="web_log" routing_key="site1.domain.ru"
sudo /usr/local/bin/rabbitmqadmin/rabbitmqadmin --vhost="/" declare binding source="monitor.direct" destination_type="queue" destination="web_log" routing_key="site2.domain.ru"
Grafana. Dashboards
Este componente se utiliza para visualizar datos de monitoreo. Para esto, es necesario instalar el plugin ClickHouse datasource for Grafana 4.6+. Tuvimos que ajustarlo un poco para mejorar la eficiencia del procesamiento de filtros SQL en el dashboard.
Por ejemplo, utilizamos variables, y si no están definidas en el campo del filtro, nos gustaría que no generara una condición en WHERE del tipo ( uriStem = » AND uriStem != » ). En tal caso, ClickHouse leerá la columna uriStem. En general, probamos diferentes opciones y al final ajustamos el plugin (macros $valueIfEmpty), de modo que en caso de un valor vacío, devuelva 1, sin mencionar la columna en sí.
Y ahora se puede usar una consulta como esta para el gráfico
$columns(response, count(*) c) from $table where $adhoc
and $valueIfEmpty($fld_app_name, 1, fld_app_name = '$fld_app_name')
and $valueIfEmpty($fld_app_module, 1, fld_app_module = '$fld_app_module') and $valueIfEmpty($fld_server_name, 1, fld_server_name = '$fld_server_name') and $valueIfEmpty($uriStem, 1, uriStem like '%$uriStem%')
and $valueIfEmpty($clientRealIP, 1, clientRealIP = '$clientRealIP')
que se transforma en esta SQL (tenga en cuenta que los campos vacíos uriStem se transformaron simplemente en 1)
SELECT
t,
groupArray((response, c)) AS groupArr
FROM (
SELECT
(intDiv(toUInt32(logdatetime), 60) * 60) * 1000 AS t, response,
count(*) AS c FROM default.log_web
WHERE (logdate >= toDate(1565061982)) AND (logdatetime >= toDateTime(1565061982)) AND 1 AND (fld_app_name = 'site1.domain.ru') AND (fld_app_module = 'web') AND 1 AND 1 AND 1
GROUP BY
t, response
ORDER BY
t ASC,
response ASC
)
GROUP BY t ORDER BY t ASC
Conclusión
La aparición de ClickHouse fue un evento significativo en el mercado. Era difícil imaginar que de forma completamente gratuita, en un instante nos equiparíamos con una herramienta poderosa y práctica para trabajar con big data. Sin duda, a medida que aumenten las necesidades (como el sharding y la replicación en varios servidores), el esquema se volverá más complejo. Pero, en primera impresión, trabajar con esta base de datos es muy agradable. Se nota que el producto está hecho 'para la gente'.
En comparación con ElasticSearch, los costos de almacenamiento y procesamiento de logs, según estimaciones preliminares, se reducen entre cinco y diez veces. En otras palabras, si para el volumen actual de datos tuviéramos que configurar un clúster de varias máquinas, al usar ClickHouse nos basta con una máquina de bajo rendimiento. Sí, por supuesto, ElasticSearch también tiene mecanismos de compresión de datos en disco y otras características que permiten reducir el consumo de recursos, pero en comparación con ClickHouse eso requerirá mayores gastos.
Sin ninguna optimización especial de nuestra parte, con la configuración predeterminada, la carga de datos y las consultas a la base de datos funcionan a una velocidad impresionante. Por el momento, no tenemos muchos datos (alrededor de 200 millones de registros), pero el servidor es débil. Esta herramienta la podemos usar en el futuro también para otros fines no relacionados con el almacenamiento de logs. Por ejemplo, para análisis integral, en el ámbito de la seguridad, en el aprendizaje automático.
Al final, un poco sobre los pros y los contras.
Desventajas
- Cargar registros en grandes lotes. Esto, por un lado, es una característica, pero aún así es necesario utilizar componentes adicionales para la memoria intermedia de los registros. Esta tarea no siempre es sencilla, pero es resolvible. Y nos gustaría simplificar el esquema.
- Algunas características exóticas o nuevas funciones a menudo se rompen en las nuevas versiones. Esto genera preocupaciones y disminuye el deseo de actualizar a la nueva versión. Por ejemplo, el motor de tablas Kafka es una función muy útil que permite leer eventos directamente de Kafka, sin necesidad de implementar consumidores. Pero, según la cantidad de problemas en GitHub, todavía tenemos reservas sobre el uso de este motor en producción. Sin embargo, si no se realizan cambios drásticos y se utiliza la funcionalidad principal, funciona de manera estable.
Ventajas
- No se retrasa.
- Bajo umbral de entrada.
- Código abierto.
- Es gratuita.
- Se escala bien (sharding/replicación "de forma nativa")
- Está en el registro de software ruso recomendado por el Ministerio de Comunicaciones.
- Disponibilidad de soporte oficial de Yandex.
Fuente: habr.com
