

Es importante para nosotros entender qué sucede con nuestros estudiantes durante el aprendizaje y cómo estos eventos impactan en los resultados, por lo que creamos un Customer Journey Map — un mapa de la experiencia del cliente. El proceso de aprendizaje no es algo continuo y homogéneo, sino una cadena de eventos y acciones interconectados del estudiante, donde estas acciones pueden diferir significativamente entre los distintos alumnos. Él ha completado una lección: ¿qué hará a continuación? ¿Irá a hacer la tarea? ¿Abrirá la aplicación móvil? ¿Cambiará de curso, pedirá un nuevo profesor? ¿Entrará de inmediato a la siguiente lección? ¿O simplemente se marchará decepcionado? ¿Es posible, al analizar este mapa, identificar patrones que conducen a la finalización exitosa del curso o, por el contrario, al abandono del estudiante?
Normalmente, para construir un CJM se utilizan herramientas especializadas, bastante costosas y con código cerrado. Pero queríamos idear algo simple, que requiriera un esfuerzo mínimo y, en la medida de lo posible, que fuera de código abierto. Así surgió la idea de utilizar cadenas de Markov — y lo logramos. Construimos un mapa, interpretamos los datos sobre el comportamiento de los estudiantes en forma de grafo, y encontramos respuestas completamente inesperadas a preguntas globales del negocio e incluso descubrimos errores profundamente ocultos. Todo esto lo hicimos con soluciones de código abierto usando un script de Python. En este artículo, contaré sobre dos casos con esos resultados inesperados y compartiré el script con todos los interesados.
Así que, las cadenas de Markov muestran la probabilidad de transiciones entre eventos. Aquí hay un ejemplo primitivo de Wikipedia:
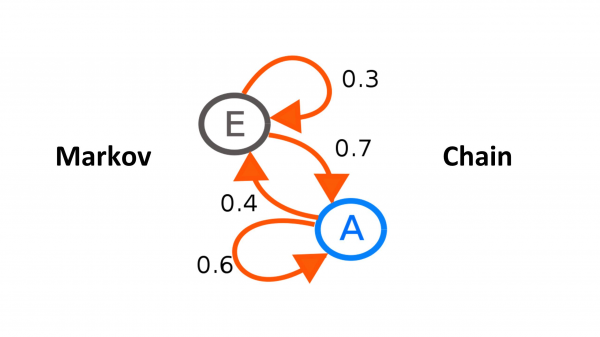
Aquí, "E" y "A" son eventos, las flechas son transiciones entre ellos (incluyendo la transición de un evento a sí mismo), y los pesos de las flechas son la probabilidad de transición ("grafo orientado ponderado").
Qué utilizamos
La cadena se entrenó con la funcionalidad estándar de Python, que recibió los registros de actividad de los estudiantes. El grafo se construyó a partir de la matriz obtenida utilizando la biblioteca NetworkX.
El registro se ve así:
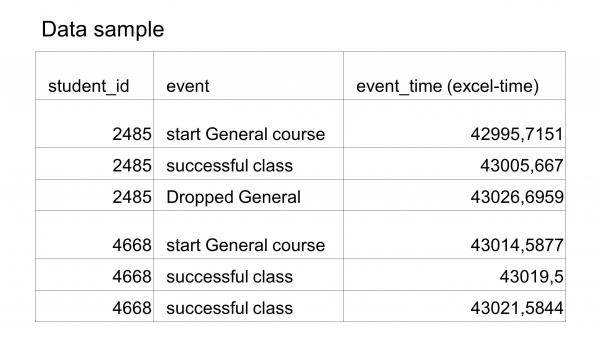
Es un archivo csv que contiene una tabla de tres columnas: id del estudiante, nombre del evento, y el tiempo en que ocurrió. Estos tres campos son suficientes para seguir los movimientos del cliente, construir un mapa y, al final, obtener una cadena de Markov.
La biblioteca devuelve los grafos construidos en formato .dot o .gexf. Para la visualización de los primeros, se puede utilizar el paquete gratuito Graphviz (herramienta gvedit), nosotros trabajamos con .gexf y Gephi, que también es gratuito.
A continuación, quiero presentar dos ejemplos del uso de cadenas de Markov, que nos permitieron replantearnos nuestras metas, procesos de aprendizaje y el mismo ecosistema de Skyeng. También corregimos algunos errores.
Primer caso: aplicación móvil
Primero, investigamos el camino del estudiante en nuestro producto más popular: el curso General. En ese momento trabajaba en el departamento infantil de Skyeng y queríamos ver qué tan eficaz era la aplicación móvil con nuestro público infantil.
Tomé los registros y los pasé por un script, obteniendo algo como esto:
El nodo de inicio — Start General, y abajo tres nodos de salida: el estudiante 'se durmió', cambió de curso, finalizó el curso.
- 'Se durmió' — significa que ya no asiste a las clases, lo más probable es que se haya desconectado. Lo llamamos optimistamente 'se durmió', ya que teóricamente tiene la posibilidad de continuar su aprendizaje. Es el peor resultado para nosotros.
- 'Cambiado de curso' — se pasó de General a otra cosa y se perdió para nuestra cadena de Markov.
- 'Finalizó el curso' — un estado ideal, la persona completó el 80% de las lecciones (no todas son obligatorias).
Llegar al nodo 'clase exitosa' significa que se ha completado una lección en nuestra plataforma con el profesor. Registra el progreso en el curso y la aproximación al resultado deseado — 'Finalizó el curso'. Es importante que los estudiantes lo visiten lo más posible.
Para obtener conclusiones cuantitativas más precisas para la aplicación móvil (nodo de sesión de la app), construimos cadenas separadas para cada uno de los nodos finales y luego comparamos los pesos de las aristas de manera pareada:
- de sesión de app de vuelta a ella misma;
- de sesión de app a clase exitosa;
- de clase exitosa a sesión de app.
A la izquierda — estudiantes que finalizaron el curso, a la derecha — 'se durmieron'
Estas tres aristas muestran la relación entre el éxito del estudiante y su uso de la aplicación móvil. Esperábamos ver que los estudiantes que finalizaron el curso tuvieran una relación más fuerte con la aplicación que los 'dormidos'. Sin embargo, obtuvimos resultados exactamente opuestos:
- Nos dimos cuenta de que diferentes grupos de usuarios interactúan de manera diferente con la aplicación móvil;
- los estudiantes exitosos utilizan la aplicación móvil de manera menos intensa;
- los estudiantes que se distraen utilizan más activamente la aplicación móvil.
Esto significa que los estudiantes 'que se distraen' comienzan a pasar cada vez más tiempo en la aplicación móvil y, al final, se quedan en ella para siempre.
Al principio nos sorprendió, pero al pensarlo, nos dimos cuenta de que era un efecto bastante lógico. En su momento, estudié francés por mi cuenta utilizando dos herramientas: una aplicación móvil y lecciones de gramática en YouTube. Al principio, dividía mi tiempo entre ambas en una proporción de 50 a 50. Pero la aplicación es más divertida, tiene gamificación, todo es simple, rápido y claro, mientras que en las lecciones hay que profundizar, tomar notas y practicar en un cuaderno. Con el tiempo, empecé a pasar más tiempo en mi teléfono, hasta que su proporción alcanzó el 100%: si pasas tres horas en ella, se crea una falsa sensación de trabajo realizado, lo que genera una falta de deseo de ir a escuchar algo.
Pero, ¿cómo es posible? Después de todo, diseñamos la aplicación móvil específicamente, , la gamificamos, la hicimos atractiva para que la gente pasara tiempo en ella, ¿y resulta que solo los distrae? En realidad, la razón es que el equipo de la aplicación móvil cumplió tan bien con sus tareas que se convirtió en un producto independiente y comenzó a salirse de nuestro ecosistema.
Como resultado de la investigación, se llegó a la comprensión de que la aplicación móvil debe ser modificada para que no desvíe tanto del curso principal de aprendizaje. Esto se aplica tanto a niños como a adultos. Actualmente, se está trabajando en esto.
Segundo caso: errores en la incorporación.
La incorporación es un procedimiento adicional no obligatorio al registrar un nuevo estudiante, que evita problemas técnicos potenciales en el futuro. El escenario básico implica que la persona se registre en la página de aterrizaje, obtenga acceso a su cuenta personal, se ponga en contacto con ellos y reciba una lección introductoria. Observamos un gran porcentaje de dificultades técnicas durante la lección introductoria: no tener la versión correcta del navegador, el micrófono o el sonido que no funcionan, el profesor no puede ofrecer una solución de inmediato, y todo esto es especialmente complicado cuando se trata de niños. Por ello, hemos desarrollado una aplicación adicional en la cuenta personal, donde se pueden realizar cuatro pasos sencillos: verificar el navegador, la cámara, el micrófono y confirmar que los padres estarán presentes durante la lección introductoria (pues son ellos quienes pagan por la educación de los niños).
Estas páginas de incorporación mostraron el siguiente embudo:
1: un bloque inicial con tres formularios de inicio de sesión ligeramente diferentes (dependiendo del cliente).
2: una casilla de aceptación para el procedimiento adicional de incorporación.
2.1-2.3: verificación de la presencia del padre, la versión de Chrome y el sonido.
3: bloque final.
Se ve muy natural: en los primeros dos pasos, la mayoría de los visitantes se retiran, al darse cuenta de que aquí hay que llenar algo, verificar, y no hay tiempo. Si el cliente llega al tercer paso, es casi seguro que llegará hasta el final. En el embudo no se observa ninguna razón para sospechar algo.
Sin embargo, decidimos analizar nuestra incorporación no con el clásico embudo unidimensional, sino mediante una cadena de Markov. Incluimos un poco más de eventos, ejecutamos el script y obtuvimos esto:
Solo se puede entender con claridad en este caos una cosa: algo salió mal. El proceso de incorporación es lineal, así lo establece el diseño, no debería haber una red de conexiones como esta. Aquí se ve claramente que el usuario es desviado entre pasos, entre los que no debería haber transiciones.
Las razones de esta extraña imagen pueden ser dos:
- errores han infiltrado la base de logs;
- los errores están presentes en el propio producto: la incorporación.
La primera razón probablemente esté presente, pero comprobarla es bastante laborioso, y la corrección de los registros no ayudará a mejorar la experiencia del usuario. En cuanto a la segunda, si existe, había que hacer algo al respecto de inmediato. Por eso nos dedicamos a analizar los nodos, identificar los bordes que no deberían existir y buscar las causas de su aparición. Observamos que algunos usuarios se quedaban atrapados y daban vueltas en círculos, otros salían de la mitad al inicio, y algunos simplemente no podían salir de los primeros dos pasos. Pasamos los datos a QA y sí, resultó que había muchos bugs en el onboarding: es un producto secundario, un poco improvisado, no se probó lo suficientemente a fondo porque no se esperaban problemas. Ahora todo el proceso de registro ha cambiado.
Esta historia nos mostró una aplicación inesperada de las cadenas de Markov en el área de QA.
¡Inténtalo tú mismo!
He subido mi al dominio público — úsenlo con gusto. La documentación está en GitHub, pueden preguntar aquí, intentaré responder a todas las consultas.
Y algunos enlaces útiles: , . Y aquí hay un artículo Gephi .
Fuente: habr.com
