

¡Hola, Habr!
Después de las festividades de Año Nuevo, relanzamos la nube de recuperación ante desastres con base en dos sitios. Hoy hablaremos de cómo está organizada y mostraremos qué ocurre con las máquinas virtuales de los clientes en caso de fallas de elementos individuales del clúster y caída de un sitio completo (spoiler: todo sigue funcionando bien).
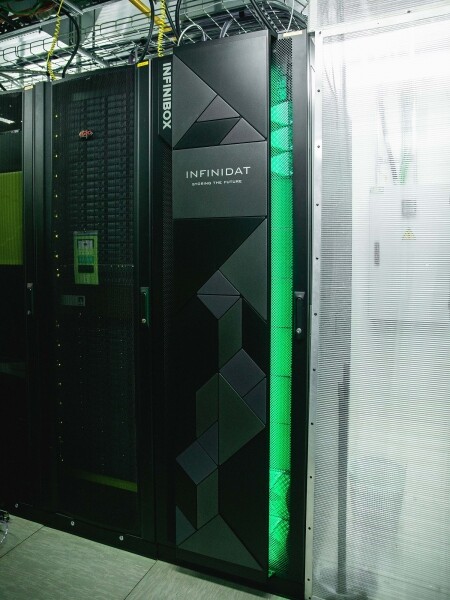
Almacenamiento en la nube de recuperación ante desastres en el sitio OST.
Qué hay dentro
En el núcleo del clúster hay servidores Cisco UCS con el hipervisor VMware ESXi, dos sistemas de almacenamiento INFINIDAT InfiniBox F2240, equipos de red Cisco Nexus, así como switches SAN Brocade. El clúster está distribuido en dos sitios: OST y NORD, es decir, en cada centro de datos hay un conjunto idéntico de hardware. Esto es lo que lo hace resistente a desastres.
Dentro de un sitio, los elementos principales también están duplicados (hosts, switches SAN, red).
Los dos sitios están conectados por tramos de fibra óptica dedicados, también redundantes.
Unas palabras sobre el almacenamiento. La primera versión de la nube de recuperación ante desastres la construimos sobre NetApp. Aquí elegimos INFINIDAT, y aquí está el porqué:
- Opción de replicación activa-activa. Permite que la máquina virtual se mantenga en funcionamiento incluso ante la falla completa de uno de los sistemas de almacenamiento. Hablaré sobre la replicación más adelante.
- Tres controladores de disco para mejorar la disponibilidad del sistema. Normalmente hay dos.
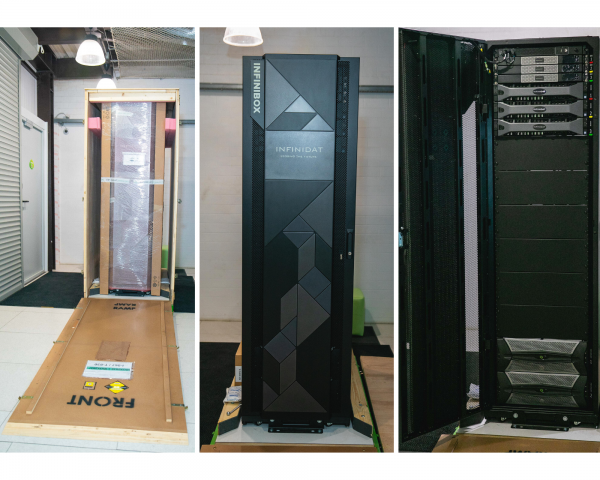
- Solución lista. Recibimos un rack ya ensamblado, que solo necesita ser conectado a la red y configurado.
- Soporte técnico atento. Los ingenieros de INFINIDAT analizan constantemente los registros y eventos del sistema de almacenamiento, instalan nuevas versiones de firmware, y ayudan con la configuración.
Aquí van algunas fotos del unpacking:
Cómo funciona
La nube ya es resistente por sí misma. Protege al cliente contra fallas de hardware y software individuales. Mientras que la recuperación ante desastres ayuda a protegerse contra fallas masivas dentro de un solo sitio: por ejemplo, falla de un almacenamiento (o cluster SDS, lo que ocurre con frecuencia 🙂), errores masivos en la red de almacenamiento, entre otros. Y lo más importante: tal nube ayuda cuando un sitio completo se vuelve inaccesible debido a un incendio, un apagón, una toma hostil, o un aterrizaje extraterrestre.
En todos estos casos, las máquinas virtuales de los clientes continúan funcionando, y aquí está el porqué.
El esquema del clúster está diseñado de tal manera que cualquier host ESXi con máquinas virtuales de cliente puede acceder a cualquiera de los dos centros de almacenamiento (SAN). Si el SAN en el sitio de OST falla, las máquinas virtuales continuarán funcionando: los hosts en los que operan accederán a los datos del SAN en NORD.
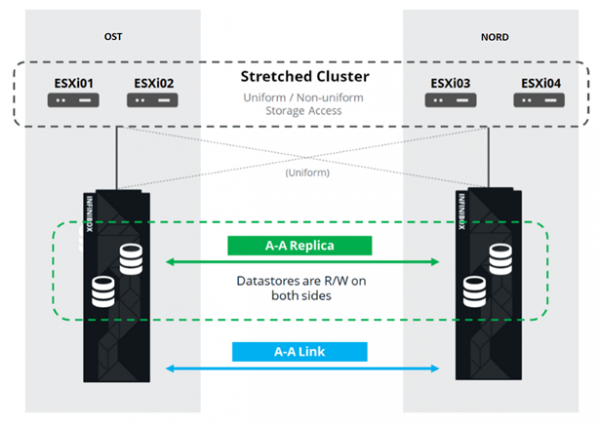
Así es como se ve el esquema de conexión en el clúster.
Esto es posible gracias a que se ha configurado Inter-Switch Link entre las fábricas SAN de los dos sitios: el switch SAN de la Fábrica A OST está conectado al switch SAN de la Fábrica A NORD, de manera similar para los switches SAN de la Fábrica B.
Y para que todas estas complejidades de las fábricas SAN tengan sentido, se ha configurado una replicación activa-activa entre los dos SAN: la información se registra prácticamente al mismo tiempo en el SAN local y en el remoto, RPO=0. Así que, un SAN almacena el original de los datos, mientras que el otro tiene su réplica. Los datos se replican a nivel de volúmenes de SAN, y sobre ellos se almacenan los datos de las VM (sus discos, archivos de configuración, archivos de intercambio, etc.).
El host ESXi ve el volumen principal y su réplica como un solo dispositivo de almacenamiento (Storage Device). Desde el host ESXi hacia cada dispositivo de almacenamiento hay 24 caminos:
12 caminos lo conectan con el SAN local (caminos óptimos), y los otros 12 - con el remoto (caminos no óptimos). En una situación normal, el ESXi accede a los datos en el SAN local utilizando los caminos 'óptimos'. Cuando este SAN falla, el ESXi pierde los caminos óptimos y se cambia a los 'no óptimos'. Así es como se ve en el esquema.
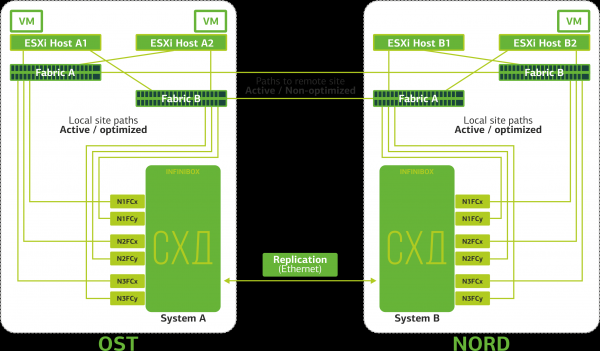
Esquema de clúster de resistencia a desastres.
Todas las redes de clientes están conectadas a ambos sitios a través de una infraestructura de red común. En cada sitio funciona un Provider Edge (PE), donde se terminan las redes del cliente. Los PE están unidos en un clúster común. Si un PE falla en un sitio, todo el tráfico se redirige al segundo sitio. Gracias a esto, las máquinas virtuales del sitio que se queda sin PE siguen estando accesibles a través de la red para el cliente.
Ahora veamos qué sucederá con las máquinas virtuales del cliente en diversas fallas. Comencemos con las opciones más leves y terminemos con la más seria: la falla de todo el sitio. En los ejemplos, el sitio principal será OST, y el de respaldo, con réplicas de datos, será NORD.
¿Qué sucede con la máquina virtual del cliente si…
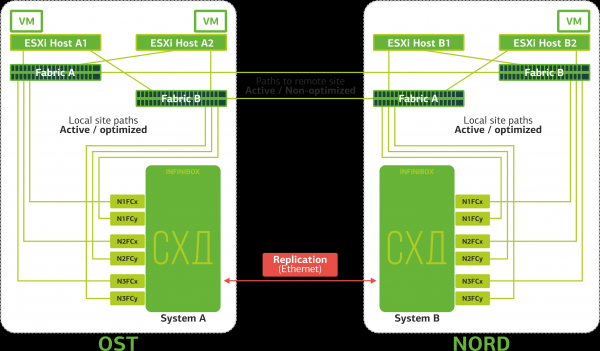
Falla el Replication Link. La replicación entre los SAN de los dos sitios se detiene.
ESXi solo funcionará con dispositivos de almacenamiento locales (a través de rutas óptimas).
Las máquinas virtuales siguen funcionando.
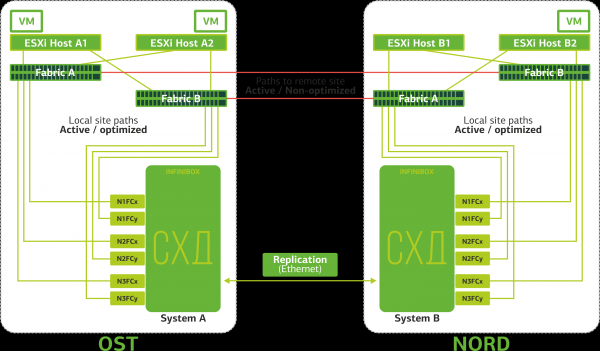
Está ocurriendo una ruptura de ISL (Inter-Switch Link). Es un caso poco probable. A menos que algún excavador loco corte varias líneas ópticas que pasan por rutas independientes y estén conectadas a los sitios a través de diferentes entradas. Pero aún así. En este caso, los hosts ESXi perderían la mitad de las rutas y solo podrían acceder a sus propias SAN locales. Las réplicas se recopilan, pero los hosts no podrán acceder a ellas.
Las máquinas virtuales funcionan normalmente.
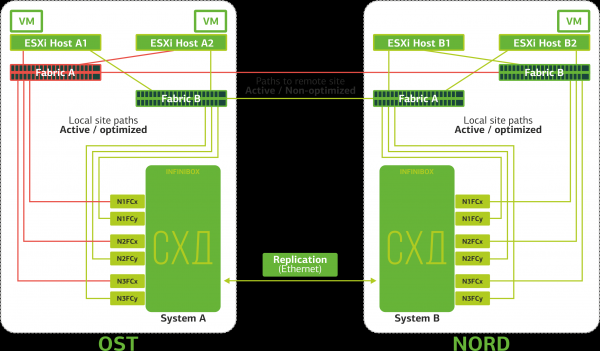
Falla un switch SAN en uno de los sitios. Los hosts ESXi pierden parte de las rutas a la SAN. En este caso, los hosts en el sitio donde falló el switch funcionarán solo a través de su HBA único.
Las máquinas virtuales siguen funcionando normalmente.
Fallen todos los switches SAN en uno de los sitios. Supongamos que esto sucede en el sitio OST. En este caso, los hosts ESXi en ese sitio perderán todas las rutas a sus dispositivos de almacenamiento. Actúa el mecanismo estándar de VMware vSphere HA: reiniciará todas las máquinas virtuales del sitio OST en NORD en un máximo de 140 segundos.
Las máquinas virtuales que funcionan en los hosts del sitio NORD operan normalmente.
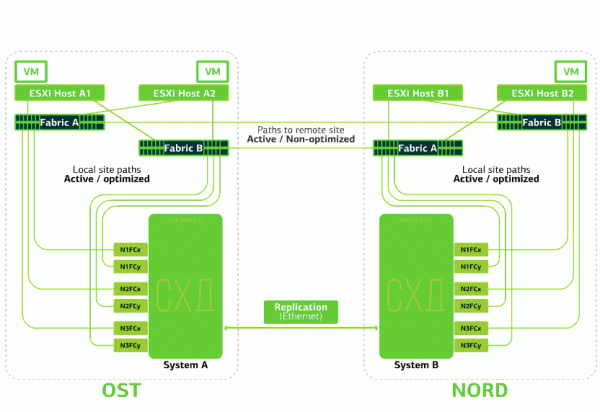
Falla un host ESXi en uno de los sitios. Aquí el mecanismo vSphere HA vuelve a activarse: las máquinas virtuales del host defectuoso se reinician en otros hosts, ya sea en el mismo sitio o en un sitio remoto. El tiempo de reinicio de la máquina virtual es de hasta 1 minuto.
Si fallan todos los hosts ESXi del sitio OST, no hay opción: las VMs se reinician en otro. El tiempo de reinicio es el mismo.
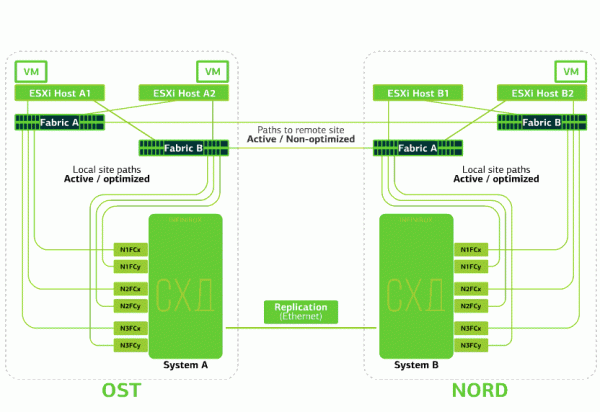
Falla la SAN en uno de los sitios. Supongamos que la SAN falló en el sitio OST. Entonces, los hosts ESXi del sitio OST cambiarán a trabajar con las réplicas de la SAN en NORD. Después de que la SAN defectuosa vuelva a estar operativa, se llevará a cabo una replicación forzada y los hosts ESXi OST volverán a acceder a su SAN local.
Las máquinas virtuales siguen funcionando normalmente durante todo este tiempo.
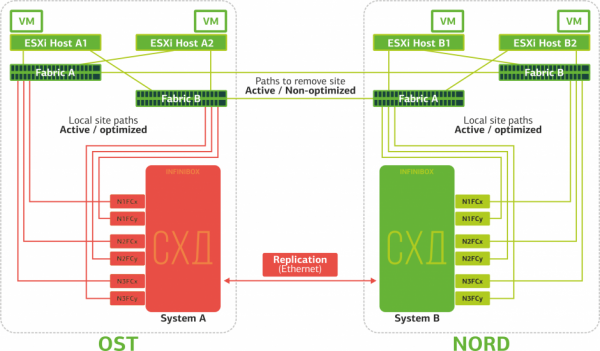
Falla uno de los sitios. En este caso, todas las máquinas virtuales se reiniciarán en el sitio de respaldo a través del mecanismo vSphere HA. El tiempo de reinicio de las VMs es de 140 segundos. Durante esto, todas las configuraciones de red de la máquina virtual se mantendrán, y seguirá siendo accesible para el cliente a través de la red.
Para que el reinicio de las máquinas en la ubicación de respaldo transcurra sin problemas, cada lugar está ocupado solo a la mitad. La segunda mitad se reserva en caso de trasladar todas las máquinas virtuales desde la segunda ubicación afectada.
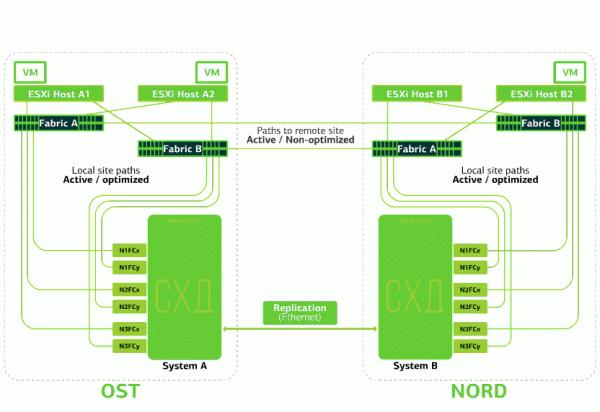
Este tipo de fallos es lo que protege una nube de alta disponibilidad basada en dos centros de datos.
Este placer no es barato, ya que, además de los recursos básicos, se necesita una reserva en la segunda ubicación. Por eso, se alojan en esta nube los servicios críticos para el negocio, cuyo largo tiempo de inactividad podría generar grandes pérdidas financieras y de reputación, o si hay requisitos de alta disponibilidad requeridos por reguladores o normas internas de la empresa.
Fuentes:
Fuente: habr.com
