

Este artículo está escrito para ayudar a elegir la solución adecuada y entender las diferencias entre SDS como Gluster, Ceph y Vstorage (Virtuozzo).
El texto utiliza enlaces a artículos con un análisis más detallado de ciertos problemas, por lo que las descripciones serán lo más breves posible, utilizando puntos clave sin información innecesaria y sin introducciones que puedes encontrar por tu cuenta en internet.
De hecho, los temas tratados requieren un tono formal, pero en el mundo moderno cada vez más personas no quieren leer mucho))), por lo que se puede leer rápidamente y tomar una decisión, y si algo no queda claro, se pueden seguir los enlaces o buscar palabras desconocidas))), este artículo actúa como una envoltura transparente para estos temas profundos, mostrando el contenido: los principales puntos clave de cada solución.
Gluster
Comencemos con Gluster, que se utiliza activamente en plataformas hipercalificadas con SDS de código abierto para entornos virtuales y que se puede encontrar en el sitio web de RedHat en la sección de almacenamiento, donde se ofrece elegir entre dos opciones de SDS: Gluster o Ceph.
Gluster consiste en un stack de traductores: servicios que realizan todas las tareas de distribución de archivos, etc. Brick – es el servicio que atiende un disco, Volume – es el volumen (pool) que combina estos bricks. Luego viene el servicio de distribución de archivos por grupos mediante la función DHT (tabla hash distribuida). No incluiremos en la descripción el servicio de Sharding, ya que en los enlaces proporcionados a continuación habrá una descripción de los problemas relacionados con él.
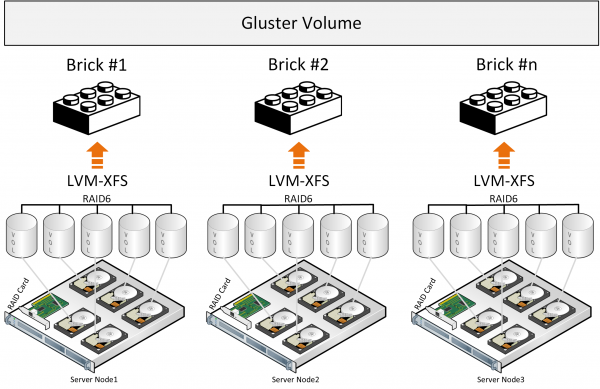
Al escribir, el archivo se guarda completamente en un brick y su copia se escribe paralelamente en un brick en el segundo servidor. Luego, un segundo archivo se grabará en el segundo grupo de dos bricks (o más) en diferentes servidores.
Si los archivos son de tamaño similar y el volumen consta solo de un grupo, todo está bien, pero en otras condiciones surgirán los siguientes problemas de las descripciones:
- el espacio en los grupos se utiliza de manera desigual, esto depende del tamaño de los archivos y, si hay insuficiente espacio en el grupo para guardar el archivo, recibirá un error, el archivo no se guardará y no se redistribuirá a otro grupo;
- al escribir un solo archivo, IO solo va a un grupo, los demás quedan inactivos;
- no se puede obtener IO de todo el volumen al escribir un solo archivo;
- y el concepto general parece menos eficiente debido a la falta de distribución de datos en bloques, donde es más fácil lograr un equilibrio y resolver el problema de la distribución uniforme, en lugar de que ahora el archivo se coloque en un bloque entero.
De la descripción oficial también surge involuntariamente la comprensión de que Gluster opera como un almacenamiento de archivos sobre un RAID de hardware clásico. Ha habido intentos de desarrollar la segmentación (Sharding) de archivos en bloques, pero todo esto es un complemento que impone pérdidas de rendimiento al enfoque arquitectónico ya existente, además del uso de componentes de código abierto con limitaciones de rendimiento como Fuse. No hay servicios de metadatos, lo que limita las capacidades de rendimiento y redundancia del almacenamiento al distribuir archivos en bloques. Se pueden observar mejores métricas de rendimiento con la configuración 'Distributed Replicated' y el número de nodos debe ser al menos 6 para organizar una réplica confiable de 3 con una distribución óptima de la carga.
Estas conclusiones también están relacionadas con la descripción de la experiencia de uso y al compararlo con , y también hay una descripción de la experiencia que lleva a comprender esta configuración más productiva y confiable
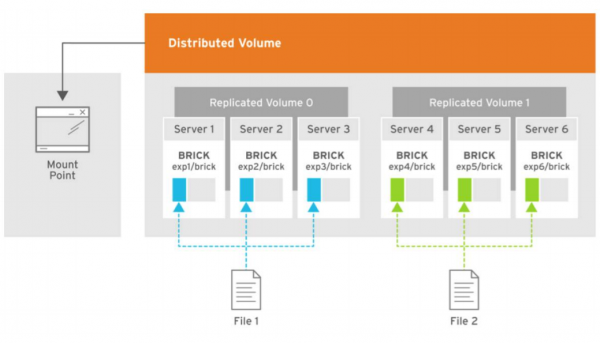
En la imagen se muestra la distribución de carga al escribir dos archivos, donde las copias del primer archivo se distribuyen entre los tres primeros servidores, que están agrupados en el volumen 0, y las tres copias del segundo archivo se colocan en el segundo grupo volume1 de tres servidores. Cada servidor tiene un disco.
La conclusión general es que se puede usar Gluster, pero con la comprensión de que habrá limitaciones en rendimiento y redundancia que crean dificultades bajo ciertas condiciones en soluciones hiperconvergentes, donde los recursos también son necesarios para las cargas computacionales de entornos virtuales.
También hay algunos indicadores de rendimiento de Gluster que se pueden lograr bajo ciertas condiciones limitándose en
Ceph
Ahora consideremos Ceph a partir de descripciones de arquitectura que he logrado También hay una comparación entre , donde se puede entender de inmediato que es recomendable implementar Ceph en servidores separados, ya que sus servicios requieren todos los recursos del hardware bajo carga.
Arquitectura es más complicado que Gluster y tiene servicios como los de metadatos, pero toda la pila de componentes es bastante compleja y no muy flexible para su uso en soluciones de virtualización. Los datos se agrupan en bloques, lo que parece más eficiente, pero hay pérdidas y latencia en la jerarquía de todos los servicios (componentes) bajo ciertas cargas y condiciones de falla; un ejemplo es lo siguiente
En la descripción de la arquitectura, el corazón es CRUSH, gracias al cual se elige el lugar para almacenar los datos. A continuación está PG; esta es la abstracción más compleja (grupo lógico) para comprender. PG son necesarios para que CRUSH sea más eficiente. La principal función de PG es agrupar objetos para reducir el consumo de recursos, aumentar el rendimiento y la escalabilidad. La dirección de objetos de forma directa, por separado, sin agruparlos en PG sería muy costosa. OSD es el servicio para cada disco individual.
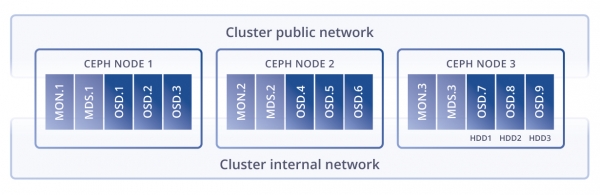
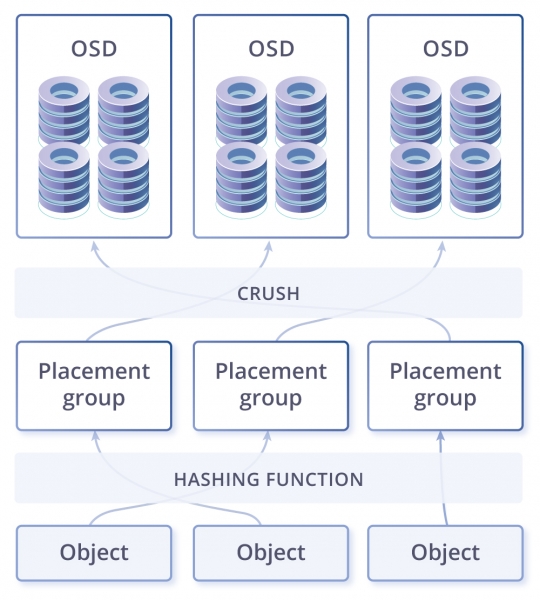
Un clúster puede tener uno o varios grupos de datos para diferentes propósitos y configuraciones. Los grupos se dividen en grupos de colocación. En los grupos de colocación se almacenan los objetos a los que acceden los clientes. Aquí termina el nivel lógico y comienza el físico, porque detrás de cada grupo de colocación hay un disco principal y varios discos réplicas (la cantidad depende del factor de replicación del grupo). En otras palabras, a nivel lógico, el objeto se almacena en un grupo de colocación específico, y a nivel físico, en los discos que están asignados a él. Estos discos pueden estar físicamente en diferentes nodos o incluso en diferentes centros de datos.
En este esquema, los grupos de colocación parecen ser un nivel necesario para la flexibilidad de toda la solución, pero al mismo tiempo, son un eslabón adicional en esta cadena, lo que inevitablemente sugiere una pérdida de rendimiento. Por ejemplo, al grabar datos, el sistema necesita dividirlos en estos grupos y luego, a nivel físico, en el disco principal y en los discos para réplicas. Es decir, la función hash trabaja al buscar e insertar un objeto, pero hay un efecto secundario: hay unos costos muy altos y limitaciones en la reestructuración del hash (al añadir o eliminar un disco). Otro problema del hash es la ubicación de los datos, que está fijada y no se puede cambiar. Por lo tanto, si un disco experimenta una carga excesiva, el sistema no tiene la posibilidad de no escribir en él (elegir otro disco); la función hash obliga a ubicar los datos de acuerdo con una regla, independientemente de lo mal que le vaya al disco. Por esta razón, Ceph consume mucha memoria al reestructurar los PG en caso de auto-reparación o aumento del almacenamiento. La conclusión es que Ceph funciona bien (aunque lentamente), pero solo cuando no hay escalado, situaciones de emergencia o actualizaciones.
Por supuesto, hay opciones para mejorar el rendimiento mediante la caché y la caché de niveles, pero para ello se necesita un buen hardware y, aun así, habrá pérdidas. Sin embargo, en general, Ceph parece ser más atractivo que Gluster para la producción. Además, al utilizar estos productos es necesario tener en cuenta un factor muy importante: se requiere un alto nivel de competencias, experiencia y profesionalismo con un gran énfasis en Linux, ya que es fundamental desplegar, configurar y mantener todo correctamente, lo que impone aún mayor responsabilidad y carga al administrador.
Vstorage
La arquitectura de , se puede utilizar junto con el hipervisor en los mismos nodos, en el mismo , pero es muy importante configurarlo correctamente para lograr un buen rendimiento. Es decir, desplegar un producto así directamente en cualquier configuración sin tener en cuenta las recomendaciones de acuerdo con la arquitectura será muy fácil, pero no productivo.
¿Qué puede coexistir para el almacenamiento junto con los servicios del hipervisor kvm-qemu? Solo hay algunos servicios donde se ha encontrado una jerarquía compacta y óptima de componentes: el servicio del cliente montado a través de FUSE (modificado, no de código abierto), el servicio de metadatos MDS (Metadata service), el servicio de bloques de datos Chunk service, que a nivel físico equivale a un disco y eso es todo. En términos de velocidad, es óptimo utilizar un esquema redundante con dos réplicas, pero si se utiliza almacenamiento en caché y registros en discos SSD, la codificación de tolerancia a fallos (erase coding o raid6) se puede acelerar bastante en un esquema híbrido o incluso mejor en todo flash. Con la EC (erase coding) hay cierta desventaja: al cambiar un bloque de datos, es necesario recalcular las sumas de paridad. Para evitar pérdidas en esta operación, Ceph escribe en EC de forma diferida y pueden ocurrir problemas de rendimiento en ciertas solicitudes, cuando por ejemplo es necesario leer todos los bloques, mientras que en el caso de Virtuozzo Storage, la escritura de bloques modificados se realiza utilizando el enfoque de “sistema de archivos estructurado por registros”, lo que minimiza los costos de cálculo de paridad. Para estimar aproximadamente las opciones de aceleración del rendimiento con EC y sin él, hay Las cifras obtenidas son aproximadas, dependiendo del coeficiente de precisión del fabricante del equipo, pero el resultado de los cálculos ayuda a planificar bien la configuración.
Un esquema simple de componentes de almacenamiento no significa que estos componentes no consuman pero si se calculan todos los costos de antemano, se puede contar con un funcionamiento conjunto junto al hipervisor.
Hay un esquema de comparación del consumo de recursos de hardware entre los servicios de Ceph y Virtuozzo Storage.
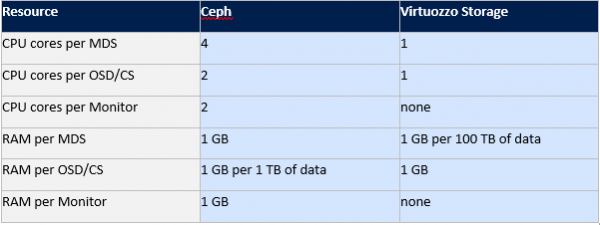
Si anteriormente se podía comparar Gluster y Ceph a partir de viejos artículos, utilizando las líneas más importantes de ellos, con Virtuozzo es más complicado. Hay pocos artículos sobre este producto y la información solo se puede obtener de la documentación en o en ruso si consideramos Vstorage como almacenamiento utilizado en algunas soluciones hiperconvergentes en empresas como y Acronis.
Intentaré ayudar con la descripción de esta arquitectura, así que el texto será un poco más extenso. Para entender la documentación, se necesita mucho tiempo, y la documentación existente se puede usar solo como un manual, revisando el índice o buscando por palabras clave.
Consideremos el proceso de grabación en una configuración híbrida de hardware con los componentes descritos anteriormente: la grabación comienza en el nodo desde el cual el cliente (el servicio de punto de montaje FUSE) la inició, pero el componente maestro del servicio de metadatos (MDS) dirigirá al cliente directamente al servicio de chunk correspondiente (el servicio de almacenamiento de bloques CS), por lo que el MDS no participa en el proceso de grabación, solo orienta al servicio de chunk necesario. En general, se puede hacer una analogía de la grabación con el derrame de agua en barriles. Cada barril es un bloque de datos de 256 MB.
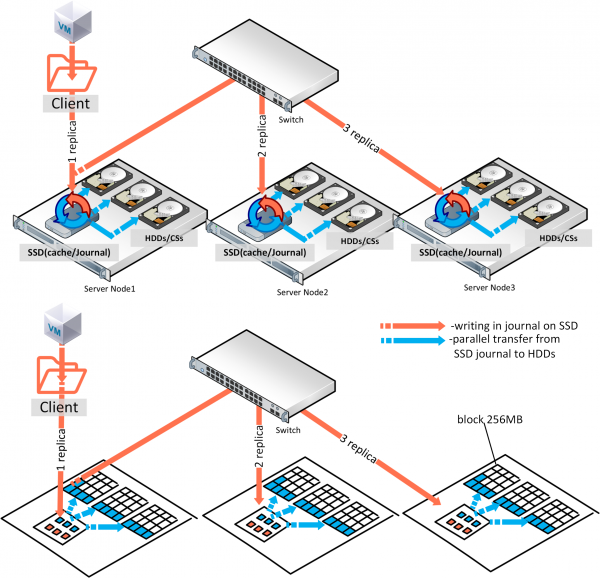
Es decir, un disco es una cierta cantidad de estos barriles, lo que equivale al volumen del disco dividido entre 256 MB. Cada copia se derrama en un nodo, la segunda casi paralelamente en otro nodo, y así sucesivamente... Si tenemos tres réplicas y discos SSD para caché (para lectura y registros de escritura), la confirmación de la grabación se producirá después de registrar el log en el SSD, mientras que el volcado paralelo del SSD continuará en el HDD, como si fuera en segundo plano. En el caso de tres réplicas, el commit de la grabación será tras la confirmación del SSD del tercer nodo. Puede parecer que la suma de las velocidades de grabación de tres SSD se puede dividir por tres, obteniendo así la velocidad de grabación de una réplica, pero la grabación de las copias ocurre paralelamente y la latencia de la red generalmente es mayor que la de los SSD. En esencia, el rendimiento de la grabación dependerá de la red. Por ello, para ver los IOPS reales, es necesario cargar correctamente todo el Vstorage según , es decir, probar la carga real, no la memoria y caché, donde es fundamental considerar el tamaño correcto del bloque de datos, el número de hilos, etc.
El registro mencionado anteriormente en SSD funciona de tal manera que, tan pronto como los datos ingresan, son leídos inmediatamente por el servicio y escritos en el HDD. Hay varios servicios de metadatos (MDS) por clúster, y su cantidad se determina por el quórum que opera según el algoritmo Paxos. Desde la perspectiva del cliente, el punto de montaje FUSE es una carpeta del almacenamiento del clúster que es visible para todos los nodos del clúster; cada nodo tiene un cliente montado de este modo, así que este almacenamiento está disponible para cada nodo.
Para el rendimiento de cualquiera de los enfoques mencionados anteriormente, es crucial, en la etapa de planificación y despliegue, configurar correctamente la red, donde habrá equilibrio a través de la agregación y un ancho de banda del canal de red adecuado. En la agregación, es importante seleccionar correctamente el modo de hash y los tamaños de tramas. También hay una diferencia significativa con los SDS mencionados anteriormente, que es el fuse con tecnología de fast path en Virtuozzo Storage. Este, además del fuse modernizado al contrario de las demás soluciones de código abierto, incrementa significativamente los IOPS y permite no limitarse al escalado horizontal o vertical. En general, en comparación con las arquitecturas mencionadas, esta resulta más poderosa, pero por este privilegio, por supuesto, es necesario adquirir licencias a diferencia de Ceph y Gluster.
Resumiendo, se puede destacar un ranking de tres: el primer lugar en términos de rendimiento y fiabilidad de la arquitectura lo ocupa Virtuozzo Storage, en segundo lugar Ceph y en tercero Gluster.
Los criterios por los cuales se eligió Virtuozzo Storage son: un conjunto óptimo de componentes de arquitectura, el Fuse modernizado adaptado a este enfoque con fast path, un conjunto flexible de configuraciones de hardware, menor consumo de recursos y la posibilidad de uso conjunto con compute (cálculos/virtualización), es decir, se adapta completamente a una solución hiperconvergente, de la cual forma parte. El segundo lugar es para Ceph, porque es una arquitectura más eficiente que Gluster, debido a la operación con bloques, así como a escenarios más flexibles y la posibilidad de funcionar en clústeres más grandes.
En los planes hay el deseo de escribir una comparación entre vSAN, Space Direct Storage, Vstorage y Nutanix Storage, probar Vstorage en equipos de HPE, Huawei, así como escenarios de integración de Vstorage con sistemas de almacenamiento externo, por lo que si te gustó el artículo, sería bueno recibir tus comentarios, que podrían aumentar la motivación para nuevos artículos teniendo en cuenta tus observaciones y deseos.
Fuente: habr.com
