

Hola, Habr.
Me llamo Misha Butrimov y me gustaría hablar un poco sobre Cassandra. Mi relato será útil para aquellos que nunca han utilizado bases de datos NoSQL, ya que tiene muchas características de implementación y trampas bajo las cuales deben estar informados. Y si solo han visto Oracle u otra base de datos relacional, estas cosas les salvarán la vida.
¿Qué hace a Cassandra tan buena? Es una base de datos NoSQL diseñada sin un único punto de fallo que se escala bien. Si necesitas agregar unos terabytes a una base de datos, simplemente añades nodos al anillo. ¿Quieres ampliar a otro centro de datos? Añades nodos al clúster. ¿Quieres aumentar el RPS procesado? Añades nodos al clúster. También funciona en la dirección opuesta.
¿Qué más la hace buena? Su capacidad para procesar muchas solicitudes. Pero, ¿cuánto es 'mucho'? 10, 20, 30, 40 mil solicitudes por segundo no es mucho. 100 mil solicitudes por segundo para escritura tampoco es mucho. Hay empresas que afirman manejar 2 millones de solicitudes por segundo. A ellas, probablemente, deberíamos creer.
Y en principio, Cassandra tiene una gran diferencia respecto a los datos relacionales: no se parece en nada a ellos. Y es muy importante recordar esto.
No todo lo que parece igual funciona igual.
Una vez, un colega se acercó y preguntó: "Aquí está el lenguaje de consulta SQL de Cassandra, tiene instrucciones select, hay un where, hay un and. Estoy escribiendo letras y no funciona. ¿Por qué?". Si se considera a Cassandra como una base de datos relacional, esa es la manera perfecta de terminar tu vida de manera cruel y violenta. Y no estoy promoviendo eso, está prohibido en Rusia. Simplemente diseñarás algo incorrectamente.
Por ejemplo, llega un cliente y dice: "Construyamos una base de datos para series, o una base de datos para un recetario. Tendremos platos con ingredientes o una lista de series y actores en ella". Respondemos alegremente: "¡Vamos!". Son solo dos bytes para transmitir, un par de tablas y todo listo, funcionará muy rápido y de manera fiable. Todo es perfecto, hasta que los clientes llegan y dicen que las amas de casa también están resolviendo la tarea inversa: tienen una lista de ingredientes y quieren saber qué plato desean cocinar. Estás muerto.
Todo porque Cassandra es una base de datos híbrida: es tanto key value como almacena datos en columnas anchas. Si hablamos en términos de Java o Kotlin, se podría describir así:
Map<RowKey, SortedMap>
Es decir, un mapa dentro del cual hay otro mapa ordenado. La primera clave de este mapa es la Row key o Partition key — clave de partición. La segunda clave, que es la clave del mapa ya ordenado, es la Clustering key.
Para ilustrar la distribución de la base de datos, dibujemos tres nodos. Ahora hay que entender cómo repartir los datos entre los nodos. Porque si los metemos todos en uno (y puede haber miles, dos mil, cinco — los que sean), eso no es realmente distribución. Por lo tanto, necesitamos una función matemática que devuelva un número. Simplemente un número, un int largo, que caerá en algún rango. Y un nodo será responsable de un rango, el segundo de otro, el n-ésimo de otro.
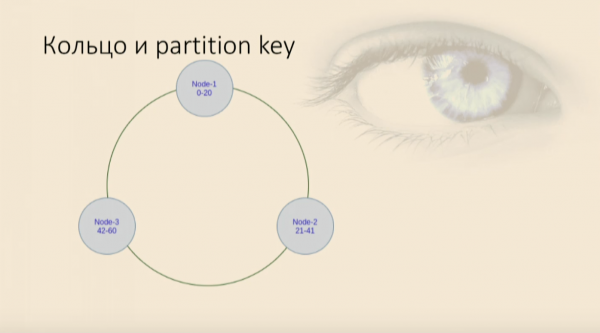
Este número se obtiene mediante una función hash que se aplica precisamente a lo que llamamos Partition key. Esta es la columna que se indica en la directiva Primary key, y es la columna que será la primera y principal clave del mapa. Define a qué nodo se asignarán qué datos. La tabla se crea en Cassandra casi con una sintaxis similar a SQL:
CREATE TABLE users (
	user_id UUID,
	name text,
	year int,
	salary float,
	PRIMARY KEY(user_id)

)
La clave primaria en este caso consiste en una sola columna, que también es la clave de partición.
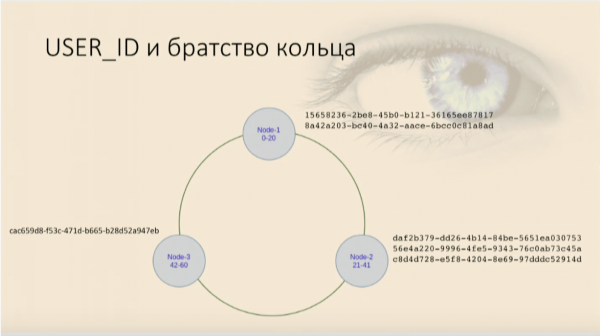
¿Cómo se distribuirán los usuarios? Parte irá a un nodo, parte a otro y parte a un tercero. Se convierte en una simple tabla hash, también un mapa, también un diccionario en Python, también una simple estructura Key value, de la que podemos leer todos los valores, leer y escribir por clave.
Select: cuando allow filtering se convierte en un full scan, o cómo no se debe hacer
Escribamos alguna declaración select: select * from users where userid = . Es como en Oracle: escribimos select, especificamos las condiciones y todo funciona, se extraen los usuarios. Pero si seleccionamos, por ejemplo, un usuario con un año de nacimiento específico, Cassandra se queja de que no puede ejecutar la consulta. Porque en realidad no sabe nada sobre cómo se distribuyen nuestros datos de año de nacimiento; solo tiene una columna como clave. Entonces dice: “Está bien, aún puedo ejecutar esta consulta. Añade allow filtering”. Añadimos la directiva, todo funciona. Y en ese momento, ocurre algo terrible.
Cuando probamos con datos de prueba, todo está perfecto. Pero cuando ejecutas la consulta en producción, donde tenemos, por ejemplo, 4 millones de registros, las cosas no van tan bien. Porque allow filtering es una directiva que permite a Cassandra recopilar todos los datos de esta tabla de todos los nodos, todos de centros de datos (si hay muchos en este clúster), y solo luego filtrar. Esto es análogo a un Full Scan, y es poco probable que a alguien le entusiasme.
Si solo necesitáramos usuarios por identificadores, eso nos bastaría. Pero a veces necesitamos escribir otras consultas y aplicar otras restricciones a la selección. Por lo tanto, recordamos: esto es un mapa, que tiene una clave de partición, pero dentro de él hay un mapa ordenado.
Y también tiene una clave, que llamamos Clustering Key. Esta clave, que a su vez, consiste en columnas que elegimos, permite que Cassandra comprenda cómo se ordenarán y almacenarán físicamente los datos en cada nodo. Es decir, para una clave de partición, la Clustering Key indicará cómo insertar realmente los datos en este árbol, en qué lugar estarán.
Es realmente un árbol, simplemente se llama a un comparador, al que le pasamos un conjunto de columnas en forma de objeto, y también se define como enumeración de columnas.
CREATE TABLE users_by_year_salary_id (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY((year), salary, user_id)
Presta atención a la directiva Primary key, cuyo primer argumento (en nuestro caso el año) siempre es la Partition key. Puede constar de una o varias columnas, eso no importa. Si hay varias columnas, debe encerrarse nuevamente entre paréntesis para que el preprocesador del lenguaje entienda que es específicamente la Primary key, y que detrás de ella vienen todas las demás columnas: Clustering key. De este modo, se transmitirán en el comparador en el orden en que se presentan. Es decir, la primera columna es más significativa, la segunda es menos significativa, y así sucesivamente. Como escribimos para las clases de datos, por ejemplo, en los campos equals: enumeramos los campos y especificamos cuáles son más importantes y cuáles menos. En Cassandra, esto son, en cierta forma, los campos de la data class a la que se aplicará el equals escrito para ella.
Establecemos el orden, imponemos restricciones
Hay que recordar que el orden de clasificación (descendente, ascendente, no importa) se establece en el mismo momento en que se crea la clave, y luego no se podrá cambiar. Define físicamente cómo se ordenarán los datos y cómo se almacenarán. Si se necesita cambiar el Clustering key o el orden de clasificación, será necesario crear una nueva tabla y transferir los datos a ella. No se podrá hacer eso con una que ya existe.
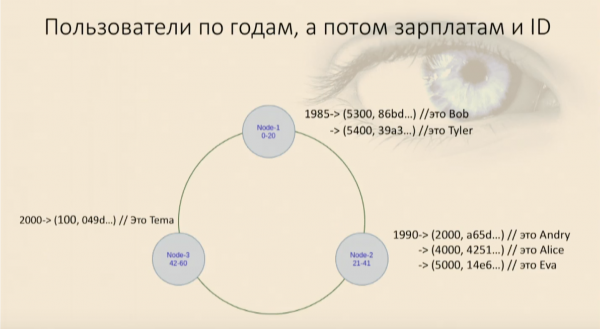
Hemos llenado nuestra tabla con usuarios y hemos visto que se organizaron en un anillo primero por el año de nacimiento, y luego dentro de cada nodo por el salario y el ID de usuario. Ahora podemos seleccionar, imponiendo restricciones.
Vuelve a aparecer nuestro trabajando donde, y, y los usuarios nos son entregados, y todo está bien nuevamente. Pero si intentamos usar solo una parte del Clustering key, específicamente la menos significativa, Cassandra inmediatamente dará error, diciendo que no puede encontrar en nuestro mapa el lugar donde está este objeto, cuyos campos para el comparador son null, y dónde está este que acabamos de establecer. Tendré que volver a cargar todos los datos de este nodo y filtrarlos. Y eso es análogo a un Full Scan dentro del nodo, lo cual es malo.
Ante cualquier situación confusa, crea una nueva tabla
Si queremos poder recuperar usuarios por ID, edad o salario, ¿qué debemos hacer? Nada. Simplemente usamos dos tablas. Si necesitamos extraer usuarios de tres maneras diferentes, habrá tres tablas. Han pasado los días en que ahorrábamos espacio en el disco. Este es el recurso más barato. Cuesta mucho menos que el tiempo de respuesta, que puede ser devastador para el usuario. Al usuario le resulta mucho más agradable recibir algo en un segundo que en diez minutos.
Intercambiamos el espacio adicional ocupado, datos desnormalizados, por la capacidad de escalar bien y funcionar de manera confiable. De hecho, un clúster que consiste en tres centros de datos, cada uno con cinco nodos, con un nivel aceptable de conservación de datos (cuando no se pierde nada), puede sobrevivir a la pérdida total de un centro de datos. Y aún quedan dos nodos en cada uno de los dos restantes. Solo después de eso comenzarán los problemas. Es un buen tipo de reserva, que cuesta un par o tres de SSD y procesadores adicionales. Por lo tanto, para usar Cassandra, que no es SQL, en la que no hay relaciones ni claves externas, es necesario conocer reglas simples.
Diseñamos todo a partir de la consulta. Lo más importante no son los datos, sino cómo la aplicación va a trabajar con ellos. Si necesita obtener diferentes datos de diferentes maneras o los mismos datos de diferentes maneras, debemos organizarlos de tal manera que sea conveniente para la aplicación. De lo contrario, caeremos en un escaneo completo y Cassandra no nos dará ninguna ventaja.
Desnormalizar los datos es lo estándar. Olvidamos las formas normales, ya no tenemos bases de datos relacionales. Colocamos algo 100 veces, estará almacenado 100 veces. Esto sigue siendo más barato que ralentizar el sistema.
Seleccionamos claves para el particionamiento de manera que se distribuyan adecuadamente. No necesitamos que el hash de nuestras claves caiga en un rango estrecho. Es decir, el año de nacimiento en el ejemplo anterior es un mal ejemplo. Más bien, es bueno si nuestros usuarios están distribuidos de manera uniforme por año de nacimiento, y es malo si se trata de estudiantes de quinto grado, donde la partición no funcionará bien.
La ordenación se elige una vez en la etapa de creación de la Clave de Clustering. Si es necesario cambiarla, tendremos que volcar nuestra tabla con otra clave.
Y lo más importante: si necesitamos obtener los mismos datos de 100 maneras diferentes, eso significa que tendremos 100 tablas diferentes.
Fuente: habr.com
