

Este artículo está dedicado a Python Gateway, un proyecto comunitario de código abierto para la plataforma de datos InterSystems IRIS. Este proyecto permite orquestar cualquier algoritmo de aprendizaje automático creado en Python (el entorno principal para muchos científicos de datos), utilizando numerosas bibliotecas listas para crear rápidamente soluciones analíticas adaptativas y automatizadas de IA/ML en la plataforma InterSystems IRIS. En este artículo, mostraré cómo InterSystems IRIS puede orquestar procesos en Python, realizar de manera efectiva la transferencia bidireccional de datos y crear procesos de negocio inteligentes.
Plan
- Introducción.
- Herramientas.
- Instalación.
- API.
- Interoperabilidad.
- Jupyter Notebook.
- Conclusiones.
- Enlaces.
- MLToolkit.
Introducción
Python es un lenguaje de programación de alto nivel de propósito general, orientado a mejorar la productividad del desarrollador y la legibilidad del código. En esta serie de artículos, hablaré sobre las posibilidades de aplicar Python en la plataforma InterSystems IRIS, centrándome en su uso como lenguaje para crear y aplicar modelos de aprendizaje automático.
El aprendizaje automático (ML) es una clase de métodos de inteligencia artificial que se caracterizan por no resolver directamente el problema, sino aprender durante la resolución de múltiples problemas similares.
Los algoritmos y modelos de aprendizaje automático están cada vez más presentes. Hay muchas razones para ello, pero todo se reduce a la accesibilidad, simplicidad y logro de resultados prácticos. ¿Es la clustering o incluso la modelización de redes neuronales una nueva tecnología?
Por supuesto que no, pero actualmente no es necesario escribir cientos de miles de líneas de código para ejecutar un modelo, y los costos de creación y aplicación de modelos están disminuyendo cada vez más.
Las herramientas están evolucionando; aunque no tenemos herramientas de IA/ML totalmente orientadas a GUI, el progreso que hemos visto con muchas otras clases de sistemas de información, como BI (desde la codificación hasta el uso de marcos y soluciones configurables orientadas a GUI), también se está observando en las herramientas para crear IA/ML. Ya hemos superado la etapa de codificación y hoy en día utilizamos marcos para construir y entrenar modelos.
Otras mejoras, como la capacidad de difundir un modelo preentrenado, donde el usuario final solo tiene que completar el entrenamiento del modelo con sus datos específicos, también facilitan el inicio en la aplicación del aprendizaje automático. Estos avances simplifican significativamente el aprendizaje del aprendizaje automático tanto para especialistas como para empresas en general.
Por otro lado, estamos recopilando cada vez más datos. Gracias a una plataforma de datos unificada, como InterSystems IRIS, toda esta información puede ser preparada y utilizada de inmediato como datos de entrada para modelos de aprendizaje automático.
Con la transición a la nube, lanzar proyectos de IA/ML se vuelve más fácil que nunca. Solo podemos consumir los recursos que necesitamos. Además, gracias a la paralelización que ofrecen las plataformas en la nube, podemos ahorrar tiempo.
¿Pero qué pasa con los resultados? Aquí es donde las cosas se complican. Existen múltiples herramientas para construir modelos, de las cuales hablaré a continuación. Construir un buen modelo no es fácil, ¿pero qué sigue? Obtener beneficios de un modelo que utiliza el negocio también es una tarea no trivial. La raíz del problema radica en la separación de las cargas analíticas y transaccionales, así como de los modelos de datos. Cuando entrenamos un modelo, generalmente lo hacemos con datos históricos. Pero el lugar para el modelo construido es en el procesamiento transaccional de datos. ¿De qué sirve el mejor modelo de detección de transacciones fraudulentas si lo ejecutamos una vez al día? Los estafadores ya se han ido con el dinero. Necesitamos entrenar el modelo con datos históricos, pero también debemos aplicarlo en tiempo real a los nuevos datos entrantes para que nuestros procesos comerciales puedan actuar de acuerdo con las predicciones realizadas por el modelo.
ML Toolkit es un conjunto de herramientas cuyo objetivo es precisamente esto: combinar modelos y entornos transaccionales, para que los modelos construidos puedan ser fácilmente utilizados directamente en sus procesos comerciales. Python Gateway es parte de ML Toolkit y permite la integración con el lenguaje Python (de manera similar a como R Gateway, que forma parte de ML Toolkit, proporciona integración con el lenguaje R).
Herramientas
Antes de continuar, me gustaría describir algunas herramientas y bibliotecas de Python que utilizaremos más adelante.
Tecnologías
- Python es un lenguaje de programación interpretado, de alto nivel y de propósito general. La principal ventaja del lenguaje es su gran biblioteca de bibliotecas matemáticas, de aprendizaje automático (ML) y de inteligencia artificial (AI). Al igual que ObjectScript, es un lenguaje orientado a objetos, pero todo se define dinámicamente, no estáticamente. Además, todo es un objeto. Los artículos posteriores suponen un conocimiento pasajero del lenguaje. Si deseas comenzar a aprender, te recomiendo empezar con .
- Para nuestros ejercicios posteriores, instala .
- IDE: Yo uso , pero en general hay otros. . Si utilizas Atelier, hay un complemento de Eclipse para desarrolladores de Python. Si usas VS Code, hay una extensión para Python.
- Notebook: en lugar de un IDE, puedes escribir y compartir tus scripts en cuadernos en línea. El más popular de ellos es .
Bibliotecas
Aquí hay una lista (no exhaustiva) de bibliotecas para aprendizaje automático:
- — paquete fundamental para cálculos precisos.
- — estructuras de datos de alto rendimiento y herramientas de análisis de datos.
- — creación de gráficos.
- — visualización de datos basada en matplotlib.
- — métodos de aprendizaje automático.
- — algoritmos de aprendizaje automático dentro de la metodología de refuerzo de gradiente (Gradient Boosting).
- — procesamiento de lenguaje natural (NLP).
- — redes neuronales.
- — plataforma para construir modelos de aprendizaje automático.
- — plataforma para construir modelos de aprendizaje automático orientada a Python.
- — PMML de varios modelos.
Las tecnologías AI/ML permiten que las empresas sean más eficientes y adaptables. Además, hoy en día estas tecnologías se están volviendo más fáciles de desarrollar e implementar. Comienza a estudiar las tecnologías AI/ML y cómo pueden ayudar a tu organización a crecer.
Instalación
Hay varias maneras de instalar y usar Python Gateway:
- el sistema operativo
- Windows
- Linux
- Mac
- Docker
- Usa una imagen de DockerHub
- Crea tu propia imagen
Independientemente de la forma de instalación, necesitarás el código fuente. El único lugar para descargar el código es . Contiene lanzamientos estables probados, simplemente toma el último. En este momento es 0.8, pero con el tiempo habrá nuevos. No clones/subas el repositorio, descarga la última versión.
el sistema operativo
Si está instalando el Gateway de Python en un sistema operativo, primero (independientemente del sistema operativo) debe instalar Python. Para ello:
- . Se recomienda instalar Python en el directorio predeterminado.
- Instale el módulo
dill:pip install dill. - Descargue el código ObjectScript (es decir,
do $system.OBJ.ImportDir("C:InterSystemsReposPythoniscpy", "*.cls", "c",,1)) en cualquier espacio de nombres con productos. Si desea que un espacio existente admita productos, ejecute:write ##class(%EnsembleMgr).EnableNamespace($Namespace, 1). - Coloque a la carpeta
binde su instancia InterSystems IRIS. El archivo de la biblioteca debe ser accesible en la ruta devuelta porwrite ##class(isc.py.Callout).GetLib().
Windows
- Asegúrese de que la variable de entorno
PYTHONHOMEapunte a Python 3.6.7. - Asegúrese de que la variable de entorno del sistema
PATHcontenga la variablePYTHONHOME(o el directorio al que apunta).
Linux (Debian/Ubuntu)
- Verifique que la variable de entorno
PATHcontiene/usr/liby/usr/lib/x86_64-linux-gnu. Utilice el archivo/etc/environmentpara establecer las variables de entorno. - Si hay errores
símbolo indefinido: _Py_TrueStructconfigure la opciónPythonLib. También en hay una sección de resolución de problemas.
Mac
- Actualmente solo se admite Python 3.6.7 de . Verifique la variable
PATH.
Si ha cambiado las variables de entorno, reinicie su producto InterSystems.
Docker
El uso de contenedores ofrece varias ventajas:
- Portabilidad
- Eficiencia
- ⚠️ Limitado
- Ligereza
- Inmutabilidad
Consulte esta para obtener más información sobre el uso de Docker con los productos de InterSystems.
Todas las compilaciones del Gateway de Python actualmente se basan en contenedores 2019.4.
Imagen lista
Ejecuta: docker run -d -p 52773:52773 --name irispy intersystemscommunity/irispy-community:latest, para descargar y ejecutar el Gateway de Python con la Edición de Comunidad de InterSystems IRIS. Eso es todo.
Crea tu propia imagen
Para construir la imagen de Docker, ejecute en la raíz del repositorio: docker build --force-rm --tag intersystemscommunity/irispy:latest ..
Por defecto, la imagen se construye sobre la imagen store/intersystems/iris-community:2019.4.0.383.0, sin embargo, puede cambiar esto configurando la variable IMAGE.
Para construir desde InterSystems IRIS, ejecute: `docker build —build-arg IMAGE=store/intersystems/iris:2019.4.0.383.0 —force-rm —tag intersystemscommunity/irispy:latest`.
Después de eso, puede ejecutar la imagen de Docker:
docker run -d
  -p 52773:52773
  -v //:/mount
  --name irispy
  intersystemscommunity/irispy:latest
  --key /mount/iris.key
Si utiliza una imagen basada en la Edición de Comunidad de InterSystems IRIS, puede omitir la clave.
Comentarios
- Proceso de prueba
isc.py.test.Processalmacena una serie de imágenes en un directorio temporal. Es posible que desee cambiar esta ruta a un directorio montado. Para ello, edite la configuraciónWorkingDirespecificando el directorio montado. - Para acceder al terminal, ejecute:
docker exec -it irispy sh. - Acceso al Portal de Gestión del Sistema con el inicio de sesión
SuperUser/SYS. - Para detener el contenedor, ejecute:
docker stop irispy && docker rm --force irispy.
Comprobación de la instalación
Después de haber instalado el Python Gateway, debe verificar que funciona. Ejecute este código en el terminal de InterSystems IRIS:
set sc = ##class(isc.py.Callout).Setup()
set sc = ##class(isc.py.Main).SimpleString("x='HELLO'", "x", , .var).
write var
Como resultado, debe imprimirse HELLO — el valor de la variable de Python x. Si el estado devuelto sc es un error o var está vacío, verifique .
API
Python Gateway está instalado y se ha asegurado de que funcione. ¡Es hora de comenzar a usarlo!
La interfaz principal para Python es isc.py.Main. Ofrece los siguientes grupos de métodos (todos devuelven %Status):
- Ejecución de código
- Transmisión de datos
- Auxiliares
Ejecución de código
Estos métodos permiten ejecutar código Python arbitrario.
SimpleString
SimpleString — es el método principal. Acepta 4 argumentos opcionales:
code— cadena de código a ejecutar. El carácter de nueva línea:$c(10).returnVariable— nombre de la variable para devolver.serialization— cómo serializarreturnVariable. 0 — string (predeterminado), 1 — repr.resultado— ByRef referencia a la variable donde se escribe el valorreturnVariable.
Anteriormente, hemos ejecutado:
set sc = ##class(isc.py.Main).SimpleString("x='HELLO'", "x", , .var).En este ejemplo, asignamos a una variable de Python x valor Hola y queremos devolver el valor de la variable de Python x a una variable de ObjectScript var.
ExecuteCode
ExecuteCode es una alternativa más segura y menos restringida SimpleString.
Las cadenas en la plataforma InterSystems IRIS están limitadas a 3,641,144 caracteres, y si desea ejecutar un bloque de código más largo, debe utilizar flujos.
Se aceptan dos argumentos:
code— cadena o flujo de código Python para ejecutar.variable— (opcional) asigna el resultado de la ejecucióncodea esta variable de Python.
Ejemplo de uso:
set sc = ##class(isc.py.Main).ExecuteCode("2*3", "y").En este ejemplo, multiplicamos 2 por 3 y guardamos el resultado en una variable de Python y.
Transmisión de datos
Transfiera datos entre Python y de vuelta.
Python -> InterSystems IRIS
Hay 4 maneras de obtener el valor de la variable de Python en InterSystems IRIS, dependiendo de la serialización que necesite:
Stringpara tipos de datos simples y depuración.Reprpara el almacenamiento de objetos simples y la depuración.JSONpara la manipulación fácil de datos en el lado de InterSystems IRIS.Picklepara guardar objetos.
Estos métodos permiten obtener variables de Python en forma de cadenas o flujos.
GetVariable(variable, serialization, .stream, useString)— obtenerserializationvariablevariableenstream. SiuseStringigual a 1 y si la serialización se coloca en una cadena, se devuelve una cadena en lugar de un flujo.GetVariableJson(variable, .stream, useString)— obtener la serialización JSON de la variable.GetVariablePickle(variable, .stream, useString, useDill)— obtener la serialización Pickle (o Dill) de la variable.
Intentemos obtener nuestra variable y.
set sc = ##class(isc.py.Main).GetVariable("y", , .val, 1)
write val
>6
InterSystems IRIS -> Python
Cargamos datos de InterSystems IRIS en Python.
ExecuteQuery(query, variable, type, namespace)— crea un conjunto de datos (pandasdataframeolist) desde una consulta SQL y lo establece en una variable de Pythonvariable. El paqueteisc.pydebe estar disponible en el ámbitonamespace— donde se ejecutará la consulta.ExecuteGlobal(global, variable, type, start, end, mask, labels, namespace)— carga datos globalesglobaldel subíndicestarthastaenden Python como una variable de tipotipo:list, o pandasdataframe. La descripción de los argumentos opcionalesmaskylabelsestá disponible en la documentación de la clase y el repositorio .ExecuteClass(class, variable, type, start, end, properties, namespace)— carga datos de la claseclasspor idstarthastaenden Python como una variable de tipotipo:list, o pandasdataframe.properties— lista (separador – coma) de propiedades de la clase que se deben cargar en el conjunto de datos. Se admiten máscaras*y?. Por defecto —*(todas las propiedades). La propiedad%%CLASSNAMEse ignora.ExecuteTable(table, variable, type, start, end, properties, namespace)— carga datos de la tablatablapor idstarthastaenden Python.
ExecuteQuery — es universal (cualquier consulta SQL válida se pasará a Python). Sin embargo, ExecuteGlobal y sus envolturas ExecuteClass y ExecuteTable funcionan con varias limitaciones. Son mucho más rápidos (3-5 veces más rápidos que el controlador ODBC y 20 veces más rápidos ExecuteQuery). Más información en .
Todos estos métodos admiten la transferencia de datos desde cualquier ámbito. El paquete isc.py debe estar disponible en el ámbito de destino.
ExecuteQuery
ExecuteQuery(request, variable, type, namespace) — paso de los resultados de cualquier consulta SQL válida a Python. Este es el método más lento de transferencia de datos. Utilízalo si ExecuteGlobal y sus envolturas no están disponibles.
Argumentos:
query— consulta SQL.variable— nombre de la variable de Python en la que se escriben los datos.tipo—listo Pandasdataframe.namespace— ámbito en el que se ejecutará la consulta.
ExecuteGlobal
ExecuteGlobal(global, variable, type, start, end, mask, labels, namespace) — paso de un global a Python.
Argumentos:
global— nombre del global sin^variable— nombre de la variable de Python en la que se escriben los datos.tipo—listo Pandasdataframe.start— primer subíndice del global. Obligatorio%Integer.end— último subíndice del global. Obligatorio%Integer.mask— máscara de valores global. La máscara puede ser más corta que la cantidad de campos en el global (en este caso, los campos al final se omitirán). Cómo formatear la máscara:+transmitir el valor tal cual.-omitir el valor.b— Tipo lógico (0—False, todo lo demás —Verdadero).d— Fecha (desde $horolog, en Windows desde 1970, en Linux desde 1900).t— Hora ($horolog, segundos después de medianoche).m— Marca de tiempo (string en formato AÑO-MES-DÍA HORA:MINUTO:SEGUNDO).
labels— %Lista de nombres de columnas. El primer elemento — nombre del subscript.namespace— ámbito en el que se ejecutará la consulta.
ExecuteClass
Envoltorio sobre ExecuteGlobal. Basado en la definición de la clase, prepara la llamada ExecuteGlobal y la ejecuta.
ExecuteClass(class, variable, type, start, end, properties, namespace) — transmisión de datos de clase en Python.
Argumentos:
class— nombre de la clasevariable— nombre de la variable de Python en la que se escriben los datos.tipo—listo Pandasdataframe.start— Id inicial.end— Id finalproperties— lista (separador – coma) de propiedades de la clase que se deben cargar en el conjunto de datos. Se admiten máscaras*y?. Por defecto —*(todas las propiedades). La propiedad%%CLASSNAMEse ignora.namespace— ámbito en el que se ejecutará la consulta.
Todas las propiedades se transmiten tal cual, excepto las propiedades de tipos cha, %Hora, %Booleano y %Marca de tiempo — se convierten a las clases correspondientes de Python.
ExecuteTable
Envoltorio sobre ExecuteClass. Transmite el nombre de la tabla al nombre de clase y ejecuta ExecuteClass. Firma:
ExecuteTable(table, variable, type, start, end, properties, namespace) — transmisión de datos de tabla en Python.
Argumentos:
tabla— nombre de la tabla.
Todos los demás argumentos se transmiten tal cual aExecuteClass.
Notas
ExecuteGlobal,ExecuteClassyExecuteTablefuncionan a la misma velocidad.ExecuteGlobal20 veces más rápido queExecuteQueryen conjuntos de datos grandes (tiempo de transmisión >0.01 segundos).ExecuteGlobal,ExecuteClassyExecuteTablefuncionan en globals con esta estructura:^global(key) = $lb(prop1, prop2, ..., propN)dondekey— número entero.- Para
ExecuteGlobal,ExecuteClassyExecuteTablerango de valores soportadochacorresponde al rangomktimey depende del SO (: 1970-01-01, 1900-01-01, ). Use%Marca de tiempopara transmitir datos fuera de este rango o use pandas dataframe ya que esta restricción es solo para la lista. - Para
ExecuteGlobal,ExecuteClassyExecuteTabletodos los argumentos excepto la fuente de datos (global, clase o tabla) y la variable son opcionales.
Ejemplos
Clase de prueba contiene un método que muestra todas las opciones de transmisión de datos:
set global = "isc.py.test.PersonD"
set class = "isc.py.test.Person"
set table = "isc_py_test.Person"
set query = "SELECT * FROM isc_py_test.Person"

// Argumentos generales
set variable = "df"
set type = "dataframe"
set start = 1
set end = $g(^isc.py.test.PersonD, start)

// Método 0: ExecuteGlobal sin argumentos
set sc = ##class(isc.py.Main).ExecuteGlobal(global, variable _ 0, type)

// Método 1: ExecuteGlobal con argumentos
// Al pasar el global, los nombres de los campos son definidos manualmente
// globalKey - nombre del subtipo
set labels = $lb("globalKey", "Nombre", "DOB", "TS", "RandomTime", "EdadAños", "EdadDecimal", "EdadDoble", "Bool")

// mask tiene un elemento menos que labels porque "globalKey" - nombre del subtipo
// Saltamos %%CLASSNAME
set mask = "-+dmt+++b"

set sc = ##class(isc.py.Main).ExecuteGlobal(global, variable _ 1, type, start, end, mask, labels)

// Método 2: ExecuteClass
set sc = ##class(isc.py.Main).ExecuteClass(class, variable _ 2, type, start, end)

// Método 3: ExecuteTable
set sc = ##class(isc.py.Main).ExecuteTable(table, variable _ 3, type, start, end)

// Método 4: ExecuteTable
set sc = ##class(isc.py.Main).ExecuteQuery(query, variable _ 4, type)
Llama al método do ##class(isc.py.test.Person).Test() para ver cómo funcionan todos los métodos de transmisión de datos.
Métodos auxiliares
GetVariableInfo(variable, serialization, .defined, .type, .length)— obtener información sobre la variable: si está definida, su clase y la longitud de la serialización.GetVariableDefined(variable, .defined)— determina si la variable está definida.GetVariableType(variable, .type)— obtener la clase de la variable.GetStatus()— obtener y eliminar la última excepción del lado de Python.GetModuleInfo(module, .imported, .alias)— obtener la variable del módulo y el estado de importación.GetFunctionInfo(function, .defined, .type, .docs, .signature, .arguments)— obtener información sobre la función.
Interoperabilidad
Has aprendido a llamar a Python Gateway desde la terminal, ahora empecemos a usarlo en producción. La base de la interacción con Python en este modo es isc.py.ens.Operation. Permite:
- Ejecutar código en Python
- Guardar/Restaurar el contexto de Python
- Cargar y obtener datos de Python
En principio, la operación Pyhton es un envoltorio sobre isc.py.Main. La operación isc.py.ens.Operation ofrece la posibilidad de interactuar con el proceso de Python desde las producciones de InterSystems IRIS. Se admiten cinco solicitudes:
isc.py.msg.ExecutionRequestpara ejecutar código de Python. Devuelveisc.py.msg.ExecutionResponsecon el resultado de la ejecución y los valores de las variables solicitadas.isc.py.msg.StreamExecutionRequestpara ejecutar código de Python. Devuelveisc.py.msg.StreamExecutionResponsecon el resultado de la ejecución y los valores de las variables solicitadas. Análogoisc.py.msg.ExecutionRequest, pero acepta y devuelve flujos en lugar de cadenas.isc.py.msg.QueryRequestpara pasar el resultado de la ejecución de la consulta SQL. DevuelveEns.Response.isc.py.msg.GlobalRequest/isc.py.msg.ClassRequest/isc.py.msg.TableRequestpara la transmisión de datos global/clase/tabla. DevuelveEns.Response.isc.py.msg.SaveRequestpara guardar el contexto de Python. DevuelveEns.StringResponsecon el identificador de contexto.isc.py.msg.RestoreRequestpara restaurar el contexto de Python.Además,
isc.py.ens.Operationtiene dos configuraciones:Initializer— selección de la clase que implementa la interfazisc.py.init.Abstract. Puede ser utilizado para cargar funciones, módulos, clases, etc. Se ejecuta una vez al iniciar el proceso.PythonLib— (solo para Linux) si ves errores al cargar, establece su valor enlibpython3.6m.soo incluso en la ruta completa a la biblioteca de Python.
Creación de procesos de negocio
Hay dos clases disponibles que facilitan el desarrollo de procesos de negocio:
isc.py.ens.ProcessUtilspermite extraer anotaciones de las actividades con sustitución de variables.isc.py.util.BPEmulatorpermite probar fácilmente los procesos de negocio con Python. Puede ejecutar el proceso de negocio (partes en el lenguaje Python) en el proceso actual.
Sustitución de variables.
Todos los procesos de negocio que heredan de isc.py.ens.ProcessUtils, pueden utilizar el método GetAnnotation(name) para obtener el valor de la anotación de la actividad por su nombre. La anotación de la actividad puede contener variables que se calcularán en el lado de InterSystems IRIS antes de ser pasadas a Python. Aquí está la sintaxis para la sustitución de variables:
${class:method:arg1:...:argN}— llamada al método#{expr}— ejecutar código en ObjectScript.
Un ejemplo está disponible en el proceso de negocio de prueba isc.py.test.Process, por ejemplo, en la actividad Matriz de Correlación: Gráfico: f.savefig(r'#{process.WorkDirectory}SHOWCASE${%PopulateUtils:Integer:1:100}.png'). En este ejemplo:
#{process.WorkDirectory}devuelve la propiedad WorkDirectory del objetoprocesar, que es una instancia de la claseisc.py.test.Processes decir, el proceso de negocio actual.${%PopulateUtils:Integer:1:100}se llama al métodoIntegerde la clase%PopulateUtils, pasando argumentos1y100, devolviendo un número entero aleatorio en el rango1...100.
Proceso de negocio de prueba
El producto de prueba y el proceso de negocio de prueba están disponibles por defecto como parte de Python Gateway. Para usarlos:
- Ejecuta en el terminal del sistema operativo:
pip install pandas matplotlib seaborn. - Ejecuta en el terminal de InterSystems IRIS:
do ##class(isc.py.test.CannibalizationData).Import()para llenar los datos de prueba. - Ejecuta el producto
isc.py.test.Production. - Enviar una solicitud de tipo
Ens.Requestenisc.py.test.Process.
Veamos cómo funciona todo esto junto. Abre isc.py.test.Process en el editor BPL:
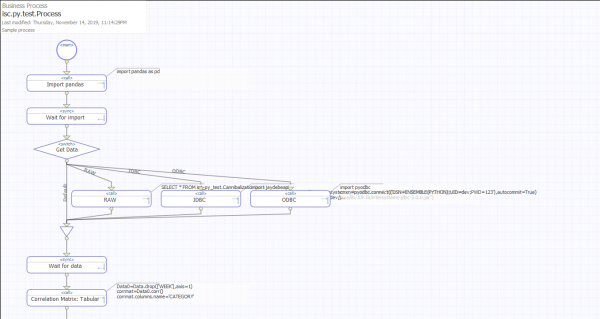
Ejecución de código
La llamada más importante es la ejecución de código Python:
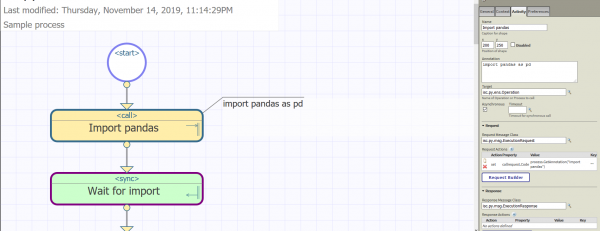
Se utiliza la solicitud isc.py.msg.ExecutionRequest, aquí están sus propiedades:
Código— código Python.SeparateLines— si dividir el código en líneas para su ejecución.$c(10)(n) se utiliza para separar líneas. Tenga en cuenta que NO se recomienda procesar el mensaje completo de una vez; esta función está destinada únicamente a la manipulación dedefy expresiones multilínea similares. Por defecto0.Variables– una lista de variables separadas por comas que se incluirán en la respuesta.Serialización– Cómo serializar las variables que queremos retornar. Opciones:Str,Repr,JSON,PickleyDill, por defectoStr.
En nuestro caso, solo estamos configurando la propiedad Código, así que todas las demás propiedades utilizan valores por defecto. La establecemos llamando a process.GetAnnotation("Import pandas"), que en tiempo de ejecución devuelve la anotación tras realizar la sustitución de variables. Al final, el código import pandas as pd se pasará a Python. GetAnnotation puede ser útil para obtener scripts de Python multilínea, pero no hay restricciones en este método para obtener el código. Se puede establecer la propiedad Código de cualquier forma que le resulte conveniente.
Obtención de variables
Otro desafío interesante utilizando isc.py.msg.ExecutionRequest — Matriz de correlación: tabular:
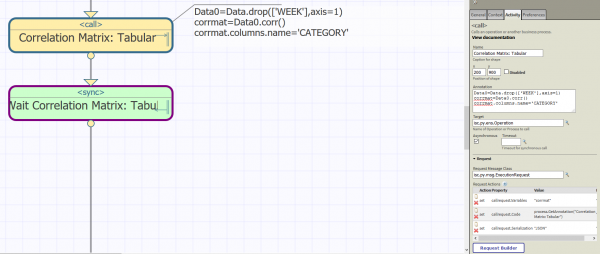
Calcula la matriz de correlación en el lado de Python y extrae la variable corrmat de vuelta a InterSystems IRIS en formato JSON, ajustando las propiedades de la solicitud:
Variables:"corrmat"Serialización:"JSON"
Podemos ver los resultados en Visual Trace:
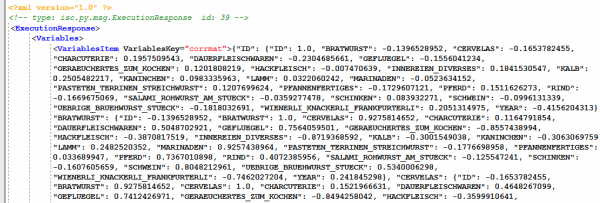
Y si necesitamos este valor en BP, se puede obtener así: callresponse.Variables.GetAt("corrmat").
Transmisión de datos
A continuación, hablemos sobre la transferencia de datos de InterSystems IRIS a Python; todas las solicitudes de transferencia de datos implementan la interfaz isc.py.msg.DataRequest, que proporciona las siguientes propiedades:
Variable– variable Python en la que se escriben los datos.Tipo– tipo de variable:dataframe(dataframe de pandas) olist.Namespace– el ámbito del que obtenemos datos. El paqueteisc.pydebe estar disponible en este ámbito. Puede ser un ámbito sin soporte para productos.
Sobre la base de esta interfaz, se han implementado 4 clases de solicitudes:
isc.py.msg.QueryRequest– establezca su propiedadQuerypara pasar la consulta SQL.isc.py.msg.ClassRequest– establezca su propiedadClasspara pasar datos de clase.isc.py.msg.TableRequest– establecer su propiedadTablepara pasar datos de tabla.isc.py.msg.GlobalRequest– establecer su propiedadGlobalpara pasar datos globales.
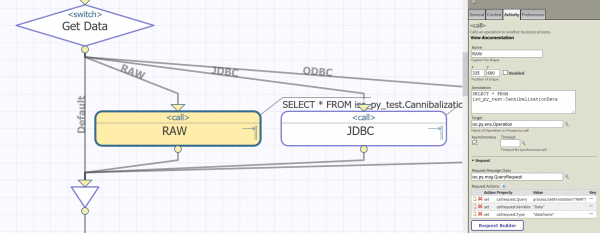
En el proceso de prueba, observe la actividad RAW, donde isc.py.msg.QueryRequest se muestra en acción.
Guardar/restaurar contexto de Python
Finalmente, podemos guardar el contexto de Python en InterSystems IRIS; para hacerlo, enviaremos isc.py.msg.SaveRequest con los argumentos:
Mask– Solo se guardan las variables que satisfacen la máscara. Se admiten*y?. Ejemplo:"Data*, Figure?". Por defecto*.MaxLength— Longitud máxima de la variable guardada. Si la serialización de la variable es más larga, será ignorada. Establezca 0 para permitir variables de cualquier longitud. Por defecto$$$MaxStringLength.Nombre— Nombre del contexto (opcional).Descripción— Descripción del contexto (opcional).
Devuelve Ens.StringResponse con Id del contexto guardado. En el proceso de prueba, observe la actividad Guardar contexto.
Solicitud correspondiente isc.py.msg.RestoreRequest carga el contexto desde InterSystems IRIS en Python:
ContextId— identificador del contexto.Limpiar— limpiar el contexto antes de restaurarlo.
Jupyter Notebook
— esta es una aplicación web de código abierto que permite crear cuadernos que contienen código, visualizaciones y texto, y publicarlos. Python Gateway permite visualizar y editar procesos BPL como un cuaderno de Jupyter. Tenga en cuenta que actualmente se utiliza un ejecutor estándar de Python 3.
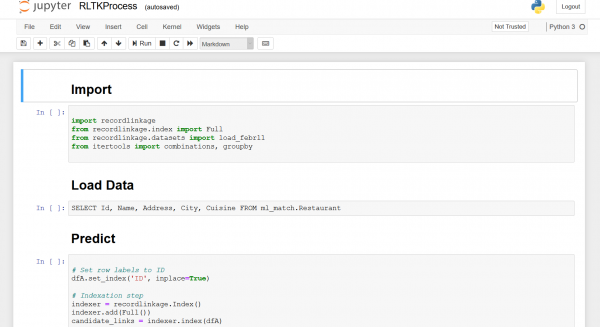
Esta extensión asume que las anotaciones contienen código Python y utilizan los nombres de las actividades como encabezados precedentes. Ahora es posible desarrollar procesos de negocio PythonGateway en un cuaderno de Jupyter. Esto es lo que es posible:
- Crear nuevos procesos de negocio
- Eliminar procesos de negocio
- Crear nuevas actividades
- Modificar actividades
- Eliminar actividades
Aquí . Y algunas capturas de pantalla:
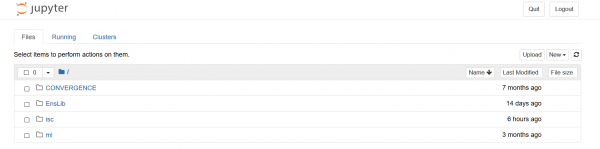
Explorador de procesos
Editor de procesos
Instalación
- Necesitará InterSystems IRIS 2019.2+.
- Instale PythonGateway v0.8+ (solo se requiere
isc.py.util.Jupyter,isc.py.util.JupyterCheckpointsyisc.py.ens.ProcessUtils). - Actualice el código ObjectScript desde el repositorio.
- Ejecuta
do ##class(isc.py.util.Jupyter).Install()y siga las instrucciones.
.
Conclusiones
MLToolkit es un conjunto de herramientas con el objetivo de integrar modelos y entornos transaccionales, para que los modelos construidos sean fácilmente utilizables directamente en sus procesos de negocio. Python Gateway es parte de MLToolkit y proporciona integración con el lenguaje Python, permitiendo orquestar cualquier algoritmo de aprendizaje automático creado en Python (el entorno principal para muchos Científicos de Datos), utilizando numerosas bibliotecas listas para crear rápidamente soluciones analíticas adaptativas y robotizadas AI/ML en la plataforma InterSystems IRIS.
Enlaces
MLToolkit
El grupo de usuarios de MLToolkit es un repositorio privado de GitHub, creado como parte de la organización corporativa de GitHub InterSystems. Está dirigido a usuarios externos que instalan, estudian o ya utilizan los componentes de MLToolkit, incluido el Python Gateway. En el grupo hay disponibles numerosos casos de uso implementados (con código fuente y datos de prueba) en áreas como marketing, producción, medicina y muchas otras industrias. Para unirte al grupo de usuarios de ML Toolkit, por favor envía un breve mensaje por correo electrónico a la siguiente dirección: y especifica en tu correo los siguientes datos:
- Nombre de usuario de GitHub
- Organización (donde trabajas o estudias)
- Cargo (tu puesto actual en tu organización, o "Estudiante", o "Freelance").
- País
A aquellos que han leído el artículo y están interesados en las capacidades de InterSystems IRIS como plataforma para el desarrollo o la implementación de mecanismos de inteligencia artificial y aprendizaje automático, les proponemos discutir posibles escenarios de interés para su empresa. Estamos dispuestos a analizar las necesidades de su negocio y definir conjuntamente un plan de acción; la dirección de correo electrónico de nuestro equipo de expertos en AI/ML es .
Fuente: habr.com
