

Prólogo
Existe en el mundo una herramienta tan simple y muy útil — , y así sucedió que se arraigó en nuestro proceso de producción desde hace mucho tiempo (aunque no pude instalar su versión, estoy seguro de que no era la más reciente). La usamos para su propósito original: crear parches binarios. Al mirar lo que hay en el repositorio, se vuelve un poco triste: en esencia, ha estado abandonado durante mucho tiempo y muchas cosas allí están bastante desactualizadas (alguna vez mi ex compañero hizo algunas correcciones, pero eso fue hace tiempo). En resumen, decidí revivirlo: hice un fork, eliminé lo que no planeo usar, y convertí el proyecto a , inlineé funciones micro 'calientes', eliminé grandes arreglos de la pila (y arreglos de longitud variable, que realmente me molestan), ejecuté el profiler una vez más — y descubrí que alrededor del 40% del tiempo se gastaba en …
¿Qué pasa con fwrite?
En este código, fwrite (en mi caso de prueba específico: crear un parche entre archivos de alrededor de 300 MB, con los datos de entrada completamente en memoria) se llama millones de veces con un buffer de pequeño tamaño. Es evidente que esta cosa va a ralentizarse, y por lo tanto quisiera influir en este desorden sin introducir diferentes fuentes de datos, ya que no tengo ganas de usar E/S asíncrono; quería encontrar una solución más sencilla. Lo primero que se me ocurrió fue aumentar el tamaño del buffer
setvbuf(file, nullptr, _IOFBF, 64 * 1024)pero no obtuve una mejora sustancial en el resultado (ahora fwrite consumía alrededor del 37% del tiempo) — así que el problema no está en la escritura frecuente de datos en el disco. Al mirar ‘bajo el capó’ de fwrite, se puede ver que dentro ocurre un lock/unlock de la estructura FILE aproximadamente así (pseudocódigo, todo el análisis se realizó en Visual Studio 2017):
size_t fwrite (const void *buffer, size_t size, size_t count, FILE *stream)
{
   size_t retval = 0;
   _lock_str(stream);   /* lock stream */
   __try
   {
      retval = _fwrite_nolock(buffer, size, count, stream);
   }
   __finally
   {
       _unlock_str(stream);   /* unlock stream */
   }
   return retval;
}
Si le creo al profiler, en _fwrite_nolock solo se gasta el 6% del tiempo, el resto es overhead. En mi caso específico, la seguridad de hilo es un exceso evidente, y me atreveré a dejarla de lado, reemplazando la llamada a fwrite por — incluso con argumentos no hay que complicarse. En resumen: esta sencilla manipulación redujo considerablemente los costos de grabación del resultado, que en la variante original representaban casi la mitad del tiempo invertido. Por cierto, en el mundo POSIX existe una función análoga — . En general, lo mismo aplica para fread. De este modo, con un par de #define se puede obtener una solución multiplataforma sin bloqueos innecesarios en caso de que no sean necesarios (lo cual sucede con bastante frecuencia).
fwrite, _fwrite_nolock, setvbuf
Abstraigámonos del proyecto original y centrémonos en probar un caso específico: escribir un gran archivo (512 MB) en porciones extremadamente pequeñas — de 1 byte. Sistema de prueba: AMD Ryzen 7 1700, 16 GB de RAM, HDD 7200 rpm con 64 MB de caché, Windows 10 1809, el binario se compila en 32 bits, optimizaciones habilitadas, la biblioteca está vinculada estáticamente.
Muestra para realizar el experimento:
#include <chrono>
#include <cstdio>
#include <inttypes.h>
#include <memory>

#ifdef _MSC_VER
#define fwrite_unlocked _fwrite_nolock
#endif

using namespace std::chrono;

int main()
{
    std::unique_ptr<FILE, int(*)(FILE*)> file(fopen("test.bin", "wb"), fclose);
    if (!file)
        return 1;

    constexpr size_t TEST_BUFFER_SIZE = 256 * 1024;
    if (setvbuf(file.get(), nullptr, _IOFBF, TEST_BUFFER_SIZE) != 0)
        return 2;

    auto start = steady_clock::now();
    const uint8_t b = 77;
    constexpr size_t TEST_FILE_SIZE = 512 * 1024 * 1024;
    for (size_t i = 0; i < TEST_FILE_SIZE; ++i)
        fwrite_unlocked(&b, 1, sizeof(b), file.get());

    auto end = steady_clock::now();
    auto interval = duration_cast<microseconds>(end - start);
    printf("Time: %lldn", interval.count());

    return 0;
}
Las variables serán TEST_BUFFER_SIZE, y en un par de casos sustituiremos fwrite_unlocked por fwrite. Comencemos con el caso fwrite sin establecer explícitamente el tamaño del búfer (comentaremos setvbuf y el código relacionado): tiempo 27048906 µs, velocidad de escritura — 18.93 MB/s. Ahora establezcamos el tamaño del búfer en 64 KB: tiempo — 25037111 µs, velocidad — 20.44 MB/s. Ahora probemos el funcionamiento de _fwrite_nolock sin llamar a setvbuf: 7262221 µs, velocidad — 70.5 MB/s!
A continuación, experimentaremos con el tamaño del búfer (setvbuf):
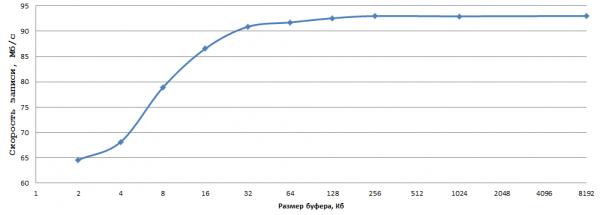
Los datos se obtuvieron promediando 5 experimentos, no me molesté en calcular las desviaciones. En mi opinión, 93 MB/s al escribir de 1 byte en un HDD normal — es un resultado muy bueno, sólo se necesita elegir el tamaño óptimo del búfer (en mi caso 256 KB — es ideal) y reemplazar fwrite por _fwrite_nolock/fwrite_unlocked (en caso de que no se necesite la seguridad de hilo, por supuesto).
Lo mismo con fread en condiciones similares. Como no tengo una máquina física con Linux a mano (las de una sola placa no cuentan), decidí realizar un experimento limitado en una máquina virtual (Hyper-V, OpenSUSE 15, GCC 8.3.1) — la tendencia, en principio, es la misma: fwrite 'desnudo' 20 MB/s, fwrite + búfer de 256 KB dio 23 MB/s, fwrite_unlocked con el mismo búfer — 35 MB/s (binario de 64 bits, se compiló g++ -o2 -s -static-libgcc -static-libstdc++ fwrite_test.cpp -o fwrite_test).
Póscrito
El objetivo de este artículo era describir un método simple y eficaz en muchos casos (no había encontrado antes las funciones _fwrite_nolock/fwrite_unlocked, que no son muy populares, y eso es una pena). No pretendo ser original en el material, pero espero que el artículo sea útil para la comunidad.
Fuente: habr.com
