

Entonces, estás recopilando métricas. Al igual que nosotros. También recopilamos métricas. Por supuesto, las necesarias para el negocio. Hoy hablaremos sobre el primer eslabón del sistema de monitoreo: un servidor de agregación compatible con statsd. , por qué lo escribimos y por qué abandonamos brubeck.
De nuestros artículos anteriores (, ) se puede saber que hasta hace algún tiempo, recopilábamos etiquetas utilizando . Está escrito en C. Desde el punto de vista del código, es tan simple como un tapón (lo cual es importante cuando quieres contribuir) y, lo más importante, maneja nuestros volúmenes de 2 millones de métricas por segundo (MPS) en pico sin problemas. La documentación afirma soportar 4 millones de MPS con asterisco. Esto significa que la cifra anunciada se obtendrá si configuras correctamente la red en Linux. (No sabemos cuántos MPS se pueden obtener si dejas la red como está). A pesar de estas ventajas, tuvimos varias quejas serias sobre brubeck.
Queja 1. Github, el desarrollador del proyecto, ha dejado de mantenerlo: de publicar parches y arreglos, aceptar nuestros y (no solo nuestros) PR. En los últimos meses (desde febrero-marzo de 2018) la actividad ha vuelto, pero antes de eso hubo casi 2 años de completo silencio. Además, el proyecto está desarrollado , lo que puede convertirse en un serio obstáculo para implementar nuevas funcionalidades.
Queja 2. Precisión de los cálculos. Brubeck solo recopila 65536 valores para la agregación. En nuestro caso, para algunas métricas en el período de agregación (30 segundos) pueden llegar muchos más valores (1,527,392 en pico). Como resultado de esta muestreo, los valores de máximos y mínimos parecen inútiles. Por ejemplo, así:
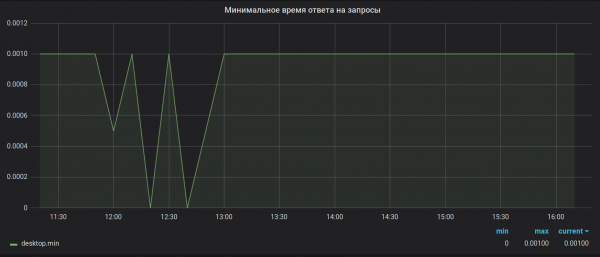
Como fue
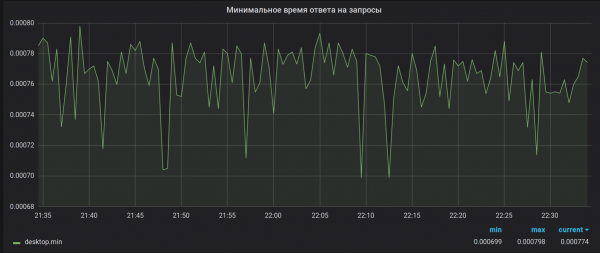
Como debería haber sido
Por la misma razón, las sumas se calculan incorrectamente. Añade a esto un error de desbordamiento de float de 32 bits, que realmente provoca un segfault en el servidor al recibir una métrica que parece inocente, y se vuelve aún mejor. El error, por cierto, aún no se ha corregido.
Y, por último, Queja X. En el momento de redactar este artículo, estamos listos para presentarlo a las 14 implementaciones de statsd más o menos funcionales que hemos logrado encontrar. Imaginemos que cierta infraestructura ha crecido tanto que recibir 4 millones de MPS ya no es suficiente. O puede que aún no haya crecido, pero las métricas son tan importantes para usted que incluso breves caídas de 2-3 minutos en los gráficos pueden volverse críticas y causar ataques de depresión incontrolable a los gerentes. Dado que tratar la depresión es un asunto ingrato, son necesarias soluciones técnicas.
En primer lugar, tolerancia a fallos, para que un problema repentino en el servidor no desencadene un apocalipsis zombi psiquiátrico en la oficina. En segundo lugar, escalabilidad, para poder recibir más de 4 millones de MPS sin tener que hurgar en la pila de red de Linux y crecer cómodamente 'horizontalmente' hasta los tamaños necesarios.
Dado que teníamos margen para la escalabilidad, decidimos comenzar con la tolerancia a fallos. '¡Oh! ¡Tolerancia a fallos! Esto es fácil, lo sabemos hacer', pensamos y lanzamos 2 servidores, levantando una copia de brubeck en cada uno. Para ello, tuvimos que duplicar el tráfico con las métricas en ambos servidores e incluso escribir para ello . Resolvimos el problema de la tolerancia a fallos, pero… no muy bien. Al principio, todo parecía ir bastante bien: cada brubeck recopila su propia variante de agregación, escribe datos en Graphite cada 30 segundos, sobrescribiendo el intervalo anterior (esto lo hace Graphite). Si un servidor falla, siempre tenemos el segundo con su propia copia de los datos agregados. Pero hay un problema: si un servidor falla, en los gráficos aparece una 'sierra'. Esto se debe a que los intervalos de 30 segundos en brubeck no están sincronizados, y en el momento de la caída uno de ellos no se sobrescribe. Al iniciar el segundo servidor ocurre lo mismo. Es bastante tolerable, pero se desea algo mejor. El problema de la escalabilidad también sigue sin resolverse. Todas las métricas siguen 'volando' hacia un único servidor, por lo que estamos limitados a esos mismos 2-4 millones de MPS, dependiendo de la capacidad de la red.
Si se piensa un poco en el problema y al mismo tiempo se excava en la nieve, puede venir a la mente una idea tan obvia: se necesita un statsd que funcione en modo distribuido. Es decir, uno que implemente sincronización entre nodos en función del tiempo y las métricas. "Por supuesto, ya debe existir una solución así", dijimos y empezamos a buscar en Google... y no encontramos nada. Después de revisar la documentación de varios statsd ( a partir del 11.12.2017), no encontramos nada en absoluto. Al parecer, ni los desarrolladores ni los usuarios de estas soluciones se habían enfrentado a esta CANTIDAD de métricas, de lo contrario, seguro ya habrían ideado algo.
Y aquí recordamos el statsd "juguete" — bioyino, que desarrollamos en un hackathon solo por diversión (el nombre del proyecto fue generado por un script al inicio del hackathon) y entendimos que urgentemente necesitábamos nuestro propio statsd. ¿Por qué?
- Porque en el mundo hay muy pocos clones de statsd,
- porque se puede proporcionar la resiliencia y escalabilidad deseadas (incluyendo sincronizar métricas agregadas entre servidores y resolver el problema de conflictos al enviar),
- porque se puede contar las métricas con más precisión que lo hace brubeck,
- porque podemos recopilar estadísticas más detalladas, que brubeck prácticamente no nos ofrecía,
- porque se presentó la oportunidad de programar nuestra propia aplicación de alto rendimiento distribuida, que no replicará completamente la arquitectura de otra aplicación de alto rendimiento similar.
¿En qué escribir? Por supuesto, en Rust. ¿Por qué?
- porque ya teníamos un prototipo de la solución,
- porque el autor del artículo en ese momento ya conocía Rust y estaba ansioso por escribir algo en él que pudiera ser publicado en open-source,
- porque los lenguajes con GC no nos son adecuados debido a la naturaleza del tráfico recibido (prácticamente en tiempo real) y las pausas del GC son prácticamente inaceptables,
- porque necesitamos el máximo rendimiento, comparable al de C
- porque Rust nos proporciona concurrencia sin miedo, y al comenzar a escribir esto en C/C++, habríamos enfrentado aún más vulnerabilidades, desbordamientos de buffer, condiciones de carrera y otras palabras aterradoras que ya tiene brubeck.
También hubo un argumento en contra de Rust. La empresa no tenía experiencia en la creación de proyectos en Rust, y actualmente tampoco planeamos usarlo en el proyecto principal. Por lo tanto, había serias preocupaciones de que no funcionaría, pero decidimos arriesgarnos y probar.
Pasó el tiempo...
Finalmente, después de varios intentos fallidos, la primera versión funcional estaba lista. ¿Qué salió de ello? Esto es lo que obtuvimos.
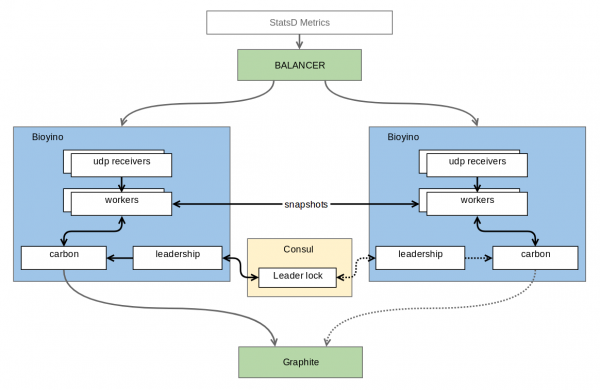
Cada nodo recibe su propio conjunto de métricas y las acumula internamente, sin agregar métricas para los tipos que requieren su conjunto completo para la agregación final. Los nodos están conectados entre sí mediante algún protocolo de bloqueo distribuido, que permite elegir entre ellos el único (aquí lloramos) que es digno de enviar métricas al Gran. Actualmente, este problema se resuelve mediante , pero en el futuro las ambiciones del autor se extienden a Raft, donde ese digno será, por supuesto, el nodo líder del consenso. Además del consenso, los nodos suelen (por defecto, una vez por segundo) enviar a sus vecinos las partes de las métricas preagregadas que lograron acumular durante ese segundo. Así que, la escalabilidad y la resistencia a fallos se mantienen: cada uno de los nodos todavía mantiene su conjunto completo de métricas, pero las métricas se envían ya agregadas, a través de TCP y con codificación en un protocolo binario, por lo que los costos de duplicación se reducen significativamente en comparación con UDP. A pesar de la gran cantidad de métricas entrantes, la acumulación requiere muy poca memoria y aún menos CPU. Para nuestras métricas bien compresibles, son solo unas pocas decenas de megabytes de datos. Un bono adicional es que se elimina la sobreescritura innecesaria de datos en Graphite, como sucedía con burbeck.
Los paquetes UDP con métricas se distribuyen entre los nodos en el equipo de red mediante un simple Round Robin. Por supuesto, el hardware de red no analiza el contenido de los paquetes y, por lo tanto, puede manejar mucho más de 4M de paquetes por segundo, sin mencionar las métricas, que en realidad no conoce en absoluto. Teniendo en cuenta que las métricas no llegan de una en una en cada paquete, no prevemos problemas de rendimiento en este aspecto. En caso de caída del servidor, el dispositivo de red detecta rápidamente (dentro de 1-2 segundos) este hecho y retira el servidor caído de la rotación. Como resultado, los nodos pasivos (es decir, no líderes) se pueden encender y apagar prácticamente sin notar caídas en los gráficos. Lo máximo que perdemos es una parte de las métricas que llegaron en el último segundo. La pérdida/desconexión/cambio repentino de un líder seguirá mostrando una anomalía leve (el intervalo de 30 segundos sigue desincronizado), pero con una conexión entre los nodos se pueden minimizar estos problemas, por ejemplo, mediante el envío de paquetes de sincronización.
Un poco sobre la arquitectura interna. La aplicación, por supuesto, es multihilo, pero la arquitectura de hilos es diferente a la utilizada en brubeck. Los hilos en brubeck son homogéneos: cada uno de ellos se encarga tanto de la recolección de información como de la agregación. En bioyino, los hilos de trabajo (workers) se dividen en dos grupos: los responsables de la red y los responsables de la agregación. Esta división permite gestionar la aplicación de manera más flexible según el tipo de métricas: donde se requiere una agregación intensiva, se pueden añadir más agregadores, y donde hay mucho tráfico de red, se puede aumentar el número de hilos de red. En este momento, en nuestros servidores estamos trabajando con 8 hilos de red y 4 hilos de agregación.
La parte de conteo (responsable de la agregación) es bastante aburrida. Los búferes llenos de hilos de red se distribuyen entre los hilos de conteo, donde posteriormente se analizan y agregan. Las métricas se envían a otras nodos bajo demanda. Todo esto, incluyendo la transmisión de datos entre nodos y el trabajo con Consul, se realiza de manera asíncrona, funcionando sobre el framework .
El desarrollo de la parte de red, encargada de recibir métricas, ha presentado muchos más problemas. La principal tarea de separar los flujos de red en entidades distintas fue reducir el tiempo que el flujo tarda no en leer datos del socket. Las opciones que utilizan UDP asíncrono y el recvmsg normal se descartaron rápidamente: la primera consume demasiada CPU en el espacio de usuario para procesar eventos, la segunda — demasiados cambios de contexto. Por lo tanto, actualmente se utiliza con buffers grandes (¡y los buffers, señores oficiales, no son cualquier cosa!). Se ha mantenido el soporte para UDP normal en casos no cargados, donde no es necesario recvmmsg. En modo multimensaje se logra lo principal: la gran mayoría del tiempo, el flujo de red despeja la cola del sistema operativo, leyendo datos del socket y trasladándolos al buffer del espacio de usuario, solo cambiando de vez en cuando para entregar el buffer lleno a los agregadores. La cola en el socket prácticamente no se acumula, y el número de paquetes desechados prácticamente no aumenta.
Nota
En la configuración predeterminada, el tamaño del buffer está ajustado para ser bastante grande. Si decides probar el servidor por tu cuenta, es posible que encuentres que después de enviar una pequeña cantidad de métricas, estas no lleguen a Graphite, quedándose en el buffer del flujo de red. Para trabajar con un pequeño número de métricas, debes ajustar los valores de bufsize y task-queue-size en la configuración a menores.
Por último, un poco de gráficos para los amantes de las estadísticas.
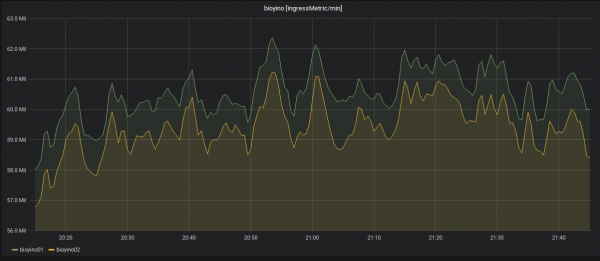
Estadísticas del número de métricas recibidas por cada servidor: más de 2 millones de MPS.
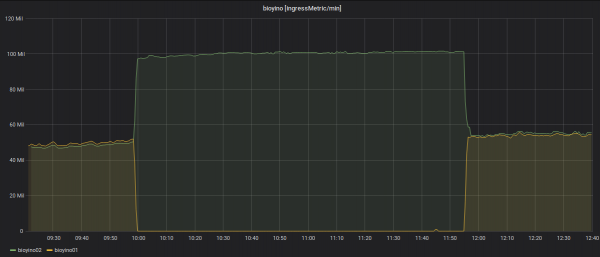
Desconexión de uno de los nodos y redistribución de las métricas entrantes.
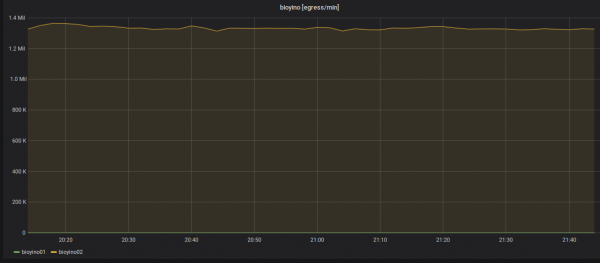
Estadísticas de métricas salientes: siempre solo un nodo envía — el jefe de la banda.
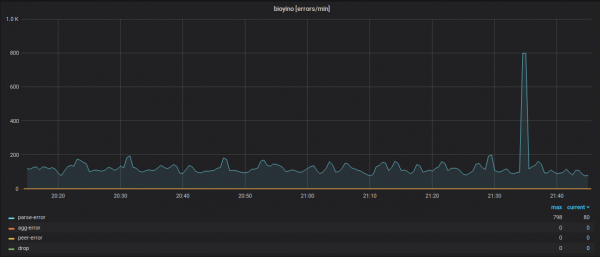
Estadísticas del rendimiento de cada nodo teniendo en cuenta errores en varios módulos del sistema.
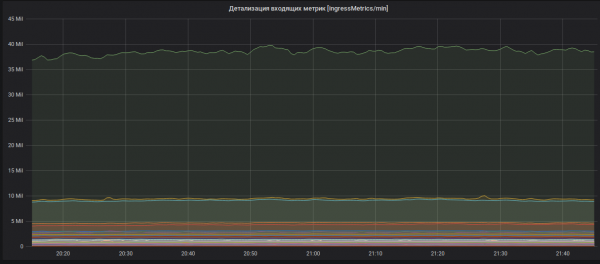
Detallado de métricas entrantes (los nombres de métricas están ocultos).
¿Qué planeamos hacer con todo esto a continuación? Por supuesto, escribir código, ¡bl...! El proyecto fue planeado desde el principio como open-source y seguirá siendo así durante toda su vida. En los planes más cercanos — pasar a nuestra propia versión de Raft, cambiar el protocolo peer a uno más portátil, añadir estadísticas internas adicionales, nuevos tipos de métricas, corregir errores y otras mejoras.
Por supuesto, todos los que deseen ayudar en el desarrollo del proyecto son bienvenidos: ¡crea PR, Issues y responderemos y mejoraremos cuando sea posible, etc.!
Y con esto, como se dice, ¡eso es todo amigos, compren nuestros elefantes!
Fuente: habr.com
