

¡Hola a todos! En mi anterior publicación, escribí acerca de la organización de un sistema de monitoreo modular para arquitecturas de microservicios. Nada se queda quieto, nuestro proyecto sigue creciendo y también lo hace la cantidad de métricas almacenadas. Cómo organizamos la migración de Graphite+Whisper a Graphite+ClickHouse bajo condiciones de alta carga, las expectativas sobre este y los resultados de la migración, lo pueden leer a continuación.
Antes de contarles cómo organizamos la transición del almacenamiento de métricas en Graphite+Whisper a Graphite+ClickHouse, quisiera proporcionar información sobre las razones detrás de esta decisión y sobre las desventajas de Whisper, con las que vivimos durante un largo tiempo.
Problemas de Graphite+Whisper
1. Alta carga en el subsistema de disco
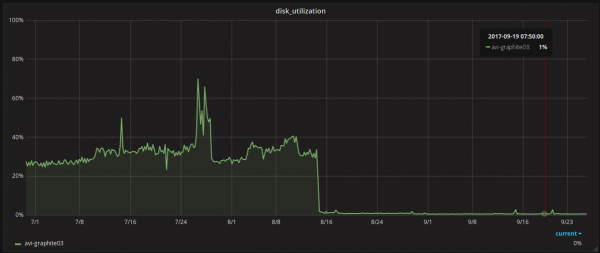
En el momento de la transición, recibíamos aproximadamente 1.5 millones de métricas por minuto. Con este flujo, la utilización de disco en los servidores era del ~30%. En general, esto era bastante aceptable: todo funcionaba de manera estable, se escribía rápido, se leía rápido... Hasta que uno de los equipos de desarrollo lanzó una nueva función y comenzó a enviarnos 10 millones de métricas por minuto. En ese momento, el subsistema de disco se vio presionado y experimentamos una utilización del 100%. El problema se resolvió rápidamente, pero quedó una mala experiencia.
2. Falta de replicación y consistencia
Probablemente, al igual que todos los que usan o han usado Graphite+Whisper, enviábamos el mismo flujo de métricas simultáneamente a varios servidores Graphite con el objetivo de crear redundancia. Y esto no presentó problemas significativos, hasta que uno de los servidores fallaba por alguna razón. A veces logramos reiniciar el servidor caído bastante rápido y carbon-c-relay lograba llenar el servidor con métricas de su caché, y a veces no. Entonces había un hueco en las métricas que cubríamos con rsync. El procedimiento era bastante lento. Solo se salvaba el hecho de que esto ocurría con muy poca frecuencia. También tomábamos periódicamente un conjunto aleatorio de métricas y las comparábamos con otros similares en los nodos vecinos del clúster. En aproximadamente el 5% de los casos, algunos valores diferían, lo que no nos alegraba mucho.
3. Gran volumen de espacio ocupado
Dado que escribimos en Graphite no solo métricas de infraestructura, sino también métricas comerciales (y ahora también métricas de Kubernetes), a menudo nos encontramos en una situación en la que la métrica solo contiene unos pocos valores, y el archivo .wsp se crea teniendo en cuenta todo el período de retención, ocupando el espacio dedicado que teníamos asignado, que era aproximadamente de 2 MB. El problema se agrava aún más por el hecho de que con el tiempo aparecen muchos de estos archivos, y al generar informes sobre ellos, se consume mucho tiempo y recursos para leer los puntos vacíos.
Quisiera señalar de inmediato que se pueden abordar los problemas descritos anteriormente de diversas maneras y con diferentes grados de efectividad, pero cuanto más datos comienzan a llegar a usted, más acentuados se vuelven.
Teniendo en cuenta todo lo anterior (junto con lo anterior, ), así como el crecimiento constante en la cantidad de métricas recibidas, el deseo de reducir el intervalo de almacenamiento de todas las métricas a 30 segundos (si es necesario, hasta 10 segundos), decidimos probar Graphite+ClickHouse como una alternativa prometedora a Whisper.
Graphite+ClickHouse. Expectativas
Después de asistir a varios encuentros con los chicos de Yandex, leer , revisar la documentación y encontrar componentes sensatos para integrar ClickHouse con Graphite, ¡decidimos actuar!
Queríamos lograr lo siguiente:
- reducir la utilización del sistema de almacenamiento del 30% al 5%;
- reducir el espacio ocupado de 1TB a 100GB;
- tener la capacidad de recibir 100 millones de métricas por minuto en el servidor;
- replicación de datos y alta disponibilidad de forma nativa;
- no estar trabajando en este proyecto durante un año y hacer la transición en un tiempo razonable;
- cambiar sin tiempo de inactividad.
Bastante ambicioso, ¿verdad?
Graphite+ClickHouse. Componentes
Para obtener datos a través del protocolo Graphite y posteriormente escribirlos en ClickHouse, se eligió (golang).
Se eligió la última versión estable de ClickHouse en ese momento, versión 1.1.54253, como base de datos para el almacenamiento de series temporales. Al trabajar con ella, surgieron problemas: se registraban una gran cantidad de errores en los logs, y no estaba claro qué hacer con ellos. En una discusión con (autor de carbon-clickhouse, graphite-clickhouse y muchas, muchas más cosas), se eligió una versión anterior, Los errores desaparecieron: todo comenzó a funcionar a la perfección.
Para leer datos de ClickHouse, se eligió (golang). Como interfaz API para Graphite, se utilizó (golang). Se utilizó para organizar la replicación entre las tablas de ClickHouse . Para la ruta de las métricas, dejamos nuestro querido (C) .
Graphite+ClickHouse. Estructura de las tablas
“graphite” es la base de datos que creamos para las tablas de monitoreo.
“graphite.metrics” es una tabla con el motor ReplicatedReplacingMergeTree (replicada ). Esta tabla almacena los nombres de las métricas y sus rutas.
CREATE TABLE graphite.metrics ( Date Date, Level UInt32, Path String, Deleted UInt8, Version UInt32 ) ENGINE = ReplicatedReplacingMergeTree('\/clickhouse\/tables\/replicator\/graphite.metrics', 'r1', Date, (Level, Path), 8192, Version);“graphite.data” es una tabla con el motor ReplicatedGraphiteMergeTree (replicada ). Esta tabla almacena los valores de las métricas.
CREATE TABLE graphite.data ( Path String, Value Float64, Time UInt32, Date Date, Timestamp UInt32 ) ENGINE = ReplicatedGraphiteMergeTree('\/clickhouse\/tables\/replicator\/graphite.data', 'r1', Date, (Path, Time), 8192, 'graphite_rollup')“graphite.date_metrics” es una tabla que se llena bajo condiciones, con el motor ReplicatedReplacingMergeTree. En esta tabla se registran los nombres de todas las métricas encontradas en un día. Las razones de su creación se describen en la sección al final de este artículo.
CREATE MATERIALIZED VIEW graphite.date_metrics ( Path String, Level UInt32, Date Date) ENGINE = ReplicatedReplacingMergeTree('\/clickhouse\/tables\/replicator\/graphite.date_metrics', 'r1', Date, (Level, Path, Date), 8192) AS SELECT toUInt32(length(splitByChar('.', Path))) AS Level, Date, Path FROM graphite.data“graphite.data_stat” es una tabla que se llena bajo condiciones, con el motor ReplicatedAggregatingMergeTree (replicada ). En esta tabla se registra la cantidad de métricas entrantes, desglosadas hasta 4 niveles de profundidad.
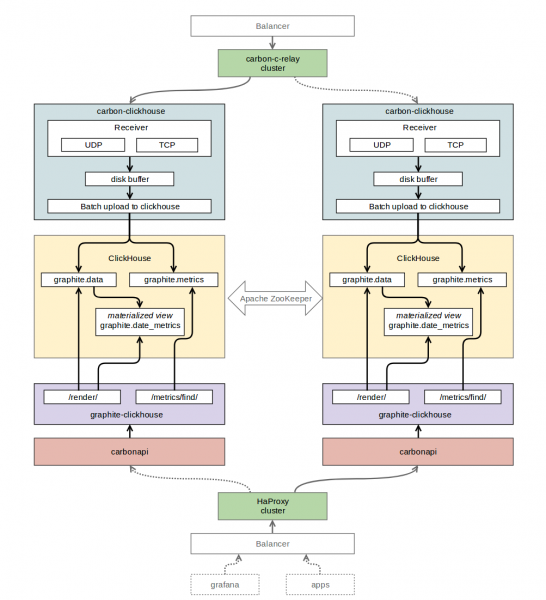
CREATE MATERIALIZED VIEW graphite.data_stat ( Date Date, Prefix String, Timestamp UInt32, Count AggregateFunction(count)) ENGINE = ReplicatedAggregatingMergeTree('\/clickhouse\/tables\/replicator\/graphite.data_stat', 'r1', Date, (Timestamp, Prefix), 8192) AS SELECT toStartOfMonth(now()) AS Date, replaceRegexpOne(Path, '^([^.]+\.[^.]+\.[^.]+).*$', '1') AS Prefix, toUInt32(toStartOfMinute(toDateTime(Timestamp))) AS Timestamp, countState() AS Count FROM graphite.data GROUP BY Timestamp, PrefixGraphite+ClickHouse. Esquema de interacción de componentes
Graphite+ClickHouse. Migración de datos
Como recordamos de las expectativas de este proyecto, la transición a ClickHouse debe ser sin tiempos de inactividad, por lo tanto, debemos haber de alguna manera cambiar todo nuestro sistema de monitoreo a la nueva base de datos de manera lo más transparente posible para nuestros usuarios.
Así lo hicimos.
En carbon-c-relay añadimos una regla para enviar un flujo adicional de métricas a carbon-clickhouse de uno de los servidores que participan en la replicación de las tablas de ClickHouse.
Escribimos un pequeño script en Python que, utilizando la biblioteca whisper-dump, leía todos los archivos .wsp de nuestro almacenamiento y enviaba estos datos al carbon-clickhouse mencionado anteriormente en 24 hilos. La cantidad de valores de métricas recibidos en carbon-clickhouse alcanzaba los 125 millones/minuto, y ClickHouse ni siquiera se inmutó.
Creamos una fuente de datos separada en Grafana con el objetivo de depurar las funciones utilizadas en los dashboards existentes. Identificamos una lista de funciones que usábamos, pero no estaban implementadas en carbonapi. Añadimos estas funciones y enviamos PR a los autores de carbonapi (a ellos, muchas gracias).
- Para cambiar la carga de lectura, en la configuración de los balanceadores, cambiamos los endpoints de graphite-api (interfaz API para Graphite+Whisper) a carbonapi.
Graphite+ClickHouse. Resultados
redujimos la utilización del subsistema de disco del 30% al 1%;

- redujimos el espacio ocupado de 1 TB a 300 GB;
- tenemos la capacidad de recibir 125 millones de métricas por minuto en el servidor (picos durante la migración);
- cambiamos todas las métricas a un intervalo de almacenamiento de treinta segundos;
- obtuvimos replicación de datos y tolerancia a fallos;
- cambiamos sin tiempo de inactividad;
- nos llevó aproximadamente 7 semanas.
Graphite+ClickHouse. Problemas
En nuestro caso, también hubo algunos escollos. Aquí están los problemas que encontramos después de la transición.
- ClickHouse no siempre vuelve a leer los archivos de configuración en tiempo real, a veces es necesario reiniciarlo. Por ejemplo, en el caso de la descripción del clúster zookeeper en la configuración de ClickHouse, no se aplica hasta reiniciar el servidor de clickhouse.
- No pasaban grandes consultas a ClickHouse, por lo que en nuestra conexión a graphite-clickhouse se ve así:
url = "http://localhost:8123/?max_query_size=268435456&max_ast_elements=1000000" - En ClickHouse, con bastante frecuencia se lanzan nuevas versiones de lanzamientos estables, que pueden tener sorpresas: ten cuidado.
- Los contenedores creados dinámicamente en Kubernetes envían una gran cantidad de métricas con un corto y aleatorio período de vida. No hay muchos puntos para estas métricas, y no hay problemas de espacio. Pero al construir consultas, ClickHouse recupera una enorme cantidad de estas métricas de la tabla 'metrics'. En el 90% de los casos, los datos de ellas están ausentes en la ventana (24 horas). Sin embargo, se dedica tiempo a buscar estos datos en la tabla 'data', lo que finalmente provoca un tiempo de espera. Para resolver este problema, comenzamos a llevar una vista separada con información sobre las métricas que aparecieron en un día. Así, al construir informes (gráficos) sobre los contenedores creados dinámicamente, solo consultamos las métricas que aparecieron dentro de la ventana establecida, y no durante todo el tiempo, lo que aceleró significativamente la creación de informes sobre ellas. Para la solución descrita anteriormente se desarrolló , que incluye la implementación de la tabla date_metrics.
Graphite+ClickHouse. Etiquetas
Desde la versión 1.1.0, Graphite ha empezado a . Y estamos pensando activamente en lo que y cómo se debe hacer para apoyar esta iniciativa en el stack graphite+clickhouse.
Graphite+ClickHouse. Detector de anomalías
Sobre la base de la infraestructura descrita anteriormente, implementamos un prototipo de detector de anomalías, ¡y funciona! Pero sobre ello, en el próximo artículo.
¡Suscríbete, da un 'me gusta' y sé feliz!
Fuente: habr.com
