

Hoy en nuestro proyecto, además del código monolítico, funcionan decenas de microservicios. Cada uno de ellos requiere ser monitoreado. Hacer esto en tales volúmenes por parte de ingenieros de DevOps es problemático. Hemos desarrollado un sistema de monitoreo que funciona como un servicio para los desarrolladores. Ellos pueden escribir métricas en el sistema de monitoreo, utilizarlas, construir tableros basados en ellas y agregar alertas que se activarán al alcanzar valores umbral. De los ingenieros de DevOps, solo quedan la infraestructura y la documentación.
Esta publicación es la transcripción de mi presentación en nuestra en RIT++. Muchos nos pidieron que hiciéramos versiones textuales de las conferencias de allí. Si estuviste en la conferencia o viste el video, no encontrarás nada nuevo. Y a los demás, bienvenidos a continuación. Les contaré cómo llegamos a este sistema, cómo funciona y cómo planeamos actualizarlo.
Pasado: esquemas y planes
¿Cómo llegamos al sistema de monitoreo existente? Para responder a esta pregunta, debemos retroceder al año 2015. Así se veía entonces:
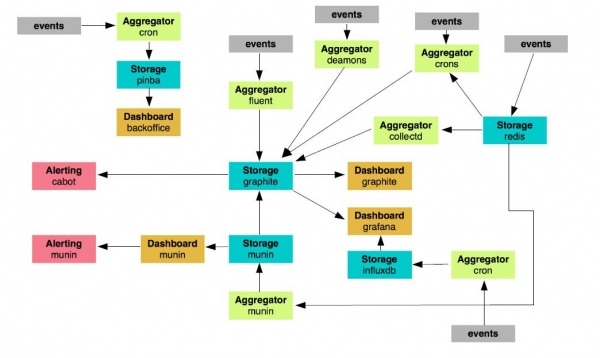
Contábamos con alrededor de 24 nodos encargados del monitoreo. Aquí hay un montón de diferentes cron jobs, scripts, demonios que monitorean algo de alguna manera, envían mensajes, realizan funciones. Pensamos que cuanto más avanzáramos, menos viable sería tal sistema. No tenía sentido desarrollarlo: era demasiado engorroso.
Decidimos elegir aquellos elementos de monitoreo que conservaríamos y desarrollar, y aquellos de los que nos despediríamos. Resultaron ser 19. Solo quedaron Graphite, agregadores y Grafana como tablero. Pero, ¿cómo se verá el nuevo sistema? Así:
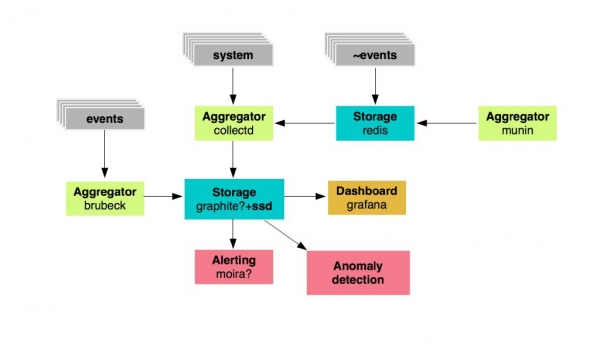
Tenemos un almacenamiento de métricas: son Graphite, que estarán basados en discos SSD rápidos, y ciertos agregadores para métricas. Luego, Grafana para mostrar los tableros y Moira como herramienta de alertas. También queríamos desarrollar un sistema para buscar anomalías.
Estándar: Monitoreo 2.0
Así se veían los planes en 2015. Pero necesitábamos preparar no solo la infraestructura y el servicio, sino también la documentación para ello. Desarrollamos un estándar corporativo que llamamos monitoreo 2.0. ¿Cuáles eran los requisitos del sistema?
- disponibilidad continua;
- intervalo de almacenamiento de métricas = 10 segundos;
- almacenamiento estructurado de métricas y dashboards;
- SLA > 99,99%
- recolección de métricas de eventos a través de UDP (!).
Necesitábamos UDP porque tenemos un gran flujo de tráfico y eventos que generan métricas. Si escribiéramos todas de inmediato en Graphite, el almacenamiento colapsaría. También elegimos prefijos de primer nivel para todas las métricas.
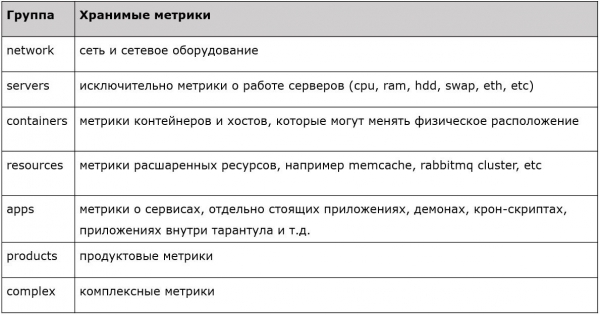
Cada uno de los prefijos tiene alguna propiedad. Hay métricas para servidores, redes, contenedores, recursos, aplicaciones, etc. Se ha implementado un filtrado claro, estricto y tipificado, donde aceptamos métricas de primer nivel y las demás simplemente las descartamos. Así es como planeamos este sistema en 2015. ¿Y ahora?
Actualidad: esquema de interacción de los componentes de monitoreo
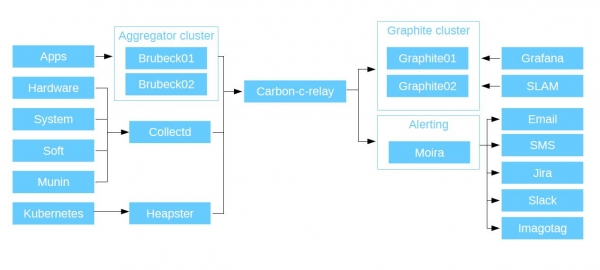
Primero monitoreamos aplicaciones: nuestro código PHP, aplicaciones y microservicios; en resumen, todo lo que escriben nuestros desarrolladores. Todas las aplicaciones envían métricas a través de UDP al agregador Brubeck (statsd, reescrito en C). Resultó ser el más rápido según las pruebas sintéticas. Y ya envía métricas agregadas a Graphite a través de TCP.
Tiene un tipo de métricas llamado temporizadores. Es una herramienta muy útil. Por ejemplo, para cada conexión de usuario con el servicio, envías a Brubeck una métrica con el tiempo de respuesta. Llegaron un millón de respuestas, y el agregador produjo solo 10 métricas. Tienes la cantidad de usuarios, el tiempo de respuesta máximo, mínimo y promedio, la mediana y 4 percentiles. Luego los datos se transmiten a Graphite y los vemos todos en vivo.
También tenemos agregación para métricas de hardware, software, métricas del sistema y nuestro antiguo sistema de monitoreo Munin (que funcionó con nosotros hasta 2015). Todo esto lo recopilamos a través del demonio CollectD (que tiene una gran variedad de plugins incorporados, puede consultar todos los recursos del sistema host en el que está instalado, solo tienes que especificar en la configuración dónde escribir los datos) y escribimos los datos en Graphite a través de él. También admite plugins de Python y scripts de shell, por lo que puedes escribir tus soluciones personalizadas: CollectD recopilará estos datos de un host local o remoto (supongamos que tienes Curl) y los enviará a Graphite.
A continuación, enviamos todas las métricas que hemos recopilado a Carbon-c-relay. Esta es una solución de Carbon Relay de Graphite, ajustada en C. Es un enrutador que recopila todas las métricas que enviamos desde nuestros agregadores y las enruta a través de los nodos. También, en la etapa de enrutamiento, verifica la validez de las métricas. Primero, deben corresponder al esquema de prefijos que mencioné antes y, segundo, deben ser válidas para Graphite. De lo contrario, se descartan.
Luego, Carbon-c-relay envía las métricas al clúster de Graphite. Usamos Carbon-cache, reescrito en Go, como nuestro principal almacenamiento de métricas. Go-carbon, debido a su multitarea, supera con creces el rendimiento de Carbon-cache. Acepta datos y los escribe en discos utilizando el paquete whisper (el estándar, escrito en Python). Para leer datos de nuestros almacenes, utilizamos la API de Graphite. Funciona mucho más rápido que el Graphite WEB estándar. ¿Qué sucede con los datos después?
Pasamos a Grafana. Usamos nuestros clústeres de Graphite como la fuente principal de datos, además de que tenemos Grafana como interfaz web para mostrar métricas y construir paneles de control. Cada uno de nuestros servicios tiene su propio panel. Luego, construyen gráficos donde se muestran las métricas que registran desde sus aplicaciones. Además de Grafana, tenemos SLAM. Este es un demonio en Python que calcula el SLA basado en los datos de Graphite. Como mencioné, tenemos decenas de microservicios, cada uno con sus propios requisitos. Con SLAM consultamos la documentación y la comparamos con lo que hay en Graphite y evaluamos cuán bien se cumplen los requisitos respecto a la disponibilidad de nuestros servicios.
Avancemos: la alerta. Está organizada con un sistema robusto: Moira. Es independiente porque tiene su propio Graphite bajo el capó. Desarrollada por el equipo de SKB «Kontur», escrita en Python y Go, completamente de código abierto. Moira recibe el mismo flujo que se dirige a los Graphites. Si por alguna razón su almacenamiento falla, su sistema de alertas seguirá funcionando.
Implementamos Moira en Kubernetes, utilizando un clúster de servidores Redis como base de datos principal. Como resultado, obtuvimos un sistema tolerante a fallos. Compara el flujo de métricas con una lista de disparadores: si no hay menciones, desecha la métrica. De este modo, puede procesar gigabytes de métricas por minuto.
Además, lo conectamos a un LDAP corporativo, que permite a cada usuario del sistema corporativo crear notificaciones para los disparadores existentes (o nuevos). Dado que Moira incluye Graphite, admite todas sus funciones. Primero, tomas una línea y la copias en Grafana. Observas cómo se visualizan los datos en los gráficos. Luego, tomas esa misma línea y la copias en Moira. Le agregas límites y obtienes alertas. Para hacer todo esto, no necesitas ningún conocimiento específico. Moira puede enviar alertas por SMS, correo electrónico, en Jira, Slack... También admite la ejecución de scripts personalizados. Cuando ocurre un disparador y está suscrita a un script o binario personalizado, lo ejecuta y le entrega JSON a través de stdin. Por lo tanto, tu programa debe analizarlo. Lo que hagas con este JSON depende de ti. Puedes enviarlo a Telegram, abrir tareas en Jira, hacer lo que quieras.
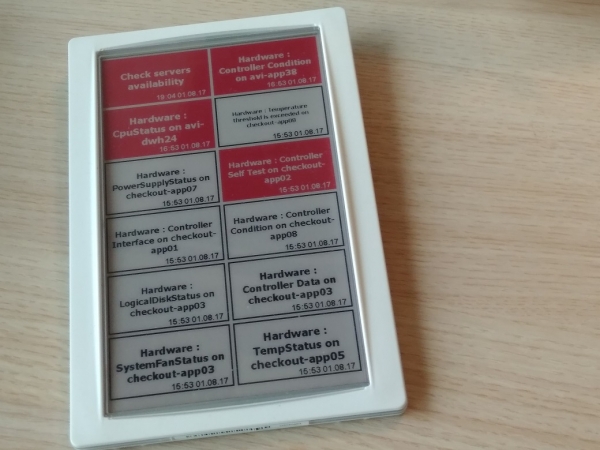
Además, utilizamos un desarrollo propio para alertas: Imagotag. Adaptamos un panel usado normalmente para etiquetas de precios en tiendas a nuestras necesidades. Mostramos los disparadores de Moira en él. Ahí se indica su estado y cuándo ocurrieron. Parte del equipo de desarrollo abandonó las notificaciones en Slack y correo en favor de este panel.
Y dado que somos una empresa progresista, también monitorizamos Kubernetes en este sistema. Lo integraron a través de Heapster, que instalamos en el clúster. Este recolecta datos y los envía a Graphite. En consecuencia, el esquema se ve así:
Componentes de monitoreo
Aquí tienes una lista de enlaces a los componentes que utilizamos para esta tarea. Todos son de código abierto.
Graphite:
- go-carbon:
- whisper:
- graphite-api:
Carbon-c-relay:
Brubeck:
Collectd:
Moira:
Grafana:
Heapster:
Estadísticas
Y aquí hay algunos números sobre cómo funciona nuestro sistema.
Agregador (brubeck)
Número de métricas: ~ 300 000 / seg
Intervalo de envío de métricas a Graphite: 30 seg
Uso de recursos del servidor: ~ 6% CPU (se refiere a servidores completos); ~ 1Gb RAM; ~ 3 Mbps LAN
Graphite (go-carbon)
Número de métricas: ~ 1 600 000 / min
Intervalo de actualización de métricas: 30 seg
Esquema de almacenamiento de métricas: 30seg 35d, 5min 90d, 10min 365d (esto proporciona una comprensión de lo que sucede con el servicio a largo plazo)
Uso de recursos del servidor: ~ 10% CPU; ~ 20Gb RAM; ~ 30 Mbps LAN
Flexibilidad
En Avito valoramos mucho la flexibilidad en nuestro servicio de monitoreo. ¿Por qué es así? En primer lugar, sus componentes son intercambiables: tanto los propios componentes como sus versiones. En segundo lugar, la mantenibilidad. Dado que todo el proyecto está construido sobre código abierto, usted mismo puede modificar el código, realizar cambios y puede implementar funciones que no están disponibles de manera predeterminada. Se utilizan stacks bastante comunes, principalmente Go y Python, por lo que es bastante sencillo hacerlo.
Aquí hay un ejemplo de un problema que realmente surgió. Una métrica en Graphite es un archivo. Tiene un nombre. El nombre del archivo = el nombre de la métrica. Y hay una ruta hacia él. Los nombres de los archivos en Linux están limitados a 255 caracteres. Y tenemos (como 'clientes internos') a personas del departamento de bases de datos. Nos dicen: “Queremos monitorear nuestras consultas SQL. Y no son 255 caracteres, sino 8 MB cada una. Queremos mostrarlas en Grafana, ver los parámetros de esa consulta, y aún mejor, queremos ver el top de esas consultas. Sería genial si se mostrara en tiempo real. Y aún mejor sería incluirlas en alertas.
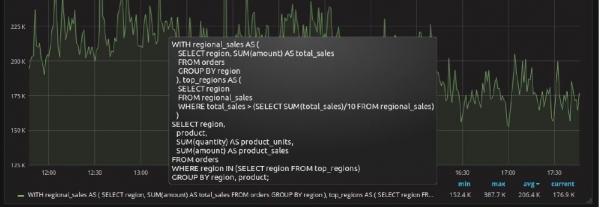
Ejemplo de consulta SQL tomada como ejemplo de
Estamos implementando un servidor Redis y nuestros plugins Collectd, que acceden a Postgres y extraen todos los datos, enviando métricas a Graphite. Pero cambiamos el nombre de la métrica por hashes. Este mismo hash lo enviamos a Redis como clave, y toda la consulta SQL como valor. Solo nos queda hacer que Grafana pueda acceder a Redis y obtener esta información. Abrimos la API de Graphite, ya que es la interfaz principal de interacción entre todos los componentes de monitoreo y Graphite, e incorporamos una nueva función llamada aliasByHash() — recibimos el nombre de la métrica de Grafana y lo usamos en la consulta a Redis como clave, y en la respuesta obtenemos el valor clave que es nuestra "consulta SQL". De este modo, mostramos en Grafana la representación de la consulta SQL, que teóricamente no se podría mostrar allí, junto con las estadísticas relacionadas (llamadas, filas, tiempo total, ...).
Resultados
Disponibilidad. Nuestro servicio de monitoreo está disponible 24/7 desde cualquier aplicación y cualquier código. Si tienes acceso a los almacenes, puedes enviar datos al servicio. El lenguaje no importa, las soluciones no importan. Solo necesitas saber cómo abrir un socket, enviar la métrica y cerrar el socket.
Confiabilidad. Todos los componentes son tolerantes a fallos y manejan nuestras cargas de trabajo de manera eficiente.
Bajo umbral de entrada. Para usar este sistema, no necesitas aprender lenguajes de programación ni consultas en Grafana. Simplemente abre tu aplicación, introduces el socket que enviará métricas a Graphite, lo cierras, abres Grafana, creas paneles allí y observas el comportamiento de tus métricas, recibiendo notificaciones a través de Moira.
Autonomía. Todo esto se puede hacer de forma independiente, sin ayuda de ingenieros DevOps. Y esto es un gran beneficio, porque puedes monitorear tu proyecto ahora mismo, sin necesidad de pedir ayuda — ni para comenzar a trabajar, ni para realizar cambios.
¿A qué aspiramos?
Todo lo mencionado a continuación no son solo pensamientos abstractos, sino a lo que se han dado al menos los primeros pasos.
- Detector de anomalías. Queremos implementar un servicio que vaya a nuestros almacenes de Graphite y verifique cada métrica con diversos algoritmos. Ya tenemos algoritmos que queremos revisar, tenemos datos, y sabemos cómo trabajar con ellos.
- Metadatos. Tenemos muchos servicios que cambian con el tiempo, al igual que las personas que trabajan con ellos. Mantener la documentación manualmente no es una opción. Por lo tanto, ahora se integran metadatos en nuestros microservicios. Ahí se especifica quién lo desarrolló, los lenguajes con los que interactúa, los requisitos de SLA, a dónde y a quién enviar las notificaciones. Al desplegar el servicio, todos los datos de la entidad se crean automáticamente. Al final, obtienes dos enlaces: uno para los disparadores y otro para los tableros en Grafana.
- Monitoreo en cada hogar. Creemos que todos los desarrolladores deberían usar un sistema así. De esta manera, siempre entiendes dónde está tu tráfico, qué le sucede, dónde cae y dónde tiene sus puntos débiles. Si, por ejemplo, algo llega y colapsa tu servicio, no te enterarás durante una llamada del gerente, sino por una alerta, y podrás abrir los registros recientes y ver qué ocurrió.
- Alto rendimiento. Nuestro proyecto está en constante crecimiento y hoy procesa alrededor de 2,000,000 de valores de métricas por minuto. Hace un año, este indicador era de 500,000. Y el crecimiento continúa, lo que significa que en algún momento Graphite (whisper) comenzará a sobrecargar mucho el subsistema de disco. Como ya mencioné, este sistema de monitoreo es bastante versátil gracias a la intercambiabilidad de sus componentes. Algunos mantienen y amplían constantemente su infraestructura específicamente para Graphite, pero decidimos tomar otro camino: usar como almacenamiento de nuestras métricas. Esta transición está casi completada, y pronto contaré más en detalle cómo se llevó a cabo: cuáles fueron las dificultades y cómo se superaron, cómo se llevó a cabo el proceso de migración, describiré los componentes elegidos como envoltura y sus configuraciones.
¡Gracias por su atención! Hagan sus preguntas sobre el tema, intentaré responder aquí o en las siguientes publicaciones. Quizás alguien tenga experiencia construyendo un sistema de monitoreo similar o haciendo la transición a Clickhouse en una situación similar: compártanlo en los comentarios.
Fuente: habr.com
