

Encontré un material interesante sobre inteligencia artificial en los juegos. Con explicaciones básicas sobre la IA mediante ejemplos simples, y además, incluye muchas herramientas y métodos útiles para su desarrollo y diseño. También hay información sobre cómo, dónde y cuándo usarlos.
La mayoría de los ejemplos están escritos en pseudocódigo, por lo que no se requieren profundos conocimientos de programación. Más abajo hay 35 páginas de texto con imágenes y gifs, así que prepárense.
UPD. Lo siento, pero ya hice mi propia traducción de este artículo en Habrahabr. . Se puede leer su versión , pero por alguna razón el artículo me pasó desapercibido (utilicé la búsqueda, pero algo salió mal). Y como escribo en un blog dedicado al desarrollo de videojuegos, decidí dejar mi propia traducción para mis suscriptores (algunos puntos los he presentado de manera diferente, y otros los he omitado intencionadamente por recomendación de los desarrolladores).
¿Qué es la IA?
La IA en los juegos se centra en las acciones que debe realizar un objeto, en función de las condiciones en las que se encuentra. Esto generalmente se llama gestión de "agentes inteligentes", donde el agente puede ser un personaje del juego, un vehículo, un bot, o a veces algo más abstracto: un grupo entero de entidades o incluso una civilización. En cada caso, es una entidad que debe percibir su entorno, tomar decisiones basadas en ello y actuar en consecuencia. Esto se conoce como el ciclo Sense/Think/Act (Sentir/Pensar/Actuar):
- Sense: el agente encuentra o recibe información sobre cosas en su entorno que pueden influir en su comportamiento (amenazas cercanas, objetos para recoger, lugares interesantes para investigar).
- Think: el agente decide cómo reaccionar (considera si es lo suficientemente seguro recoger objetos o si primero debe luchar/esconderse).
- Act: el agente lleva a cabo acciones para realizar la decisión anterior (comienza a moverse hacia el enemigo o el objeto).
- …ahora la situación ha cambiado debido a las acciones de los personajes, por lo que el ciclo se repite con nuevos datos.
La IA, por lo general, se concentra en la parte de Sense del ciclo. Por ejemplo, los coches autónomos capturan imágenes de la carretera, combinan estas con datos de radar y lidar, y los interpretan. Normalmente, esto lo hace el aprendizaje automático, que procesa los datos entrantes y les da significado, extrayendo información semántica del tipo "hay otro coche a 20 yardas enfrente de ti". Estos son los llamados problemas de clasificación.
Los juegos no necesitan un sistema complicado para extraer información, ya que gran parte de los datos ya es parte integral del mismo. No es necesario ejecutar algoritmos de reconocimiento de imágenes para determinar si hay un enemigo adelante; el juego ya lo sabe y transmite esa información directamente en el proceso de toma de decisiones. Por lo tanto, la parte del ciclo Sense es a menudo mucho más simple que Think y Act.
Limitaciones de la IA en los juegos
La IA tiene una serie de limitaciones que deben ser respetadas:
- La IA no necesita ser entrenada de antemano, como lo haría un algoritmo de aprendizaje automático. No tiene sentido escribir una red neuronal durante el desarrollo para observar a decenas de miles de jugadores y estudiar la mejor forma de jugar contra ellos. ¿Por qué? Porque el juego no ha sido lanzado y no hay jugadores.
- El juego debe entretener y desafiar, por lo que los agentes no deben encontrar el mejor enfoque contra los humanos.
- Los agentes deben parecer realistas para que los jugadores sientan que están jugando contra personas reales. El programa AlphaGo superó al humano, pero los movimientos seleccionados estaban muy alejados de la comprensión tradicional del juego. Si el juego imita a un oponente humano, esa sensación no debería existir. El algoritmo debe modificarse para que tome decisiones plausibles en lugar de perfectas.
- La IA debe operar en tiempo real. Esto significa que el algoritmo no puede monopolizar el uso del procesador durante largos períodos para tomar decisiones. Incluso 10 milisegundos para esto es demasiado tiempo, porque la mayoría de los juegos necesitan entre 16 y 33 milisegundos para procesar todo y pasar al siguiente fotograma gráfico.
- Es ideal que al menos parte del sistema sea controlada por datos, para que los "no programadores" puedan hacer cambios y para que las correcciones ocurran más rápidamente.
Consideremos enfoques de IA que abordan todo el ciclo Sense/Think/Act.
Toma de decisiones básicas
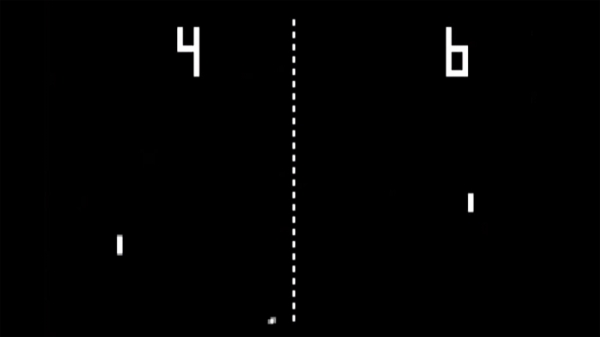
Comencemos con el juego más simple: Pong. Objetivo: mover la paleta (paddle) para que la pelota rebote en ella y no pase de largo. Es como el tenis, donde pierdes si no golpeas la pelota. Aquí la IA tiene una tarea relativamente sencilla: decidir en qué dirección mover la paleta.
Operadores condicionales
Para la IA en Pong, la solución más obvia es siempre intentar mantener la paleta debajo de la pelota.
Un algoritmo simple para esto, escrito en pseudocódigo:
cada fotograma/actualización mientras el juego esté en funcionamiento:
si la pelota está a la izquierda de la paleta:
mover la paleta a la izquierda
si no, si la pelota está a la derecha de la paleta:
mover la paleta a la derecha
Si la paleta se mueve a la misma velocidad que la pelota, entonces este es el algoritmo ideal para la IA en Pong. No hay necesidad de complicar las cosas si hay pocos datos y acciones posibles para el agente.
Este enfoque es tan simple que todo el ciclo Sense/Think/Act es apenas perceptible. Pero existe:
- La parte Sense se encuentra en dos operadores if. El juego sabe dónde está la pelota y dónde está la paleta, por lo que la IA consulta esa información.
- La parte Think también consiste en dos operadores if. Ellos encapsulan dos decisiones, que en este caso son mutuamente excluyentes. Como resultado, se selecciona una de tres acciones: mover la paleta a la izquierda, moverla a la derecha o no hacer nada si ya está en la posición correcta.
- La parte Act se encuentra en los operadores Mover Paleta a la Izquierda y Mover Paleta a la Derecha. Dependiendo del diseño del juego, pueden mover la paleta instantáneamente o a una velocidad determinada.
Este tipo de enfoques se llama reactivos: hay un conjunto simple de reglas (en este caso, los operadores if en el código) que reaccionan al estado actual del mundo y actúan.
Árbol de decisiones
El ejemplo del juego Pong equivale en realidad al concepto formal de IA llamado árbol de decisiones. El algoritmo lo atraviesa para llegar a la "hoja": una decisión sobre qué acción tomar.
Hagamos un diagrama de flujo del árbol de decisiones para el algoritmo de nuestra paleta:
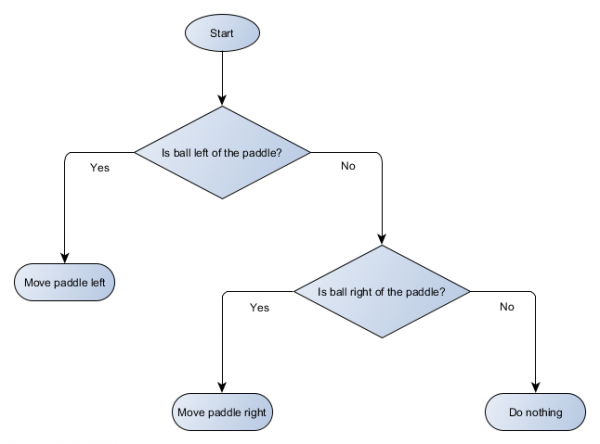
Cada parte del árbol se llama nodo (node) — la IA utiliza la teoría de grafos para describir estas estructuras. Hay dos tipos de nodos:
- Nodos de decisión: elegir entre dos alternativas basándose en la verificación de alguna condición, donde cada alternativa se presenta como un nodo separado.
- Nodos terminales: acción a ejecutar, que representa la decisión final.
El algoritmo comienza con el primer nodo (la "raíz" del árbol). Este toma una decisión sobre qué nodo hijo visitar o realiza una acción almacenada en el nodo y se completa.
¿Cuál es la ventaja, si el árbol de decisiones realiza el mismo trabajo que los operadores if en la sección anterior? Aquí hay un sistema común donde cada decisión tiene solo una condición y dos resultados posibles. Esto permite al desarrollador crear inteligencia artificial a partir de datos que representan decisiones en el árbol, evitando su codificación rígida. Imaginémoslo en forma de tabla:
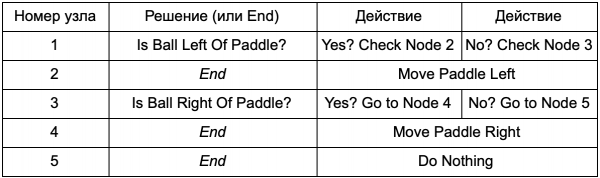
En el lado del código, tendrás un sistema para leer las filas. Crea un nodo para cada una de ellas, conecta la lógica de toma de decisiones basada en la segunda columna y los nodos hijos basados en la tercera y cuarta columna. Aún necesitarás programar las condiciones y acciones, pero ahora la estructura del juego será más compleja. En ella añadirás decisiones y acciones adicionales, y luego configurarás toda la IA simplemente editando un archivo de texto que define el árbol. Luego, pasas el archivo al diseñador de juegos, quien podrá modificar el comportamiento sin recompilar el juego ni cambiar el código.
Los árboles de decisiones son muy útiles cuando se construyen automáticamente a partir de un gran conjunto de ejemplos (por ejemplo, utilizando el algoritmo ID3). Esto los convierte en una herramienta eficiente y de alto rendimiento para clasificar situaciones basadas en los datos obtenidos. Sin embargo, salimos del ámbito de un simple sistema para la selección de acciones por parte de los agentes.
Escenarios
Hemos discutido el sistema del árbol de decisiones que utilizaba condiciones y acciones predefinidas. La persona que diseña la IA puede organizar el árbol como desee, pero todavía debe depender del programador que lo codificó. ¿Qué pasaría si pudiéramos darle al diseñador herramientas para crear sus propias condiciones o acciones?
Para que el programador no tenga que escribir código para las condiciones Is Ball Left Of Paddle e Is Ball Right Of Paddle, puede crear un sistema en el que el diseñador escriba las condiciones para verificar esos valores. Entonces, los datos del árbol de decisiones se verían así:
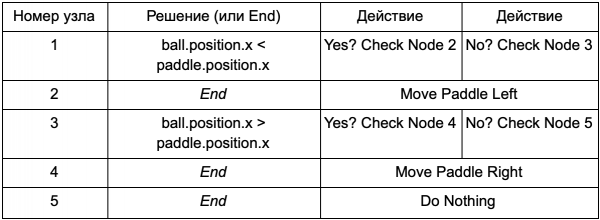
En esencia, es lo mismo que en la primera tabla, pero las soluciones internas tienen su propio código, algo similar a la parte condicional de un operador if. En el código, esto se leería en la segunda columna para los nodos de decisión, pero en lugar de buscar una condición específica para ejecutar (¿Está la bola a la izquierda de la paleta?), evalúa la expresión condicional y devuelve verdadero o falso según corresponda. Esto se hace usando un lenguaje de scripting como Lua o Angelscript, permitiendo al desarrollador trabajar con objetos en su juego (bola y paleta) y crear variables que serán accesibles en el script (bola.posición). Además, el lenguaje de scripting es más simple que C++. No requiere un proceso completo de compilación, lo que lo hace ideal para ajustes rápidos en la lógica del juego y permite a los
programadores" crear las funciones necesarias por sí mismos.
Se puede ir aún más lejos y escribir completamente el árbol de decisiones en el lenguaje de scripting. Este sería un código compuesto de operadores condicionales programados de manera fija (hardcoded), pero estarían en archivos de script externos, es decir, podrían ser modificados sin recompilar todo el programa. A menudo es posible cambiar el archivo de script en tiempo real durante el juego, para probar rápidamente diferentes reacciones de la IA.
Reacción a eventos
Los ejemplos anteriores son perfectos para Pong. Ejecutan continuamente el ciclo Sensar/Pensar/Actuar y actúan según el último estado del mundo. Pero en juegos más complejos, es necesario reaccionar a eventos individuales, en lugar de evaluar todo de una vez. Pong, en tal caso, ya no es un buen ejemplo. Tomemos otro.
Imagina un shooter en el que los enemigos permanecen inmóviles hasta que detectan al jugador, tras lo cual actúan dependiendo de su “especialización”: algunos correrán para “atacar”, otros atacarán desde lejos. Esta sigue siendo una base de sistema reactivo: “si se ve al jugador, haz algo”, pero se puede dividir lógicamente en el evento Jugador Visto (jugador detectado) y la reacción (selecciona una respuesta y ejecútala).
Esto nos lleva de vuelta al ciclo Sensar/Pensar/Actuar. Podemos codificar la parte de Sensar, que revisará en cada cuadro si la IA ve al jugador. Si no, no pasa nada, pero si lo ve, se crea un evento Jugador Visto. El código tendrá una sección separada que dirá: «cuando se produzca el evento Jugador Visto, haz», donde será la respuesta que necesitas para dirigirte a las partes Pensar y Actuar. Así, configurarás las reacciones al evento Jugador Visto: para un personaje que carga, será CargarYAtacar, y para un francotirador, EsconderYDisparar. Estas conexiones se pueden crear en un archivo de datos para una edición rápida sin necesidad de recompilar. Y aquí también se puede usar un lenguaje de scripts.
Tomar decisiones complejas
Aunque los sistemas de reacciones simples son muy efectivos, hay muchas situaciones en las que no son suficientes. A veces es necesario tomar diferentes decisiones basadas en lo que el agente está haciendo en ese momento, pero representarlo como una condición es difícil. A veces hay demasiadas condiciones para representarlas de manera efectiva en un árbol de decisiones o un script. A veces es necesario evaluar de antemano cómo cambiará la situación antes de tomar una decisión sobre el siguiente paso. Para abordar estos problemas se requieren enfoques más complejos.
Máquina de estados finitos
Una máquina de estados finitos o FSM (máquina de estados finitos) es una forma de decir que nuestro agente se encuentra actualmente en uno de varios estados posibles, y que puede pasar de un estado a otro. Hay un número definido de tales estados, de ahí el nombre. El mejor ejemplo de la vida real es un semáforo. En diferentes lugares hay diferentes secuencias de luces, pero el principio es el mismo: cada estado representa algo (detenerse, ir, etc.). El semáforo solo está en un estado en cualquier momento dado y cambia de uno a otro basado en reglas simples.
Con los NPC en los juegos, la historia es similar. Tomemos como ejemplo un guardia con los siguientes estados:
- Patrullando (Patrolling).
- Atacando (Attacking).
- Huyendo (Fleeing).
Y con estas condiciones para cambiar su estado:
- Si el guardia ve a un enemigo, ataca.
- Si el guardia ataca, pero ya no ve al enemigo, vuelve a patrullar.
- Si el guardia ataca, pero está gravemente herido, huye.
También se pueden escribir operadores if con variables de estado del guardia y diversas comprobaciones: si hay enemigos cercanos, cuál es el nivel de salud del NPC, etc. Agreguemos algunos estados más:
- Inactividad (Idling) — entre patrullas.
- Búsqueda (Searching) — cuando un enemigo avistado se ha ocultado.
- Pedir ayuda (Finding Help) — cuando un enemigo es detectado, pero es demasiado fuerte para luchar solo.
Las opciones para cada uno están limitadas; por ejemplo, el guardia no buscará al enemigo oculto si tiene poca salud.
Al final, una gran lista de «si <x и y, но не z>, entonces <p>» puede volverse demasiado extensa, por lo que es necesario formalizar un método que nos permita mantener en mente los estados y las transiciones entre ellos. Para hacer esto, consideraremos todos los estados y bajo cada estado anotaremos en una lista todas las transiciones a otros estados, junto con las condiciones necesarias para ellas.
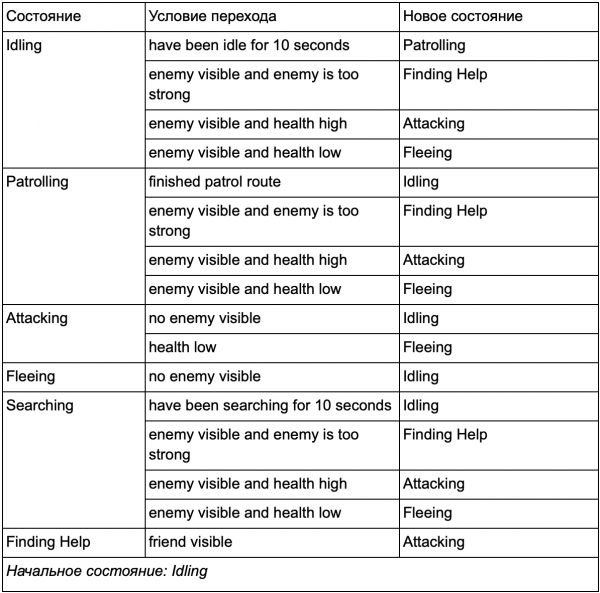
Esta es una tabla de transiciones de estados: una forma compleja de representar una FSM. Dibujemos un diagrama y obtendremos una visión completa de cómo cambia el comportamiento del NPC.
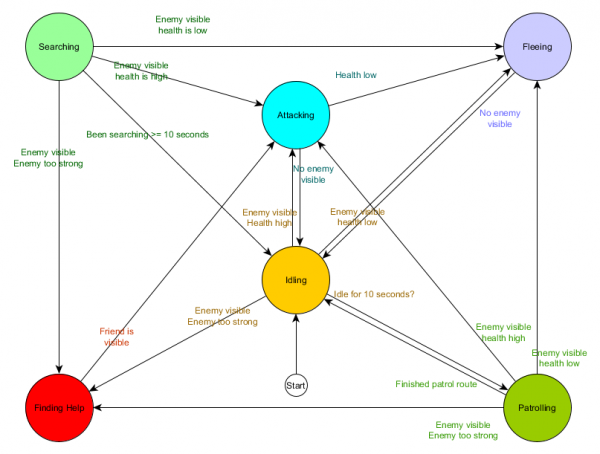
El diagrama refleja la esencia de la toma de decisiones para este agente basada en la situación actual. Además, cada flecha muestra una transición entre estados si la condición al lado de ella es verdadera.
En cada actualización verificamos el estado actual del agente, revisamos la lista de transiciones y si se cumplen las condiciones para la transición, asume un nuevo estado. Por ejemplo, cada frame se verifica si el temporizador de 10 segundos ha expirado, y si es así, el guardia pasa de Idling a Patrolling. De la misma manera, el estado Attacking verifica la salud del agente; si es baja, pasa al estado Fleeing.
Esto es el manejo de transiciones entre estados, pero ¿qué pasa con el comportamiento relacionado con los propios estados? En cuanto a la implementación del comportamiento real para un estado específico, generalmente hay dos tipos de "ganchos" donde asignamos acciones a la FSM:
- Acciones que realizamos periódicamente para el estado actual.
- Acciones que emprendemos al transitar de un estado a otro.
Ejemplos del primer tipo. El estado Patrolling moverá al agente por la ruta de patrulla en cada frame. El estado Attacking intentará iniciar un ataque o cambiar a un estado en el que esto sea posible en cada frame.
Para el segundo tipo, consideremos la transición: "si el enemigo es visible y el enemigo es demasiado fuerte, entonces pasar al estado Finding Help." El agente debe elegir a dónde ir en busca de ayuda y guardar esta información para que el estado Finding Help sepa a dónde acudir. Una vez que se encuentra ayuda, el agente regresa al estado Attacking. En ese momento, querrá informar a su aliado sobre la amenaza, por lo que puede surgir la acción NotifyFriendOfThreat.
Una vez más, podemos ver este sistema a través del ciclo Sense/Think/Act. Sense se manifiesta en los datos utilizados por la lógica de transición. Think son las transiciones disponibles en cada estado. Y Act se lleva a cabo a través de las acciones que se realizan periódicamente dentro del estado o durante las transiciones entre estados.
A veces, la encuesta continua de las condiciones de transición puede ser costosa. Por ejemplo, si cada agente realiza cálculos complejos en cada fotograma para determinar si ve enemigos y entender si puede pasar del estado Patrolling a Attacking, podría consumir mucho tiempo de CPU.
Los cambios importantes en el estado del mundo pueden considerarse eventos que se manejarán a medida que ocurran. En lugar de que la FSM verifique en cada fotograma la condición de transición "¿puede mi agente ver al jugador?", se puede configurar un sistema separado para realizar las verificaciones con menos frecuencia (por ejemplo, 5 veces por segundo). Y el resultado sería emitir Player Seen cuando la verificación pasa.
Esto se pasa a la FSM, que ahora debe pasar a la condición de evento Player Seen recibido y responder adecuadamente. El comportamiento final es el mismo, excepto por una casi imperceptible demora antes de la respuesta. Sin embargo, el rendimiento ha mejorado como resultado de separar parte de Sense en una parte independiente del programa.
Máquina de estados finitos jerárquica
Sin embargo, trabajar con grandes FSM no siempre es conveniente. Si quisiéramos ampliar el estado de ataque, reemplazándolo por MeleeAttacking (cuerpo a cuerpo) y RangedAttacking (a distancia), tendríamos que cambiar las transiciones de todos los demás estados que conducen al estado Attacking (tanto actuales como futuros).
Seguramente habrás notado que en nuestro ejemplo hay muchas transiciones duplicadas. La mayoría de las transiciones en estado de Idling son idénticas a las transiciones en estado de Patrolling. Sería ideal no repetirnos, especialmente si añadimos más estados similares. Tiene sentido agrupar Idling y Patrolling bajo una etiqueta común de "no combativa", donde solo hay un conjunto común de transiciones a los estados de combate. Si consideramos esta etiqueta como un estado, Idling y Patrolling se convertirían en subestados. Ejemplo de uso de una tabla de transiciones separada para un nuevo subestado no combatiente:
Estados principales:
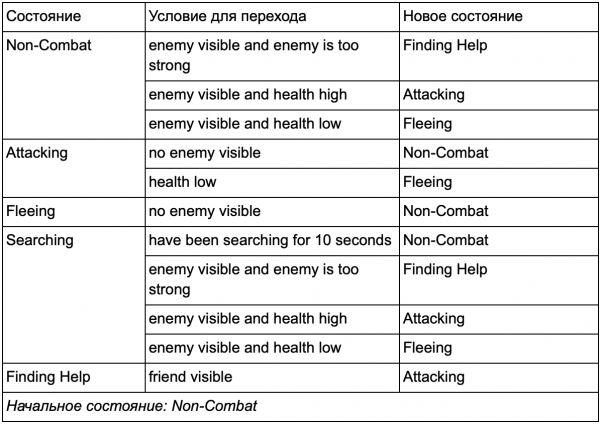
Estado fuera de combate:
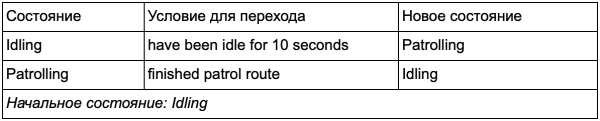
Y en forma de diagrama:
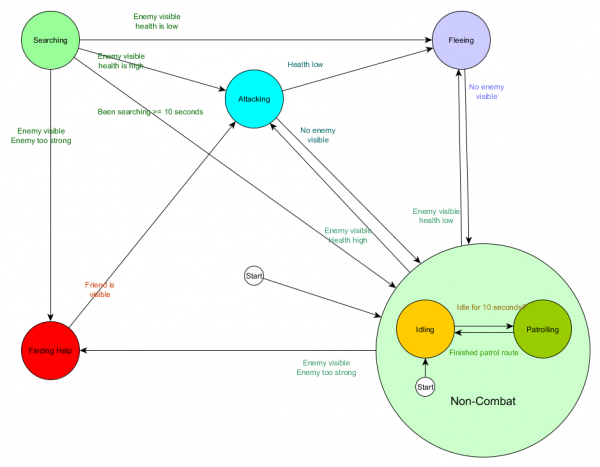
Este es el mismo sistema, pero con un nuevo estado no combatiente que incluye Idling y Patrolling. Con cada estado conteniendo un FSM con subestados (y estos subestados, a su vez, contienen sus propios FSM — y así sucesivamente tantas veces como necesites), obtenemos una Máquina de Estados Finitos Jerárquica o HFSM (máquina de estados finitos jerárquica). Al agrupar el estado no combatiente, hemos eliminado un montón de transiciones redundantes. Lo mismo podemos hacer para cualquier nuevo estado con transiciones comunes. Por ejemplo, si en el futuro ampliamos el estado Attacking a los estados MeleeAttacking y MissileAttacking, estos serán subestados que transicionan entre sí en función de la distancia al enemigo y la disponibilidad de municiones. Como resultado, los modelos de comportamiento complejos y los submodelos de comportamiento se pueden representar con un mínimo de transiciones duplicadas.
Árbol de comportamientos
Con HFSM se crean combinaciones complejas de comportamientos de manera sencilla. Sin embargo, hay una pequeña dificultad, ya que la toma de decisiones en forma de reglas de transición está fuertemente vinculada al estado actual. Y en muchos juegos, esto es justo lo que se necesita. Un uso meticuloso de la jerarquía de estados puede reducir la cantidad de repeticiones en las transiciones. Pero a veces se requieren reglas que funcionen independientemente del estado en el que te encuentres o que se apliquen casi en cualquier estado. Por ejemplo, si la salud del agente cae al 25%, querrás que huya independientemente de si ha estado en combate, ocioso o conversando; tendrás que añadir esta condición en cada estado. Y si tu diseñador quiere más tarde cambiar el umbral de baja salud del 25% al 10%, tendrás que lidiar con ello nuevamente.
Idealmente, para esta situación se necesita un sistema en el que las decisiones sobre 'qué estado adoptar' estén fuera de los propios estados, de modo que los cambios se realicen solo en un lugar sin alterar las condiciones de transición. Aquí es donde aparecen los árboles de comportamiento.
Existen varias formas de implementarlos, pero la esencia para todos es aproximadamente la misma y se asemeja a un árbol de decisiones: el algoritmo comienza desde un nodo 'raíz', y en el árbol hay nodos que representan decisiones o acciones. Sin embargo, hay algunas diferencias clave:
- Ahora los nodos devuelven uno de tres valores: Succeeded (si la tarea se completó), Failed (si no se puede iniciar) o Running (si todavía está en ejecución y no hay un resultado final).
- Ya no hay nodos de decisión para elegir entre dos alternativas. En su lugar, hay nodos Decorator, que tienen un solo nodo hijo. Si tienen éxito, ejecutan su único nodo hijo.
- Los nodos que realizan acciones devuelven el valor Running para indicar que las acciones están en curso.
Este pequeño conjunto de nodos se puede combinar para crear una gran cantidad de modelos de comportamiento complejos. Imaginemos el HFSM de un guardia del ejemplo anterior como un árbol de comportamiento:
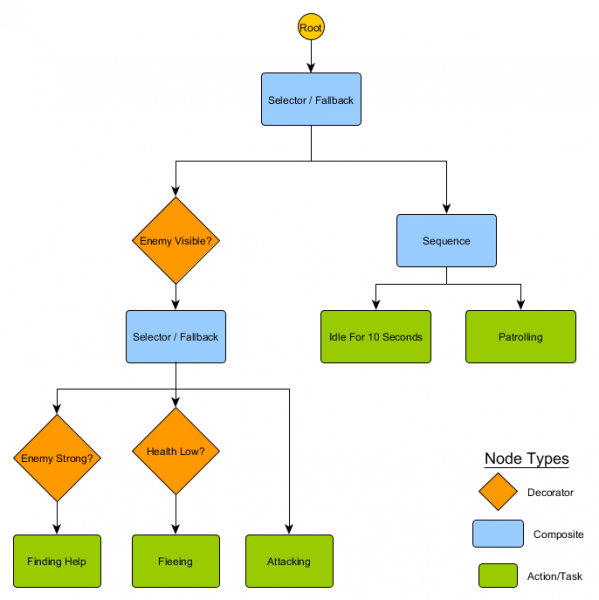
Con esta estructura, no debería haber una transición explícita de los estados Idling/Patrolling al estado Attacking o a cualquier otro. Si el enemigo es visible y la salud del personaje es baja, la ejecución se detendrá en el nodo Fleeing, sin importar qué nodo estaba ejecutando anteriormente: Patrolling, Idling, Attacking o cualquiera otro.
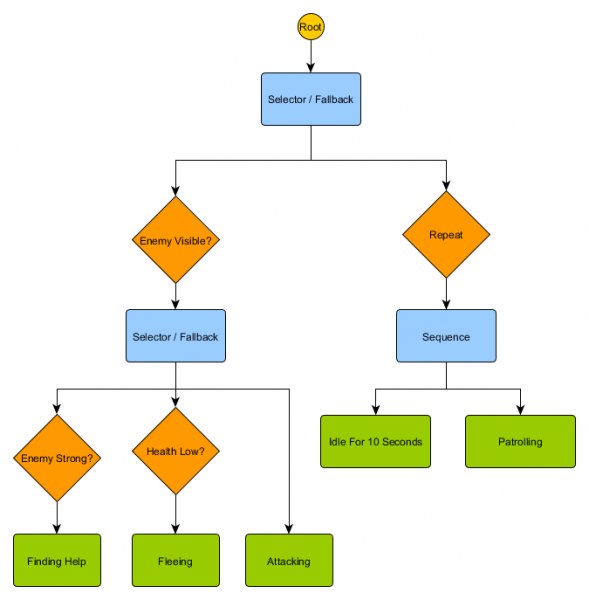
Los árboles de comportamiento son complejos: hay muchas maneras de construirlos, y encontrar la combinación adecuada de decoradores y nodos compuestos puede ser problemático. También hay preguntas sobre con qué frecuencia se debe revisar el árbol: ¿queremos revisarlo en cada parte o solo cuando cambia una de las condiciones? ¿Cómo almacenar el estado relacionado con los nodos: cómo saber cuándo estuvimos en estado Idling durante 10 segundos o cómo saber qué nodos se ejecutaron la última vez para manejar correctamente la secuencia?
Es por eso que existen muchas implementaciones. Por ejemplo, en algunos sistemas, los nodos decoradores han sido reemplazados por decoradores integrados. Estos reevalúan el árbol cuando las condiciones del decorador cambian, ayudan a conectar nodos y proporcionan actualizaciones periódicas.
Sistema basado en utilidad
Algunos juegos tienen una variedad de mecánicas diferentes. Es deseable que obtengan todas las ventajas de las reglas de transición simples y generales, pero no necesariamente en forma de un árbol completo de comportamiento. En lugar de tener un conjunto claro de elecciones o un árbol de acciones posibles, es más sencillo estudiar todas las acciones y elegir la más adecuada en ese momento.
Un sistema basado en utilidad ayudará en esto. Es un sistema donde el agente tiene múltiples acciones y él mismo elige cuál realizar, basándose en la utilidad relativa de cada una. Donde la utilidad es una medida arbitraria de cuán importante o deseable es ejecutar esa acción para el agente.
La utilidad calculada de una acción, basada en el estado actual y el entorno, puede ser verificada por el agente y puede elegir el estado alternativo más adecuado en cualquier momento. Esto es similar a un FSM, salvo que las transiciones se determinan por la evaluación de cada estado potencial, incluyendo el actual. Tenga en cuenta que elegimos la acción más útil para la transición (o nos quedamos si ya la hemos ejecutado). Para mayor variedad, esto puede ser una elección ponderada, pero aleatoria de una pequeña lista.
El sistema asigna un rango arbitrario de valores de utilidad, por ejemplo, de 0 (totalmente indeseable) a 100 (completamente deseable). Cada acción tiene un conjunto de parámetros que influyen en el cálculo de este valor. Volviendo a nuestro ejemplo del guardia:
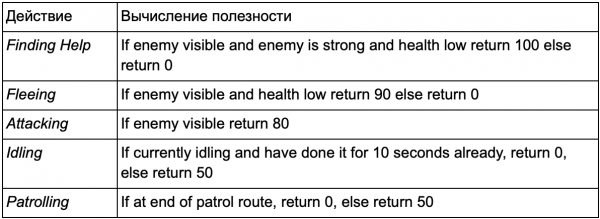
Las transiciones entre acciones son ambiguas: cualquier estado puede seguir a cualquier otro. Las prioridades de las acciones están en los valores de utilidad devueltos. Si un enemigo es visible y este enemigo es fuerte, mientras que la salud del personaje es baja, tanto Fleeing como FindingHelp devolverán altos valores no nulos. Sin embargo, FindingHelp siempre será más alto. De esta manera, las acciones no relacionadas con el combate nunca devuelven más de 50, por lo que siempre serán inferiores a las de combate. Esto debe tenerse en cuenta al crear acciones y calcular su utilidad.
En nuestro ejemplo, las acciones devuelven ya sea un valor constante fijo o uno de dos valores fijos. Un sistema más realista sugiere devolver una evaluación de un rango continuo de valores. Por ejemplo, la acción de Huida devuelve valores de utilidad más altos si la salud del agente es baja, mientras que la acción de Ataque devuelve valores más bajos si el enemigo es demasiado fuerte. Debido a esto, la acción de Huida tiene prioridad sobre el Ataque en cualquier situación en que el agente sienta que no tiene suficiente salud para vencer al oponente. Esto permite cambiar las prioridades de las acciones basándose en una serie de criterios, lo que hace que este enfoque sea más flexible y variable que un árbol de comportamiento o FSM.
Cada acción tiene muchas condiciones para calcular el programa. Estas se pueden escribir en un lenguaje de scripting o como una serie de fórmulas matemáticas. En The Sims, que modela la rutina diaria de un personaje, se añade un nivel adicional de cálculos: el agente recibe una serie de 'motivaciones' que afectan las evaluaciones de utilidad. Si el personaje tiene hambre, con el tiempo tendrá aún más hambre, y el resultado de utilidad de la acción ComerComida aumentará hasta que el personaje la realice, reduciendo su nivel de hambre y devolviendo el valor de ComerComida a cero.
La idea de elegir acciones basadas en un sistema de puntuación es bastante simple, por lo que un sistema basado en la utilidad se puede utilizar como parte de los procesos de toma de decisiones de IA, y no como un reemplazo completo. Un árbol de decisiones puede solicitar la evaluación de utilidad de dos nodos hijos y elegir el de mayor puntuación. De manera similar, un árbol de comportamiento puede tener un nodo compuesto de Utilidad para evaluar la utilidad de las acciones y decidir cuál elemento hijo ejecutar.
Movimiento y navegación
En los ejemplos anteriores teníamos una plataforma que movíamos hacia la izquierda o hacia la derecha, y un guardián que patrullaba o atacaba. Pero, ¿cómo manejamos el movimiento del agente durante un período de tiempo determinado? ¿Cómo establecemos la velocidad, cómo evitamos obstáculos y cómo planificamos una ruta si llegar al destino es más complicado que simplemente moverse en línea recta? Vamos a analizarlo.
Gestión
En la etapa inicial, asumiremos que cada agente tiene un valor de velocidad que incluye qué tan rápido se mueve y en qué dirección. Puede medirse en metros por segundo, kilómetros por hora, píxeles por segundo, etc. Recordando el ciclo Sensar/Pensar/Actuar, podemos imaginar que la parte de Pensar elige la velocidad y la parte de Actuar aplica esta velocidad al agente. Normalmente, en los juegos hay un sistema físico que realiza esta tarea por usted, evaluando el valor de velocidad de cada objeto y ajustándolo. Por lo tanto, se puede dejar que la IA tenga una sola tarea: decidir qué velocidad debe tener el agente. Si se sabe dónde debe estar el agente, se debe mover en la dirección correcta a la velocidad establecida. Una ecuación muy trivial:
desired_travel = destination_position – agent_position
Imagina un mundo 2D. El agente se encuentra en el punto (-2,-2), el destino está en alguna parte al noreste en el punto (30, 20), y la ruta necesaria para que el agente llegue allí es (32, 22). Supongamos que estas posiciones se miden en metros; si tomamos la velocidad del agente como 5 metros por segundo, entonces escalaremos nuestro vector de movimiento y obtendremos una velocidad de aproximadamente (4.12, 2.83). Con estos parámetros, el agente llegaría a su destino en casi 8 segundos.
Los valores se pueden recalcular en cualquier momento. Si el agente está a mitad de camino hacia el objetivo, el movimiento sería la mitad de la longitud, pero como la velocidad máxima del agente es de 5 m/s (lo decidimos anteriormente), la velocidad será la misma. Esto también funciona para objetivos en movimiento, permitiendo al agente realizar pequeños ajustes a medida que se mueven.
Pero queremos más variabilidad; por ejemplo, aumentar la velocidad lentamente para simular un personaje que pasa de estar de pie a correr. Lo mismo se puede hacer al final antes de detenerse. Estas características se conocen como comportamientos de dirección, cada uno de los cuales tiene nombres específicos: Buscar (Seek), Huir (Flee), Llegada (Arrival), etc. La idea es que las fuerzas de aceleración pueden aplicarse a la velocidad del agente, basándose en la comparación de la posición del agente y su velocidad actual con respecto al destino, para utilizar diferentes métodos de movimiento hacia el objetivo.
Cada comportamiento tiene un objetivo ligeramente diferente. Seek y Arrival son formas de mover al agente hacia un destino. Obstacle Avoidance (evitación de obstáculos) y Separation (separación) ajustan el movimiento del agente para sortear obstáculos en su camino hacia el objetivo. Alignment (alineación) y Cohesion (cohesión) mantienen a los agentes juntos durante su movimiento. Cualquier número de diferentes comportamientos de dirección puede sumarse para obtener un solo vector que considere todos los factores. Un agente utiliza los comportamientos Arrival, Separation y Obstacle Avoidance para mantenerse alejado de las paredes y otros agentes. Este enfoque funciona bien en espacios abiertos sin detalles adicionales.
En condiciones más difíciles, la combinación de diferentes comportamientos funciona peor; por ejemplo, un agente puede quedar atrapado en una pared debido al conflicto entre Arrival y Obstacle Avoidance. Por lo tanto, se deben considerar opciones que sean más complejas que simplemente sumar todos los valores. Una forma de hacerlo es, en lugar de sumar los resultados de cada comportamiento, considerar el movimiento en diferentes direcciones y elegir la mejor opción.
Sin embargo, en un entorno complejo con callejones sin salida y decisiones sobre hacia dónde ir, necesitaremos algo aún más avanzado.
Búsqueda de caminos
Los comportamientos de dirección son ideales para movimientos simples en espacios abiertos (un campo de fútbol o una arena), donde ir de A a B es un camino directo con pequeñas desviaciones alrededor de obstáculos. Para rutas más complejas, necesitamos pathfinding (búsqueda de caminos), que es una forma de explorar el mundo y tomar decisiones sobre la ruta a seguir.
La forma más simple es superponer una cuadrícula sobre cada celda adyacente al agente y evaluar en cuáles se permite moverse. Si alguna de ellas es un destino, siga desde allí la ruta de cada celda a la anterior hasta que llegue al inicio. Esa es la ruta. De lo contrario, repita el proceso con las celdas más cercanas hasta que encuentre el destino o se agoten las celdas (lo que indica que no hay ruta posible). Esto se conoce formalmente como Búsqueda en Amplitud o BFS (Breadth-First Search). En cada paso, mira en todas las direcciones (de ahí lo de amplitud). El espacio de búsqueda se asemeja a un frente de ola que se desplaza hasta alcanzar el lugar buscado: el área de búsqueda se expande en cada paso hasta que se alcanza el punto final, después de lo cual se puede rastrear el camino de vuelta al inicio.
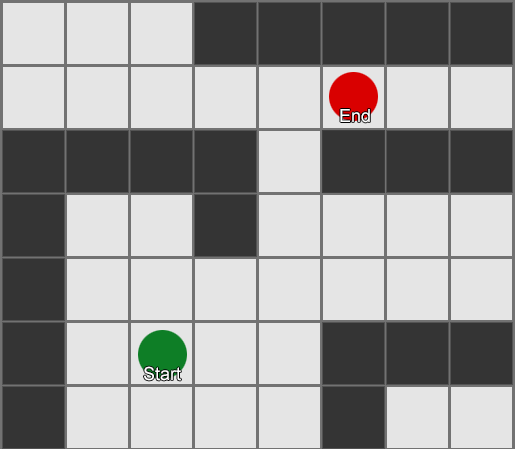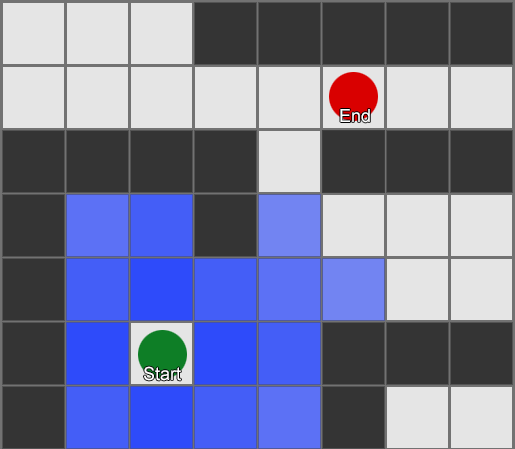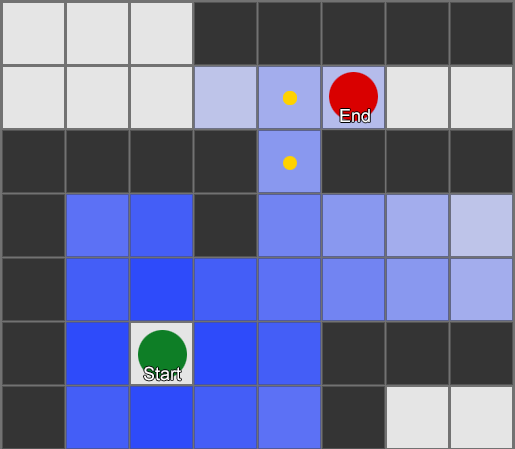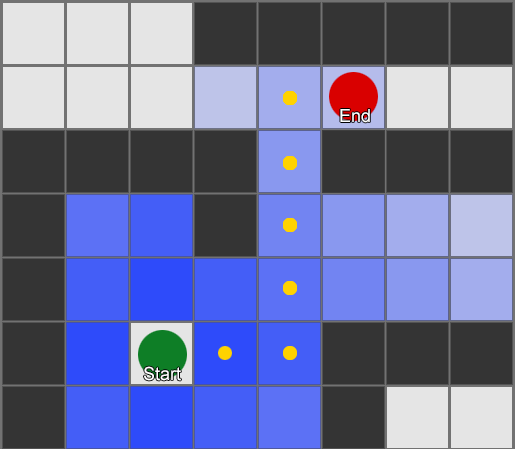
Como resultado, obtendrá una lista de celdas a través de las cuales se compone la ruta necesaria. Este es el camino (de ahí el término pathfinding) — una lista de lugares que el agente visitará al dirigirse al destino.
Dado que conocemos la posición de cada celda en el mundo, se pueden usar comportamientos de dirección para moverse por el camino — de nodo 1 a nodo 2, luego de nodo 2 a nodo 3, y así sucesivamente. La opción más simple es dirigirse al centro de la siguiente celda, pero es aún mejor detenerse a mitad de arista entre la celda actual y la siguiente. Esto permitirá al agente recortar esquinas en giros cerrados.
El algoritmo BFS tiene desventajas: explora tantas celdas en la dirección "incorrecta" como en la "correcta". Aquí es donde aparece un algoritmo más sofisticado llamado A* (A estrella). Funciona de manera similar, pero en lugar de explorar ciegamente las celdas vecinas (luego las vecinas de las vecinas, y así sucesivamente), recopila nodos en una lista y los organiza de tal manera que el siguiente nodo a investigar siempre sea el que conducirá al camino más corto. Los nodos se ordenan en función de una heurística que toma en cuenta dos cosas: el "costo" de la ruta hipotética hacia la celda deseada (incluyendo cualquier costo de movimiento) y una estimación de qué tan lejos está esa celda del destino (dirigiendo la búsqueda en la dirección correcta).
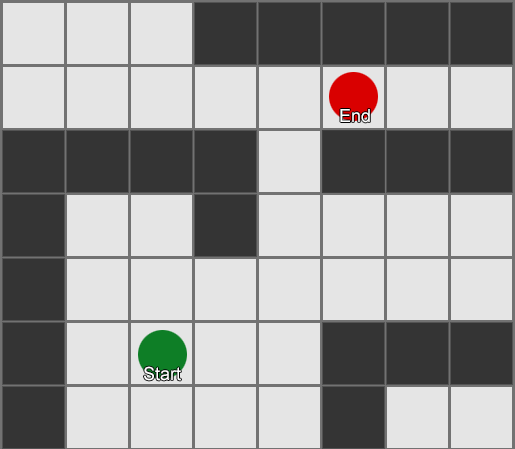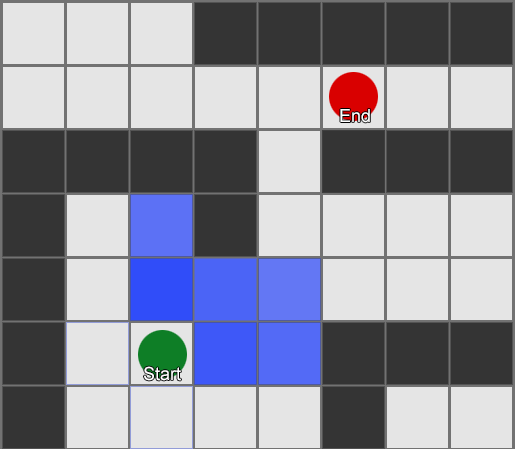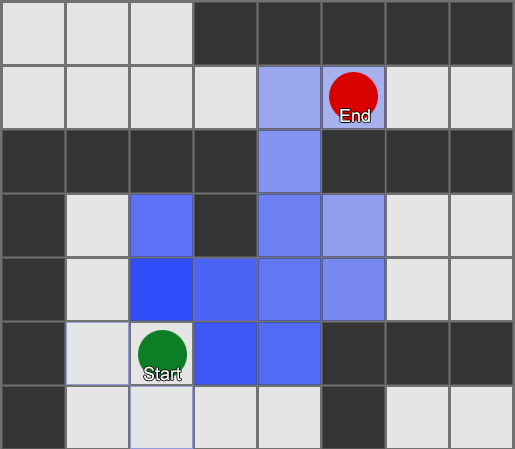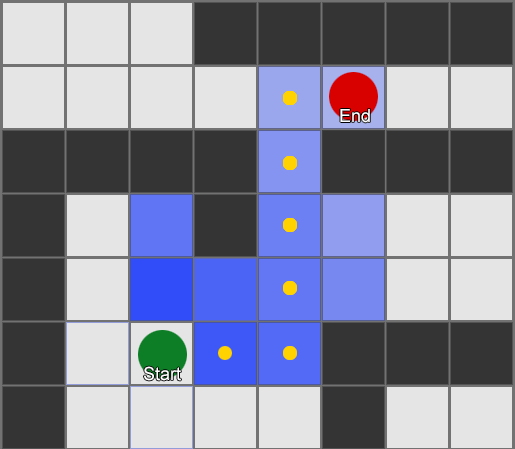
En este ejemplo se muestra que el agente explora un cuadrado a la vez, eligiendo cada vez el vecino que es más prometedor. El camino resultante es el mismo que en el BFS, pero se consideraron menos cuadrados en el proceso, lo que tiene un gran impacto en el rendimiento del juego.
Movimiento sin rejilla
Pero la mayoría de los juegos no están dispuestos en rejilla, y a menudo no se puede hacer sin comprometer el realismo. Se requieren compromisos. ¿Qué tamaño deberían tener los cuadrados? Si son demasiado grandes, no podrán representar correctamente pasillos o giros pequeños; si son demasiado pequeños, habrá demasiados cuadrados para buscar, lo que finalmente tomará mucho tiempo.
Lo primero que hay que entender es que la rejilla nos da un gráfico de nodos interconectados. Los algoritmos A* y BFS trabajan en gráficos y no se preocupan en absoluto por nuestra rejilla. Podríamos colocar nodos en cualquier lugar del mundo del juego: siempre que haya conexión entre dos nodos conectados, así como entre el punto de inicio y el de destino y al menos uno de los nodos, el algoritmo funcionará tan bien como antes. Esto se conoce a menudo como un sistema de puntos de referencia (waypoint), ya que cada nodo representa una posición significativa en el mundo que puede ser parte de cualquiera de varios caminos hipotéticos.
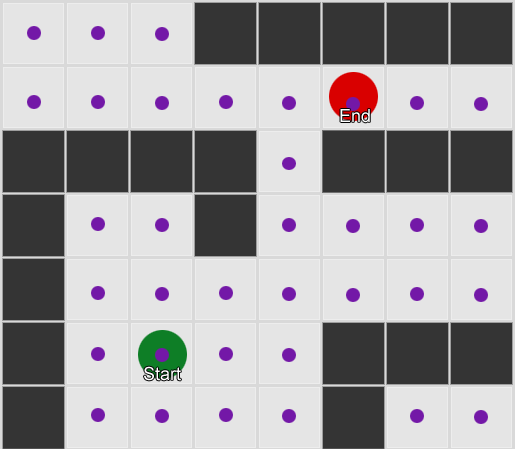
Ejemplo 1: un nodo en cada cuadrado. La búsqueda comienza desde el nodo en el que se encuentra el agente y termina en el nodo del cuadrado requerido.
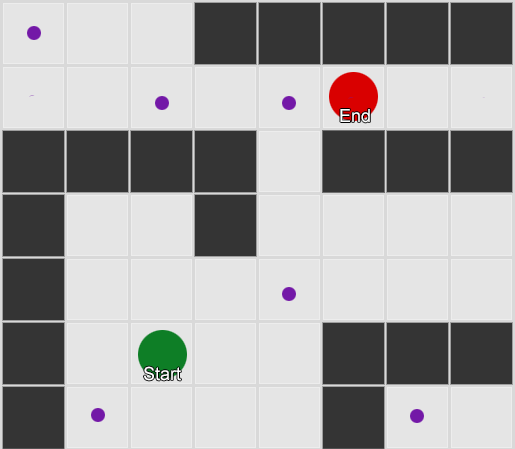
Ejemplo 2: un conjunto más pequeño de nodos (puntos de referencia). La búsqueda comienza en el cuadrado con el agente, pasa por el número necesario de nodos y luego continúa hasta el destino.
Este es un sistema bastante flexible y potente. Pero se necesita cierta precaución en las decisiones sobre dónde y cómo colocar el waypoint, de lo contrario, los agentes pueden simplemente no ver el punto más cercano y no podrán comenzar el camino. Sería más sencillo si pudiéramos colocar automáticamente los puntos de referencia en función de la geometría del mundo.
Aquí es donde entra en juego el navigation mesh o navmesh (rejilla de navegación). Esta es generalmente una rejilla 2D de triángulos que se superpone a la geometría del mundo, en todas partes donde se permite que el agente camine. Cada uno de los triángulos de la rejilla se convierte en un nodo en el gráfico y tiene hasta tres triángulos adyacentes que se convierten en nodos vecinos en el gráfico.
Esta imagen es un ejemplo del motor Unity: ha analizado la geometría del mundo y ha creado un navmesh (en la captura de pantalla de color azul claro). Cada polígono en el navmesh es un área donde un agente puede estar de pie o moverse de un polígono a otro. En este ejemplo, los polígonos son más pequeños que los pisos en los que se encuentran, para tener en cuenta los tamaños del agente que sobresalen de su posición nominal.
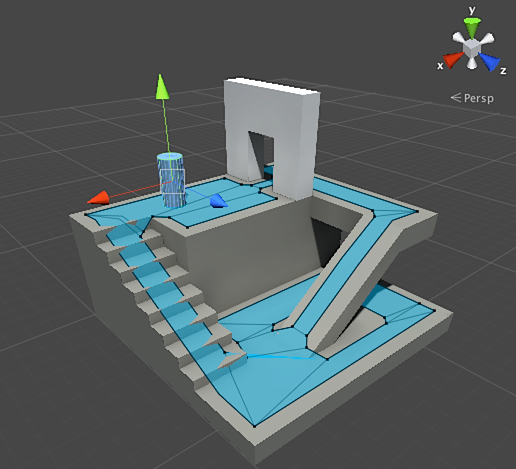
Podemos buscar una ruta a través de esta cuadrícula, utilizando nuevamente el algoritmo A*. Esto nos dará una ruta prácticamente ideal en el mundo, que tiene en cuenta toda la geometría y, al mismo tiempo, no requiere nodos adicionales ni la creación de puntos de referencia.
La búsqueda de caminos es un tema demasiado extenso que no se puede cubrir en una sola sección de un artículo. Si desea estudiarlo más a fondo, puede hacerlo a través del .
Planificación
Con la búsqueda de caminos, hemos visto que a veces no es suficiente simplemente elegir una dirección y avanzar: debemos elegir una ruta y realizar varios giros para llegar a nuestro destino. Podemos generalizar esta idea: alcanzar un objetivo no es solo el siguiente paso, sino toda una secuencia, donde a veces es necesario mirar hacia adelante algunos pasos para saber cuál debe ser el primero. Esto se llama planificación. La búsqueda de caminos puede considerarse como uno de los varios complementos de la planificación. Desde el punto de vista de nuestro ciclo Sentir/Pensar/Actuar, es donde la parte Pensar planifica varias partes Actuar para el futuro.
Tomemos como ejemplo el juego de cartas Magic: The Gathering. Nosotros jugamos primero con esta mano de cartas:
- Pantano — proporciona 1 maná negro (carta de tierra).
- Bosque — proporciona 1 maná verde (carta de tierra).
- Mago Fugitivo — requiere 1 maná azul para invocarse.
- Místico Elfo — requiere 1 maná verde para invocarse.
Ignoramos las otras tres cartas para simplificar. Según las reglas, al jugador se le permite jugar 1 carta de tierra por turno, puede 'tapar' esta carta para extraer maná de ella y luego usar hechizos (incluyendo invocar criaturas) según la cantidad de maná. En esta situación, el jugador sabe que debe jugar Bosque, 'tapar' 1 maná verde y luego invocar Místico Elfo. Pero, ¿cómo puede adivinar esto la IA del juego?
Planificación simple
El enfoque trivial es probar cada acción por turno hasta que no queden opciones disponibles. Al mirar las cartas, la IA ve que puede jugar Swamp. Y lo juega. ¿Quedan otras acciones en este turno? No puede invocar ni a Elvish Mystic ni a Fugitive Wizard, ya que requieren mana verde y azul respectivamente, y Swamp solo proporciona mana negra. Ya no podrá jugar Forest porque ya jugó Swamp. Por lo tanto, la IA del juego actuó de acuerdo con las reglas, pero lo hizo mal. Se puede mejorar.
La planificación puede encontrar una lista de acciones que llevan el juego al estado deseado. Así como cada cuadrado en el camino tiene vecinos (en pathfinding), cada acción en el plan también tiene vecinos o sucesores. Podemos buscar estas acciones y las subsiguientes hasta que alcancemos el estado deseado.
En nuestro ejemplo, el resultado deseado es «invocar una criatura, si es posible». Al comienzo del turno, solo vemos dos acciones posibles permitidas por las reglas del juego:
1. Jugar Swamp (resultado: Swamp en juego)
2. Jugar Forest (resultado: Forest en juego)
Cada acción tomadas puede conducir a acciones adicionales y cerrar otras, nuevamente dependiendo de las reglas del juego. Imagina que jugamos Swamp; esto eliminará Swamp como siguiente paso (ya lo hemos jugado), y también eliminará Forest (porque según las reglas solo se puede jugar una carta de tierra por turno). Después, la IA añade como siguiente paso – obtener 1 mana negra, porque no hay otras opciones. Si avanza y elige Tap the Swamp, obtendrá 1 unidad de mana negra y no podrá hacer nada con ella.
1. Jugar Swamp (resultado: Swamp en juego)
1.1 «Tapiar» Swamp (resultado: Swamp «tapada», +1 unidad de mana negra)
No hay acciones disponibles – FIN
2. Jugar Forest (resultado: Forest en juego)
La lista de acciones es corta, nos hemos estancado. Repetimos el proceso para la siguiente acción. Jugamos Forest, desbloqueamos la acción «obtener 1 mana verde», que a su vez abrirá una tercera acción: invocar a Elvish Mystic.
1. Jugar Swamp (resultado: Swamp en juego)
1.1 «Tapiar» Swamp (resultado: Swamp «tapada», +1 unidad de mana negra)
No hay acciones disponibles – FIN
2. Jugar Forest (resultado: Forest en juego)
2.1 «Tapiar» Forest (resultado: Forest «tapada», +1 unidad de mana verde)
2.1.1 Invocar a Elvish Mystic (resultado: Elvish Mystic en juego, -1 unidad de mana verde)
No hay acciones disponibles – FIN
Finalmente, hemos explorado todas las acciones posibles y encontramos un plan para invocar una criatura.
Este es un ejemplo muy simplificado. Es preferible elegir el mejor plan posible en lugar de cualquiera que cumpla con ciertos criterios. Por lo general, se pueden evaluar los planes potenciales en función del resultado final o el beneficio total de su ejecución. Puedes asignarte 1 punto por jugar una carta de tierra y 3 puntos por invocar una criatura. Jugar un Swamp te daría 1 punto. Y jugar un Forest → Tap the Forest → invocar un Elvish Mystic te daría 4 puntos de inmediato.
Así es como funciona la planificación en Magic: The Gathering, pero esta misma lógica se aplica en otras situaciones. Por ejemplo, mover un peón para hacer espacio para el movimiento de un alfil en el ajedrez. O esconderse detrás de una pared para disparar de forma segura en XCOM. En general, ya entiendes la idea.
Planificación mejorada
A veces hay demasiadas acciones potenciales para considerar cada posible opción. Volviendo al ejemplo de Magic: The Gathering: supongamos que en el juego tienes varias cartas de tierra y criaturas en la mano; el número de combinaciones posibles de movimientos puede contarse por decenas. Hay varias soluciones al problema.
La primera forma es el backwards chaining (cadena inversa). En lugar de probar todas las combinaciones, es mejor comenzar con el resultado final y tratar de encontrar una ruta directa. En lugar de ir del árbol raíz a una hoja específica, nos movemos en la dirección opuesta: de la hoja a la raíz. Este método es más simple y rápido.
Si el oponente tiene 1 punto de salud, podemos encontrar un plan para "infligir 1 o más puntos de daño". Para lograr esto, es necesario cumplir con una serie de condiciones:
1. El daño puede ser infligido por un hechizo: debe estar en la mano.
2. Para jugar el hechizo, se necesita maná.
3. Para obtener maná, es necesario jugar una carta de tierra.
4. Para jugar una carta de tierra, debe estar en la mano.
Otro método es el best-first search (búsqueda de mejor primero). En lugar de probar todos los caminos, elegimos el más apropiado. A menudo, este método proporciona un plan óptimo sin costos innecesarios en la búsqueda. A* es una forma de búsqueda de mejor primero: al explorar las rutas más prometedoras desde el principio, ya puede encontrar el mejor camino sin necesidad de verificar otras opciones.
Una opción interesante y cada vez más popular de búsqueda best-first es la Búsqueda por Árbol de Monte Carlo. En lugar de adivinar qué planes son mejores que otros al elegir cada acción subsiguiente, el algoritmo selecciona sucesores aleatorios en cada paso, hasta alcanzar el final (cuando el plan conduce a una victoria o derrota). Luego, el resultado final se utiliza para incrementar o disminuir la evaluación del "peso" de las opciones anteriores. Repitiendo este proceso varias veces, el algoritmo proporciona una buena evaluación de cuál es el mejor siguiente paso, incluso si la situación cambia (si el oponente toma medidas para obstaculizar al jugador).
En el relato sobre planificación en juegos, no se puede pasar por alto el Goal-Oriented Action Planning o GOAP (planificación de acciones orientada a objetivos). Este es un método ampliamente utilizado y debatido, pero además de algunos detalles distintivos, es esencialmente un método de encadenamiento inverso del que hablamos anteriormente. Si la tarea es "destruir al jugador", y el jugador está detrás de una cobertura, el plan puede ser: destrúyelo con una granada → consíguela → lánzala.
Generalmente hay múltiples objetivos, cada uno con su prioridad. Si el objetivo de más alta prioridad no se puede cumplir (ninguna combinación de acciones crea el plan "destruir al jugador" porque el jugador no es visible), la IA regresará a los objetivos de menor prioridad.
Aprendizaje y adaptación
Ya hemos mencionado que la IA de los juegos generalmente no utiliza aprendizaje automático, porque no se adapta bien para controlar agentes en tiempo real. Pero eso no significa que no se pueda tomar prestado algo de este campo. Queremos que un oponente en un shooter sea capaz de aprender algo. Por ejemplo, conocer las mejores posiciones en el mapa. O un oponente en un juego de lucha que bloqueara los combos más utilizados por el jugador, motivándolo a usar otros. Así que el aprendizaje automático en tales situaciones puede ser muy útil.
Estadísticas y probabilidades
Antes de entrar en ejemplos complejos, evaluemos hasta dónde podemos llegar, tomando algunas medidas simples y utilizándolas para tomar decisiones. Por ejemplo, la estrategia en tiempo real — ¿cómo podemos determinar si un jugador puede comenzar un ataque en los primeros minutos del juego y qué defensa preparar contra eso? Podemos estudiar la experiencia previa del jugador para entender cuál podría ser su reacción futura. Empezaremos por reconocer que no contamos con esos datos iniciales, pero podemos recopilarlos: cada vez que la IA juega contra un humano, puede registrar el tiempo del primer ataque. Después de varias sesiones, obtendremos un promedio del tiempo en que el jugador atacará en el futuro.
Los promedios también tienen un problema: si un jugador ha 'rushado' 20 veces y ha jugado despacio 20 veces, los valores necesarios estarán en algún lugar del medio, lo cual no nos dará información útil. Una solución es limitar los datos de entrada — se pueden considerar solo los últimos 20 casos.
Un enfoque similar se utiliza al evaluar la probabilidad de ciertas acciones, asumiendo que las preferencias pasadas del jugador serán las mismas en el futuro. Si un jugador nos ataca cinco veces con un bola de fuego, dos veces con un rayo y una vez cuerpo a cuerpo, es evidente que prefiere la bola de fuego. Extrapolamos y vemos la probabilidad de uso de diferentes armas: bola de fuego = 62.5%, rayo = 25% y cuerpo a cuerpo = 12.5%. Nuestra IA de juego necesita prepararse para defenderse del fuego.
Otro método interesante es utilizar el Clasificador Bayesiano Naive (naive Bayes classifier) para estudiar grandes volúmenes de datos de entrada y clasificar la situación, de modo que la IA reaccione de manera adecuada. Los clasificadores bayesianos son más conocidos por su uso en filtros de spam de correo electrónico. Allí investigan las palabras, las comparan con dónde han aparecido anteriormente (en spam o no) y sacan conclusiones sobre los correos entrantes. Podemos hacer lo mismo incluso con una menor cantidad de datos de entrada. Basándonos en toda la información útil que ve la IA (por ejemplo, qué unidades enemigas han sido creadas, o qué hechizos están utilizando, o qué tecnologías han investigado), y el resultado final (guerra o paz, 'rushar' o defenderse, etc.) — elegiremos el comportamiento adecuado para la IA.
Todos estos métodos de aprendizaje son suficientes, pero es preferible utilizarlos basándose en datos de pruebas. La IA aprenderá a adaptarse a las diferentes estrategias que hayan usado tus testers de juego. Una IA que se adapta al jugador después del lanzamiento puede volverse demasiado predecible o, por el contrario, demasiado difícil de vencer.
Adaptación basada en valores
Teniendo en cuenta el contenido de nuestro mundo de juego y sus reglas, podemos modificar el conjunto de valores que impactan las decisiones, en lugar de utilizar únicamente los datos de entrada. Lo hacemos así:
- Permite que la IA recopile datos sobre el estado del mundo y eventos clave durante el juego (como se indicó anteriormente).
- Cambiaremos algunos valores importantes (value) basándonos en estos datos.
- Implementaremos nuestras decisiones, basadas en el procesamiento o evaluación de estos valores.
Por ejemplo, un agente tiene varias habitaciones para elegir en un mapa de un juego de disparos en primera persona. Cada habitación tiene su propio value, que determina cuán deseable es para visitar. La IA elige al azar a qué habitación ir, basándose en el value. Luego, el agente recuerda en qué habitación fue asesinado y reduce su value (la probabilidad de que regrese allí). De manera similar en la situación opuesta: si el agente destruye a muchos oponentes, el value de la habitación aumenta.
Modelo de Markov
¿Qué pasaría si utilizamos los datos recopilados para hacer pronósticos? Si recordamos cada habitación donde vemos al jugador durante un periodo de tiempo determinado, podremos predecir a qué habitación puede moverse el jugador. Al rastrear y registrar los movimientos del jugador entre habitaciones (values), podemos hacer predicciones.
Tomemos tres habitaciones: roja, verde y azul. Y también las observaciones que registramos mientras observábamos una sesión de juego:
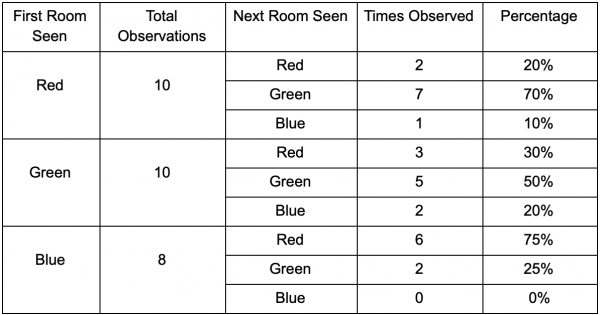
La cantidad de observaciones para cada habitación es casi igual; aún no sabemos dónde hacer un buen lugar para una emboscada. La recopilación de estadísticas también se complica con el respawn de los jugadores, que aparecen uniformemente en todo el mapa. Pero los datos de la siguiente habitación a la que entran después de aparecer en el mapa ya son útiles.
Es evidente que la sala verde satisface a los jugadores; la mayoría de las personas que están en la sala roja la eligen, y el 50% de estas se queda allí. Por el contrario, la sala azul no es popular, casi no recibe visitas, y si hay visitas, son breves.
Pero los datos nos dicen algo más importante: cuando un jugador se encuentra en la sala azul, la siguiente sala en la que probablemente lo veremos será la roja, y no la verde. A pesar de que la sala verde es más popular que la roja, la situación cambia si el jugador está en la sala azul. El siguiente estado (es decir, la sala a la que el jugador se trasladará) depende del estado anterior (es decir, la sala en la que se encuentra actualmente el jugador). Gracias al estudio de las dependencias, podremos hacer pronósticos más precisos que si simplemente contáramos las observaciones de manera independiente entre sí.
Predecir el estado futuro basado en los datos del estado pasado se llama modelo de Markov, y tales ejemplos (con las salas) se denominan cadenas de Markov. Dado que los modelos representan la probabilidad de cambios entre estados sucesivos, se visualizan como FSMs con probabilidades en cada transición. Anteriormente, utilizamos FSM para representar el estado comportamental en el que se encontraba el agente, pero este concepto se aplica a cualquier estado, independientemente de si está relacionado con el agente o no. En este caso, los estados representan la sala que ocupa el agente:
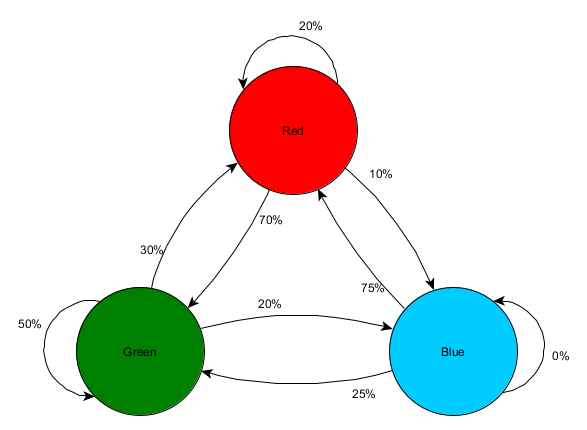
Esta es una forma sencilla de representar la probabilidad relativa de cambios de estado, dando al IA la capacidad de predecir el siguiente estado. Se puede prever varios pasos hacia adelante.
Si el jugador está en la sala verde, hay un 50% de probabilidad de que permanezca allí en la siguiente observación. Pero, ¿cuál es la probabilidad de que todavía esté allí incluso después de eso? No solo hay una probabilidad de que el jugador haya permanecido en la sala verde después de dos observaciones, sino también una probabilidad de que se haya ido y regresado. Aquí hay una nueva tabla considerando los nuevos datos:
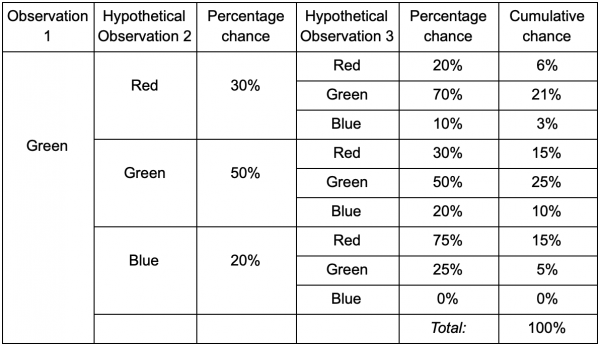
De ella se desprende que la probabilidad de ver al jugador en la sala verde después de dos observaciones será del 51%: 21% de que provenga de la sala roja, 5% de que el jugador haya visitado la sala azul entre ellas, y 25% de que el jugador no haya salido de la sala verde en absoluto.
La tabla es una herramienta visual simple; el proceso solo requiere multiplicar probabilidades en cada paso. Esto significa que puedes mirar lejos en el futuro con una salvedad: suponemos que la probabilidad de entrar a una habitación depende completamente de la habitación actual. Esto se llama propiedad de Markov (Markov Property): el estado futuro depende solo del presente. Pero no es 100% preciso. Los jugadores pueden alterar decisiones basándose en otros factores: nivel de salud o cantidad de municiones. Dado que no fijamos estos valores, nuestras predicciones serán menos precisas.
N-Grams
¿Y qué hay del ejemplo con la pelea y la predicción de los combos de un jugador? ¡Lo mismo! Pero en lugar de un solo estado o evento, exploraremos secuencias enteras que componen el golpe de combo.
Una de las formas de hacerlo es almacenar cada entrada (por ejemplo, Kick, Punch o Block) en un búfer y registrar todo el búfer como un evento. Así, el jugador presiona repetidamente Kick, Kick, Punch para realizar el ataque SuperDeathFist, el sistema de IA almacena todas las entradas en el búfer y recuerda las últimas tres utilizadas en cada paso.
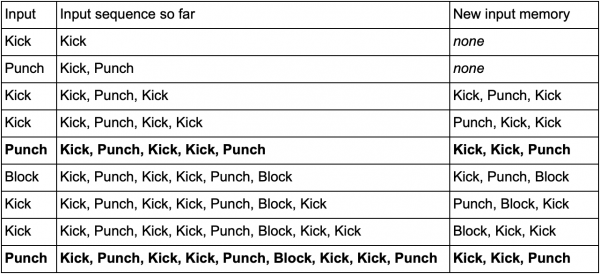
(Las líneas en negrita indican cuándo el jugador inicia el ataque SuperDeathFist.)
La IA verá todas las combinaciones cuando el jugador elija Kick, seguido de otro Kick, y luego notará que la siguiente entrada siempre es Punch. Esto permitirá al agente predecir el combo SuperDeathFist y bloquearlo, si es posible.
Estas secuencias de eventos se llaman N-gramas (N-grams), donde N es la cantidad de elementos almacenados. En el ejemplo anterior, fue un 3-grama (trigrama), lo que significa: las dos primeras entradas se utilizan para predecir la tercera. De manera correspondiente, en un 5-grama, las primeras cuatro entradas predicen la quinta y así sucesivamente.
El desarrollador debe elegir cuidadosamente el tamaño de los N-gramas. Un número menor de N requiere menos memoria, pero también almacena menos historia. Por ejemplo, un 2-grama (bigram) registrará Kick, Kick o Kick, Punch, pero no podrá almacenar Kick, Kick, Punch, por lo que la IA no reaccionará al combo SuperDeathFist.
Por otro lado, números más grandes requieren más memoria y la IA tendrá más dificultad para aprender, ya que habrá muchas más combinaciones posibles. Si tienes tres entradas posibles: Kick, Punch o Block, y usamos un 10-grama, obtendremos alrededor de 60,000 combinaciones diferentes.
El modelo de bigramas es una cadena de Markov simple: cada par "estado anterior/estado actual" es un bigrama, y puedes predecir el segundo estado en función del primero. Los trigramas y n-gramas más grandes también se pueden considerar como cadenas de Markov, donde todos los elementos (excepto el último en el n-grama) forman el primer estado, y el último elemento es el segundo. Un ejemplo relacionado con la lucha muestra la probabilidad de transición del estado Kick y Kick al estado Kick y Punch. Al considerar varios registros de la historia de entrada como una unidad, esencialmente transformamos la secuencia de entrada en parte de un estado total. Esto nos proporciona la propiedad de Markov, permitiéndonos usar cadenas de Markov para predecir la siguiente entrada y adivinar qué movimiento de combo será el siguiente.
Conclusión
Hablamos sobre las herramientas y enfoques más comunes en el desarrollo de inteligencia artificial. También discutimos situaciones en las que deben aplicarse y dónde son especialmente útiles.
Esto debería ser suficiente para comprender lo básico en IA de videojuegos. Pero, por supuesto, esto está lejos de ser todos los métodos. Menos populares, pero igual de efectivos, son:
- algoritmos de optimización, incluidos el ascenso de montaña, el descenso de gradiente y los algoritmos genéticos
- algoritmos de búsqueda/planificación competitiva (minimax y poda alpha-beta)
- métodos de clasificación (perceptrones, redes neuronales y máquinas de soporte vectorial)
- sistemas para el procesamiento de la percepción y la memoria de los agentes
- enfoques arquitectónicos para IA (sistemas híbridos, subconjuntos de arquitecturas y otras formas de superposición de sistemas de IA)
- herramientas de animación (planificación y coordinación del movimiento)
- factores de rendimiento (nivel de detalle, algoritmos anytime y timeslicing)
Recursos en línea sobre el tema:
1. En GameDev.net hay , así como .
2. contiene numerosas presentaciones y artículos sobre una amplia gama de temas relacionados con el desarrollo de IA en videojuegos.
3. incluye temas de la cumbre GDC AI, muchos de los cuales están disponibles de forma gratuita.
4. También se pueden encontrar materiales útiles en el sitio .
5. Tommy Thompson, investigador de IA y desarrollador de juegos, hace videos en el canal de YouTube con explicaciones y estudios de IA en videojuegos comerciales.
Libros sobre el tema:
1. La serie de libros Game AI Pro consiste en colecciones de artículos breves que explican cómo implementar funciones específicas o resolver problemas concretos.
2. La serie AI Game Programming Wisdom es el predecesor de la serie Game AI Pro. Presenta métodos más antiguos, pero casi todos son relevantes incluso hoy.
3. — es uno de los textos básicos para todos aquellos que quieran entender el campo general de la inteligencia artificial. Este libro no trata sobre el desarrollo de juegos — enseña los fundamentos básicos de la IA.
Fuente: habr.com
