

En Hemos revisado la agrupación de RabbitMQ para garantizar la resistencia a fallos y la alta disponibilidad. Ahora profundizaremos en Apache Kafka.
Aquí, la unidad de replicación es la partición. Cada tema tiene una o más particiones. En cada partición hay un líder con sus seguidores o sin ellos. Al crear un tema, se especifica el número de particiones y el factor de replicación. Un valor común es 3, lo que significa tres réplicas: un líder y dos seguidores.
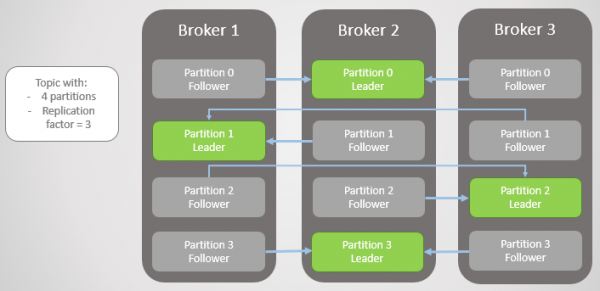
Fig. 1. Cuatro particiones distribuidas entre tres brokers
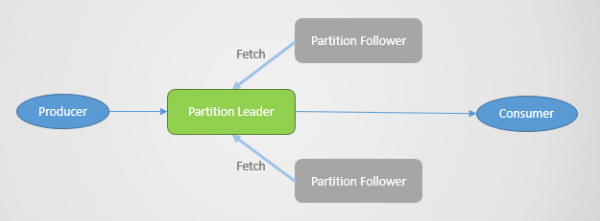
Todas las solicitudes de lectura y escritura se dirigen al líder. Los seguidores envían periódicamente al líder solicitudes para obtener los últimos mensajes. Los consumidores nunca se dirigen a los seguidores, que existen únicamente por redundancia y resistencia a fallos.
Fallo de partición
Cuando un broker falla, a menudo se caen los líderes de varias particiones. En cada una de ellas, un seguidor de otro nodo se convierte en líder. Sin embargo, esto no siempre ocurre, ya que también influye el factor de sincronización: si hay seguidores sincronizados y, si no los hay, si se permite el cambio a una réplica no sincronizada. Pero no compliquemos las cosas por ahora.
El broker 3 se desconecta de la red, y se elige un nuevo líder para la partición 2 en el broker 2.
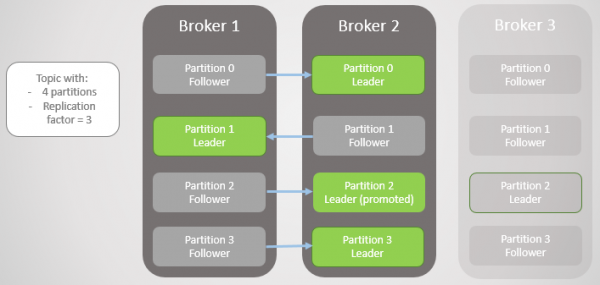
Fig. 2. El broker 3 muere, y su seguidor en el broker 2 es elegido nuevo líder de la partición 2
Luego, el broker 1 se desconecta y la partición 1 también pierde a su líder, cuyo rol pasa al broker 2.
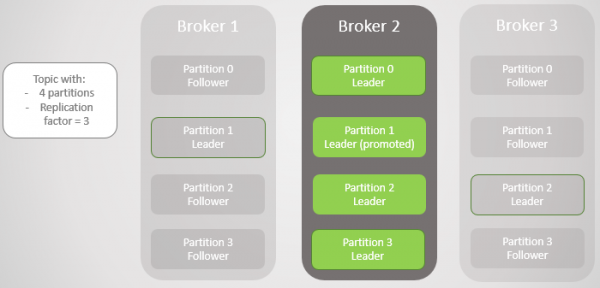
Fig. 3. Solo queda un broker. Todos los líderes están en un solo broker con cero redundancia
Cuando el broker 1 vuelve a la red, añade cuatro seguidores, proporcionando cierta redundancia a cada partición. Pero todos los líderes siguen estando en el broker 2.
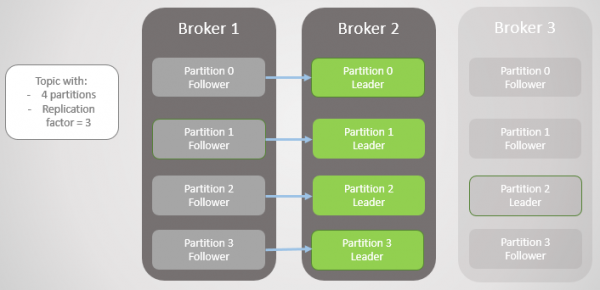
Fig. 4. Los líderes permanecen en el broker 2
Cuando el broker 3 se levanta, volvemos a tener tres réplicas en la partición. Pero todos los líderes siguen en el broker 2.
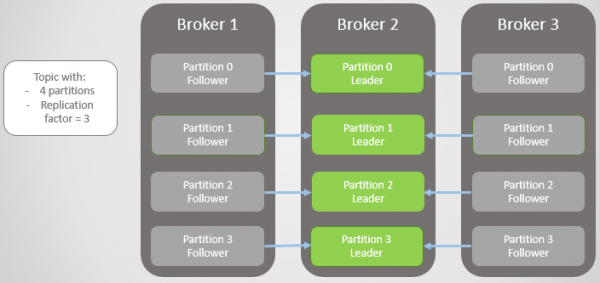
Fig. 5. Distribución desequilibrada de los líderes tras la recuperación de los brokers 1 y 3
Kafka tiene una herramienta para realizar un reequilibrio de líderes de mejor calidad que RabbitMQ. En este último, se debía utilizar un plugin externo o un script que modificaba las políticas para migrar el nodo principal a costa de reducir la redundancia durante la migración. Además, para colas grandes, había que aceptar la indisponibilidad durante la sincronización.
Kafka tiene el concepto de "réplicas preferidas" para el papel de líder. Cuando se crean particiones de un tema, Kafka intenta distribuir los líderes de manera uniforme entre los nodos y marca a estos primeros líderes como preferidos. Con el tiempo, debido a reinicios de servidores, fallos y problemas de conectividad, los líderes pueden terminar en otros nodos, como se describió en el caso extremo anterior.
Para solucionar esto, Kafka ofrece dos opciones:
- La opción auto.leader.rebalance.enable=true permite que el nodo controlador reasigne automáticamente los líderes de regreso a las réplicas preferidas, restableciendo así la distribución uniforme.
- El administrador puede ejecutar el script kafka-preferred-replica-election.sh para reasignar manualmente.
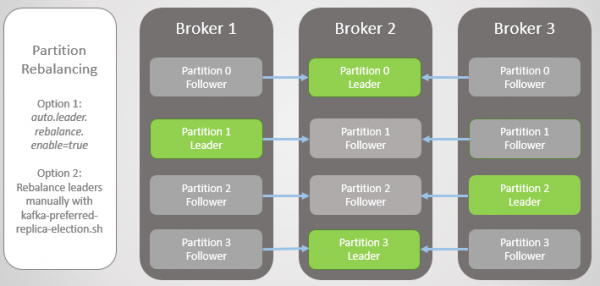
Fig. 6. Réplicas después del rebalanceo
Esta fue una versión simplificada de la falla, pero la realidad es más compleja, aunque no hay nada demasiado complicado aquí. Todo se reduce a réplicas sincronizadas (In-Sync Replicas, ISR).
Réplicas Sincronizadas (ISR)
ISR es un conjunto de réplicas de una partición que se considera "sincronizada" (in-sync). Aquí hay un líder, y puede que no haya seguidores. Un seguidor se considera sincronizado si ha hecho copias exactas de todos los mensajes del líder antes de que expire el intervalo replica.lag.time.max.ms.
Un seguidor se elimina del conjunto ISR si:
- no ha realizado una solicitud de recuperación dentro del intervalo replica.lag.time.max.ms (se considera muerto)
- no se actualizó a tiempo dentro del intervalo replica.lag.time.max.ms (se considera lento)
Los seguidores realizan solicitudes de recuperación en el intervalo replica.fetch.wait.max.ms, que por defecto es de 500 ms.
Para explicar claramente el propósito del ISR, es necesario observar las confirmaciones del productor y algunos escenarios de falla. Los productores pueden elegir cuándo el corredor envía una confirmación:
- acks=0, la confirmación no se envía
- acks=1, la confirmación se envía después de que el líder haya escrito el mensaje en su registro local
- acks=all, la confirmación se envía después de que todas las réplicas en el ISR hayan escrito el mensaje en sus registros locales
En la terminología de Kafka, si el ISR ha mantenido el mensaje, se realiza su "commit". Acks=all es la opción más segura, pero también implica una demora adicional. Consideremos dos ejemplos de fallos y cómo diferentes opciones de 'acks' interactúan con el concepto de ISR.
Acks=1 y ISR
En este ejemplo, veremos que si el líder no espera la confirmación de cada mensaje de todos los seguidores, podría haber pérdida de datos en caso de fallo del líder. El paso a un seguidor no sincronizado puede permitirse o denegarse mediante la configuración. unclean.leader.election.enable.
En este ejemplo, el productor tiene el valor acks=1. La partición está distribuida entre los tres brokers. El broker 3 está retrasado; se sincronizó con el líder hace ocho segundos y ahora tiene un retraso de 7456 mensajes. El broker 1 solo tiene un segundo de retraso. Nuestro productor envía un mensaje y rápidamente recibe un ack, sin sobrecarga sobre seguidores lentos o caídos que el líder no está esperando.
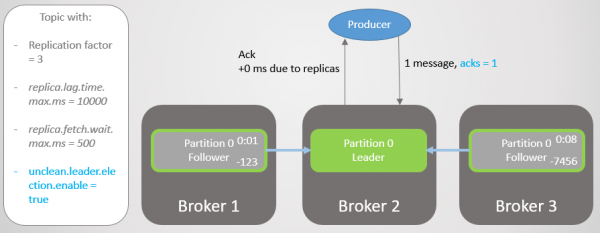
Fig. 7. ISR con tres réplicas
El broker 2 falla, y el productor recibe un error de conexión. Después del cambio de liderazgo al broker 1, perdemos 123 mensajes. El seguidor en el broker 1 estaba en ISR, pero no se había sincronizado completamente con el líder cuando este falló.
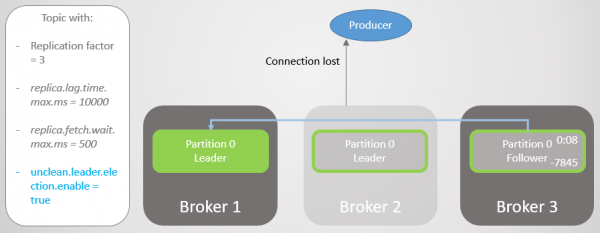
Fig. 8. Se pierden mensajes en caso de fallo
En la configuración bootstrap.servers el productor enumera varios brokers y puede preguntar a otro broker quién se convirtió en el nuevo líder de la partición. Luego establece una conexión con el broker 1 y continúa enviando mensajes.
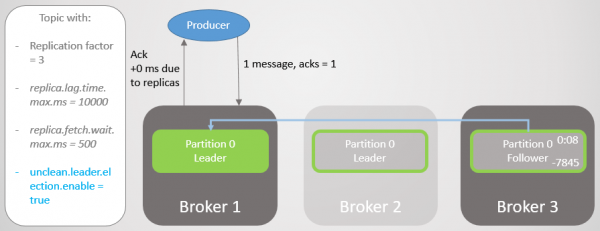
Fig. 9. La producción de mensajes se reanuda después de un breve descanso
El broker 3 está aún más retrasado. Hace solicitudes de recuperación, pero no puede sincronizarse. Esto podría deberse a una conexión de red lenta entre los brokers, problemas de almacenamiento, etc. Sale de ISR. ¡Ahora ISR consiste en una única réplica: el líder! El productor sigue enviando mensajes y recibiendo confirmaciones.
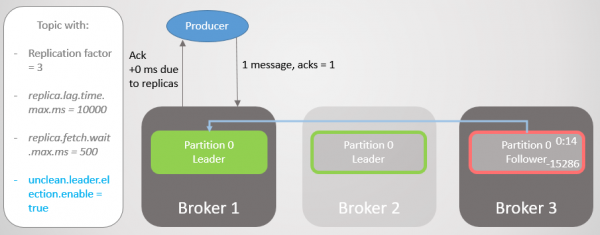
Fig. 10. El seguidor en el broker 3 es eliminado de ISR
El broker 1 falla y el liderazgo se transfiere al broker 3 con una pérdida de 15286 mensajes. El productor recibe un mensaje de error de conexión. El paso al líder fuera de ISR fue posible solo por la configuración unclean.leader.election.enable=true. Si se establece en false, entonces el cambio no habría ocurrido y todas las solicitudes de lectura y escritura habrían sido rechazadas. En este caso, esperamos el regreso del broker 1 con sus datos intactos en la réplica, que volverá a asumir el liderazgo.
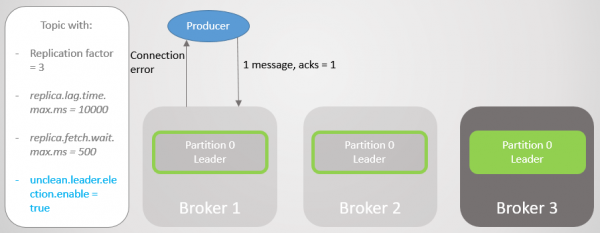
Fig. 11. El broker 1 falla. Se pierde una gran cantidad de mensajes en caso de fallo.
El productor establece conexión con el último corredor y ve que ahora es el líder de la sección. Comienza a enviar mensajes al corredor 3.
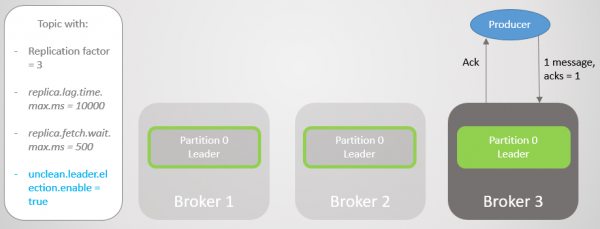
Fig. 12. Después de una breve pausa, los mensajes se envían nuevamente a la sección 0.
Hemos visto que, además de las breves interrupciones para establecer nuevas conexiones y buscar un nuevo líder, el productor envió constantemente mensajes. Esta configuración asegura disponibilidad a expensas de la consistencia (seguridad de los datos). Kafka perdió miles de mensajes, pero siguió aceptando nuevas entradas.
Acks=all e ISR.
Repitamos este escenario una vez más, pero con acks=all.La latencia del corredor 3 es de alrededor de cuatro segundos. El productor envía un mensaje con acks=all., y ahora no recibe una respuesta rápida. El líder espera a que el mensaje sea guardado por todas las réplicas en ISR.
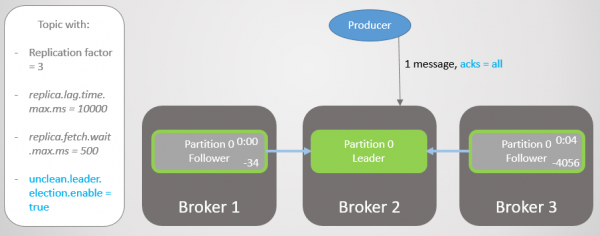
Fig. 13. ISR con tres réplicas. Una funciona lentamente, lo que provoca un retraso en la escritura.
Después de cuatro segundos de latencia adicional, el corredor 2 envía ack. Todas las réplicas ahora están completamente actualizadas.
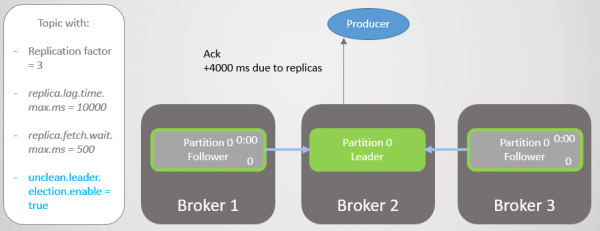
Fig. 14. Todas las réplicas guardan mensajes y se envía ack.
El corredor 3 ahora se retrasa aún más y se elimina de ISR. La latencia se reduce significativamente, ya que no quedan réplicas lentas en ISR. El corredor 2 ahora solo espera al corredor 1, que tiene un retraso promedio de 500 ms.
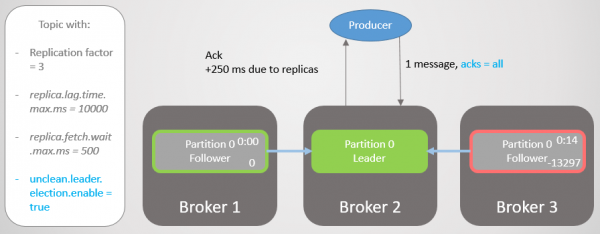
Fig. 15. La réplica en el corredor 3 es eliminada de ISR.
Luego, el corredor 2 falla y el liderazgo se transfiere al corredor 1 sin pérdida de mensajes.
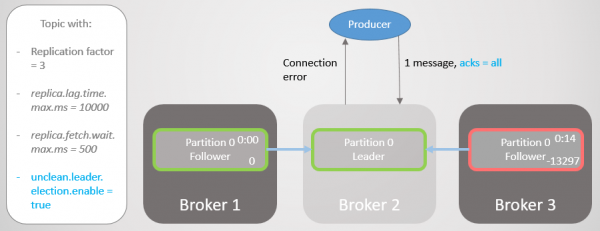
Fig. 16. El corredor 2 falla.
El productor encuentra un nuevo líder y comienza a enviarle mensajes. La latencia disminuye aún más, ya que ahora ISR consta de una sola réplica. Por lo tanto, la opción acks=all. no añade redundancia.
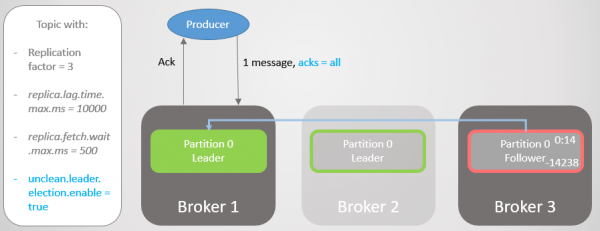
Fig. 17. La réplica en el corredor 1 asume el liderazgo sin pérdida de mensajes.
Luego, el corredor 1 falla y el liderazgo se transfiere al corredor 3 con una pérdida de 14238 mensajes.
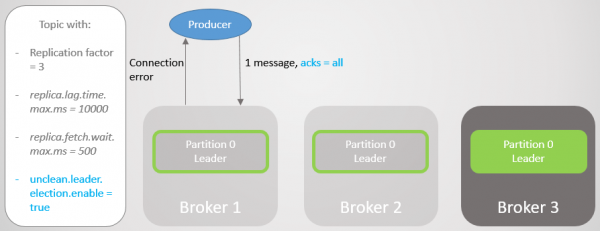
Fig. 18. El corredor 1 muere, y la transferencia de liderazgo con la configuración unclean causa una gran pérdida de datos.
Podríamos no haber establecido la opción unclean.leader.election.enable en true. Por defecto, es igual a false. La configuración acks=all. con unclean.leader.election.enable=true asegura disponibilidad con cierta seguridad adicional de los datos. Pero, como pueden ver, todavía podemos perder mensajes.
¿Y si queremos aumentar la seguridad de los datos? Se puede establecer unclean.leader.election.enable = false., pero esto no necesariamente nos protegerá de la pérdida de datos. Si el líder falla de manera crítica y pierde los datos, los mensajes siguen estando perdidos, además de que se pierde la disponibilidad hasta que el administrador restaure la situación.
Es mejor garantizar la redundancia de todos los mensajes, o de lo contrario, renunciar a la grabación. De esta manera, al menos desde el punto de vista del broker, la pérdida de datos solo puede ocurrir en caso de dos o más fallos simultáneos.
Acks=all, min.insync.replicas e ISR
Con la configuración del tema min.insync.replicas aumentamos el nivel de seguridad de los datos. Volvamos a pasar por la última parte del escenario anterior, pero esta vez con min.insync.replicas=2.
Así que el broker 2 tiene un líder de réplica, y el seguidor en el broker 3 está eliminado del ISR.
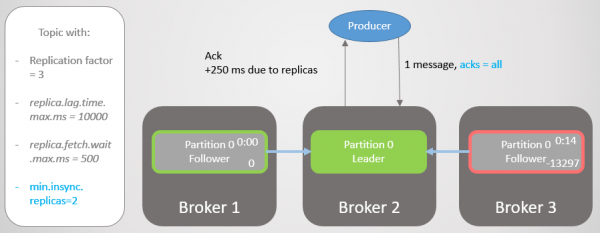
Fig. 19. ISR de dos réplicas
El broker 2 falla, y el liderazgo pasa al broker 1 sin pérdida de mensajes. Pero ahora el ISR consta solo de una réplica. Esto no cumple con el número mínimo para grabaciones, y por lo tanto, el broker responde con un error en el intento de grabación. NotEnoughReplicas.
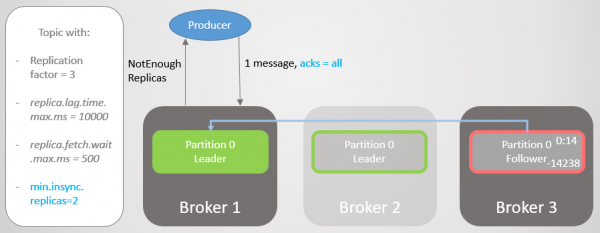
Fig. 20. El número de ISR es uno menos de lo indicado en min.insync.replicas
Esta configuración sacrifica la disponibilidad por la coherencia. Antes de confirmar el mensaje, garantizamos que se graba en al menos dos réplicas. Esto da al productor mucha más confianza. Aquí la pérdida de mensajes solo es posible con el fallo simultáneo de dos réplicas en un intervalo corto, mientras el mensaje no ha sido replicado en otro seguidor, lo cual es poco probable. Pero si eres un paranoico extremo, puedes establecer un factor de replicación de 5, y min.insync.replicas así como 3. Aquí deben fallar simultáneamente tres brokers para perder la grabación. Por supuesto, por tal fiabilidad pagarás con un retraso adicional.
Cuando la disponibilidad es necesaria para la seguridad de los datos
Como en , a veces la disponibilidad es necesaria para la seguridad de los datos. Debes pensar en lo siguiente:
- ¿Puede el publicador simplemente devolver un error, y el servicio o usuario superior intentará de nuevo más tarde?
- ¿Puede el publicador guardar el mensaje localmente o en una base de datos para volver a intentarlo más tarde?
Si la respuesta es negativa, entonces la optimización de la disponibilidad aumenta la seguridad de los datos. Perderás menos datos si eliges disponibilidad en lugar de renunciar a la grabación. Así que todo se reduce a encontrar un equilibrio, y la decisión depende de la situación específica.
El sentido de ISR
El conjunto ISR permite seleccionar el equilibrio óptimo entre la seguridad de los datos y la latencia. Por ejemplo, garantiza la disponibilidad en caso de fallos en la mayoría de las réplicas, minimizando el impacto de réplicas muertas o lentas en términos de latencia.
Nosotros elegimos el valor replica.lag.time.max.ms de acuerdo con nuestras necesidades. Esencialmente, este parámetro significa qué latencia estamos dispuestos a aceptar al acks=all.. El valor predeterminado es de diez segundos. Si esto es demasiado largo para usted, puede reducirlo. Entonces, la frecuencia de cambios en el ISR aumentará, ya que los seguidores serán eliminados y agregados con más frecuencia.
En RabbitMQ, simplemente hay un conjunto de espejos que deben ser replicados. Los espejos lentos introducen latencia adicional, y la respuesta de espejos muertos puede tardar hasta el tiempo de vida de los paquetes que revisan la disponibilidad de cada nodo (net tick). ISR es una forma interesante de evitar estos problemas de latencia aumentada. Pero corremos el riesgo de perder redundancia, ya que el ISR puede reducirse solo al líder. Para evitar este riesgo, utilice la configuración min.insync.replicas.
Garantía de conexión de clientes
En la configuración bootstrap.servers del productor y el consumidor, puede especificar varios brokers para la conexión de clientes. La idea es que, si un nodo se desconecta, quedan varios de reserva con los que el cliente puede abrir una conexión. No son necesariamente los líderes de particiones, sino simplemente plataformas para la carga inicial. El cliente puede preguntarles en qué nodo se encuentra el líder de partición para lectura/escritura.
En RabbitMQ, los clientes pueden conectarse a cualquier nodo, y el enrutamiento interno envía la solicitud a donde debe. Esto significa que puede colocar un equilibrador de carga antes de RabbitMQ. Kafka requiere que los clientes se conecten al nodo donde se encuentra el líder de la partición correspondiente. En tal situación, no se puede instalar un equilibrador de carga. La lista bootstrap.servers es crítica para que los clientes puedan acceder a los nodos necesarios y encontrarlos después de un fallo.
Arquitectura de consenso de Kafka
Hasta ahora, no hemos considerado cómo el clúster se entera de la caída de un broker y cómo se elige un nuevo líder. Para entender cómo Kafka maneja las particiones de red, primero es necesario comprender la arquitectura de consenso.
Cada clúster de Kafka se despliega junto con un clúster de Zookeeper, un servicio de consenso distribuido que permite a la sistema alcanzar un consenso en un estado específico, priorizando la consistencia sobre la disponibilidad. Para la autorización de operaciones de lectura y escritura se requiere el consentimiento de la mayoría de los nodos de Zookeeper.
Zookeeper almacena el estado del clúster:
- Lista de temas, particiones, configuración, réplicas líderes actuales, réplicas preferidas.
- Miembros del clúster. Cada corredor envía un ping al clúster de Zookeeper. Si no recibe un ping en un periodo de tiempo establecido, Zookeeper registra al corredor como no disponible.
- Selección de nodos principales y de respaldo para el controlador.
El nodo controlador es uno de los corredores de Kafka que es responsable de la elección de líderes de réplicas. Zookeeper envía notificaciones al controlador sobre el estado de membresía en el clúster y cambios en los temas, y el controlador debe actuar de acuerdo a esos cambios.
Por ejemplo, tomemos un nuevo tema con diez particiones y un factor de replicación de 3. El controlador debe elegir un líder para cada partición, tratando de distribuir los líderes de forma óptima entre los corredores.
Para cada partición, el controlador:
- actualiza la información en Zookeeper sobre ISR y el líder;
- envía el comando LeaderAndISRCommand a cada corredor que aloja una réplica de esta partición, informando a los corredores sobre el ISR y el líder.
Cuando un corredor líder falla, Zookeeper envía una notificación al controlador, y este elige un nuevo líder. De nuevo, el controlador primero actualiza Zookeeper y luego envía un comando a cada corredor, notificándoles sobre el cambio de liderazgo.
Cada líder es responsable del conjunto de ISR. La configuración replica.lag.time.max.ms determina quién entrará. Cuando cambia el ISR, el líder envía nueva información a Zookeeper.
Zookeeper siempre está informado de cualquier cambio, de modo que en caso de fallo, la transición de liderazgo se realice sin problemas hacia el nuevo líder.
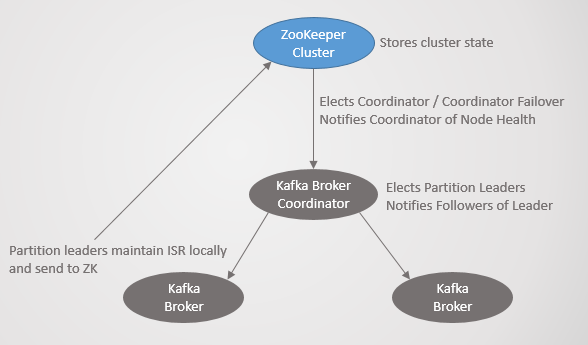
Fig. 21. Consenso de Kafka
Protocolo de replicación
Comprender los detalles de la replicación ayuda a entender mejor los potenciales escenarios de pérdida de datos.
Solicitudes de acceso, Log End Offset (LEO) y Highwater Mark (HW)
Hemos considerado que los seguidores envían periódicamente solicitudes de extracción (fetch) al líder. El intervalo por defecto es de 500 ms. Esto difiere de RabbitMQ en que en RabbitMQ la replicación es iniciada no por el espejo de la cola, sino por el maestro. El maestro envía los cambios a los espejos.
El líder y todos los seguidores mantienen el desplazamiento del final del registro (Log End Offset, LEO) y la marca de alto nivel (Highwater, HW). La marca LEO almacena el desplazamiento del último mensaje en la réplica local, mientras que HW almacena el desplazamiento del último compromiso. Recuerde que para el estado "comprometido" el mensaje debe estar almacenado en todas las réplicas ISR. Esto significa que LEO generalmente está un poco por delante de HW.
Cuando el líder recibe un mensaje, lo almacena localmente. El seguidor realiza una solicitud de extracción, enviando su LEO. Luego, el líder envía un paquete de mensajes, comenzando desde este LEO, y también transmite el HW actual. Cuando el líder recibe información de que todas las réplicas han almacenado el mensaje con el desplazamiento especificado, mueve la marca HW. Solo el líder puede mover el HW, y así todos los seguidores conocen el valor actual en las respuestas a sus solicitudes. Esto significa que los seguidores pueden quedarse atrás del líder tanto en mensajes como en el conocimiento de HW. Los consumidores reciben mensajes solo hasta el HW actual.
Tenga en cuenta que "persistido" (persisted) significa almacenado en memoria, no en disco. Por razones de rendimiento, Kafka realiza la sincronización en disco a intervalos específicos. RabbitMQ también tiene este intervalo, pero solo enviará una confirmación al publicador después de que el maestro y todos los espejos hayan almacenado el mensaje en disco. Los desarrolladores de Kafka, por razones de rendimiento, decidieron enviar el ack tan pronto como el mensaje está almacenado en memoria. Kafka apuesta a que la redundancia compensará el riesgo de mantener confirmaciones de mensajes solo en memoria a corto plazo.
Fallo del líder
Cuando el líder falla, Zookeeper notifica al controlador, y este elige un nuevo réplica líder. El nuevo líder establece una nueva marca HW de acuerdo con su LEO. Luego, los seguidores reciben la información sobre el nuevo líder. Dependiendo de la versión de Kafka, el seguidor elegirá uno de los dos escenarios:
- Truncará el registro local hasta el conocido HW y enviará al nuevo líder una solicitud de mensajes después de esta marca.
- Enviará una solicitud al líder para conocer el HW en el momento de su elección, y luego truncará el registro hasta ese desplazamiento. Luego comenzará a realizar solicitudes periódicas de muestreo, comenzando desde este desplazamiento.
Puede que el seguidor necesite truncar el registro por las siguientes razones:
- Cuando una falla ocurre en el líder, el primer seguidor del conjunto ISR, registrado en Zookeeper, gana las elecciones y se convierte en líder. Todos los seguidores en ISR, aunque se consideran "sincronizados", pueden no haber recibido del antiguo líder copias de todos los mensajes. Es posible que el seguidor electo no tenga la copia más actual. Kafka garantiza que no hay discrepancias entre réplicas. Por lo tanto, para evitar discrepancias, cada seguidor debe truncar su registro hasta el valor HW del nuevo líder en el momento de su elección. Esta es otra razón por la cual la configuración acks=all. es tan importante para la coherencia.
- Los mensajes se graban periódicamente en disco. Si todos los nodos del clúster fallan al mismo tiempo, en los discos se guardarán réplicas con distintos desplazamientos. Es posible que cuando los corredores regresen a la red, el nuevo líder que sea elegido se quede atrás de sus seguidores, porque se guardó en disco antes que los demás.
Reconexión al clúster
Al reconectarse al clúster, las réplicas se manejan de la misma manera que en un fallo del líder: verifican la réplica del líder y truncarán su registro hasta su HW (en el momento de la elección). En comparación, RabbitMQ considera los nodos reconectados como completamente nuevos. En ambos casos, el corredor descarta cualquier estado existente. Si se utiliza una sincronización automática, el maestro debe replicar absolutamente todo el contenido actual en el nuevo espejo de manera "y que espere el mundo entero". Durante esta operación, el maestro no acepta ninguna operación de lectura o escritura. Este enfoque crea problemas en grandes colas.
Kafka es un registro distribuido y, en general, almacena más mensajes que una cola de RabbitMQ, donde los datos se eliminan de la cola después de ser leídos. Las colas activas deben mantenerse relativamente pequeñas. Pero Kafka es un registro con su propia política de almacenamiento, que puede establecer un límite de días o semanas. El enfoque de bloqueo de la cola y la sincronización completa es absolutamente inaceptable para un registro distribuido. En su lugar, los seguidores de Kafka simplemente recortan su registro hasta el líder HW (en el momento de su elección) si su copia supera al líder. En el caso más probable, cuando el seguidor está retrasado, simplemente comienza a hacer solicitudes de recuperación, comenzando desde su LEO actual.
Los seguidores nuevos o reintroducidos comienzan fuera del ISR y no participan en los commits. Simplemente trabajan junto al grupo, recibiendo mensajes tan rápido como pueden hasta que alcanzan al líder y entran en el ISR. Aquí no hay bloqueo y no es necesario desechar todos sus datos.
Violación de la coherencia
Kafka tiene más componentes que RabbitMQ, por lo que hay un conjunto de comportamientos más complejo cuando se rompe la conectividad en el clúster. Pero Kafka fue diseñado originalmente para clústeres, así que las soluciones están muy bien pensadas.
A continuación se presentan algunos escenarios de ruptura de conectividad:
- Escenario 1. El seguidor no ve al líder, pero aún ve a Zookeeper.
- Escenario 2. El líder no ve a ningún seguidor, pero aún ve a Zookeeper.
- Escenario 3. El seguidor ve al líder, pero no ve a Zookeeper.
- Escenario 4. El líder ve a los seguidores, pero no ve a Zookeeper.
- Escenario 5. El seguidor está completamente aislado tanto de otros nodos de Kafka como de Zookeeper.
- Escenario 6. El líder está completamente aislado tanto de otros nodos de Kafka como de Zookeeper.
- Escenario 7. El nodo controlador de Kafka no ve a otro nodo de Kafka.
- Escenario 8. El controlador de Kafka no ve a Zookeeper.
Se prevé un comportamiento específico para cada escenario.
Escenario 1. El seguidor no ve al líder, pero aún ve a Zookeeper.
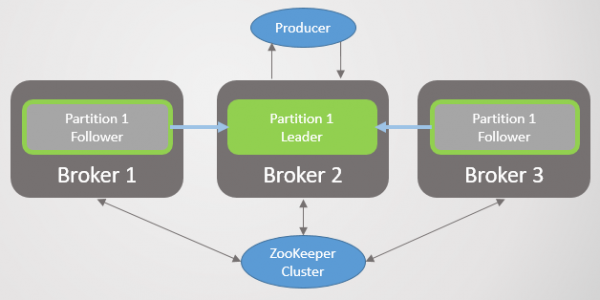
Fig. 22. Escenario 1. ISR de tres réplicas.
La ruptura de conectividad aísla al corredor 3 de los corredores 1 y 2, pero no de Zookeeper. El corredor 3 ya no puede enviar solicitudes de recuperación. Con el tiempo. replica.lag.time.max.ms se elimina del ISR y no participa en los commits de mensajes. Una vez que se restaura la conectividad, reanuda las solicitudes de extracción y se une al ISR cuando alcanza al líder. Zookeeper continuará recibiendo pings y considerará que el corredor está vivo y saludable.
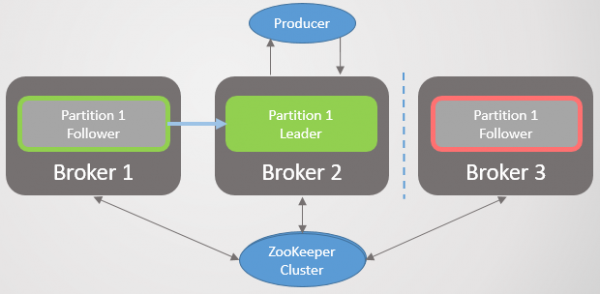
Fig. 23. Escenario 1. El corredor se elimina del ISR si no recibe una solicitud de extracción durante el intervalo replica.lag.time.max.ms
No hay ninguna separación lógica (split-brain) o suspensión del nodo, como en RabbitMQ. En su lugar, se reduce la redundancia.
Escenario 2. El líder no ve a ningún seguidor, pero todavía ve a Zookeeper
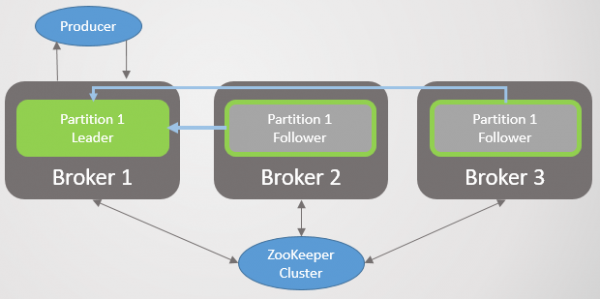
Fig. 24. Escenario 2. Líder y dos seguidores
La interrupción de la conectividad de red separa al líder de los seguidores, pero el corredor todavía ve a Zookeeper. Al igual que en el primer escenario, el ISR se comprime, pero esta vez solo hasta el líder, ya que todos los seguidores dejan de enviar solicitudes de extracción. Nuevamente, no hay ninguna separación lógica. En su lugar, ocurre una pérdida de redundancia para nuevos mensajes, hasta que se restaura la conectividad. Zookeeper continúa recibiendo pings y considera que el corredor está vivo y saludable.
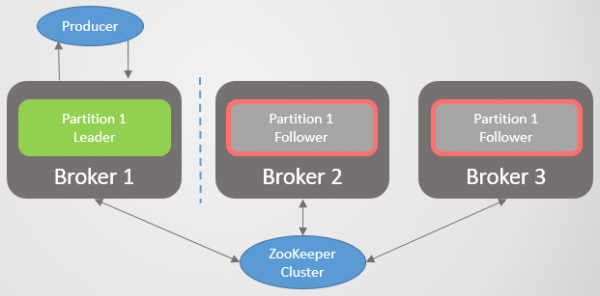
Fig. 25. Escenario 2. El ISR se ha comprimido solo hasta el líder
Escenario 3. El seguidor ve al líder, pero no ve a Zookeeper
El seguidor se separa de Zookeeper, pero no del corredor con el líder. Como resultado, el seguidor continúa haciendo solicitudes de extracción y siendo miembro del ISR. Zookeeper ya no recibe pings y registra la caída del corredor, pero dado que solo es un seguidor, no hay consecuencias después de la recuperación.
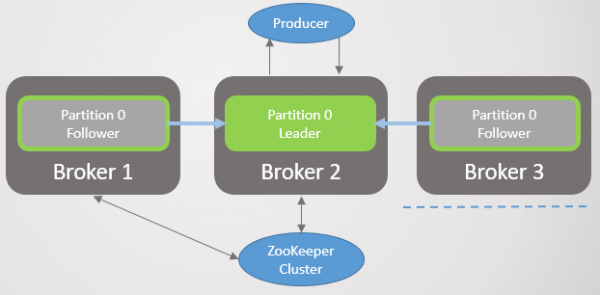
Fig. 26. Escenario 3. El seguidor continúa enviando al líder solicitudes de extracción
Escenario 4. El líder ve a los seguidores, pero no ve a Zookeeper
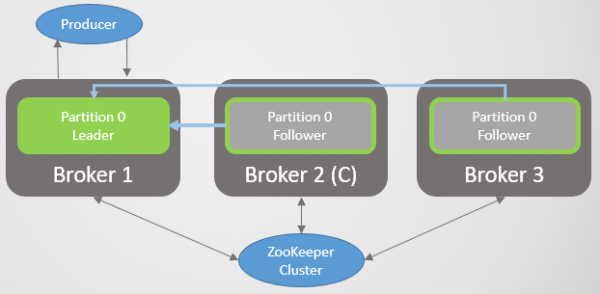
Fig. 27. Escenario 4. Líder y dos seguidores
El líder está separado de Zookeeper, pero no de los corredores con seguidores.
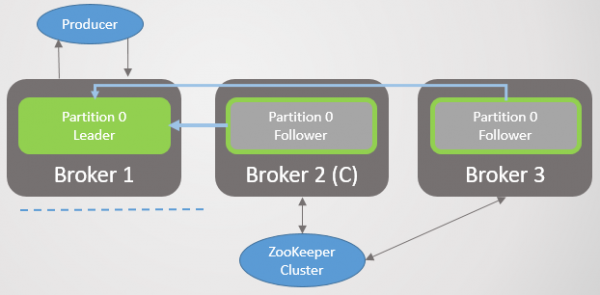
Fig. 28. Escenario 4. El líder está aislado de Zookeeper
Después de un tiempo, Zookeeper registrará la caída del corredor y notificará al controlador. Este elegirá un nuevo líder entre los seguidores. Sin embargo, el líder original seguirá creyendo que es el líder y continuará aceptando registros con acks=1. Los seguidores ya no le envían solicitudes de extracción, por lo que él los considerará muertos y tratará de comprimir el ISR hasta sí mismo. Pero como no tiene conexión a Zookeeper, no podrá hacerlo y en ese momento dejará de aceptar registros.
Mensajes acks=all. no recibirán confirmaciones porque primero el ISR incluye todas las réplicas, y hasta que no se reciban los mensajes. Cuando el líder original intente eliminarlas del ISR, no podrá hacerlo y dejará de aceptar cualquier mensaje.
Los clientes pronto notan el cambio de líder y comienzan a enviar registros al nuevo servidor. Una vez que la red se restablece, el líder original ve que ya no es líder y recorta su registro al valor de HW que tenía el nuevo líder en el momento de la falla, para evitar la divergencia de registros. Luego comenzará a enviar solicitudes de recuperación al nuevo líder. Se perderán todos los registros del líder original que no fueron replicados al nuevo líder. Es decir, se perderán los mensajes que no fueron confirmados por el líder original en esos pocos segundos en los que funcionaron dos líderes.
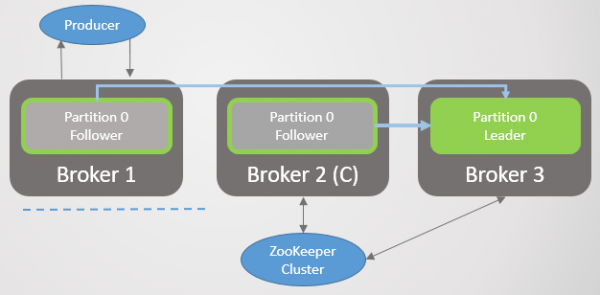
Fig. 29. Escenario 4. El líder en el corredor 1 se convierte en seguidor tras la recuperación de la red
Escenario 5. El seguidor está completamente aislado tanto de otros nodos de Kafka como de Zookeeper
El seguidor está completamente aislado de otros nodos de Kafka y de Zookeeper. Simplemente se elimina del ISR hasta que la red se restablezca, y luego alcanza a los demás.

Fig. 30. Escenario 5. El seguidor aislado se elimina del ISR
Escenario 6. El líder está completamente aislado de otros nodos de Kafka y de Zookeeper
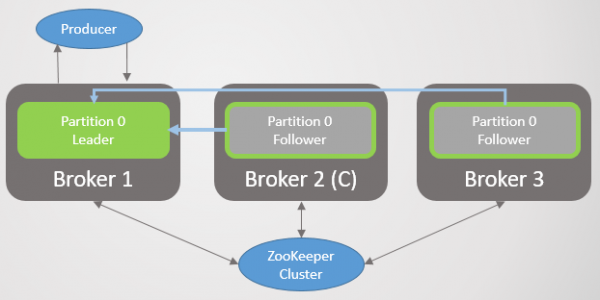
Fig. 31. Escenario 6. Líder y dos seguidores
El líder está completamente aislado de sus seguidores, del controlador y de Zookeeper. Durante un corto periodo, continuará aceptando registros de acks=1.
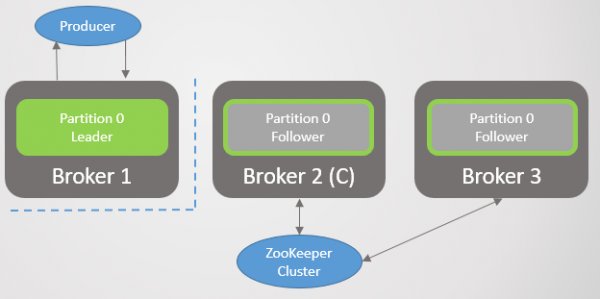
Fig. 32. Escenario 6. Aislamiento del líder de otros nodos de Kafka y Zookeeper
No recibiendo solicitudes al expirar replica.lag.time.max.ms, intentará reducir el ISR a sí mismo, pero no podrá hacerlo, ya que no hay conexión con Zookeeper, y entonces dejará de aceptar registros.
Mientras tanto, Zookeeper marcará al corredor aislado como muerto, y el controlador elegirá un nuevo líder.
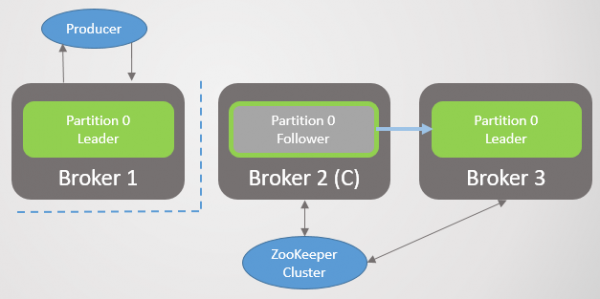
Fig. 33. Escenario 6. Dos líderes
El líder original puede aceptar registros durante unos segundos, pero luego deja de aceptar cualquier mensaje. Los clientes se actualizan cada 60 segundos con los últimos metadatos. Serán informados sobre el cambio de líder y comenzarán a enviar registros al nuevo líder.
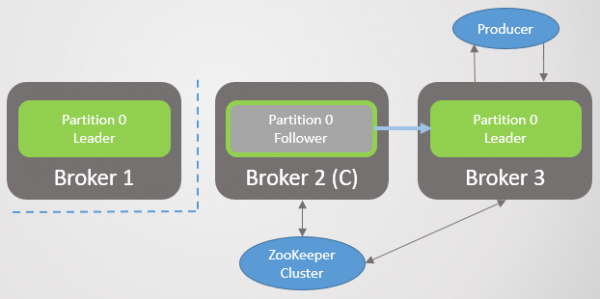
Fig. 34. Escenario 6. Los productores cambian al nuevo líder
Se perderán todos los registros confirmados realizados por el líder original desde el momento de la pérdida de conectividad. Una vez que la red se restablezca, el líder original a través de Zookeeper descubrirá que ya no es el líder. Luego truncará su registro hasta el HW del nuevo líder en el momento de la elección y comenzará a enviar solicitudes como seguidor.
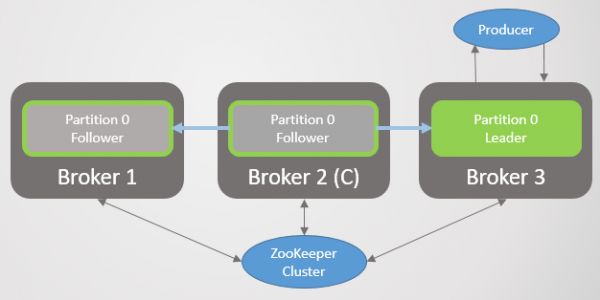
Fig. 35. Escenario 6. El líder original se convierte en seguidor tras la restauración de la conectividad de la red.
En esta situación, puede observarse una división lógica a corto plazo, pero solo si acks=1 y min.insync.replicas también 1. La división lógica se termina automáticamente ya sea después de restaurar la red, cuando el líder original se da cuenta de que ya no es líder, o cuando todos los clientes entienden que el líder ha cambiado y comienzan a escribir al nuevo líder, dependiendo de lo que ocurra primero. En cualquier caso, se perderán algunos mensajes, pero solo con acks=1.
Hay otra variante de este escenario, cuando justo antes de la división de la red, los seguidores se retrasan y el líder contrae el ISR a sí mismo. Luego se aísla debido a la pérdida de conectividad. Se elige un nuevo líder, pero el líder original sigue aceptando registros, incluso acks=all., porque en el ISR no hay nadie más que él. Estos registros se perderán una vez que se restablezca la red. La única forma de evitar este escenario es min.insync.replicas = 2.
Escenario 7. El nodo controlador de Kafka no ve a otro nodo de Kafka.
En general, tras perder conexión con un nodo de Kafka, el controlador no podrá transmitirle ninguna información sobre el cambio de líder. En el peor de los casos, esto conducirá a una breve división lógica, como en el escenario 6. Con mayor frecuencia, el corredor simplemente no será candidato a liderazgo en caso de que el último falle.
Escenario 8. El controlador de Kafka no ve a Zookeeper.
El controlador de Zookeeper caído no recibirá un ping y elegirá como controlador un nuevo nodo de Kafka. El controlador original puede seguir considerándose como tal, pero no recibe notificaciones de Zookeeper, por lo que no tendrá tareas que realizar. Una vez que la red se restablezca, se dará cuenta de que ya no es un controlador, sino un nodo normal de Kafka.
Conclusiones de los escenarios
Observamos que la pérdida de conectividad de los seguidores no conduce a la pérdida de mensajes, sino que simplemente reduce temporalmente la redundancia hasta que la red se restablezca. Esto, por supuesto, puede resultar en la pérdida de datos si uno o más nodos se pierden.
Si debido a la pérdida de conectividad el líder se separa de Zookeeper, esto puede conducir a la pérdida de mensajes con acks=1. La falta de conexión con Zookeeper provoca una breve separación lógica con dos líderes. Este problema se resuelve con el parámetro acks=all..
Parámetro min.insync.replicas de dos o más réplicas que proporcionan garantías adicionales de que tales escenarios a corto plazo no provocaràn la pérdida de mensajes, como en el escenario 6.
Resumen sobre la pérdida de mensajes
Enumeremos todas las formas en que se pueden perder datos en Kafka:
- Cualquier fallo del líder, si los mensajes fueron confirmados mediante acks=1
- Cualquier transición de liderazgo sucia (unclean), es decir, hacia un seguidor fuera de ISR, incluso con acks=all.
- Aislamiento del líder de Zookeeper, si los mensajes fueron confirmados mediante acks=1
- Aislamiento total del líder que ya ha comprimido el grupo ISR a sí mismo. Se perderán todos los mensajes, incluso acks=all.. Esto es cierto solo si min.insync.replicas=1.
- Fallos simultáneos de todos los nodos de la partición. Dado que los mensajes se confirman desde la memoria, algunos pueden no haberse escrito aún en el disco. Después de reiniciar los servidores, pueden faltar algunos mensajes.
Se pueden evitar las transiciones de liderazgo sucias, ya sea prohibiéndolas o asegurando una redundancia de al menos dos. La configuración más robusta es una combinación de acks=all. y min.insync.replicas más de 1.
Comparación directa de la fiabilidad de RabbitMQ y Kafka
Para garantizar la fiabilidad y alta disponibilidad, ambas plataformas implementan un sistema de replicación primaria y secundaria. Sin embargo, RabbitMQ tiene un talón de Aquiles. Al reconectarse después de una falla, los nodos descartan sus datos y la sincronización se bloquea. Este doble golpe pone en duda la durabilidad de las grandes colas en RabbitMQ. Tendrá que lidiar con una menor redundancia o con prolongados bloqueos. La reducción de la redundancia aumenta el riesgo de pérdida masiva de datos. Pero si las colas son pequeñas, se puede manejar la garantía de redundancia con cortos períodos de inactividad (unos segundos) mediante reintentos de conexión.
En Kafka no existe tal problema. Descarta datos solo desde el punto de discrepancia entre el líder y el seguidor. Todos los datos comunes se mantienen. Además, la replicación no bloquea el sistema. El líder sigue aceptando registros mientras un nuevo seguidor lo alcanza, por lo que para los DevOps unirse o reunirse al clúster se convierte en una tarea trivial. Por supuesto, todavía existen problemas, como el ancho de banda de la red durante la replicación. Si se añaden varios seguidores al mismo tiempo, se puede enfrentar a un límite de ancho de banda.
RabbitMQ supera a Kafka en confiabilidad cuando varios servidores fallan simultáneamente en el clúster. Como ya hemos mencionado, RabbitMQ enviará una confirmación al publicador solo después de que el mensaje haya sido escrito en disco en el maestro y en todos los espejos. Pero esto añade una latencia adicional por dos razones:
- fsync cada pocos cientos de milisegundos
- Las fallas en los espejos solo se pueden detectar después de que expira el tiempo de vida de los paquetes que verifican la disponibilidad de cada nodo (tick de red). Si un espejo se ralentiza o cae, esto añade latencia.
Kafka apuesta a que si un mensaje se almacena en varios nodos, se pueden confirmar los mensajes tan pronto como lleguen a la memoria. Esto conlleva el riesgo de pérdida de mensajes de cualquier tipo (incluso acks=all., min.insync.replicas=2) en caso de fallos simultáneos.
En general, Kafka muestra un rendimiento más alto y está diseñado originalmente para clústeres. El número de seguidores se puede aumentar a 11 si se necesita para la confiabilidad. Un factor de replicación de 5 y un número mínimo de réplicas en estado sincronizado min.insync.replicas=3 harán que la pérdida de mensajes sea un evento muy raro. Si su infraestructura puede garantizar tal factor de replicación y nivel de redundancia, puede optar por esta opción.
La agrupación de RabbitMQ es buena para colas pequeñas. Pero incluso las colas pequeñas pueden crecer rápidamente bajo un gran tráfico. Una vez que las colas se vuelven grandes, tendrá que hacer una dura elección entre disponibilidad y confiabilidad. La agrupación de RabbitMQ es más adecuada para situaciones poco comunes, donde las ventajas de flexibilidad de RabbitMQ superan cualquier inconveniente de su agrupación.
Una de las contramedidas a la vulnerabilidad de RabbitMQ en relación con las colas grandes es dividirlas en muchas más pequeñas. Si no se requiere un orden completo de toda la cola, sino solo de los mensajes pertinentes (por ejemplo, los mensajes de un cliente específico), o incluso si no se ordena nada, esta opción es aceptable: mira mi proyecto para dividir la cola (el proyecto está aún en una etapa temprana).
Finalmente, no olvides una serie de errores en los mecanismos de clustering y replicación tanto de RabbitMQ como de Kafka. Con el tiempo, los sistemas se han vuelto más maduros y estables, pero ningún mensaje estará 100% protegido contra la pérdida. Además, ocurren grandes desastres en los centros de datos.
Si he pasado algo por alto, he cometido un error o no estás de acuerdo con alguno de los puntos, no dudes en dejar un comentario o contactarme.
A menudo me preguntan: '¿Qué elegir, Kafka o RabbitMQ?', '¿Cuál plataforma es mejor?'. La verdad es que realmente depende de tu situación, experiencia actual, etc. No me atrevo a expresar mi opinión, ya que sería una simplificación excesiva recomendar una única plataforma para todos los casos de uso y posibles limitaciones. He escrito esta serie de artículos para que puedas formar tu propia opinión.
Quiero decir que ambos sistemas son líderes en este campo. Puede que esté un poco sesgado, ya que por la experiencia de mis proyectos tiendo a valorar cosas como la garantía de orden de mensajes y la fiabilidad.
Veo otras tecnologías que carecen de esta fiabilidad y de un orden garantizado, luego miro a RabbitMQ y Kafka, y comprendo el increíble valor de ambos sistemas.
Fuente: habr.com
