

En este artículo hablaremos sobre las dependencias funcionales en bases de datos: qué son, dónde se utilizan y qué algoritmos existen para su búsqueda.
Analizaremos las dependencias funcionales en el contexto de bases de datos relacionales. Hablando de manera simple, en este tipo de bases de datos, la información se almacena en forma de tablas. Luego utilizamos conceptos aproximados que en la estricta teoría relacional no son intercambiables: llamaremos a la tabla relación, a las columnas atributos (su conjunto es el esquema de la relación), y al conjunto de valores de una fila en un subconjunto de atributos, lo llamaremos tupla.
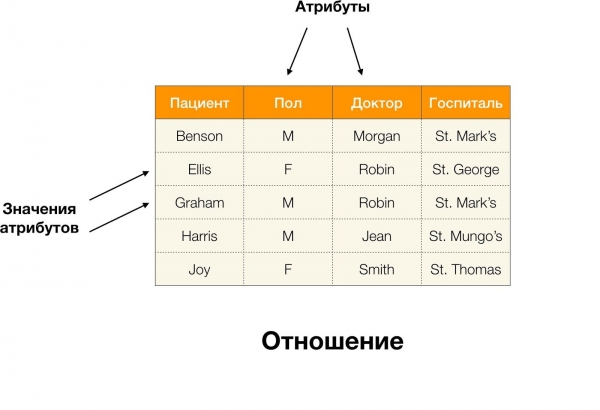
Por ejemplo, en la tabla anterior, (Benson, M, M organ) es una tupla según los atributos (Paciente, Sexo, Doctor).
Más formalmente, esto se expresa de la siguiente manera:  [Paciente, Sexo, Doctor] = (Benson, M, M organ).
Ahora podemos introducir el concepto de dependencia funcional (DF):
Definición 1. La relación R satisface la DF X → Y (donde X, Y ⊆ R) si y solo si para cualquier tupla  ,
 ∈ R se cumple: si
 [X] =
 [X], entonces
 [Y] =
 [Y]. En tal caso, se dice que X (determinante, o conjunto de atributos determinantes) determina funcionalmente a Y (conjunto dependiente).
En otras palabras, la existencia de la DF X → Y significa que si tenemos dos tuplas en R y coinciden en atributos X, entonces también coincidirán en atributos Y.
Y ahora, ordenadamente. Consideremos los atributos Paciente y Sexo para los cuales queremos saber si existen dependencias entre ellos o no. Para tal conjunto de atributos pueden existir las siguientes dependencias:
- Paciente → Sexo
- Sexo → Paciente
Según la definición anterior, para que se mantenga la primera dependencia, cada valor único de la columna Paciente debe corresponder a un único valor de la columna Sexo. Y para la tabla de ejemplo, esto es realmente así. Sin embargo, en la dirección inversa esto no funciona, es decir, la segunda dependencia no se cumple, y el atributo Sexo no es un determinante para Paciente. De manera similar, si tomamos la dependencia Doctor → Paciente, se puede notar que se infringe, ya que el valor Robin para este atributo tiene varios valores diferentes — Ellis y Graham.
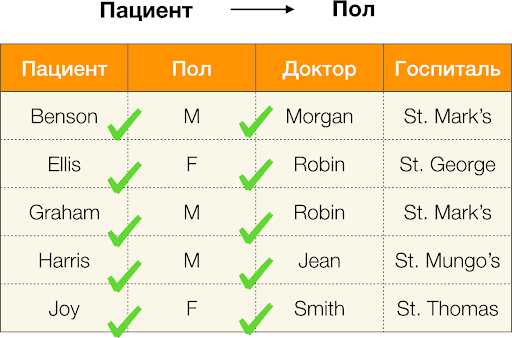
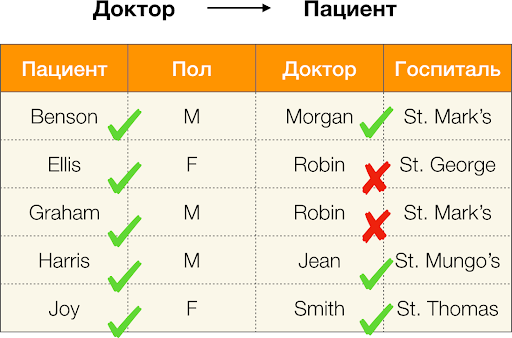
De esta manera, las dependencias funcionales permiten definir las relaciones existentes entre conjuntos de atributos de la tabla. A partir de aquí, consideraremos las relaciones más interesantes, es decir, aquellas X → Y, que son:
- no triviales, lo que significa que la parte derecha de la dependencia no es un subconjunto de la izquierda (Y ̸⊆ X);
- mínimas, lo que significa que no hay tal dependencia Z → Y, que Z ⊂ X.
Las dependencias consideradas hasta ahora eran estrictas, es decir, no permitían ninguna violación en la tabla, pero además existen aquellas que permiten cierta inconsistencia entre los valores de las tuplas. Estas dependencias se agrupan en una clase separada, se denominan aproximadas y se les permite violar un número determinado de tuplas. Esta cantidad se regula mediante el indicador de error máximo emax. Por ejemplo, una tasa de error  = 0.01 puede significar que la dependencia puede violarse en el 1% de las tuplas existentes del conjunto de atributos considerado. Es decir, para 1000 registros, un máximo de 10 tuplas pueden violar la FD. Nosotros consideraremos una métrica algo diferente, basada en los valores comparados de las tuplas. Para la dependencia X → Y en la relación r se calcula así:

Calculemos el error para Doctor → Paciente del ejemplo anterior. Tenemos dos tuplas cuyos valores difieren en el atributo Paciente, pero coinciden en Doctor:  [Doctor, Paciente] = (Robin, Ellis) y
 [Doctor, Paciente] = (Robin, Graham). Siguiendo la definición de error, debemos considerar todos los pares en conflicto, por lo que habrá dos: (
 ,
 ) y su inversa (
 ,
 ). Sustituyamos en la fórmula y obtendremos:

Y ahora intentemos responder a la pregunta: «¿Y para qué sirve todo esto?». En realidad, existen diferentes tipos de FD. El primer tipo son aquellas dependencias que son definidas por el administrador en la etapa de diseño de la base de datos. Suelen ser pocas, son estrictas, y su principal aplicación es la normalización de datos y el diseño del esquema de relación.
El segundo tipo son las dependencias que representan datos «ocultos» y relaciones previamente desconocidas entre atributos. Es decir, estas dependencias no fueron consideradas en el momento del diseño y se descubren ya con un conjunto de datos existente, para luego, basándose en muchas dependencias funcionales identificadas, hacer alguna inferencia sobre la información almacenada. Precisamente con estas dependencias es con las que trabajamos. Existe toda una área en la minería de datos dedicada a esto, con diversas técnicas de búsqueda y algoritmos construidos sobre ellas. Vamos a investigar cómo pueden ser útiles las dependencias funcionales encontradas (exactas o aproximadas) en ciertos datos.
Hoy en día, entre las principales áreas de aplicación de las dependencias, se destaca la limpieza de datos. Esto implica el desarrollo de procesos para identificar datos «sucios» que posteriormente serán corregidos. Los claros ejemplos de «datos sucios» son duplicados, errores en los datos o tipografías, valores faltantes, datos desactualizados, espacios en blanco innecesarios y similares.
Ejemplo de error en los datos:
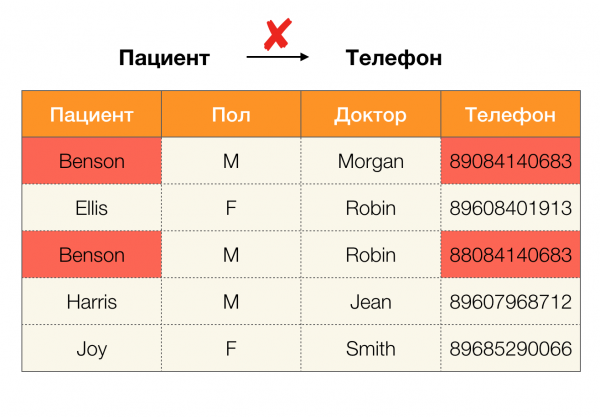
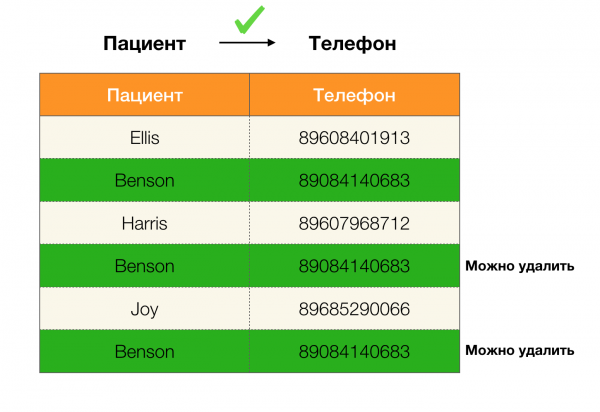
Ejemplo de duplicados en los datos:
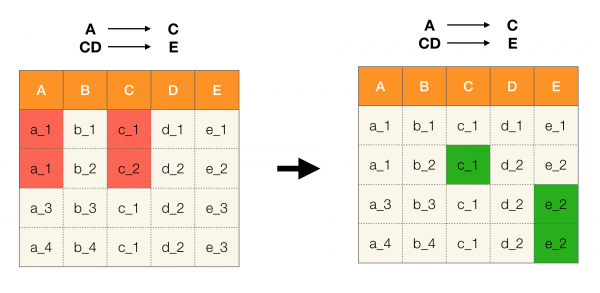
Por ejemplo, tenemos una tabla y un conjunto de reglas que deben cumplirse. La limpieza de datos en este caso implica modificar los datos de tal manera que las reglas se vuelvan correctas. Además, el número de modificaciones debe ser mínimo (existen algoritmos específicos para este procedimiento, en los que no nos centraremos en este artículo). A continuación, se presenta un ejemplo de tal transformación de datos. A la izquierda está la relación original, en la que claramente no se cumplen las reglas necesarias (en rojo se resalta un ejemplo de violación de una de las reglas). A la derecha se muestra la relación actualizada, donde las celdas verdes indican los valores modificados. Después de llevar a cabo este procedimiento, las dependencias necesarias empezaron a cumplirse.
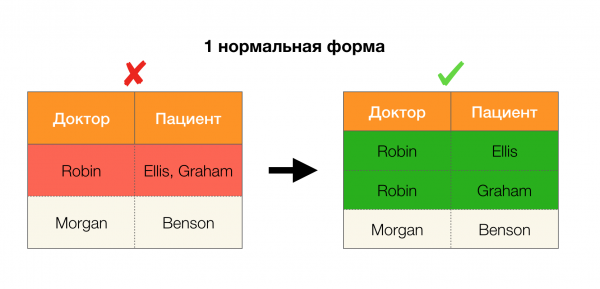
Otra área de aplicación popular es el diseño de bases de datos. Aquí es importante recordar las formas normales y la normalización. La normalización es el proceso de ajustar una relación a un conjunto específico de requisitos, cada uno de los cuales se define de manera diferente por cada forma normal. No nos extenderemos sobre los requisitos de las diversas formas normales (esto se aborda en cualquier libro sobre bases de datos para principiantes), solo mencionaremos que cada una de ellas utiliza de diferentes maneras el concepto de dependencias funcionales. De hecho, las DF son en esencia restricciones de integridad que se tienen en cuenta al diseñar una base de datos (en el contexto de esta tarea, las DF a veces se denominan superclaves).
Consideremos su aplicación para las cuatro formas normales en la imagen a continuación. Recordemos que la forma normal de Boyce-Codd es más estricta que la tercera forma, pero menos estricta que la cuarta. No examinamos esta última por ahora, ya que para establecerla se requiere entender las dependencias multivaluadas, que no son de nuestro interés en este artículo.
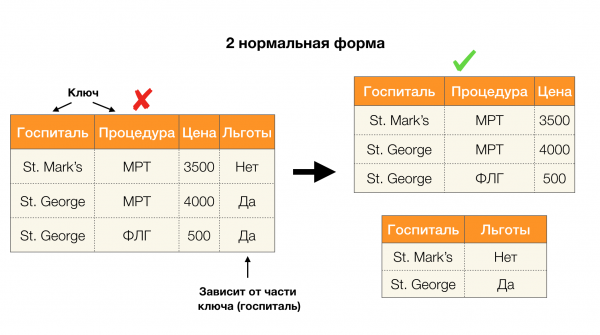
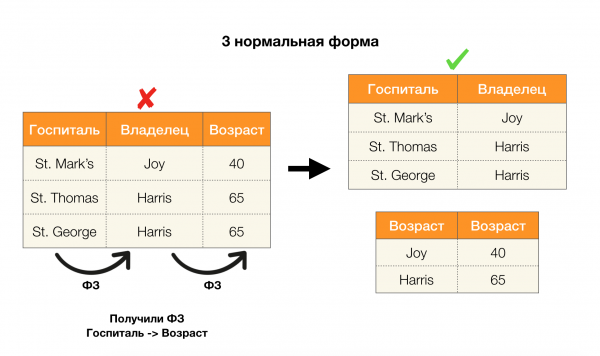
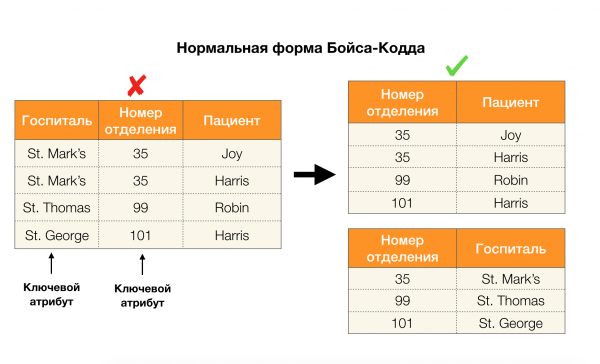
Otra área donde las dependencias han encontrado su aplicación es la reducción de la dimensionalidad del espacio de características en tareas como la construcción de un clasificador bayesiano ingenuo, la selección de características significativas y la reparametrización de modelos de regresión. En los artículos originales, esta tarea se denomina identificación de características redundantes (feature redundancy) y relevantes (feature relevancy) [5, 6], y se resuelve con el uso activo de conceptos de bases de datos. Con la aparición de tales trabajos, podemos afirmar que hoy en día existe una demanda de soluciones que integren bases de datos, análisis y la implementación de los problemas de optimización mencionados en una sola herramienta [7, 8, 9].
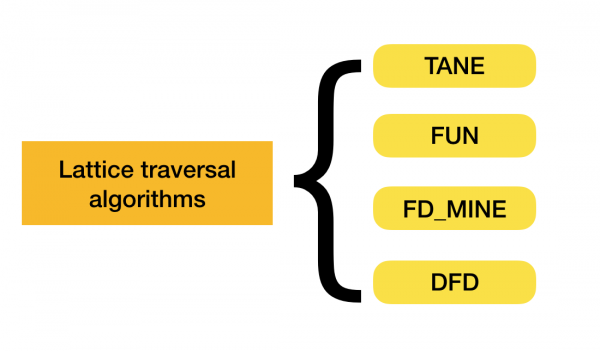
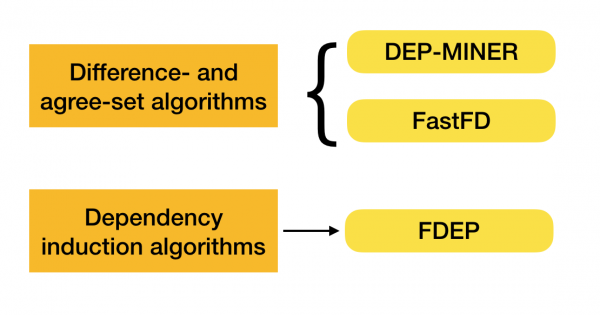
Existen numerosos algoritmos para buscar DF en un conjunto de datos (tanto modernos como no tan modernos). Estos algoritmos se pueden dividir en tres grupos:
- Algoritmos que utilizan el recorrido de rejillas algebraicas (Lattice traversal algorithms)
- Algoritmos basados en la búsqueda de valores coherentes (Difference- and agree-set algorithms)
- Algoritmos basados en comparaciones por pares (Dependency induction algorithms)
A continuación se presenta una breve descripción de cada tipo de algoritmo en la tabla:
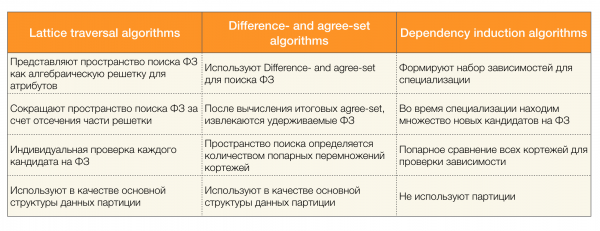
Puede leer más sobre esta clasificación en [4]. A continuación se presentan ejemplos de algoritmos para cada uno de los tipos:
Actualmente, están surgiendo nuevos algoritmos que combinan varios enfoques para la búsqueda de dependencias funcionales. Ejemplos de tales algoritmos son Pyro [2] y HyFD [3]. El análisis de su funcionamiento se espera en los próximos artículos de este ciclo. En este artículo, solo abordaremos los conceptos básicos y la lema necesaria para comprender las técnicas de identificación de dependencias.
Comencemos con lo simple: los conjuntos difference y agree, utilizados en el segundo tipo de algoritmos. El conjunto difference es un conjunto de tuplas que no coinciden en valores, mientras que el agree-set, por el contrario, son tuplas que coinciden en valores. Cabe destacar que en este caso solo consideramos la parte izquierda de la dependencia.
Otro concepto importante que se mencionó anteriormente es la reticulación algebraica. Dado que muchos algoritmos modernos operan con este concepto, necesitamos tener una idea de qué es.
Para introducir el concepto de retícula, es necesario definir el conjunto parcialmente ordenado (o partially ordered set, abreviado como poset).
Definición 2. Se dice que un conjunto S está parcialmente ordenado por la relación binaria ⩽, si para cualquier a, b, c ∈ S se cumplen las propiedades:
- Reflexividad, es decir, a ⩽ a
- Antisimetría, es decir, si a ⩽ b y b ⩽ a, entonces a = b
- Transitividad, es decir, para a ⩽ b y b ⩽ c, se sigue que a ⩽ c
Dicha relación se llama relación (no estricta) de orden parcial, y el conjunto mismo es un conjunto parcialmente ordenado. Notación formal: ⟨S, ⩽⟩.
Como un ejemplo simple de conjunto parcialmente ordenado, podemos tomar el conjunto de todos los números naturales N con la relación de orden habitual ⩽. No es difícil verificar que se cumplen todos los axiomas necesarios.
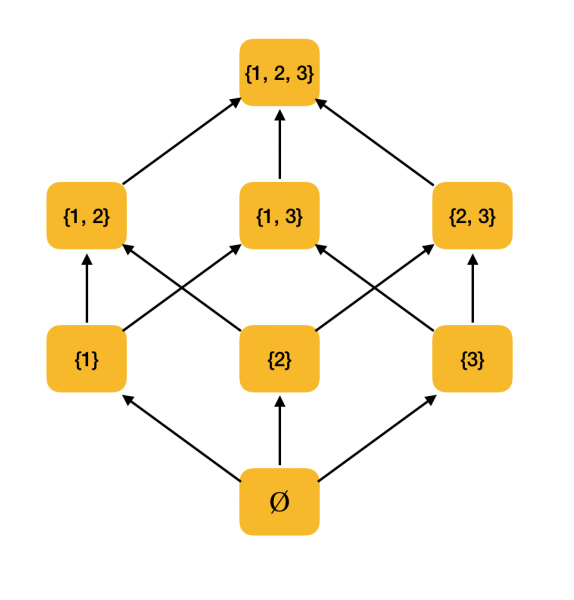
Un ejemplo más sustancial. Consideremos el conjunto de todos los subconjuntos {1, 2, 3}, ordenado por la relación de inclusión ⊆. De hecho, esta relación satisface todas las condiciones de la ordenación parcial, por lo que ⟨P({1, 2, 3}), ⊆⟩ es un conjunto parcialmente ordenado. En la imagen a continuación se muestra la estructura de este conjunto: si desde un elemento se puede llegar a otro a través de las flechas, entonces están en relación de orden.
Necesitamos dos definiciones simples del ámbito de la matemática: el supremo (supremum) y el ínfimo (infimum).
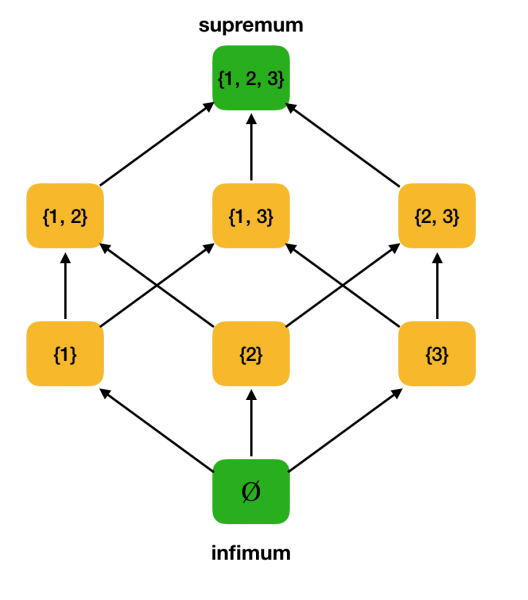
Definición 3. Sea ⟨S, ⩽⟩ un conjunto parcialmente ordenado, A ⊆ S. El límite superior de A es un elemento u ∈ S tal que ∀x ∈ S: x ⩽ u. Sea U el conjunto de todos los límites superiores de S. Si en U existe un elemento mínimo, se llama supremo y se denota como sup A.
De manera análoga se introduce el concepto de límite inferior exacto.
Definición 4. Sea ⟨S, ⩽⟩ un conjunto parcialmente ordenado, A ⊆ S. El límite inferior de A es un elemento l ∈ S tal que ∀x ∈ S: l ⩽ x. Sea L el conjunto de todos los límites inferiores de S. Si en L existe un elemento máximo, se llama ínfimo y se denota como inf A.
Consideremos como ejemplo el conjunto parcialmente ordenado ⟨P ({1, 2, 3}), ⊆⟩ y encontremos en él el supremo y el ínfimo:
Ahora podemos formular la definición de una reticulación algebraica.
Definición 5. Sea ⟨P, ⩽⟩ un conjunto parcialmente ordenado tal que cada subconjunto de dos elementos tiene límites superiores e inferiores exactos. Entonces P se llama reticulación algebraica. En este caso, sup{x, y} se escribe como x ∨ y, e inf {x, y} como x ∧ y.
Verifiquemos que nuestro ejemplo de trabajo ⟨P ({1, 2, 3}), ⊆⟩ es una retícula. En efecto, para cualesquiera a, b ∈ P ({1, 2, 3}), a∨b = a∪b, y a∧b = a∩b. Por ejemplo, consideremos los conjuntos {1, 2} y {1, 3} y encontremos su ínfimo y supremo. Si los intersectamos, obtenemos el conjunto {1}, que será el ínfimo. El supremo, en cambio, lo obtendremos al unirlos: {1, 2, 3}.
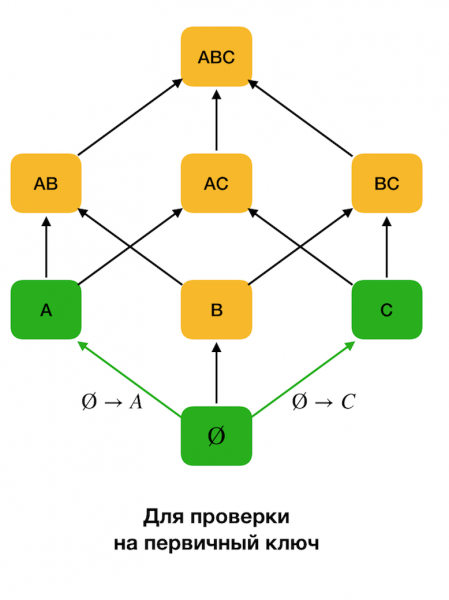
En los algoritmos de detección de FZ, el espacio de búsqueda a menudo se representa en forma de retícula, donde los conjuntos de un elemento (lee el primer nivel de búsqueda, donde la parte izquierda de las dependencias consiste en un solo atributo) representan cada atributo de la relación original.
Al principio, se consideran dependencias del tipo ∅ → Atributo único. Este paso permite determinar qué atributos son claves primarias (para tales atributos no hay determinantes, por lo que la parte izquierda está vacía). Luego, tales algoritmos avanzan hacia arriba en la retícula. Al mismo tiempo, cabe señalar que no es necesario recorrer toda la retícula, es decir, si se proporciona un tamaño máximo deseado para la parte izquierda, el algoritmo no avanzará más allá de un nivel con dicho tamaño.
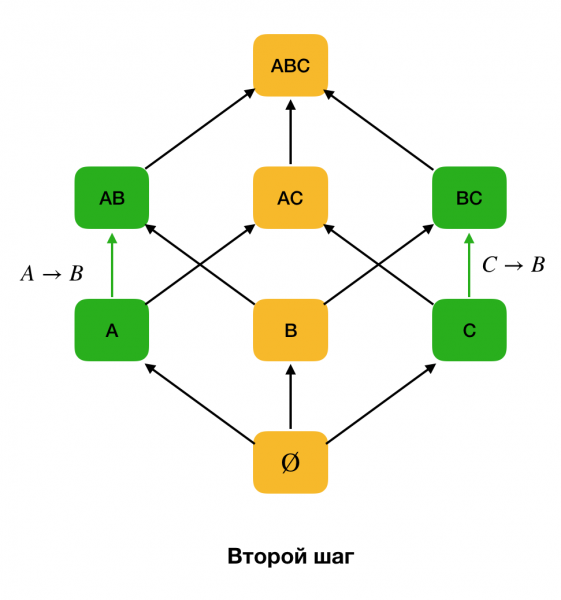
En la figura de abajo se muestra cómo se puede utilizar una red algebraica en la tarea de búsqueda de FD. Aquí, cada borde (X, XY) representa una dependencia X → Y. Por ejemplo, hemos pasado al primer nivel y sabemos que la dependencia se mantiene A → B (lo representaremos con una conexión verde entre los nodos A y B). Entonces, cuando avancemos por la red hacia arriba, no podemos verificar la dependencia A, C → B, porque ya no será mínima. De manera similar, no la verificaríamos si se mantuviera la dependencia C → B.
Además, por lo general, todos los algoritmos modernos para la búsqueda de FD utilizan una estructura de datos llamada partición (en el original — stripped partition [1]). La definición formal de una partición es la siguiente:
Definición 6. Sea X ⊆ R un conjunto de atributos para la relación r. Un clúster es un conjunto de índices de tuplas de r que tienen el mismo valor para X, es decir, c(t) = {i|ti[X] = t[X]}. La partición es un conjunto de clústeres, excluyendo los clústeres de longitud unitaria:

En palabras simples, la partición para el atributo X representa un conjunto de listas, donde cada lista contiene números de fila con valores idénticos para X. En la literatura moderna, la estructura que representa particiones se llama índice de lista de posiciones (PLI). Los clústeres de longitud unitaria se excluyen con el fin de comprimir el PLI, ya que son clústeres que contienen solo el número de registro con un valor único, que siempre será fácil de establecer.
Consideremos un ejemplo. Regresaremos a la misma tabla con los pacientes y construiremos particiones para las columnas Paciente y Sexo (apareció una nueva columna a la izquierda, que indica los números de fila de la tabla):
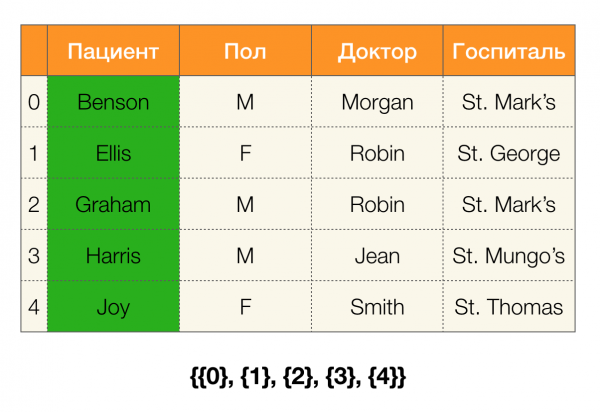
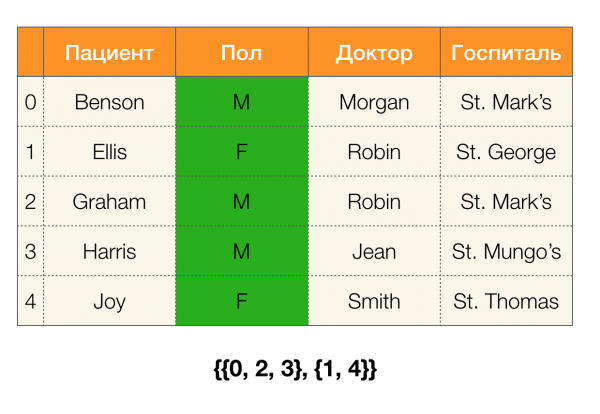
De este modo, de acuerdo con la definición, la partición para la columna Paciente en realidad estará vacía, ya que los clústeres individuales se excluyen de la partición.
Las particiones se pueden obtener a través de varios atributos. Y para ello hay dos caminos: recorrer la tabla y construir la partición de inmediato para todos los atributos necesarios, o construirla mediante la operación de intersección de particiones por un subconjunto de atributos. Los algoritmos de búsqueda de FD utilizan la segunda opción.
En palabras simples, para, por ejemplo, obtener una partición para las columnas ABC, se pueden tomar particiones para AC y B (o cualquier otro conjunto de subconjuntos no superpuestos) y cruzarlos entre sí. La operación de intersección de dos particiones destaca los clústeres de mayor longitud que son comunes a ambas particiones.
Consideremos un ejemplo:
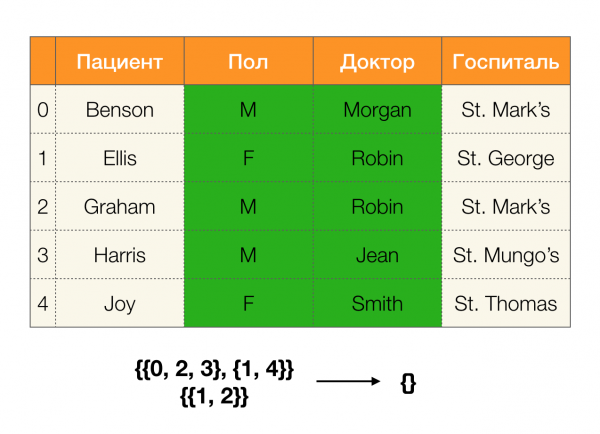
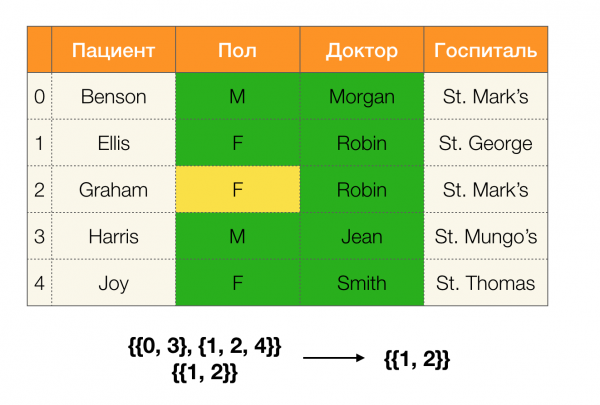
En el primer caso, obtuvimos una partición vacía. Si observamos la tabla, realmente no hay valores idénticos en dos atributos. Sin embargo, si modificamos un poco la tabla (caso de la derecha), obtendremos una intersección no vacía. De hecho, las filas 1 y 2 contienen los mismos valores en los atributos. Sexo y Doctor.
A continuación, necesitaremos un concepto como el tamaño de la partición. Formalmente:

En otras palabras, el tamaño de la partición representa la cantidad de clústeres que entran en la partición (recordemos que los clústeres individuales no entran en la partición):
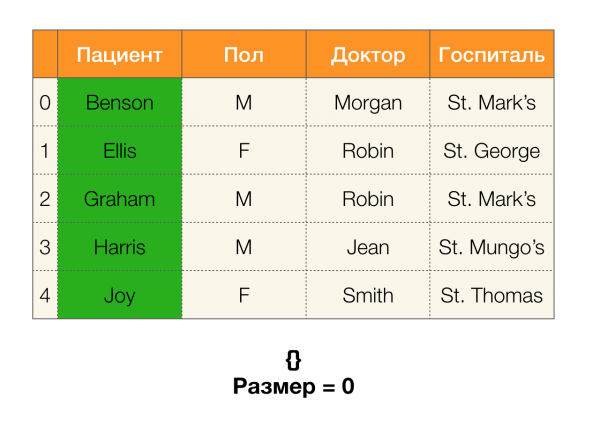
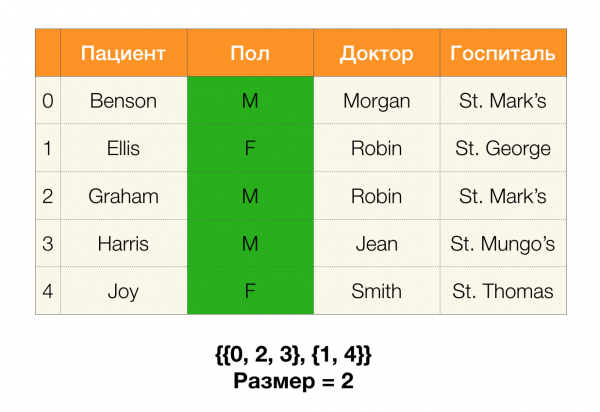
Ahora podemos definir uno de los lemas clave que, para las particiones dadas, permite establecer si se retiene la dependencia o no:
Lema 1. La dependencia A, B → C se retiene si y solo si

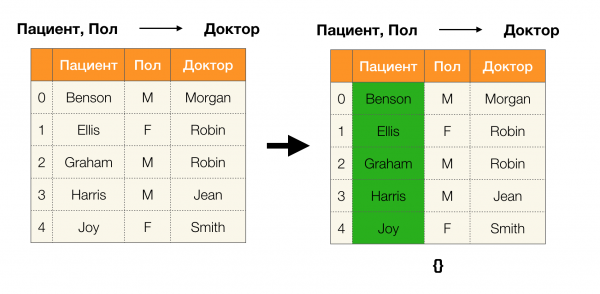
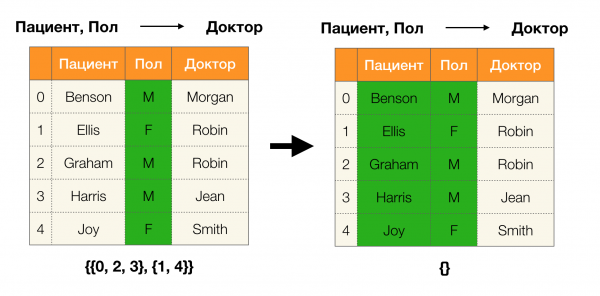
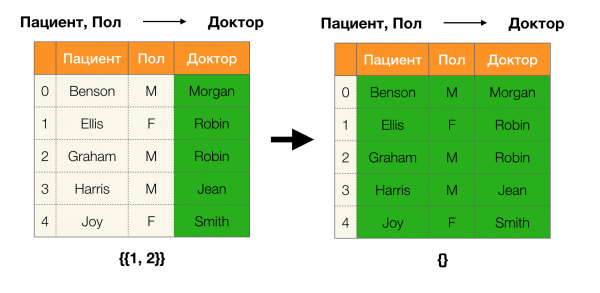
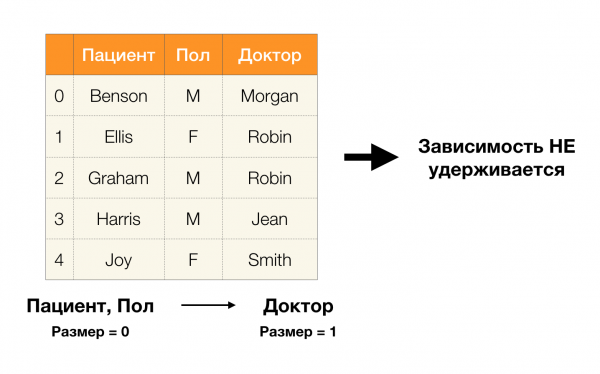
Según el lema, para determinar si se retiene la dependencia, es necesario realizar cuatro pasos:
- Calcular la partición para la parte izquierda de la dependencia
- Calcular la partición para la parte derecha de la dependencia
- Calcular el producto del primer y segundo paso
- Comparar los tamaños de las particiones obtenidas en el primer y tercer paso
A continuación se presenta un ejemplo de verificación de si se retiene la dependencia según este lema:
En este artículo hemos analizado conceptos como la dependencia funcional, la dependencia funcional aproximada, discutimos dónde se aplican, así como los algoritmos que existen para la búsqueda de dependencias funcionales. También hemos discutido detalladamente conceptos básicos pero importantes, que se utilizan activamente en los algoritmos modernos de búsqueda de dependencias funcionales.
Referencias bibliográficas:
- Huhtala Y. et al. TANE: Un algoritmo eficiente para descubrir dependencias funcionales y aproximadas //The computer journal. – 1999. – Vol. 42. – No. 2. – Pp. 100-111.
- Kruse S., Naumann F. Descubrimiento eficiente de dependencias aproximadas //Proceedings of the VLDB Endowment. – 2018. – Vol. 11. – No. 7. – Pp. 759-772.
- Papenbrock T., Naumann F. Un enfoque híbrido para el descubrimiento de dependencias funcionales //Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – Pp. 821-833.
- Papenbrock T. et al. Descubrimiento de dependencias funcionales: Una evaluación experimental de siete algoritmos //Proceedings of the VLDB Endowment. – 2015. – Vol. 8. – No. 10. – Pp. 1082-1093.
- Kumar A. et al. ¿Unirse o no unirse?: Pensando dos veces sobre las uniones antes de la selección de características //Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – Pp. 19-34.
- Abo Khamis M. et al. Aprendizaje en base de datos con tensores dispersos // Actas del 37º Simposio de ACM SIGMOD-SIGACT-SIGAI sobre principios de sistemas de bases de datos. – ACM, 2018. – Pp. 325-340.
- Hellerstein J. M. et al. La biblioteca de análisis MADlib: o habilidades MAD, el SQL // Actas del VLDB Endowment. – 2012. – Vol. 5. – N.º 12. – Pp. 1700-1711.
- Qin C., Rusu F. Aproximaciones especulativas para la optimización de descenso de gradiente distribuido a escala de tera // Actas del Cuarto Taller sobre análisis de datos en la Nube. – ACM, 2015. – P. 1.
- Meng X. et al. Mllib: Aprendizaje automático en apache spark // La revista de investigación de aprendizaje automático. – 2016. – Vol. 17. – N.º 1. – Pp. 1235-1241.
Los autores del artículo: , investigadora en , y , investigadora en
Fuente: habr.com
