

En los dos primeros artículos planteé la cuestión de la automatización y esbozé su marco; en el segundo hice una digresión sobre la virtualización de redes, como un primer enfoque para automatizar la configuración de servicios.
Ahora ha llegado el momento de dibujar el esquema de la red física.
Si no estás familiarizado con los dispositivos de redes de centros de datos, te recomiendo encarecidamente empezar por .
Todos los números:
Las prácticas descritas en esta serie deberían ser aplicables a redes de cualquier tipo, cualquier escala y con cualquier diversidad de vendedores. Sin embargo, no es posible describir un ejemplo universal de aplicación de estos enfoques. Por lo tanto, me centraré en la arquitectura moderna de la red del DC: .
Haremos DCI sobre MPLS L3VPN.
Por encima de la red física, opera una red Overlay desde el host (esto puede ser VXLAN de OpenStack o Tungsten Fabric o cualquier otra cosa que requiera de la red solo conectividad IP básica).
En este caso, se obtendrá un escenario relativamente simple para la automatización, porque tenemos mucho equipo que se configura de la misma manera.
Elegiremos un DC esférico en el vacío:
- Una versión del diseño en todas partes.
- Dos vendedores, formando dos planos de red.
- Un DC se parece a otro como dos gotas de agua.
Contenido
- Topología física
- Enrutamiento
- Plan IP
- Laboratorio
- Conclusión
- Enlaces útiles
Supongamos que nuestro Proveedor de Servicios LAN_DC será, por ejemplo, albergar videos de formación sobre supervivencia en ascensores atascados.
En las grandes ciudades esto tiene una popularidad inmensa, por lo que se necesita mucho equipo físico.
Primero describiré la red aproximadamente como uno desearía verla. Luego simplificaré para el laboratorio.
Topología física
Ubicaciones
LAN_DC tendrá 6 DC:
- Rusia (RU):
- Moscú (msk)
- Kazan (kzn)
- España (SP):
- Barcelona (bcn)
- Málaga (mlg)
- China (CN):
- Shanghái (sha)
- Xi'an (sia)

Dentro del DC (Intra-DC)
En todos los DC hay redes idénticas de conectividad interna, basadas en la topología Clos.
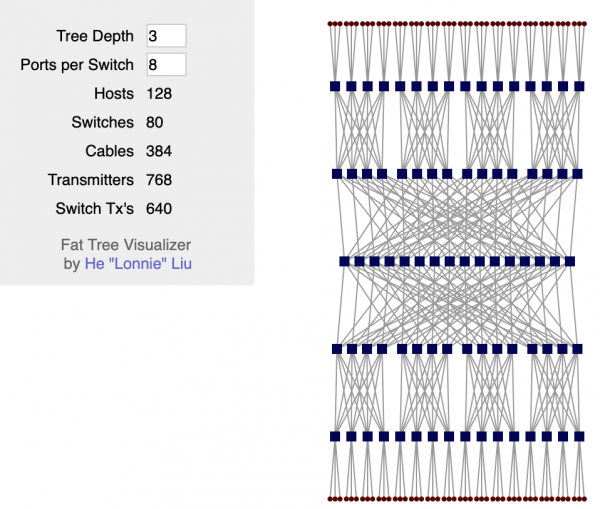
Qué son las redes Clos y por qué precisamente ellas — en un artículo separado. .
En cada DC hay 10 racks con máquinas, se numerarán como A, B, C Y así sucesivamente.
En cada rack hay 30 máquinas. No nos interesarán.
También hay un conmutador en cada rack, al que están conectadas todas las máquinas — esto es Conmutador Top of the Rack — ToR o, de otra manera, en términos de la fábrica Clos, lo llamaremos Hoja.

Esquema general de la fábrica.
Los nombraré XXX-hojaY, donde XXX — una abreviatura de tres letras del DC, Y — un número secuencial. Por ejemplo, kzn-leaf11.
En mis artículos me permitiré usar los términos Leaf y ToR de manera bastante libre como sinónimos. Sin embargo, hay que recordar que no es así.
ToR es un conmutador montado en rack al que se conectan las máquinas.
Leaf es el rol de un dispositivo en la red física o un switch de primer nivel en términos de la topología Clos.
Es decir, Leaf != ToR.
Así que un conmutador EndofRaw puede ser un Leaf, por ejemplo.
Sin embargo, en el ámbito de este artículo, seguiremos usándolos como sinónimos.
Cada conmutador ToR, a su vez, está conectado a cuatro conmutadores agregadores de nivel superior — Spine. Se ha asignado un rack a los Spine en el DC. Nombramos de manera similar: XXX-spineY.
En este mismo rack estará el equipo de red para la conectividad entre DC — 2 enrutadores con MPLS a bordo. Pero en gran medida — son los mismos ToR. Es decir, desde la perspectiva de los conmutadores Spine, no tiene ninguna importancia si se trata de un ToR convencional con máquinas conectadas o un enrutador para DCI — en cualquier caso, hay que hacer el reenvío.
Estos ToR especiales se llaman Edge-leaf. Los nombraremos XXX-edgeY.
Así se verá esto.
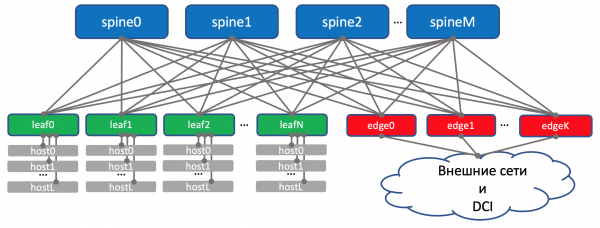
En el diagrama anterior, realmente coloqué edge y leaf en el mismo nivel. nos han acostumbrado a considerar el uplink (de ahí proviene el término) como enlaces hacia arriba. Pero aquí resulta que el 'uplink' DCI va de regreso hacia abajo, lo que desafía un poco la lógica habitual. En el caso de grandes redes, cuando los centros de datos se dividen en unidades más pequeñas — POD‘s (Point Of Delivery), se asignan ‘s separados Edge-PODpara DCI y acceso a redes externas.
Para facilitar la percepción en el futuro, seguiré dibujando Edge por encima de Spine, teniendo en cuenta que no hay ninguna inteligencia en Spine y no hay diferencias al trabajar con Leaf convencional y con Edge-leaf (aunque pueden existir matices, pero en general es así).
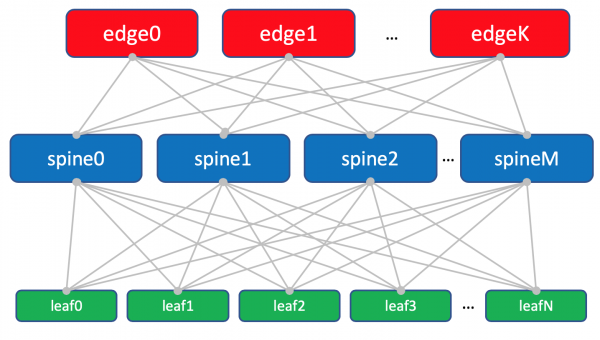
Diagrama de la fábrica con Edge-leaf.
La tríada Leaf, Spine y Edge forma la red Underlay o la fábrica.
La tarea de la fábrica de red (llámala Underlay), como ya hemos establecido en , es muy, muy simple: asegurar la conectividad IP entre las máquinas tanto dentro de un DC como entre ellos.
Por eso la red se llama fábrica, al igual que la fábrica de conmutación dentro de las cajas de red modulares, de lo que se puede leer más detalladamente en .
De hecho, esta topología se llama fábrica, porque fabric en español significa 'tela'. Es difícil no estar de acuerdo.
La fábrica es completamente L3. Sin VLAN, sin Broadcast. Estos son nuestros maravillosos programadores en LAN_DC, quienes saben escribir aplicaciones que operan en la paradigmática L3, y las máquinas virtuales no requieren Migración en Vivo manteniendo la dirección IP.
Y una vez más: la respuesta a la pregunta de por qué fábrica y por qué L3 está en un apartado separado. .
DCI — Interconexión de Centros de Datos (Inter-DC)
El DCI se organizará a través de Edge-Leaf, es decir, ellos son nuestro punto de salida hacia el backbone.
Para simplificar, supongamos que los DC están conectados entre sí por enlaces directos.
Excluyamos de la consideración la conectividad externa.
Soy consciente de que cada vez que elimino un componente, simplifico significativamente la red. Y en la automatización de nuestra red abstracta todo irá bien, mientras que en la real surgirán complicaciones.
Es así. Y aun así, el objetivo de esta serie es pensar y trabajar en enfoques, no resolver problemas imaginarios de forma heroica.
En los Edge-Leaf, el underlay se coloca en VPN y se transmite a través del backbone MPLS (ese enlace directo).
Así que esta es la esquema de alto nivel que resulta.

Enrutamiento
Para el enrutamiento dentro del DC, usaremos BGP.
En el backbone MPLS OSPF+LDP.
Para DCI, es decir, para la organización de la conectividad en el underlay — BGP L3VPN sobre MPLS.
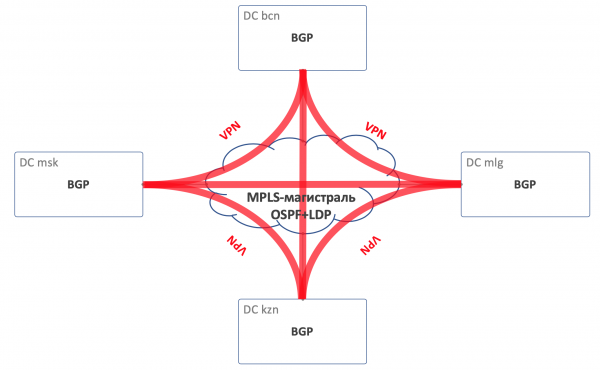
Esquema general de enrutamiento.
En la fábrica no hay OSPF ni ISIS (protocolo de enrutamiento prohibido en la Federación Rusa).
Y esto significa que no habrá Auto-discover y cálculo de rutas más cortas — solo configuración manual (en realidad automática — estamos hablando de automatización aquí) del protocolo, vecindad y políticas.
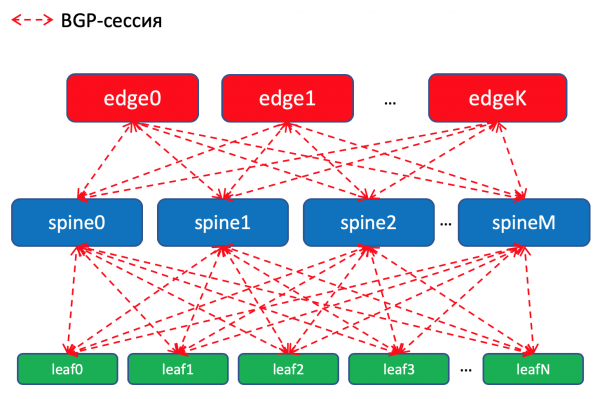
Esquema de enrutamiento BGP dentro del DC.
¿Por qué BGP?
Sobre este tema hay de Facebook y Arista, que explica cómo construir redes muy grandes de centros de datos, usando BGP. Se lee casi como ficción, lo recomiendo mucho para una noche tranquila.
Además, hay toda una sección en mi artículo dedicada a esto. A donde les .
Pero si lo resumimos, ningún IGP es adecuado para redes grandes de centros de datos, donde la cuenta de dispositivos de red llega a miles.
Además, utilizar BGP en todas partes permitirá no dispersarse en el soporte de varios protocolos diferentes y la sincronización entre ellos.
Poniendo la mano en el corazón, en nuestra fábrica, que probablemente no crecerá rápidamente, bastaría con OSPF. Realmente, estos son problemas de los megascaladores y titanes del cloud. Pero soñemos solo por unos pocos lanzamientos que lo necesitamos, y usaremos BGP, como dejó dicho Pyotr Lapukhov.
Políticas de enrutamiento
En los conmutadores Leaf, importamos en BGP los prefijos de las interfaces de Underlay con las redes.
Tendremos una sesión de BGP entre cada par de Leaf-Spine, donde estos prefijos de Underlay se anunciarán por la red de ida y vuelta.
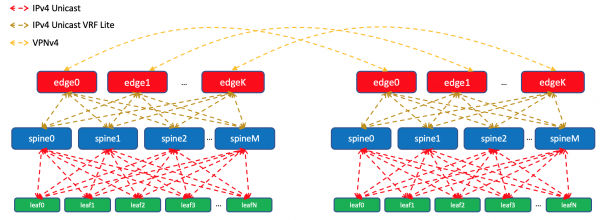
Dentro de un centro de datos, distribuiremos las especificidades que importamos en ToR. En los Edge-Leaf, las agregaremos y las anunciaremos a centros de datos remotos y las bajaremos hasta los ToR. Es decir, cada ToR sabrá exactamente cómo llegar a otro ToR en el mismo centro de datos y dónde está el punto de entrada para llegar al ToR en otro centro de datos.
En DCI, las rutas se transmitirán como VPNv4. Para ello, la interfaz de Edge-Leaf hacia la fábrica se colocará en un VRF, lo llamaremos UNDERLAY, y la vecindad con Spine en el Edge-Leaf se levantará dentro del VRF, mientras que entre los Edge-Leaf en la familia de VPNv4.
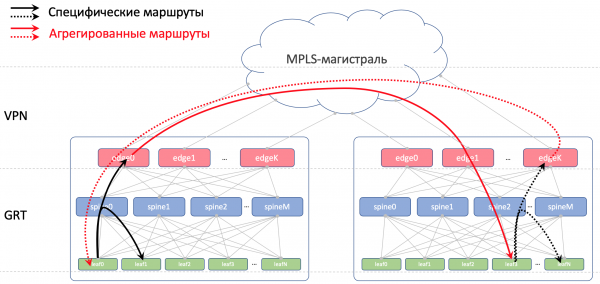
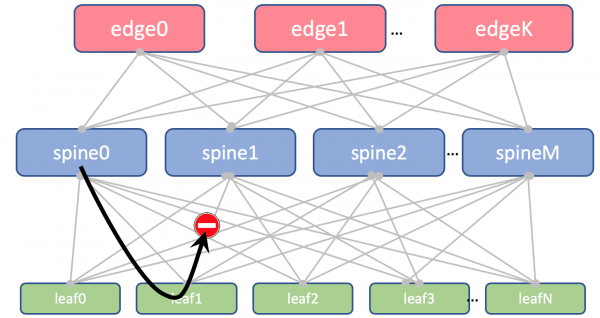
También prohibiremos reanunciar las rutas recibidas de los spines, de vuelta a ellos mismos.
En Leaf y Spine, no importaremos Loopbacks. Solo los necesitaremos para definir el Router ID.
Pero en los Edge-Leaf, lo importaremos en el BGP Global. Entre las direcciones Loopback, los Edge-Leaf establecerán una sesión de BGP en la familia de VPN IPv4 entre ellos.
Entre los dispositivos EDGE, tendremos una ruta extendida en OSPF+LDP. Todo en una zona. Configuración extremadamente simple.
Así es como se verá el enrutamiento.
BGP ASN
Edge-Leaf ASN
En los Edge-Leaf habrá un ASN en todos los centros de datos. Es importante que entre los Edge-Leaf haya iBGP, y no caigamos en los matices de eBGP. Que sea 65535. En la realidad, podría ser el número de un AS público.
Spine ASN
En Spine, tendremos un ASN por centro de datos. Comenzaremos aquí con el primer número del rango de AS privados: 64512, 64513 y así sucesivamente.
¿Por qué ASN en el centro de datos?
Descomponemos esta pregunta en dos:
- ¿Por qué ASN idénticos en todos los spines de un centro de datos?
- ¿Por qué diferentes en diferentes centros de datos?
¿Por qué ASN idénticos en todos los spines de un centro de datos?
Así es como se verá el AS-Path de la ruta de Underlay en Edge-Leaf:
[leafX_ASN, spine_ASN, edge_ASN]
Al intentar anunciarlo de vuelta a Spine, este lo rechazará porque su AS (Spine_AS) ya está en la lista.
Sin embargo, dentro del DC estamos completamente de acuerdo en que las rutas Underlay que asciendan hasta Edge no podrán descender. Toda la comunicación entre hosts dentro del DC debe realizarse en el nivel de los spines.
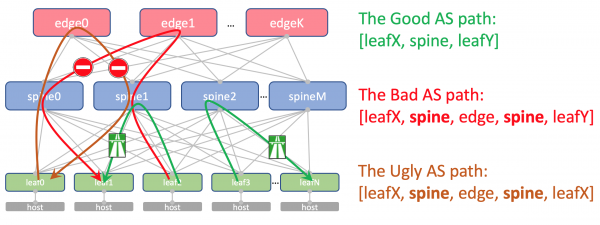
Mientras tanto, las rutas agregadas de otros DC tendrán un acceso fluido a los ToR, ya que en su AS-Path solo estará el ASN 65535, el número AS de los Edge-Leafs, porque fue en ellos donde se crearon.
Por qué son diferentes en diferentes DC
Teóricamente, puede que necesitemos transferir Loopbacks de algunas máquinas virtuales de servicio entre DC.
Por ejemplo, en el host se iniciará un Route Reflector o (Virtual Network Gateway), que se conectará a través de BGP con el ToR y anunciará su loopback, que debe ser accesible desde todos los DC.
Así es como se verá su AS-Path:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
Y aquí no deberían haber ASN repetidos en ninguna parte.
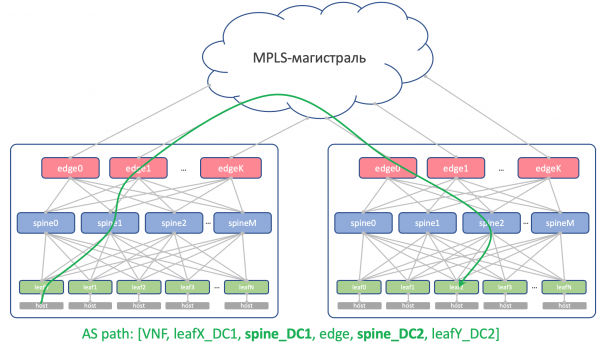
Es decir, Spine_DC1 y Spine_DC2 deben ser diferentes, al igual que leafX_DC1 y leafY_DC2, hacia donde estamos llegando.
Como probablemente sepa, existen hacks que permiten aceptar rutas con ASN repetidos a pesar del mecanismo de prevención de bucles (allowas-in en Cisco). Y esto incluso tiene aplicaciones legítimas. Pero es una posible brecha en la estabilidad de la red. Y personalmente he caído en ella un par de veces.
Y si tenemos la oportunidad de no usar cosas peligrosas, la aprovecharemos.
Leaf ASN
Tendremos un ASN individual en cada conmutador Leaf dentro de toda la red.
Hacemos esto por las razones mencionadas anteriormente: un AS-Path sin bucles, una configuración de BGP sin rieles.
Para que las rutas entre Leaf pasen sin problemas, el AS-Path debe verse así:
[leafX_ASN, spine_ASN, leafY_ASN]
donde sería bueno que leafX_ASN y leafY_ASN fueran diferentes.
Esto es necesario también para la situación del anuncio del loopback VNF entre DC:
[VNF_ASN, leafX_DC1_ASN, spine_DC1_ASN, edge_ASN, spine_DC2_ASN, leafY_DC2_ASN]
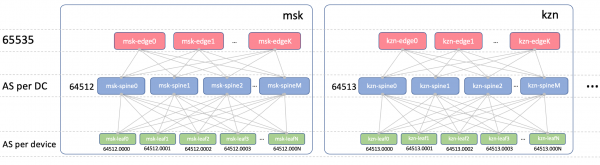
Vamos a utilizar un ASN de 4 bytes y generarlo en base al ASN del Spine y el número del conmutador Leaf, es decir, así: Spine_ASN.0000X.
Así es como se presenta el ASN.
Plan IP
Principalmente, necesitamos asignar direcciones para las siguientes conexiones:
- Direcciones de la red Underlay entre el ToR y la máquina. Deben ser únicas en toda la red, para que cualquier máquina pueda comunicarse con cualquier otra. Perfectamente adecuadas 10/8. Por cada rack /26 con reserva. Asignaremos /19 para el DC y /17 para la región.
- Direcciones de enlace entre Leaf/Tor y Spine.
Se deberían asignar algorítmicamente, es decir, calcularse a partir de los nombres de los dispositivos que deben conectarse.
Que sea… 169.254.0.0/16.
Específicamente 169.254.00X.Y/31, donde X — número de Spine, Y — red P2P /31.
Esto permitirá ejecutar hasta 128 racks y hasta 10 Spine en el DC. Las direcciones de enlace pueden (y serán) repetidas de un DC a otro. - El vínculo Spine - Edge-Leaf se organizará en subredes 169.254.10X.Y/31, donde de la misma forma X — número de Spine, Y — red P2P /31.
- Las direcciones de enlace de Edge-Leaf a la troncal MPLS. Aquí la situación es un poco diferente: es el punto de conexión de todos los fragmentos en un solo pastel, por lo que no se pueden reutilizar las mismas direcciones: hay que elegir la siguiente subred libre. Por lo tanto, tomaremos como base 192.168.0.0/16 y extraeremos direcciones libres de ella.
- Direcciones Loopback. Asignaremos todo el rango 172.16.0.0/12.
- Leaf — por /25 en el DC — los mismos 128 racks. Asignaremos por /23 a la región.
- Spine — por /28 en el DC — hasta 16 Spine. Asignaremos por /26 a la región.
- Edge-Leaf — por /29 en el DC — hasta 8 dispositivos. Asignaremos por /27 a la región.
Si en el DC no contamos con los rangos asignados (y no los tendremos — aspiramos a ser hiperescaladores), simplemente asignamos el siguiente bloque.
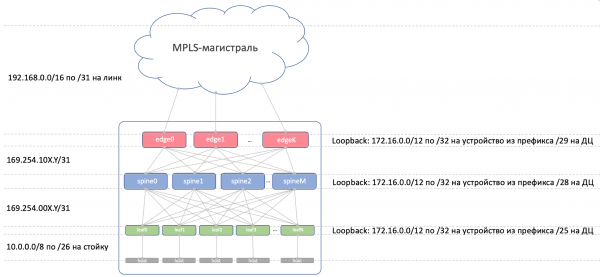
Esa es la imagen con la asignación de IP.
Loopbacks:
Prefijo
Rol del dispositivo
Región
DC
172.16.0.0/23
edge
172.16.0.0/27
es
172.16.0.0/29
msk
172.16.0.8/29
kzn
172.16.0.32/27
sp
172.16.0.32/29
bcn
172.16.0.40/29
mlg
172.16.0.64/27
cn
172.16.0.64/29
sha
172.16.0.72/29
sia
172.16.2.0/23
spine
172.16.2.0/26
es
172.16.2.0/28
msk
172.16.2.16/28
kzn
172.16.2.64/26
sp
172.16.2.64/28
bcn
172.16.2.80/28
mlg
172.16.2.128/26
cn
172.16.2.128/28
sha
172.16.2.144/28
sia
172.16.8.0/21
leaf
172.16.8.0/23
es
172.16.8.0/25
msk
172.16.8.128/25
kzn
172.16.10.0/23
sp
172.16.10.0/25
bcn
172.16.10.128/25
mlg
172.16.12.0/23
cn
172.16.12.0/25
sha
172.16.12.128/25
sia
Capa subyacente:
Prefijo
Región
DC
10.0.0.0/17
es
10.0.0.0/19
msk
10.0.32.0/19
kzn
10.0.128.0/17
sp
10.0.128.0/19
bcn
10.0.160.0/19
mlg
10.1.0.0/17
cn
10.1.0.0/19
sha
10.1.32.0/19
sia
Laboratorio
Dos proveedores. Una red. ADSM.
Juniper + Arista. Ubuntu. La buena y antigua Eva.
La cantidad de recursos en nuestra virtualización en Mirana está limitada, así que para la práctica usaremos una red simplificada al máximo.
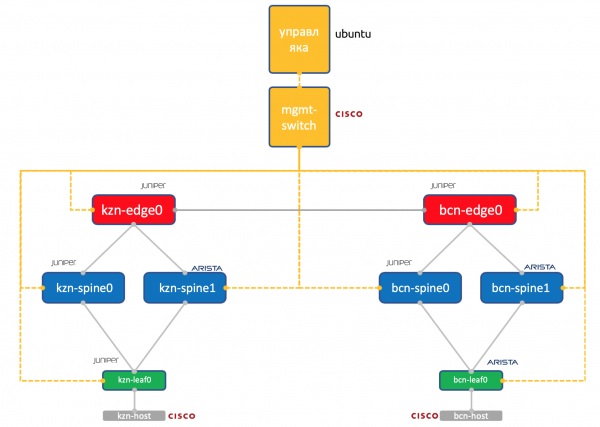
Dos centros de datos: Kazán y Barcelona.
- Dos spines en cada uno: Juniper y Arista.
- Un solo torus (Leaf) en cada uno — Juniper y Arista, con un host conectado (utilizaremos el ligero Cisco IOL para esto).
- Una nodos Edge-Leaf (por ahora solo Juniper).
- Un switch Cisco para dominarlos a todos.
- Además de los dispositivos de red, se ha lanzado una máquina virtual de gestión. Bajo Ubuntu.
Tiene acceso a todos los dispositivos, en ella funcionarán sistemas IPAM/DCIM, un conjunto de scripts en Python, Ansible y cualquier cosa más que podamos necesitar.
de todos los dispositivos de red que intentaremos reproducir con automatización.
Conclusión
¿Es así como se acostumbra? ¿Hacer un breve resumen al final de cada artículo?
Así que hemos elegido Clos dentro del DC, ya que esperamos mucho tráfico Este-Oeste y queremos ECMP.
Hemos dividido la red en física (underlay) y virtual (overlay). Además, la capa overlay comienza en el host, simplificando así los requisitos para el underlay.
Elegimos BGP como protocolo de enrutamiento para redes de capas de acceso debido a su escalabilidad y flexibilidad de políticas.
Tendremos nodos separados para organizar DCI — Edge-leaf.
En la troncal habrá OSPF+LDP.
El DCI se implementará sobre MPLS L3VPN.
Para direcciones IP de enlaces P2P, las calcularemos algorítmicamente en base a los nombres de los dispositivos.
Asignaremos bucles según el rol de los dispositivos y su ubicación de manera secuencial.
Los prefijos de capas de acceso se asignarán únicamente a los conmutadores Leaf de manera secuencial según su ubicación.
Supongamos que en este momento aún no tenemos el equipo instalado.
Por lo tanto, nuestros siguientes pasos serán introducirlo en los sistemas (IPAM, inventario), organizar el acceso, generar la configuración y desplegarla.
En el próximo artículo, analizaremos Netbox — un sistema de inventario y gestión del espacio IP en el centro de datos.
Gracias
- A Andrey Glazkov aka @glazgoo por la revisión y ediciones.
- A Alexander Klimenko aka @v00lk por la revisión y ediciones.
- A Artem Chernobai por el KPDP.
Fuente: habr.com
