

Inspirado en mis presentaciones en Highload++ y DataFest Minsk 2019.
Para muchos hoy en día, el correo es una parte integral de la vida en línea. A través de él, llevamos a cabo correspondencia empresarial, almacenamos toda clase de información importante relacionada con finanzas, reservas de hoteles, realización de pedidos y mucho más. A mediados de 2018, formulamos una estrategia de desarrollo del producto de correo. ¿Cómo debería ser el correo moderno?
El correo debe ser inteligente, es decir, ayudar a los usuarios a navegar en el creciente volumen de información: filtrar, estructurar y ofrecerla de la manera más conveniente. Debe ser útil, permitiendo resolver diversas tareas directamente en la bandeja de entrada, por ejemplo, pagar multas (una función que, lamentablemente, utilizo). Y, por supuesto, el correo debe garantizar la protección de la información, filtrando el spam y protegiendo contra hackeos, es decir, debe ser seguro.
Estas direcciones determinan una serie de tareas clave, muchas de las cuales pueden resolverse de manera efectiva con el uso de aprendizaje automático. Aquí hay ejemplos de características ya implementadas en el marco de la estrategia, una para cada dirección.
- Respuesta Inteligente. El correo tiene una función de respuesta inteligente. La red neuronal analiza el texto del correo, entiende su significado y objetivo, y como resultado, ofrece tres opciones de respuesta más adecuadas: positiva, negativa y neutral. Esto ayuda a ahorrar tiempo al responder correos, y a menudo responde de manera no estándar y divertida para sí mismo.
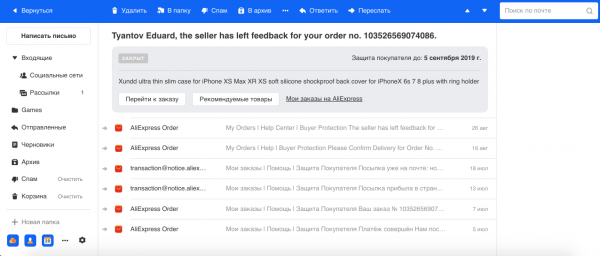
- Agrupación de correos, relacionados con pedidos en tiendas en línea. A menudo compramos en línea, y generalmente las tiendas pueden enviar varios correos para cada pedido. Por ejemplo, de AliExpress, el servicio más grande, llegan muchos correos para un pedido, y hemos calculado que en el caso extremo su número puede llegar hasta 29. Por lo tanto, con la ayuda del modelo de Reconocimiento de Entidades Nombradas, extraemos el número de pedido y otra información del texto y agrupamos todos los correos en un hilo. También mostramos la información principal sobre el pedido en una etiqueta separada, lo que facilita el tratamiento de este tipo de correos.

- Antiphishing. El phishing es un tipo de fraude especialmente peligroso mediante el cual los delincuentes intentan apoderarse de información financiera (incluida la información de las tarjetas bancarias del usuario) y credenciales. Estos correos se mimetizan con mensajes auténticos, incluidos los visuales. Por lo tanto, gracias a la Visión por Computadora, reconocemos los logotipos y el estilo de diseño de correos de grandes empresas (por ejemplo, Mail.ru, Sber, Alfa) y tomamos esto en cuenta junto con el texto y otros signos en nuestros clasificadores de spam y phishing.
Aprendizaje automático
Un poco sobre el aprendizaje automático en el correo en general. El correo es un sistema de alta carga: a través de nuestros servidores se procesan en promedio 1.5 mil millones de correos al día para 30 millones de usuarios DAU. Aproximadamente 30 sistemas de aprendizaje automático gestionan todas las funciones y características necesarias.
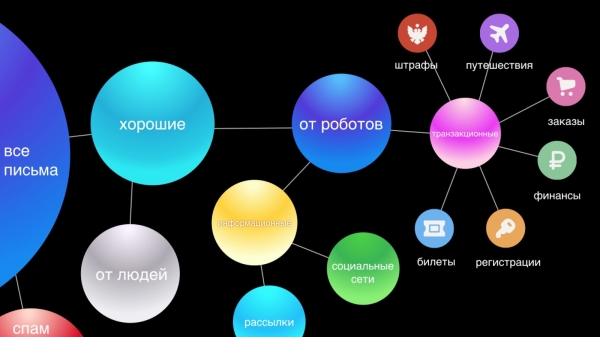
Cada correo pasa por toda una cadena de clasificación. Primero filtramos el spam y dejamos los correos buenos. Los usuarios a menudo no notan el trabajo del antispam, porque el 95-99 % del spam ni siquiera llega a la carpeta correspondiente. La detección de spam es una parte muy importante de nuestro sistema y la más compleja, ya que en el campo del antispam existe una adaptación constante entre sistemas de defensa y ataque, lo que presenta un desafío técnico continuo para nuestro equipo.
Luego, diferenciamos los correos de personas y de robots. Los correos de personas son los más importantes, por lo que ofrecemos funciones como Smart Reply para ellos. Los correos de robots se dividen en dos partes: transaccionales, que son correos importantes de servicios, como confirmaciones de compras o reservas de hoteles, finanzas, y informativos, que son publicidad comercial y descuentos.
Creemos que los correos transaccionales son tan importantes como la correspondencia personal. Deben estar a mano, ya que a menudo se necesita encontrar rápidamente información sobre un pedido o una reserva de vuelo, y perdemos tiempo buscando estos correos. Por ello, para mayor comodidad, los dividimos automáticamente en seis categorías principales: viajes, pedidos, finanzas, entradas, inscripciones y, finalmente, multas.
Los correos informativos son el grupo más numeroso y, probablemente, el menos importante, ya que no requieren una respuesta inmediata, pues nada significativo cambiará en la vida del usuario si no lee dicho correo. En nuestra nueva interfaz, los agrupamos en dos hilos: redes sociales y boletines, limpiando visualmente la bandeja de entrada y dejando a la vista solo los correos importantes.
Explotación
La gran cantidad de sistemas presenta numerosas dificultades en su operación. Con el tiempo, los modelos se degradan, al igual que cualquier software: algunos indicadores fallan, las máquinas dejan de funcionar, se acumula código defectuoso. Además, los datos cambian constantemente: se añaden nuevos, se transforma el patrón de comportamiento de los usuarios, etc., por lo que un modelo sin el soporte adecuado funcionará cada vez peor con el tiempo.
No se puede olvidar que, cuanto más profundo es el aprendizaje automático en la vida de los usuarios, mayor es su impacto en el ecosistema, y, como consecuencia, mayores son las pérdidas financieras o ganancias que pueden obtener los jugadores del mercado. Por ello, en un número creciente de áreas, los jugadores se adaptan a trabajar con algoritmos de ML (ejemplos clásicos: publicidad, búsqueda y el ya mencionado anti-spam).
Además, las tareas de aprendizaje automático tienen una particularidad: cualquier pequeña, aunque insignificante, alteración en el sistema puede generar mucho trabajo con el modelo: trabajo con datos, reentrenamiento, despliegue, lo que puede extenderse por semanas o meses. Cuanto más rápido cambie el entorno en el que operan sus modelos, más esfuerzo requerirá su mantenimiento. El equipo puede crear múltiples sistemas y alegrarse, pero luego gastar casi todos los recursos en su mantenimiento, sin posibilidad de hacer algo nuevo. Nos encontramos alguna vez en esta situación con el equipo de anti-spam. Y llegamos a la evidente conclusión de que el mantenimiento debe ser automatizado.
Automatización
¿Qué se puede automatizar? En realidad, casi todo. He identificado cuatro áreas que definen la infraestructura del aprendizaje automático:
- recolección de datos;
- reentrenamiento;
- despliegue;
- pruebas y monitoreo.
Si el entorno es inestable y cambia constantemente, toda la infraestructura alrededor del modelo resulta ser mucho más importante que el propio modelo. Puede ser un viejo y confiable clasificador lineal, pero si se alimentan correctamente las características y se establece un buen feedback de los usuarios, funcionará mucho mejor que los modelos de última generación con todas sus complejidades.
Ciclo de retroalimentación
Este ciclo combina la recolección de datos, el reentrenamiento y el despliegue — en esencia, todo el ciclo de actualización del modelo. ¿Por qué es importante? Observa el gráfico de registro en el correo:
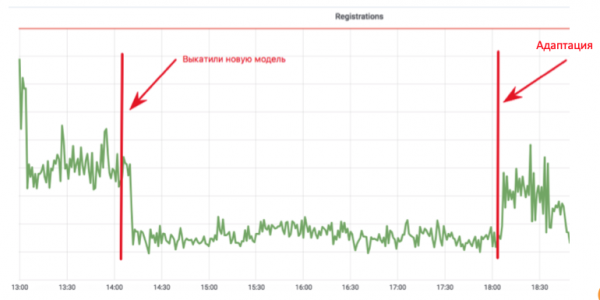
Un desarrollador de aprendizaje automático implementó un modelo anti-bots, que impide que los bots se registren en el correo. El gráfico desciende a un nivel donde solo permanecen los usuarios reales. ¡Todo genial! Pero pasan cuatro horas, los spammers ajustan sus scripts y todo vuelve a la normalidad. En esta implementación, el desarrollador gastó un mes añadiendo características y reentrenando el modelo, pero el spammer pudo adaptarse en solo cuatro horas.
Para que no sea tan doloroso y no haya que rehacer todo luego, es fundamental pensar desde el principio en cómo será el ciclo de retroalimentación y qué haremos si el entorno cambia. Comencemos con la recolección de datos: este es el combustible para nuestros algoritmos.
Recopilación de datos
Es evidente que para las redes neuronales modernas, cuanto más datos, mejor. Estos datos los generan, en esencia, los usuarios del producto. Los usuarios pueden ayudar etiquetando datos, pero no se puede abusar de esto, porque en algún momento a los usuarios les aburrirá reentrenar tus modelos y se cambiarán a otro producto.
Uno de los errores más comunes (aquí hago referencia a Andrew Ng) es una excesiva orientación hacia las métricas en el conjunto de datos de prueba, en lugar de sobre la retroalimentación del usuario, que en realidad es la principal medida de calidad del trabajo, ya que estamos creando un producto para el usuario. Si al usuario no le resulta clara o le desagrada la operación del modelo, entonces todo es en vano.
Por eso, el usuario siempre debe tener la posibilidad de votar, se le debe proporcionar una herramienta para dar su feedback. Si consideramos que en una bandeja de entrada ha llegado un correo relacionado con finanzas, debe marcarse como 'finanzas', y dibujar un botón que el usuario pueda presionar y decir que no se trata de finanzas.
Calidad de la retroalimentación
Hablemos sobre la calidad de la retroalimentación del usuario. En primer lugar, tú y el usuario pueden atribuir diferentes significados a un mismo concepto. Por ejemplo, tú y los gerentes de producto consideran que "finanzas" son cartas del banco, mientras que el usuario piensa que una carta de la abuela sobre la pensión también se refiere a finanzas. En segundo lugar, hay usuarios que presionan botones sin pensar, sin lógica alguna. En tercer lugar, el usuario puede tener ideas completamente equivocadas. Un claro ejemplo de nuestra práctica es la implementación de un clasificador , un tipo de spam bastante curioso, donde se le ofrece al usuario reclamar varios millones de dólares de un pariente lejano que de repente ha sido encontrado en África. Tras la implementación de este clasificador, revisamos los clics en "No es spam" en estos correos, y resultó que el 80 % de ellos eran jugosos correos de spam nigeriano, lo que indica que los usuarios pueden ser extremadamente crédulos.
Y no olvidemos que no solo las personas pueden presionar botones, sino también varios bots que se hacen pasar por navegadores. Así que la retroalimentación cruda no es adecuada para el aprendizaje. ¿Qué se puede hacer con esta información?
Aplicamos dos enfoques:
- Retroalimentación de ML relacionado. Por ejemplo, tenemos un sistema antipatrones en línea que, como mencioné anteriormente, toma decisiones rápidas basadas en un número limitado de características. Y hay un segundo sistema, más lento, que opera después de los hechos. Este cuenta con más datos sobre el usuario, su comportamiento, etc. Como consecuencia, se toma la decisión más equilibrada, por lo que tiene mayor precisión y exhaustividad. Se puede dirigir la diferencia en el funcionamiento de estos sistemas a la primera como datos para el aprendizaje. De esta manera, el sistema más simple siempre intentará acercarse al rendimiento del sistema más complejo.
- Clasificación de clics. Se puede clasificar cada clic de usuario, evaluar su validez y posibilidad de uso. Hacemos esto en el antispam del correo, utilizando características del usuario, su historial, características del remitente, el texto mismo y el resultado del trabajo de los clasificadores. Al final, obtenemos un sistema automático que valida el feedback del usuario. Y dado que necesita ser reentrenado mucho menos, su funcionamiento puede convertirse en la base para todos los demás sistemas. La prioridad principal en este modelo es la precisión, porque entrenar el modelo con datos imprecisos puede tener consecuencias graves.
Mientras limpiamos los datos y reentrenamos nuestros sistemas de ML, no debemos olvidar a los usuarios, ya que para nosotros miles o millones de errores en el gráfico son solo estadísticas, pero para el usuario cada error es una tragedia. Además de que el usuario debe lidiar con tu error en el producto, después de dar su retroalimentación, espera que situaciones similares no se repitan en el futuro. Por lo tanto, siempre debemos dar a los usuarios no solo la oportunidad de votar, sino también de corregir el comportamiento de los sistemas de ML, creando, por ejemplo, heurísticas personales para cada clic de retroalimentación; en el caso del correo, esto podría ser la posibilidad de filtrar correos similares según el remitente y el asunto para ese usuario.
También es necesario, basándose en algunos informes o solicitudes al soporte, ajustar el modelo de manera semiautomática o manual, para que otros usuarios no sufran problemas similares.
Heurísticas para el entrenamiento
Con estos datos heurísticos y ajustes, hay dos problemas. El primero es que la cantidad de ajustes en constante crecimiento es difícil de mantener, sin mencionar su calidad y funcionamiento a largo plazo. El segundo problema es que el error puede no ser frecuente y que unos pocos clics no serán suficientes para reentrenar el modelo. Aparentemente, estos dos efectos no relacionados se pueden mitigar sustancialmente si se aplica el siguiente enfoque.
- Creamos un ajuste temporal.
- Dirigimos los datos desde él al modelo, que se reentrena regularmente, incluyendo los datos obtenidos. Aquí, por supuesto, es importante que la heurística tenga alta precisión para no reducir la calidad de los datos en el conjunto de entrenamiento.
- Luego, configuramos la monitorización para que se active con el 'puente', y si después de un tiempo el 'puente' ya no se activa y queda completamente cubierto por el modelo, entonces se puede eliminar sin problemas. Ahora es poco probable que este problema se repita.
Así que el ejército de 'puentes' es muy útil. Lo importante es que su uso sea temporal y no permanente.
Reentrenamiento
El reentrenamiento es el proceso de agregar nuevos datos, obtenidos a partir de la retroalimentación de los usuarios u otros sistemas, y entrenar el modelo existente con ellos. El reentrenamiento puede presentar varios problemas:
- El modelo puede simplemente no soportar el reentrenamiento y solo aprender desde cero.
- No hay nada en el libro de la naturaleza que diga que el reentrenamiento necesariamente mejorará la calidad del trabajo en producción. A menudo ocurre precisamente lo contrario, es decir, puede resultar en una degradación.
- Los cambios pueden ser impredecibles. Este es un punto bastante delicado que hemos identificado. Incluso si un nuevo modelo en una prueba A/B muestra resultados similares en comparación con el actual, eso no significa que funcionará de la misma manera. Su rendimiento puede diferir en un solo porcentaje, lo cual puede introducir nuevos errores o reactivar antiguos ya solucionados. Con los errores actuales, tanto nosotros como los usuarios ya hemos aprendido a convivir, y cuando surgen muchos nuevos errores, el usuario también puede no entender lo que está pasando, ya que espera un comportamiento predecible.
Por lo tanto, lo más importante en el reentrenamiento es garantizar que se mejore el modelo, o al menos no se degrade.
Lo primero que viene a la mente cuando hablamos de reentrenamiento es el enfoque de Aprendizaje Activo. ¿Qué significa esto? Por ejemplo, un clasificador determina si un correo pertenece a finanzas, y alrededor de su frontera de decisión agregamos una muestra de ejemplos etiquetados. Esto funciona bien, por ejemplo, en publicidad, donde hay mucha retroalimentación y se puede entrenar el modelo en tiempo real. Pero si hay poca retroalimentación, obtenemos una muestra muy sesgada en relación con la distribución de datos en producción, sobre la cual no se puede evaluar el comportamiento del modelo durante su funcionamiento.
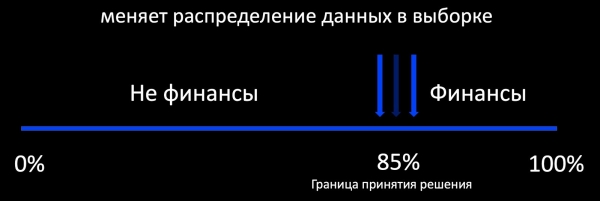
De hecho, nuestro objetivo es conservar los patrones antiguos, los modelos ya conocidos, y adquirir nuevos. Aquí la continuidad es importante. El modelo que hemos desplegado con gran esfuerzo ya funciona, por lo que podemos orientarnos en su rendimiento.
En el correo se aplican diferentes modelos: árboles, lineales, redes neuronales. Para cada uno desarrollamos nuestro propio algoritmo de reentrenamiento. En el proceso de reentrenamiento, no solo obtenemos nuevos datos, sino que a menudo también aparecen nuevas características que tendremos en cuenta en todos los algoritmos que se presentan a continuación.
Modelos lineales
Supongamos que tenemos regresión logística. Componemos la función de pérdida del modelo a partir de los siguientes componentes:
- LogLoss en nuevos datos;
- regularizamos los pesos de las nuevas características (no tocamos las viejas);
- aprendemos también de los datos antiguos para conservar los patrones anteriores;
- y, quizás lo más importante: aplicamos Regularización Armónica, que garantiza que no haya grandes cambios en los pesos en relación con el antiguo modelo según la norma.
Dado que cada componente de la pérdida tiene coeficientes, podemos encontrar valores óptimos para nuestra tarea en la validación cruzada o según los requisitos del producto.
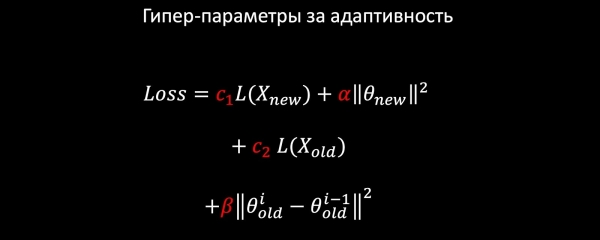
Árboles
Pasemos a los árboles de decisión. Hemos desarrollado el siguiente algoritmo de reentrenamiento para los árboles:
- En producción hay un bosque de 100 a 300 árboles, entrenado en el antiguo conjunto de datos.
- Al final, eliminamos M = 5 árboles y añadimos 2M = 10 nuevos, entrenados en todo el conjunto de datos, pero con un alto peso en los nuevos datos, lo que naturalmente garantiza un cambio incremental en el modelo.
Es evidente que con el tiempo la cantidad de árboles aumenta significativamente, y es necesario reducirlos periódicamente para ajustarse a los tiempos. Para esto, utilizamos el omnipresente ahora Conocimiento Distillation (KD). Brevemente sobre su principio de funcionamiento.
- Tenemos el actual modelo "complejo". Lo ejecutamos en el conjunto de datos de entrenamiento y obtenemos la distribución de probabilidades de clases como salida.
- Luego enseñamos al modelo alumno (modelo con menos árboles en este caso) a repetir los resultados del modelo, utilizando la distribución de clases como variable objetivo.
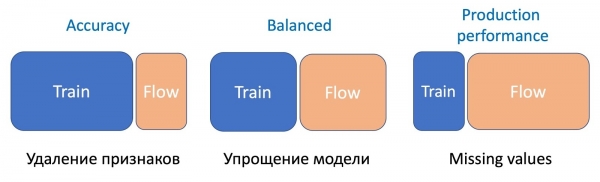
- Es importante señalar que no utilizamos ninguna estructura de conjunto de datos, por lo que podemos emplear datos arbitrarios. Por supuesto, utilizamos una muestra de datos del flujo en producción como conjunto de entrenamiento para el modelo estudiante. De esta manera, el conjunto de entrenamiento nos permite asegurar la precisión del modelo, mientras que la muestra del flujo garantiza un rendimiento similar en la distribución de producción, compensando el sesgo del conjunto de entrenamiento.
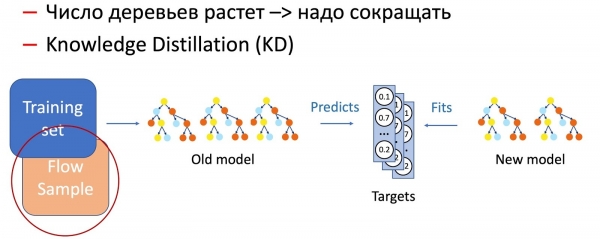
La combinación de estas dos técnicas (agregar árboles y reducir periódicamente su cantidad mediante Knowledge Distillation) garantiza la introducción de nuevos patrones y una continuidad completa.
Con KD también realizamos operaciones de diferenciación de características del modelo, como la eliminación de características y el trabajo con ausencias. En nuestro caso, tenemos una serie de características estadísticas importantes (por remitentes, hashes de texto, URLs, etc.) que se almacenan en una base de datos que tiene la propiedad de fallar. Ante tal eventualidad, el modelo, por supuesto, no está preparado, ya que en el conjunto de entrenamiento no hay situaciones de fallo. En tales casos, combinamos técnicas de KD y aumento: durante el entrenamiento de parte de los datos, eliminamos o nulificamos las características necesarias, mientras que las etiquetas (salidas del modelo actual) se toman originales; el modelo estudiante aprende a repetir esta distribución.
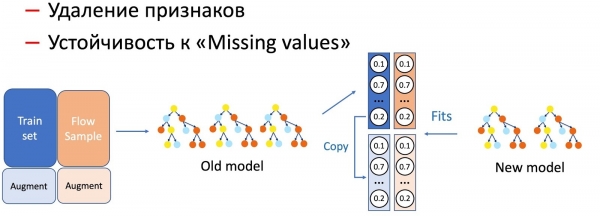
Hemos notado que cuanto más severa es la manipulación de los modelos, mayor es el porcentaje de muestra del flujo que se requiere.
Para la eliminación de características, la operación más simple, solo se necesita una pequeña parte del flujo, ya que solo se cambian un par de características, y el modelo actual se ha entrenado en el mismo conjunto: la diferencia es mínima. Para simplificar el modelo (reducir la cantidad de árboles varias veces) se requiere ya un 50/50. Y para las ausencias de características estadísticas importantes, que afectan seriamente el rendimiento del modelo, se necesita aún más flujo para igualar el funcionamiento del nuevo modelo resistente a las ausencias en todos los tipos de correos.
FastText
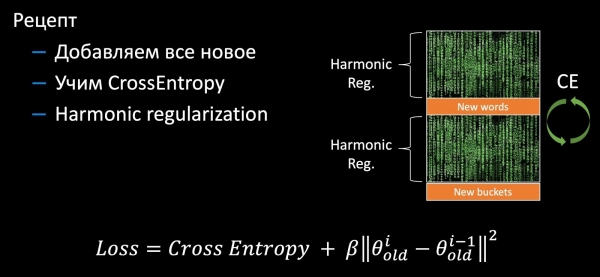
Pasemos a FastText. Recuerdo que la representación (Embedding) de una palabra consiste en la suma del embedding de la propia palabra y todos sus N-gramas de letras, generalmente trigramas. Dado que puede haber bastantes trigramas, se utiliza Bucket Hashing, es decir, la transformación de todo el espacio en un cierto hash map fijo. Como resultado, la matriz de pesos tiene dimensiones de la capa interna multiplicadas por la cantidad de palabras más los buckets.
Durante el fine-tuning surgen nuevas características: palabras y trigramas. En el fine-tuning estándar de Facebook no ocurre nada significativo. Solo se ajustan los antiguos pesos con la entropía cruzada en nuevos datos. Así, las nuevas características no se utilizan, por supuesto, este enfoque presenta todas las desventajas mencionadas anteriormente relacionadas con la imprevisibilidad del modelo en producción. Por lo tanto, hemos mejorado un poco FastText. Añadimos todos los nuevos pesos (palabras y trigramas), ajustamos toda la matriz con la entropía cruzada y añadimos regularización armónica por analogía con el modelo lineal, que garantiza un cambio insignificante en los pesos antiguos.
CNN
Con las redes convolucionales es algo más complicado. Si en la CNN se ajustan las últimas capas, entonces, por supuesto, se puede aplicar regularización armónica y garantizar la continuidad. Pero en el caso de que se requiera ajustar toda la red, esa regularización ya no se puede aplicar a todas las capas. Sin embargo, hay una opción de entrenamiento de embeddings complementarios a través de Triplet Loss ().
Triplet Loss
A través del ejemplo de la tarea de antifraude, analizaremos en términos generales el Triplet Loss. Tomamos nuestro logotipo, así como ejemplos positivos y negativos de logotipos de otras compañías. Minimizar la distancia entre los primeros y maximizar la distancia entre los segundos, hacemos esto con una pequeña holgura para garantizar una mayor compactación de las clases.
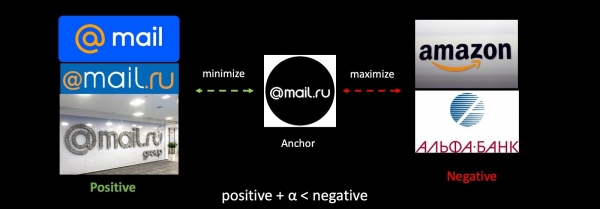
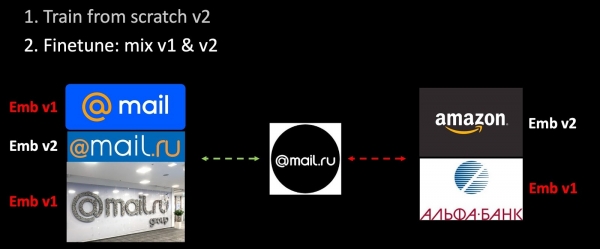
Si ajustamos la red, cambiamos completamente el espacio métrico, y se vuelve absolutamente incompatible con el anterior. Este es un problema grave en las tareas que utilizan vectores. Para sortear este problema, mezclaremos durante el entrenamiento los antiguos embeddings.
Hemos añadido nuevos datos al conjunto de entrenamiento y estamos formando desde cero la segunda versión del modelo. En la segunda etapa, afinamos nuestra red (Finetuning): primero se ajusta la última capa y luego se descongelan todas las capas. En el proceso de creación de tripletas, solo una parte de las incrustaciones se calcula utilizando el modelo entrenado, las demás se obtienen a través del antiguo. De esta forma, durante el proceso de afinación, garantizamos la compatibilidad de los espacios métricos v1 y v2. Una especie de variante de regularización armónica.
Arquitectura completa
Si consideramos todo el sistema en su conjunto a través del ejemplo del antispam, los modelos no están aislados, sino que están anidados unos dentro de otros. Tomamos imágenes, textos y otros rasgos, y con la ayuda de CNN y Fast Text obtenemos incrustaciones. Luego, sobre las incrustaciones se aplican clasificadores que generan puntuaciones para diversas clases (tipos de correos, spam, presencia de logotipos). Las puntuaciones y rasgos ya se envían a un bosque de árboles para tomar la decisión final. Clasificadores individuales en este esquema permiten interpretar mejor los resultados del funcionamiento del sistema y afinar componentes de manera más precisa en caso de surgir problemas, en lugar de presentar todos los datos sin procesar a los árboles de decisiones.
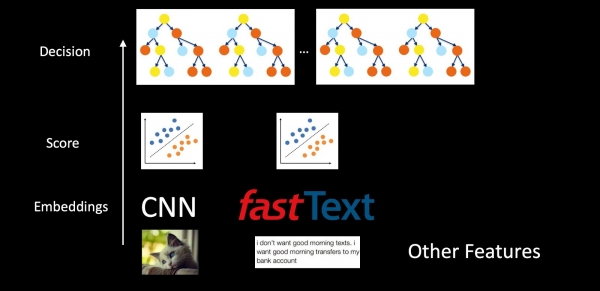
En definitiva, garantizamos la continuidad en cada nivel. En el nivel inferior, en CNN y Fast Text, utilizamos regularización armónica, y para los clasificadores en medio, también regularización armónica y calibración de la puntuación para compatibilidad en la distribución de probabilidades. El boosting de árboles se entrena de manera incremental o mediante Knowledge Distillation.
En general, el soporte para tal sistema de aprendizaje automático anidado suele ser complicado, ya que cualquier componente en el nivel inferior lleva a la actualización de todo el sistema superior. Pero dado que en nuestra configuración cada componente cambia ligeramente y es compatible con el anterior, todo el sistema puede actualizarse en partes sin la necesidad de reentrenar toda la estructura, lo que permite mantenerlo sin un alto coste adicional.
Despliegue
Hemos revisado la recopilación de datos y el afinamiento de diferentes tipos de modelos, por lo que pasamos a su despliegue en el entorno de producción.
Pruebas A/B
Como mencioné anteriormente, durante el proceso de recopilación de datos, por lo general, obtenemos una muestra sesgada, lo que hace imposible evaluar el rendimiento de producción del modelo. Por lo tanto, al implementar el modelo, es imprescindible compararlo con la versión anterior para entender cómo están realmente las cosas, es decir, realizar pruebas A/B. De hecho, el proceso de implementación y el análisis de gráficos es bastante rutinario y se presta perfectamente a la automatización. Implementamos nuestros modelos gradualmente en un 5 %, 30 %, 50 % y 100 % de los usuarios, recopilando todas las métricas disponibles sobre las respuestas del modelo y los comentarios de los usuarios. En caso de cualquier anomalía grave, revertimos automáticamente el modelo, y en otros casos, al acumular una cantidad suficiente de clics de los usuarios, tomamos la decisión de aumentar el porcentaje. Al final, llevamos el nuevo modelo al 50 % de los usuarios completamente de forma automática, y la implementación a toda la audiencia es aprobada por una persona, aunque este paso también se puede automatizar.
Sin embargo, el proceso de pruebas A/B representa un amplio espacio para la optimización. La cuestión es que cualquier prueba A/B es bastante prolongada (en nuestro caso, dura de 6 a 24 horas dependiendo de la cantidad de comentarios), lo que la hace bastante costosa y con recursos limitados. Además, se requiere un porcentaje suficientemente alto de flujo para la prueba, con el fin de acelerar el tiempo total de la prueba A/B (recoger una muestra estadísticamente significativa para evaluar métricas con un bajo porcentaje puede llevar mucho tiempo), lo que hace que la cantidad de ranuras A/B sea extremadamente limitada. Es obvio que necesitamos incluir en la prueba solo los modelos más prometedores, los cuales, durante el proceso de ajuste, obtenemos en gran cantidad.
Para abordar esta tarea, entrenamos un clasificador separado que predice el éxito de la prueba A/B. Para ello, utilizamos como características las estadísticas de la toma de decisiones, Precision, Recall y otras métricas en el conjunto de entrenamiento, en el conjunto de validación y en una muestra del flujo. Además, comparamos el modelo con el actual en producción, con heurísticas, y consideramos la complejidad del modelo. Utilizando todas estas características, el clasificador, entrenado con el historial de pruebas, evalúa los modelos candidatos, en nuestro caso, árboles de decisión, y toma la decisión de cuál de ellos enviar a la prueba A/B.
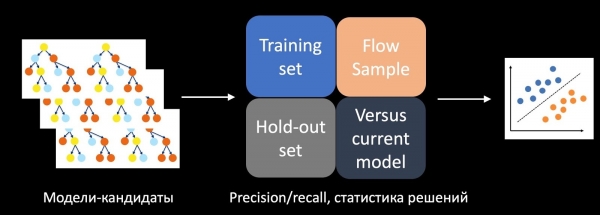
En el momento de la implementación, este enfoque permitió aumentar varias veces la cantidad de pruebas A/B exitosas.
Pruebas y monitoreo
Las pruebas y el monitoreo, sorprendentemente, no perjudican nuestra salud; más bien, lo contrario, mejoran y eliminan el estrés innecesario. Las pruebas permiten prevenir fallos, mientras que el monitoreo ayuda a detectarlos a tiempo para reducir su impacto en los usuarios.
Aquí es importante entender que tarde o temprano su sistema siempre cometerá errores; esto se debe al ciclo de desarrollo de cualquier software. Al inicio del desarrollo, hay muchos errores hasta que todo se estabiliza y se completa la fase principal de innovaciones. Pero con el tiempo, la entropía se impone, y vuelven a aparecer errores, debido a la degradación de los componentes y el cambio de datos, como mencioné al principio.
Aquí me gustaría señalar que cualquier sistema de aprendizaje automático debe ser evaluado en términos de su rentabilidad a lo largo de todo su ciclo de vida. A continuación, se muestra un ejemplo de la operación de un sistema para detectar un tipo raro de spam (en el gráfico, la línea está cerca de cero). Una vez, debido a un atributo mal almacenado en caché, el sistema se volvió loco. Lamentablemente, no había monitoreo para activaciones anómalas, como resultado, el sistema comenzó a guardar correos en la carpeta 'spam' cerca de la frontera de la decisión en grandes cantidades. A pesar de corregir las consecuencias, el sistema ya había fallado tantas veces que no recuperará su costo en cinco años. Esto es un completo fracaso desde la perspectiva del ciclo de vida del modelo.
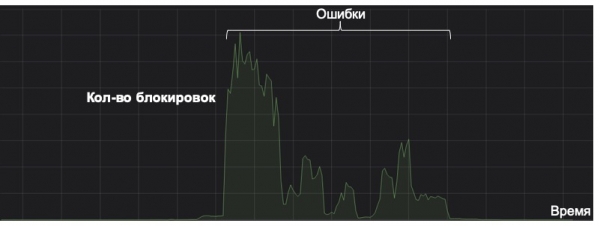
Por lo tanto, algo tan simple como el monitoreo puede ser clave en la vida del modelo. Además de las métricas estándar y evidentes, consideramos la distribución de respuestas y puntajes del modelo, así como la distribución de valores de características clave. Usando la divergencia KL, podemos comparar la distribución actual con la histórica o los valores en la prueba A/B con el resto del flujo, lo que permite detectar anomalías en el modelo y revertir los cambios a tiempo.
En la mayoría de los casos, lanzamos nuestras primeras versiones de sistemas utilizando heurísticas simples o modelos que posteriormente utilizamos para monitoreo. Por ejemplo, monitorizamos un modelo NER en comparación con expresiones regulares para tiendas en línea específicas, y si la cobertura del clasificador disminuye en comparación con ellas, investigamos las razones. ¡Otra aplicación útil de las heurísticas!
Resultados
Revisemos nuevamente los puntos clave del artículo.
- Fibdéc. Siempre pensamos en el usuario: cómo vivirá con nuestros errores, cómo podrá informarlos. No olvidemos que los usuarios no son una fuente de retroalimentación pura para el entrenamiento de modelos, y es necesario filtrar esta información con la ayuda de sistemas de ML auxiliares. Si no hay manera de recopilar señales del usuario, buscamos fuentes alternativas de retroalimentación, como sistemas relacionados.
- Reentrenamiento. Aquí lo principal es la continuidad, por lo que nos basamos en el modelo actual en producción. Entrenamos nuevos modelos de manera que no se desvíen demasiado del anterior mediante regularización armónica y trucos similares.
- Despliegue. El autodespliegue basado en métricas reduce significativamente el tiempo de implementación de modelos. El monitoreo de estadísticas y la distribución de decisiones, así como el número de falsos positivos de los usuarios, es fundamental para su tranquilidad y fines de semana productivos.
Bueno, espero que lo que has leído te ayude a mejorar más rápidamente tus sistemas de ML, acelerar su salida al mercado y hacerlos más confiables, reduciendo la cantidad de estrés en el trabajo.
Fuente: habr.com
