

En Hablamos sobre la predicción de series temporales. Una continuación lógica sería un artículo sobre la detección de anomalías.
Aplicación
La detección de anomalías se utiliza en áreas como:
1) Predicción de fallos de equipos
Así, en 2010, las centrífugas iraníes fueron atacadas por el virus Stuxnet, que estableció un modo de operación no óptimo y dañó parte del equipo debido al desgaste acelerado.
Si se hubieran utilizado algoritmos de detección de anomalías en el equipo, se podrían haber evitado situaciones de fallo.
La detección de anomalías en el funcionamiento del equipo se utiliza no solo en la industria nuclear, sino también en la metalurgia y en el funcionamiento de turbinas aéreas. Y en otras áreas donde el uso de diagnóstico predictivo es más económico que las posibles pérdidas debido a un fallo impredecible.
2) Predicción de actividades fraudulentas
Si desde la tarjeta que usas en Podolsk se retiran fondos en Albania, tal vez las transacciones deban ser revisadas con más cuidado.
3) Detección de patrones de consumo anómalos
Si un grupo de clientes presenta un comportamiento anómalo, puede haber un problema del que no estás consciente.
4) Detección de demanda y carga anormales
Si las ventas en una tienda de FMCG caen por debajo del intervalo de confianza de la predicción, vale la pena averiguar la razón de lo que está ocurriendo.
Enfoques para la detección de anomalías
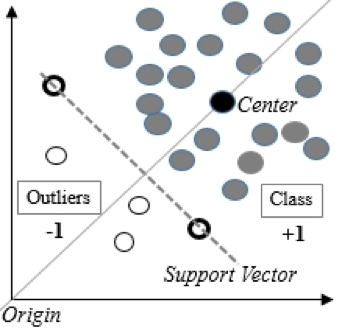
1) Método de soporte vectorial de una clase One-Class SVM
Es adecuado cuando los datos en el conjunto de entrenamiento se distribuyen normalmente, y en el de prueba contienen anomalías.
El método de soporte vectorial de una clase construye una superficie no lineal alrededor del origen. Se puede establecer un límite para determinar qué datos considerar anómalos.
Según la experiencia de nuestro equipo de DATA4, One-Class SVM es el algoritmo más utilizado para resolver el problema de detección de anomalías.
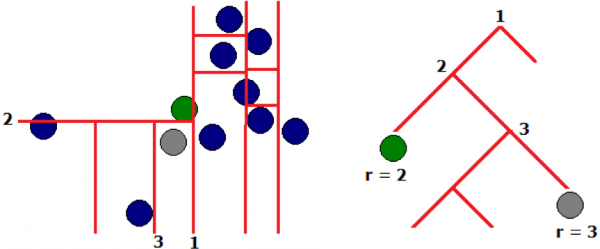
2) Método de bosque aislante – isolate forest
Con el método 'aleatorio' de construcción de árboles, las anomalías entran en las hojas en las primeras etapas (a poca profundidad del árbol), es decir, las anomalías son más fáciles de 'aislar'. La identificación de valores anómalos ocurre en las primeras iteraciones del algoritmo.
3) Sobre envolturas elípticas y métodos estadísticos
Se utiliza cuando los datos están distribuidos normalmente. Cuanto más cerca esté la medición de la cola de la mezcla de distribuciones, más anómalo será el valor.
A esta clase también se pueden clasificar otros métodos estadísticos.
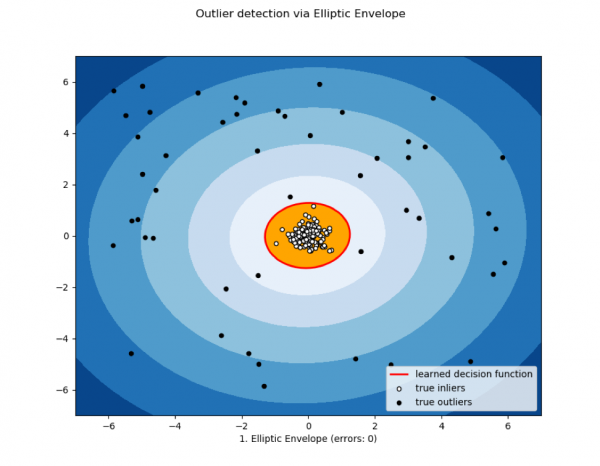
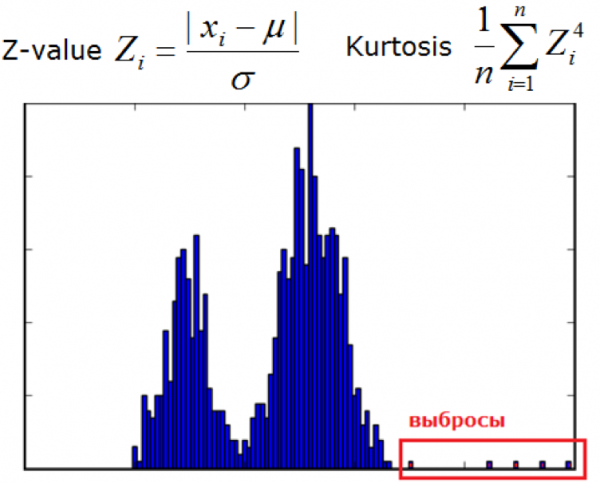
Imagen del sitio dyakonov.org
4) Métodos métricos
Los métodos incluyen algoritmos como k vecinos más cercanos, k-ésimo vecino más cercano, ABOD (detección de outliers basada en ángulo) o LOF (factor de outlier local).
Son adecuados si la distancia entre los valores en las características es equivalente o está normalizada (para no medir una serpiente en loros).
El algoritmo k vecinos más cercanos supone que los valores normales se encuentran en una determinada área del espacio multidimensional, y que la distancia a las anomalías será mayor que a la hipersuperficie de separación.
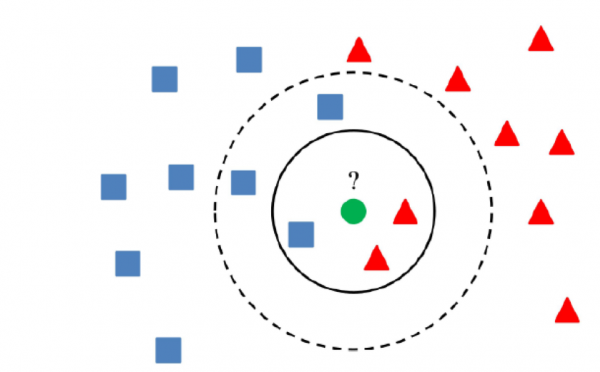
5) Métodos de clustering
La esencia de los métodos de clustering es que si un valor se aleja de los centros de los clusters más allá de un cierto umbral, se puede considerar anómalo.
Lo principal es utilizar un algoritmo que clusterice correctamente los datos, lo que depende de la tarea específica.
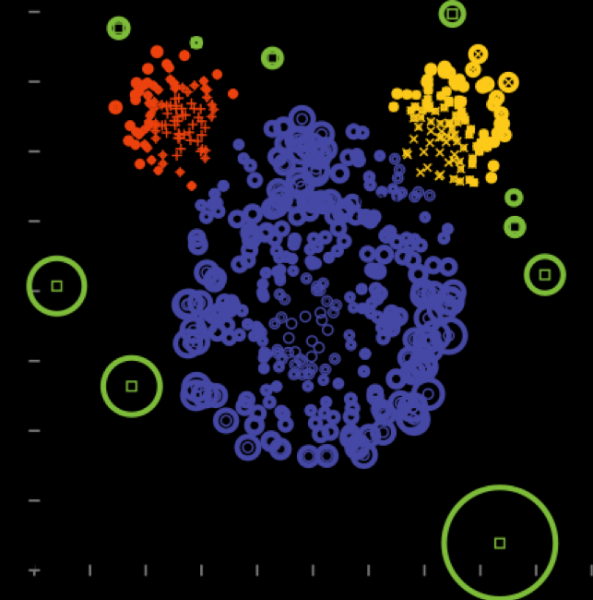
6) Método de componentes principales
Es adecuado donde se destacan las direcciones de mayor variación en la dispersión.
7) Algoritmos basados en la predicción de series temporales
La idea es que si un valor se encuentra fuera del intervalo de confianza de la predicción, se considera anómalo. Para la predicción de series temporales se utilizan algoritmos como suavizado triple, S(ARIMA), boosting, etc.
Se habló de algoritmos de predicción de series temporales en el artículo anterior.
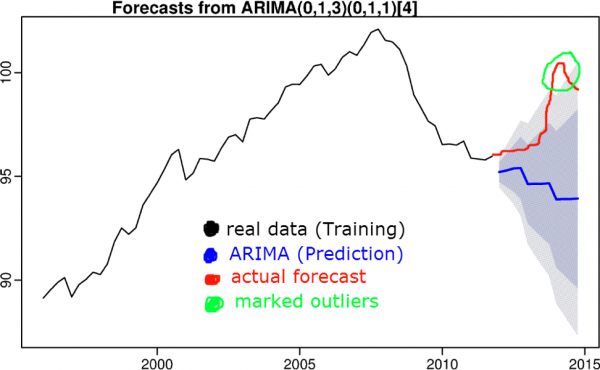
8) Aprendizaje supervisado (regresión, clasificación)
Si los datos lo permiten, utilizamos algoritmos que van desde la regresión lineal hasta las redes neuronales recurrentes. Mediremos la diferencia entre la predicción y el valor real, y concluiremos en qué medida los datos se desvían de la norma. Es importante que el algoritmo tenga una capacidad de generalización suficiente y que el conjunto de entrenamiento no contenga valores anómalos.
9) Pruebas de modelo
Abordaremos el problema de la detección de anomalías como un problema de recomendación. Descompondremos nuestra matriz de características utilizando SVD o máquinas de factorización, y aquellos valores en la nueva matriz que se desvíen significativamente de los originales se considerarán anómalos.
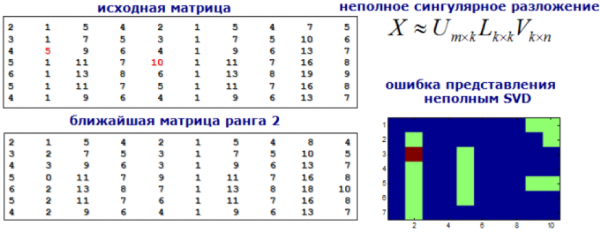
Imagen del sitio dyakonov.org
Conclusión
En este artículo hemos revisado los enfoques principales para la detección de anomalías.
La búsqueda de anomalías se puede considerar en gran medida un arte. No existe un algoritmo o enfoque perfecto que resuelva todos los problemas. Se suele utilizar una combinación de métodos para abordar un caso específico. La búsqueda de anomalías se realiza mediante el método de soporte vectorial de una sola clase, bosques aislantes, métodos métricos y de agrupamiento, así como utilizando componentes principales y pronósticos de series temporales.
Si conoces otros métodos, compártelos en los comentarios del artículo.
Fuente: habr.com
