

El desarrollo industrial de sistemas de software requiere una gran atención a la resiliencia del producto final, así como una rápida reacción ante fallos y errores, si es que ocurren. La monitorización, por supuesto, ayuda a reaccionar a fallos y errores de manera más eficiente y rápida, pero no es suficiente. En primer lugar, es muy difícil rastrear un gran número de servidores; se necesita un gran equipo de personas. En segundo lugar, es fundamental comprender bien cómo funciona la aplicación para prever su estado. Por lo tanto, se necesitan muchas personas que entiendan bien los sistemas que desarrollamos, así como sus métricas y características. Supongamos que, incluso si logramos encontrar un número suficiente de personas dispuestas a hacer esto, se requerirá mucho tiempo para capacitarlas.
¿Qué hacer entonces? Aquí es donde nos ayuda la inteligencia artificial. Este artículo hablará sobre (predictive maintenance). Este enfoque está ganando popularidad rápidamente. Se han escrito muchos artículos al respecto, incluso en Habr. Las grandes empresas utilizan plenamente este enfoque para mantener la operatividad de sus servidores. Después de estudiar una gran cantidad de artículos, decidimos probar este enfoque. ¿Qué resultó de ello?
Introducción
Un sistema de software, tarde o temprano, entra en operación. Es importante para el usuario que el sistema funcione sin fallos. Si se llega a producir una situación extraordinaria, debe resolverse con el mínimo de retrasos.
Para simplificar el soporte técnico de un sistema de software, especialmente si hay muchos servidores, normalmente se utilizan programas de monitorización que capturan métricas del sistema operativo, permiten diagnosticar su estado y ayudan a determinar qué causó el fallo. Este proceso se conoce como monitorización del sistema de software.
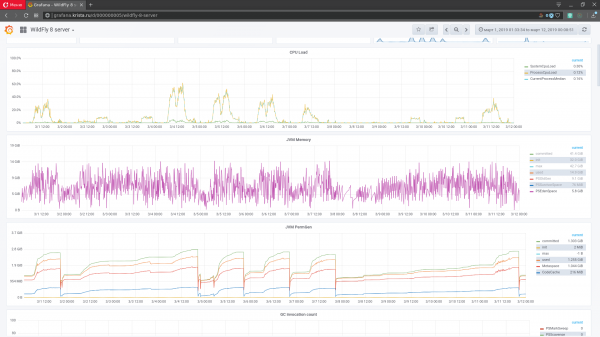
Figura 1. Interfaz de monitorización grafana
Las métricas son diversos indicadores de un sistema de software, el entorno de su ejecución o la máquina de computación física en la que se ejecuta el sistema, marcando el momento en que se obtuvieron las métricas. En el análisis estático, los datos de las métricas se conocen como series temporales. Para observar el estado del sistema de software, las métricas se representan en forma de gráficos: en el eje X se encuentra el tiempo y en el eje Y los valores (Figura 1). Se pueden capturar varios miles de métricas de un sistema de software en funcionamiento (de cada nodo). Estas forman un espacio de métricas (series temporales multidimensionales).
Dado que en sistemas de software complejos se capturan una gran cantidad de métricas, el monitoreo manual se convierte en una tarea compleja. Para reducir el volumen de datos analizados por el administrador, las herramientas de monitoreo incluyen instrumentos para detectar automáticamente problemas potenciales. Por ejemplo, se puede configurar un disparador que se active en caso de que el espacio libre en disco caiga por debajo de un umbral especificado. También se puede diagnosticar automáticamente la detención del servidor o una desaceleración crítica en la velocidad de servicio. En la práctica, las herramientas de monitoreo son bastante efectivas en detectar fallos ya ocurridos o en identificar síntomas simples de fallos futuros, pero en general, prever un posible colapso sigue siendo un problema complicado para ellas. La predicción a través del análisis manual de métricas requiere la participación de especialistas calificados. Es poco productivo. La mayoría de los posibles fallos pueden pasar desapercibidos.
Recientemente, entre las grandes empresas de TI dedicadas al desarrollo de software, ha ganado popularidad el llamado mantenimiento predictivo de sistemas de software. La esencia de este enfoque radica en identificar fallas que llevan a la degradación del sistema en etapas tempranas, antes de su colapso, utilizando inteligencia artificial. Este enfoque no excluye por completo el monitoreo manual del sistema. Es complementario al proceso de monitoreo en general.
La herramienta principal para implementar el mantenimiento predictivo es la tarea de búsqueda de anomalías en las series temporales, ya que al ocurrir una anomalía en los datos, es probable que después de un tiempo ocurrirá un error o fallo. Una anomalía es un desvío en las métricas de un sistema programático, como la detección de la degradación de la velocidad de ejecución de un tipo de solicitud o la disminución del número medio de solicitudes atendidas con un nivel constante de sesiones de clientes.
La tarea de buscar anomalías en sistemas programáticos tiene su propia especificidad. En teoría, para cada sistema programático es necesaria la elaboración o mejora de los métodos existentes, ya que la búsqueda de anomalías depende en gran medida de los datos en los que se lleva a cabo, y los datos de los sistemas programáticos varían considerablemente según las herramientas de implementación del sistema, hasta el tipo de máquina computacional en la que se ejecute.
Métodos de búsqueda de anomalías en la predicción de fallos de sistemas programáticos
Primero que nada, es importante mencionar que la idea de predecir fallos fue inspirada por un artículo . Para comprobar la efectividad del enfoque de búsqueda automática de anomalías, se eligió el sistema programático «Web-Consolidación», que es uno de los proyectos de la empresa NPO «Krista». Anteriormente, se realizaba una supervisión manual basada en las métricas obtenidas. Dado que el sistema es bastante complejo, se recopilan muchas métricas: indicadores de JVM (carga del recolector de basura), indicadores del sistema operativo en el que se ejecuta el código (memoria virtual, % de carga de la CPU del SO), indicadores de red (carga de red), del propio servidor (carga de la CPU, memoria), métricas de wildfly y métricas específicas de la aplicación en todos los subsistemas críticos.
Todas las métricas se recopilan del sistema utilizando graphite. Inicialmente, se utilizó la base whisper como solución estándar para grafana, pero con el crecimiento de la base de clientes, graphite dejó de ser eficaz, agoteando la capacidad de la subsistema de disco del centro de datos. Después de eso, se tomó la decisión de buscar una solución más efectiva. Se eligió , lo que permitió reducir significativamente la carga en el subsistema de discos y disminuir entre cinco y seis veces el volumen de disco ocupado. A continuación se presenta un esquema del mecanismo de recopilación de métricas utilizando graphite+clickhouse (figura 2).
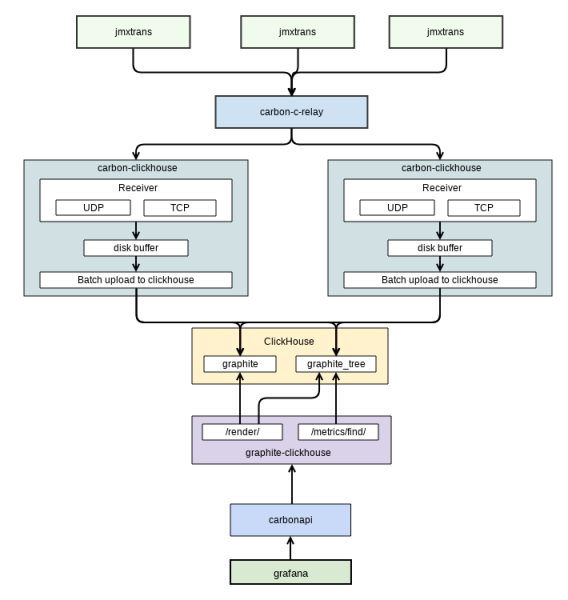
Figura 2. Esquema de recopilación de métricas
El diagrama se obtuvo de la documentación interna. Muestra el intercambio de datos entre grafana (la interfaz de usuario para monitoreo que utilizamos) y graphite. La obtención de métricas de la aplicación es realizada por un software separado – . Este también las almacena en graphite.
El sistema 'Web-Consolidación' tiene una serie de características que crean problemas para la previsión de fallas:
- frecuentemente se produce un cambio de tendencia. Para este sistema de software se emiten diferentes versiones. Cada una de ellas conlleva cambios en la parte programática del sistema. En consecuencia, de esta manera, los desarrolladores influyen directamente en las métricas de este sistema y pueden provocar un cambio de tendencia;
- la particularidad de la implementación, así como los objetivos de uso por parte de los clientes de este sistema, a menudo provocan anomalías sin una degradación previa;
- el porcentaje de anomalías con respecto al conjunto de datos total es bajo (< 5%);
- pueden producirse interrupciones en la obtención de métricas del sistema. En algunos cortos intervalos de tiempo, el sistema de monitoreo no puede recibir métricas. Por ejemplo, si el servidor está sobrecargado. Para entrenar la red neuronal, esto es crítico. Surge la necesidad de llenar los vacío de manera sintética;
- Los casos con anomalías suelen ser relevantes solo para un número/mes/tiempo específico (estacionalidad). Este sistema tiene un reglamento claro sobre su uso por parte de los usuarios. En consecuencia, las métricas son relevantes solo para un tiempo específico. El sistema puede no utilizarse de forma continua, sino solo en ciertos meses: selectivamente dependiendo del año. Surgen situaciones en las que el mismo comportamiento de las métricas en un caso puede llevar a una falla del sistema de software, mientras que en otro no.
Para comenzar, se analizaron los métodos de detección de anomalías en los datos de monitoreo de sistemas de software. En los artículos sobre este tema, con bajos porcentajes de anomalías en relación con el resto del conjunto de datos, se suele recomendar el uso de redes neuronales.
La lógica principal para buscar anomalías utilizando datos de redes neuronales se ilustra en la figura 3:
Figura 3. Búsqueda de anomalías mediante una red neuronal
En el resultado de la predicción o recuperación de la ventana del flujo actual de métricas, se calcula la desviación de lo obtenido con el sistema de software en funcionamiento. Si hay una gran diferencia entre las métricas obtenidas del sistema de software y de la red neuronal, se puede concluir sobre la anomalía del segmento de datos actual. Surge una serie de problemas para el uso de redes neuronales:
- Para un funcionamiento correcto en modo de flujo, los datos para entrenar modelos de redes neuronales deben incluir únicamente datos "normales";
- es necesario tener un modelo actualizado para una detección precisa. El cambio de tendencia y estacionalidad en las métricas puede provocar un gran número de activaciones falsas del modelo. Para su actualización, es necesario determinar claramente cuándo el modelo es obsoleto. Si actualiza el modelo demasiado tarde o demasiado pronto, es probable que se produzcan muchas activaciones falsas.
También hay que tener en cuenta la búsqueda y prevención de la aparición frecuente de activaciones falsas. Se supone que aparecerán con mayor frecuencia en situaciones anómalas. Sin embargo, también pueden ser consecuencia de un error de la red neuronal debido a la insuficiencia de su entrenamiento. Es necesario minimizar la cantidad de activaciones falsas del modelo. De lo contrario, las falsas predicciones consumirán mucho tiempo del administrador, destinado a la verificación del sistema. Tarde o temprano, esto acabará con que el administrador simplemente dejará de reaccionar a un sistema de monitoreo "paranoico".
Red neuronal recurrente
Para la detección de anomalías en series temporales, se puede aplicar con memoria LSTM. El problema es que solo se puede aplicar a series temporales pronosticables. En nuestro caso, no todas las métricas son pronosticables. Se presenta un intento de aplicar RNN LSTM a la serie temporal en la figura 4.
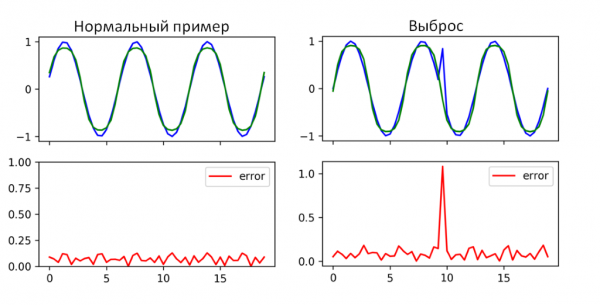
Figura 4. Ejemplo de funcionamiento de una red neuronal recurrente con celdas de memoria LSTM
Como se puede ver en la figura 4, RNN LSTM logró detectar la anomalía en este período de tiempo. Donde el resultado tiene un alto error de pronóstico (error medio), realmente ocurrió una anomalía en las métricas. Usar solo RNN LSTM claramente no será suficiente, ya que se aplica a un número limitado de métricas. Se puede utilizar como un método auxiliar para la detección de anomalías.
Auto-codificador para la predicción de fallos
– esencialmente una red neuronal artificial. La capa de entrada es el encoder, la capa de salida es el decoder. La desventaja de todas las redes neuronales de este tipo es que localizan deficiente las anomalías. Se eligió la arquitectura de un auto-codificador síncrono.
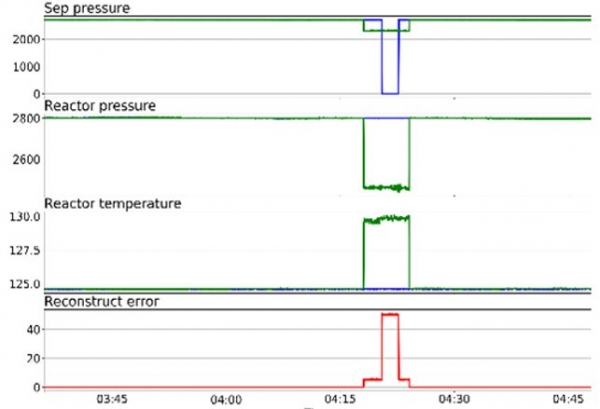
Figura 5. Ejemplo de funcionamiento del auto-codificador
Los auto-codificadores se entrenan con datos normales y luego encuentran algo anómalo en los datos que se ingresan al modelo. Justo lo que se necesita para esta tarea. Solo queda elegir cuál de los auto-codificadores es adecuado para esta tarea. La forma arquitectónica más simple de un auto-codificador es una red neuronal directa y no reversible, que se asemeja mucho a (multilayer perceptron, MLP), con una capa de entrada, una capa de salida y una o varias capas ocultas que las conectan.
Sin embargo, las diferencias entre los auto-codificadores y los MLP son que en el auto-codificador la capa de salida tiene el mismo número de nodos que la de entrada, y que en lugar de entrenarse para predecir un valor objetivo Y dado por una entrada X, el auto-codificador se entrena para reconstruir sus propios X. Por lo tanto, los auto-codificadores son modelos de aprendizaje no supervisados.
La tarea del auto-codificador radica en encontrar los índices temporales r0 … rn que corresponden a elementos anómalos en el vector de entrada X. Este efecto se logra mediante la búsqueda del error cuadrático.
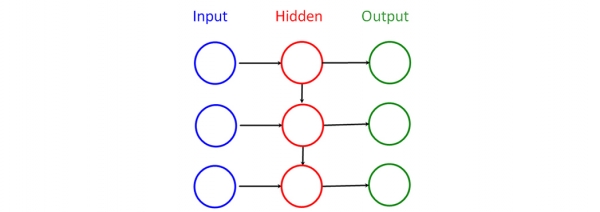
Figura 6. Auto-codificador síncrono
Se eligió . Sus ventajas: la posibilidad de utilizar modo de procesamiento en flujo y un número relativamente menor de parámetros de la red neuronal en comparación con otras arquitecturas.
Mecanismo para minimizar falsos positivos
Debido a que surgen diversas situaciones no estándar, así como la posibilidad de una capacitación insuficiente de la red neuronal, se ha tomado la decisión de desarrollar un mecanismo para minimizar las falsas alarmas en el modelo de detección de anomalías en desarrollo. Este mecanismo se basa en una base de patrones, que clasifica el administrador.
(El algoritmo DTW, por sus siglas en inglés dynamic time warping) permite encontrar la correspondencia óptima entre secuencias temporales. Se aplicó por primera vez en el reconocimiento de voz: se utilizó para determinar cómo dos señales de voz representan la misma frase pronunciada. Posteriormente, se encontró aplicación en otras áreas.
El principio básico de minimización de falsas alarmas es la recopilación de una base de estándares mediante un operador que clasifica los casos sospechosos detectados por redes neuronales. Luego, se compara el estándar clasificado con el caso que ha detectado el sistema, y se llega a una conclusión sobre si el caso es una falsa alarma o un verdadero fallo. El algoritmo DTW se utiliza precisamente para comparar dos series temporales. Sin embargo, la clasificación sigue siendo la herramienta principal de minimización. Se supone que, después de recopilar un gran número de casos estándar, el sistema comenzará a preguntar menos al operador debido a la similitud de la mayoría de los casos y la aparición de casos similares.
Como resultado de los métodos descritos anteriormente, se construyó un programa experimental para la predicción de fallos del sistema "Web-Consolidación". El objetivo de este programa era, utilizando el archivo existente de datos de monitoreo y la información sobre fallos que ya han ocurrido, evaluar la eficacia de este enfoque para nuestros sistemas de software. El esquema de funcionamiento del programa se presenta a continuación, en la figura 7.
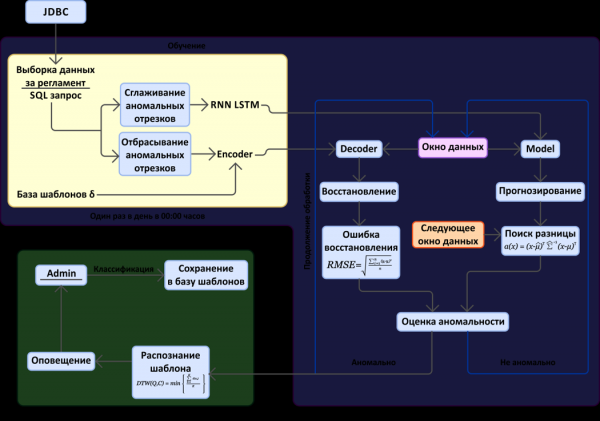
Figura 7. Esquema de predicción de fallos basado en el análisis del espacio de métricas
En el esquema se pueden identificar dos bloques principales: la búsqueda de segmentos anómalos en el flujo de datos de monitoreo (métricas) y el mecanismo de minimización de falsas alarmas. Nota: con fines experimentales, los datos se obtienen a través de una conexión JDBC de la base de datos, en la que se almacenan con graphite.
A continuación se presenta la interfaz del sistema de monitoreo desarrollado (figura 8).
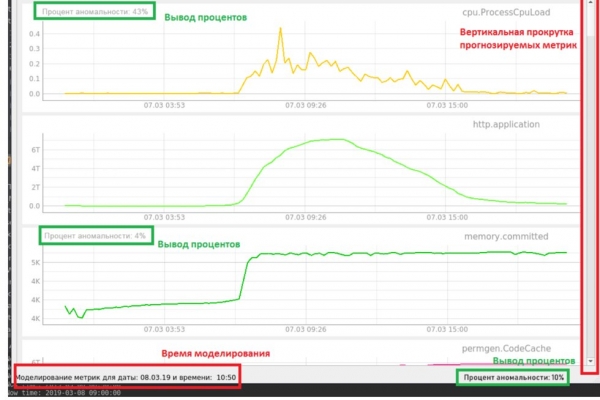
Figura 8. Interfaz del sistema de monitoreo experimental
En la interfaz se muestra el porcentaje de anormalidad basado en las métricas obtenidas. En nuestro caso, la obtención está siendo simulada. Ya tenemos todos los datos de varias semanas y los estamos cargando gradualmente para verificar el caso de anormalidad que conduce a la falla. En la barra de estado inferior se muestra el porcentaje total de anormalidad de los datos en este momento, que se determina mediante un auto-codificador. Además, para las métricas pronosticadas se muestra un porcentaje separado, calculado por una RNN LSTM.
Ejemplo de detección de anormalidad en los indicadores de CPU mediante una red neuronal RNN LSTM (figura 9).
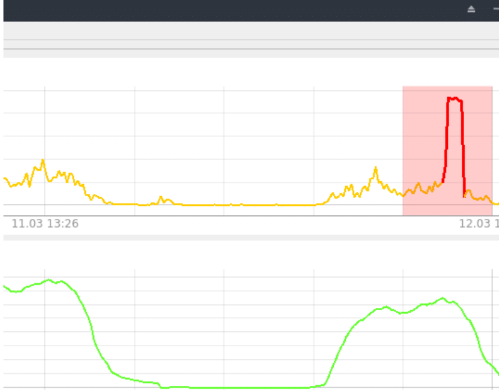
Figura 9. Detección RNN LSTM
Un caso bastante simple, en esencia un desecho normal, pero que conduce a la falla del sistema, fue detectado con éxito por la RNN LSTM. El indicador de anormalidad en este período es del 85 al 95 %, todo lo que esté por encima del 80 % (umbral definido experimentalmente) se considera una anormalidad.
Ejemplo de detección de anormalidad cuando el sistema no pudo iniciarse después de la actualización. Esta situación es detectada por el auto-codificador (figura 10).
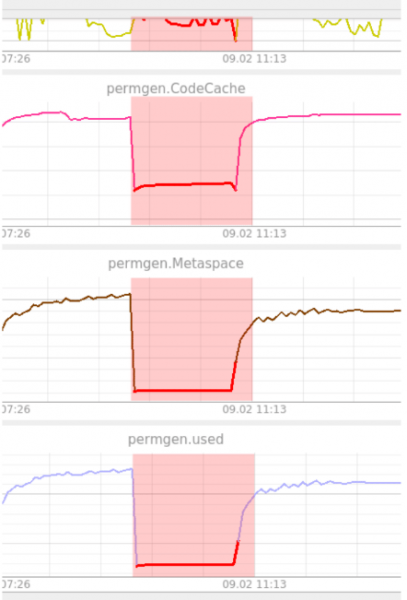
Figura 10. Ejemplo de detección por el auto-codificador
Como se puede ver en la figura, PermGen se quedó en un solo nivel. El auto-codificador consideró esto extraño, ya que no había visto nada parecido anteriormente. Aquí, la anormalidad se mantiene al 100 % hasta que el sistema vuelve a un estado operativo. La anormalidad se refleja en todas las métricas. Como se mencionó anteriormente, el auto-codificador no puede localizar anomalías. Se espera que el operador realice esta función en estas situaciones.
Conclusión
El PC "Web-Consolidación" se ha estado desarrollando durante varios años. El sistema se encuentra en un estado bastante estable y el número de incidentes registrados es bajo. Sin embargo, se han logrado identificar anomalías que llevan a fallas de 5 a 10 minutos antes de que ocurra la falla. En algunos casos, la alerta de falla de manera anticipada podría haber ayudado a ahorrar el tiempo programado destinado a la realización de trabajos de "reparación".
En los experimentos que se han podido realizar, aún es pronto para llegar a conclusiones definitivas. En este momento, los resultados son contradictorios. Por un lado, se puede ver que los algoritmos basados en redes neuronales son capaces de encontrar anomalías 'útiles'. Por otro lado, sigue existiendo un gran porcentaje de falsos positivos, y no todas las anomalías que un especialista calificado identifica pueden ser detectadas por la red neuronal. Entre las desventajas se puede mencionar que, en este momento, la red neuronal requiere aprendizaje supervisado para funcionar adecuadamente.
Para el desarrollo futuro del sistema de predicción de fallos y para llevarlo a un estado satisfactorio, se pueden prever varias vías. Un análisis más detallado de los casos con anomalías que conducen a fallos, complementando así la lista de métricas importantes que afectan significativamente el estado del sistema y eliminando las que no tienen impacto en él. Además, si seguimos esta dirección, se pueden hacer intentos de especializar los algoritmos específicamente para nuestros casos de anomalías que conducen a fallos. También hay otro camino: la mejora de las arquitecturas de las redes neuronales y, gracias a ello, el aumento de la precisión de las detecciones con una reducción del tiempo de aprendizaje.
Quiero expresar mi agradecimiento a los colegas que me ayudaron con la redacción y el mantenimiento de la actualidad de este artículo: y Sergey Finogenov.
Fuente: habr.com
