

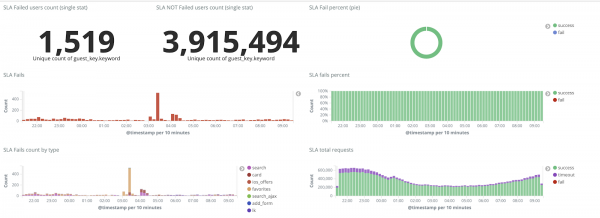
Hola a todos, me llamo Alexander, trabajo en CIAN como ingeniero y me encargo de la administración de sistemas y la automatización de procesos de infraestructura. En los comentarios de uno de los artículos anteriores, nos pidieron que explicáramos de dónde obtenemos 4 TB de registros al día y qué hacemos con ellos. Sí, tenemos muchos registros, y para su procesamiento hemos creado un clúster de infraestructura separado que nos permite resolver problemas de manera eficiente. En este artículo, contaré cómo hemos adaptado este sistema en un año para trabajar con un flujo de datos en constante crecimiento.
Por dónde empezamos
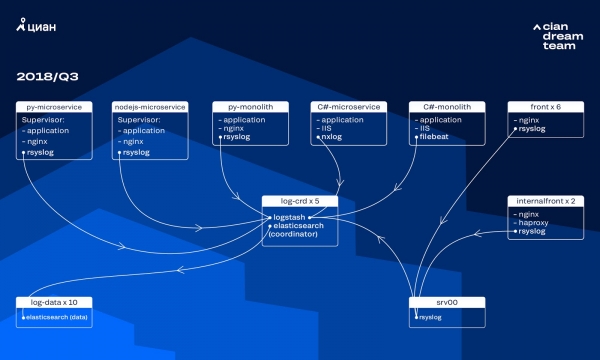
En los últimos años, la carga en cian.ru ha crecido muy rápidamente, y para el tercer trimestre de 2018, la asistencia al sitio alcanzó los 11.2 millones de usuarios únicos al mes. En esos momentos críticos, perdíamos hasta el 40% de los registros, lo que nos impedía abordar incidentes de forma rápida y dedicábamos mucho tiempo y esfuerzo a resolverlos. A menudo, no podíamos encontrar la causa del problema, y este se repetía después de un tiempo. Era un verdadero caos, y había que hacer algo al respecto.
En ese momento, utilizábamos un clúster de 10 nodos de datos con ElasticSearch versión 5.5.2 y configuraciones estándar para el almacenamiento de registros. Se implementó hace más de un año como una solución popular y accesible: entonces, el flujo de registros no era tan grande, y no tenía sentido idear configuraciones no estándar.
El procesamiento de los registros entrantes se realizaba mediante Logstash en diferentes puertos en cinco coordinadores de ElasticSearch. Un índice, independientemente de su tamaño, consistía en cinco fragmentos. Se organizó una rotación horaria y diaria, lo que resultaba en aproximadamente 100 nuevos fragmentos en el clúster cada hora. Mientras había pocos registros, el clúster funcionaba adecuadamente y nadie prestaba atención a su configuración.
Problemas de rápido crecimiento
El volumen de registros generados crecía muy rápido, ya que se superpusieron dos procesos. Por un lado, la cantidad de usuarios del servicio aumentaba. Por otro lado, comenzamos a adoptar activamente una arquitectura de microservicios, descomponiendo nuestros antiguos monolitos en C# y Python. Varios docenas de nuevos microservicios, que reemplazaban partes del monolito, generaban significativamente más registros para el clúster de infraestructura.
La escalabilidad fue precisamente lo que llevó a que el clúster se volviera prácticamente incontrolable. Cuando los registros comenzaron a llegar a una velocidad de 20,000 mensajes por segundo, la rotación frecuente e innecesaria incrementó el número de shards a 6,000, y cada nodo manejaba más de 600 shards.
Esto ocasionó problemas con la asignación de memoria, y al caer un nodo comenzaba la migración simultánea de todos los shards, multiplicando el tráfico y sobrecargando los demás nodos, lo que hacía prácticamente imposible la escritura de datos en el clúster. Durante este periodo, estuvimos sin registros. Y ante el problema con el servidor perdíamos 1/10 del clúster en principio. La gran cantidad de índices pequeños complicaba aún más la situación.
Sin registros no entendíamos las causas del incidente y, tarde o temprano, podríamos caer en los mismos errores de nuevo, lo cual es inaceptable para nuestra ideología de equipo, ya que todos nuestros mecanismos de trabajo están diseñados precisamente para lo contrario: nunca repetir los mismos problemas. Para ello necesitábamos un volumen completo de registros y su entrega casi en tiempo real, ya que el equipo de ingenieros de guardia monitorizaba alertas no solo de métricas, sino también de logs. Para entender la magnitud del problema, en ese momento el volumen total de registros era de aproximadamente 2 TB por día.
Nos propusimos la tarea de eliminar completamente la pérdida de registros y reducir el tiempo de entrega al clúster ELK a un máximo de 15 minutos durante situaciones de emergencia (esa cifra se convirtió en nuestro KPI interno).
Nuevo mecanismo de rotación y nodos hot-warm.
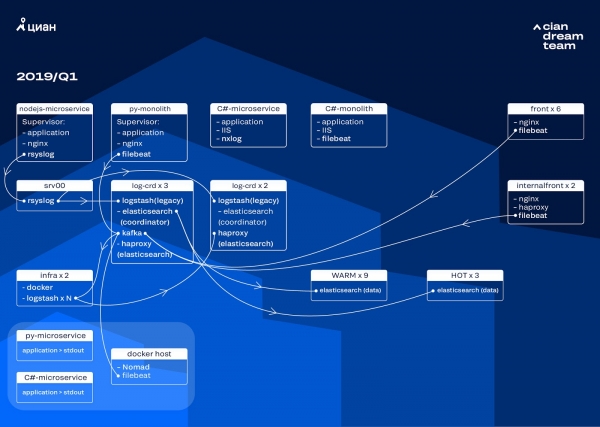
Comenzamos la transformación del clúster actualizando la versión de ElasticSearch de 5.5.2 a 6.4.3. Nuevamente experimentamos la caída del clúster de la versión 5, y decidimos desactivarlo y actualizarlo completamente, ya que de todos modos no teníamos registros. Así que esta transición la realizamos en solo unas pocas horas.
La transformación más significativa en esta etapa fue la implementación de tres nodos con un coordinador como un buffer intermedio utilizando Apache Kafka. El broker de mensajes nos liberó de la pérdida de registros durante problemas con ElasticSearch. Al mismo tiempo, agregamos 2 nodos al clúster y cambiamos a una arquitectura hot-warm con tres nodos 'calientes', ubicados en diferentes racks en el centro de datos. En ellos, redirigimos los registros que no podían perderse bajo ninguna circunstancia: nginx, así como los registros de errores de las aplicaciones. A los otros nodos se les enviaron registros menores: debug, warning, etc., y después de 24 horas, los 'importantes' registros se trasladaron desde los nodos 'calientes'.
Para no aumentar la cantidad de índices pequeños, cambiamos de rotación temporal a un mecanismo de rollover. En los foros había mucha información sobre que la rotación por tamaño de índice es muy poco confiable, por lo que decidimos utilizar la rotación por número de documentos en el índice. Analizamos cada índice y registramos la cantidad de documentos después de la cual debía activarse la rotación. De esta manera, logramos un tamaño óptimo de shard: no más de 50 GB.
Optimización del clúster
Sin embargo, no nos libramos completamente de los problemas. Desafortunadamente, aún aparecían índices pequeños: no alcanzaban el volumen requerido, no rotaban y se eliminaban con la limpieza global de índices que tenían más de tres días, ya que eliminamos la rotación por fecha. Esto provocaba pérdida de datos debido a que el índice desaparecía completamente del clúster, y el intento de escritura en un índice inexistente rompía la lógica del curator que utilizamos para la gestión. El alias para la escritura se convertía en un índice y rompía la lógica del rollover, causando un crecimiento descontrolado de algunos índices hasta 600 GB.
Por ejemplo, para la configuración de rotación:
curator-elk-rollover.yaml

---
actions:
  1:
    action: rollover
    options:
      name: "nginx_write"
      conditions:
        max_docs: 100000000
  2:
    action: rollover
    options:
      name: "python_error_write"
      conditions:
        max_docs: 10000000
En ausencia de rollover, el alias generaba un error:
ERROR     alias "nginx_write" not found.
ERROR     Failed to complete action: rollover.  : Unable to perform index rollover with alias "nginx_write".
Dejamos la solución de este problema para la siguiente iteración y nos ocupamos de otro asunto: pasamos a la lógica de trabajo de pull en Logstash, que se encarga del procesamiento de los registros entrantes (eliminación de información innecesaria y enriquecimiento). Lo colocamos en docker, que ejecutamos a través de docker-compose, y también colocamos logstash-exporter, que proporciona métricas a Prometheus para el monitoreo operativo del flujo de registros. Así nos dimos la posibilidad de cambiar gradualmente el número de instancias de logstash responsables del procesamiento de cada tipo de registros.
Mientras perfeccionábamos el clúster, la asistencia en cian.ru creció hasta 12,8 millones de usuarios únicos al mes. Como resultado, nuestras transformaciones se quedaron un poco atrás de los cambios en producción, y nos encontramos con que los nodos 'fríos' no podían manejar la carga, lo que ralentizaba toda la entrega de registros. Los datos 'calientes' los recibíamos sin problemas, pero en la entrega de los restantes teníamos que intervenir y hacer un rollover manual para distribuir uniformemente los índices.
Sin embargo, la escalabilidad y el cambio de configuraciones de las instancias de logstash en el clúster se complicaban porque era un docker-compose local, y todas las acciones se realizaban manualmente (para agregar nuevos finales, era necesario recorrer todos los servidores manualmente y ejecutar docker-compose up -d en cada uno).
Redistribución de registros
En septiembre de este año, todavía continuábamos descomponiendo el monolito, la carga en el clúster aumentaba y el flujo de registros se acercaba a 30 mil mensajes por segundo.
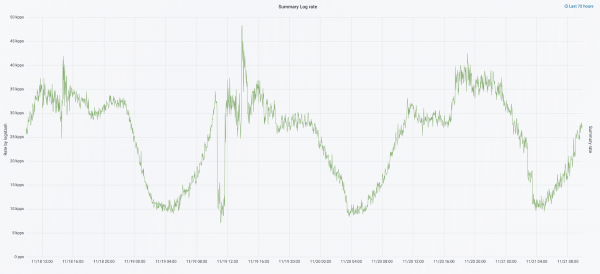
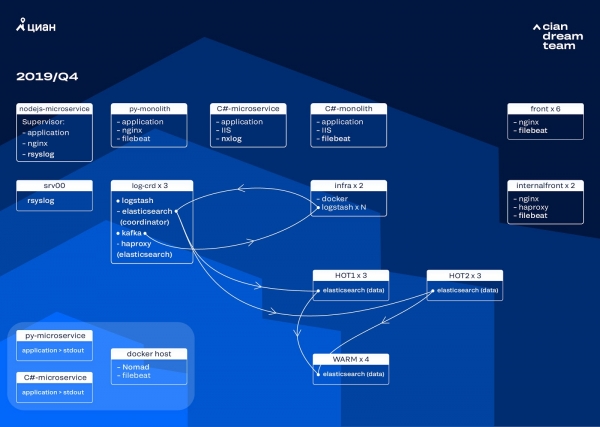
Comenzamos la siguiente iteración con una actualización del hardware. Pasamos de cinco coordinadores a tres, reemplazamos los nodos de datos y ganamos tanto en dinero como en capacidad de almacenamiento. Para los nodos usamos dos configuraciones:
- Para los nodos 'calientes': E3-1270 v6 / 960Gb SSD / 32 Gb x 3 x 2 (3 para Hot1 y 3 para Hot2).
- Para los nodos 'tibios': E3-1230 v6 / 4Tb SSD / 32 Gb x 4.
En esta iteración, trasladamos el índice con los registros de acceso de los microservicios, que ocupa tanto espacio como los registros frontales de nginx, al segundo grupo de tres nodos 'calientes'. Ahora almacenamos los datos en los nodos 'calientes' durante 20 horas y luego los trasladamos a los nodos 'tibios' junto con los otros registros.
Resolvimos el problema de la desaparición de los índices pequeños reconfigurando su rotación. Ahora, los índices rotan cada 23 horas, incluso si hay pocos datos. Esto ha incrementado ligeramente el número de shards (ahora hay alrededor de 800), pero desde el punto de vista del rendimiento del clúster, es tolerable.
Como resultado, en el clúster hay seis nodos "calientes" y solo cuatro "tibios". Esto provoca una pequeña latencia en las consultas durante intervalos de tiempo largos, pero el aumento del número de nodos en el futuro resolverá este problema.
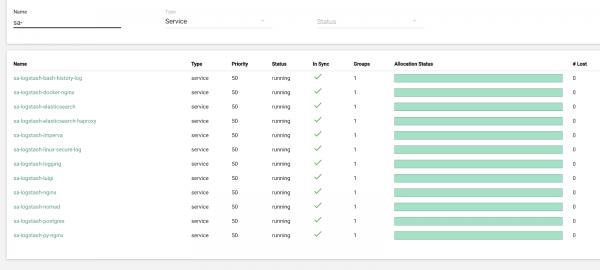
En esta iteración, también solucionamos el problema de la falta de escalado semiautomático. Para ello, desplegamos un clúster de infraestructura Nomad, similar al que ya tenemos en producción. Por ahora, el número de Logstash no cambia automáticamente según la carga, pero llegará ese momento.
Planes futuros
La configuración implementada escala muy bien y ahora almacenamos 13.3 TB de datos: todos los registros de los últimos 4 días, lo cual es necesario para la investigación urgente de alertas. Parte de los registros la convertimos en métricas, que almacenamos en Graphite. Para facilitar el trabajo de los ingenieros, tenemos métricas para el clúster de infraestructura y scripts para solucionar semiautomáticamente problemas típicos. Después del aumento del número de nodos de datos, planeado para el próximo año, pasaremos a almacenar datos de 4 a 7 días. Esto será suficiente para un trabajo ágil, ya que siempre tratamos de investigar incidentes lo más pronto posible, y para investigaciones a largo plazo hay datos de telemetría.
En octubre de 2019, el tráfico de cian.ru creció hasta 15.3 millones de usuarios únicos al mes. Esto fue una prueba seria para la solución arquitectónica de entrega de registros.
Actualmente nos estamos preparando para actualizar ElasticSearch a la versión 7. Sin embargo, para ello tendremos que actualizar el mapeo de muchos índices en ElasticSearch, ya que estos se trasladaron desde la versión 5.5 y fueron declarados como obsoletos en la versión 6 (en la versión 7 simplemente no existen). Esto significa que durante el proceso de actualización seguramente habrá algún imprevisto que nos dejará temporalmente sin registros. De la versión 7, esperamos con más anticipación Kibana con una interfaz mejorada y nuevos filtros.
Hemos alcanzado nuestro objetivo principal: hemos dejado de perder registros y hemos reducido el tiempo de inactividad del clúster de infraestructura de 2-3 caídas por semana a un par de horas de mantenimiento al mes. Todo este trabajo en producción es casi imperceptible. Sin embargo, ahora podemos identificar con precisión lo que está sucediendo con nuestro servicio, podemos hacerlo rápidamente en un modo tranquilo y no preocuparnos por la pérdida de registros. En general, estamos satisfechos, felices y nos estamos preparando para nuevos desafíos de los que hablaremos más adelante.
Fuente: habr.com
