

Nota de traducción.: Service mesh — un fenómeno que aún no tiene una traducción establecida en español (hace más de 2 años propusimos la opción «malla de servicios», y poco después algunos colegas comenzaron a promover activamente la combinación «tamiz de servicios»). La conversación constante sobre esta tecnología ha llevado a una situación en la que los componentes de marketing y técnicos están demasiado entrelazados. Este material excelente de uno de los autores del término original tiene como objetivo aclarar las ideas para los ingenieros y más allá.
Cómic de
Introducción
Si eres un ingeniero de software que trabaja en algún lugar relacionado con sistemas backend, el término «service mesh» probablemente ya está firmemente arraigado en tu mente durante los últimos par de años. Gracias a una curiosa serie de circunstancias, esta frase está capturando cada vez más la industria, mientras que el bombo publicitario y las ofertas relacionadas están creciendo como una bola de nieve que rueda cuesta abajo, sin mostrar señales de desaceleración.
La service mesh nació en las turbias y sesgadas aguas del ecosistema cloud native. Lamentablemente, esto significa que gran parte del debate relacionado varía desde «charlas livianas» hasta —si se utiliza un término técnico— pura tontería. Pero si se filtra todo el ruido, se puede encontrar que la service mesh tiene una función real, definida e importante.
En esta publicación intentaré hacer exactamente eso: presentar una guía honesta, profunda y orientada a ingenieros sobre la service mesh. Voy a responder no solo a la pregunta: «¿Qué es?», — sino también a «¿Para qué?», así como «¿Por qué ahora?». Finalmente, intentaré esbozar por qué (en mi opinión) esta tecnología en particular ha generado un entusiasmo tan loco, lo que en sí mismo es una historia interesante.
¿Quién soy yo?
¡Hola a todos! Me llamo . Soy uno de los creadores de — el primer proyecto de service mesh y el proyecto que es responsable de la aparición del término malla de servicios como tal (¡perdón, chicos!). (Ejemplo traducido.: Por cierto, en los albores de este término, hace más de 2.5 años, ya habíamos traducido material temprano del mismo autor titulado «».) También lidero — una startup que se dedica a crear cosas geniales de service mesh, como Linkerd y .
Probablemente se esté preguntando que tengo una opinión bastante sesgada y subjetiva sobre este tema. Sin embargo, intentaré minimizar la parcialidad (con la excepción de una sección: «¿Por qué hay tantas conversaciones sobre service mesh?», en la que compartiré mis ideas preconcebidas). También haré todo lo posible para que esta guía sea lo más objetiva posible. En los ejemplos específicos, principalmente me basaré en la experiencia de Linkerd, señalando las diferencias que conozco (si las hay) en la implementación de otros tipos de service mesh.
Bien, es hora de pasar a lo interesante.
¿Qué es un service mesh?
A pesar de todo el bombo, estructuralmente un service mesh es bastante simple. Es un conjunto de proxies de userspace colocados "cerca" de los servicios (más adelante hablaremos un poco sobre lo que significa "cerca"); además, hay un conjunto de procesos de gestión. Los proxies en conjunto se conocen como data plane, mientras que los procesos de gestión se denominan control plane. El data plane intercepta las llamadas entre servicios y realiza "diferentes cosas" con ellas; el control plane, por su parte, coordina el comportamiento de los proxies y proporciona acceso para usted, es decir, el operador, a la API, permitiendo manipular la red y medirla como un todo.
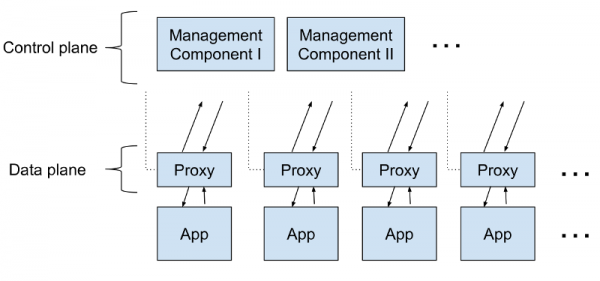
¿Qué son estos proxies? Son proxies TCP de categoría "Layer 7-aware" es decir, que "tienen en cuenta" el nivel 7 del modelo OSI , como HAProxy y NGINX. Puede elegir el proxy que prefiera; Linkerd utiliza un proxy en Rust, sencillamente llamado . Lo hemos creado específicamente para el service mesh. Otros meshes prefieren otros proxies (Envoy es una elección común). Sin embargo, la elección del proxy es solo una cuestión de implementación.
¿Qué hacen estos servidores proxy? Obviamente, envían llamadas a los servicios y de ellos (estrictamente hablando, funcionan como proxies y reverse proxies, manejando tanto llamadas entrantes como salientes). Y implementan un conjunto de funciones que se concentra en las llamadas entre los servicios. Este enfoque en el tráfico entre servicios distingue a los proxies de service mesh de, digamos, los gateways de API o los proxies de ingreso (los últimos se centran en las llamadas que llegan al clúster desde el mundo exterior). (Nota de traducción.: comparación de los controladores Ingress existentes para Kubernetes, muchos de los cuales ya utilizan el mencionado Envoy, véase en .)
Así que ya entendimos el data plane. El control plane es más simple: se trata de un conjunto de componentes que aseguran toda la mecánica necesaria para que el data plane funcione de manera coordinada, incluyendo la detección de servicios, la emisión de certificados TLS, la agregación de métricas, etc. El data plane informa al control plane sobre su comportamiento; a su vez, el control plane proporciona una API que permite cambiar y rastrear el comportamiento del data plane como un todo.
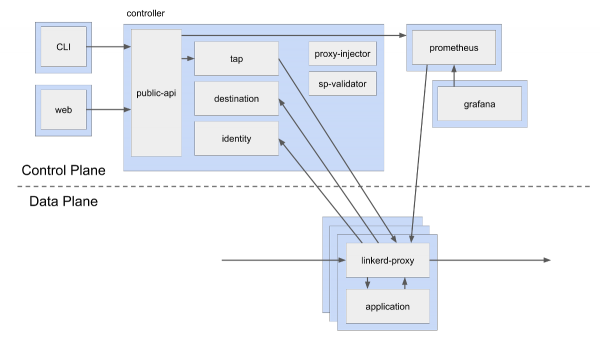
A continuación se presenta un esquema del control plane y el data plane en Linkerd. Como se puede ver, el control plane incluye varios componentes diferentes, incluyendo una instancia de Prometheus que recoge métricas de los proxies, así como otros componentes como destino (detección de servicios), -token, (centro de certificación, CA) y public-api (puntos finales para web y CLI). En contraste, el data plane consiste en un simple linkerd-proxy al lado de la instancia de la aplicación. Este es solo un esquema lógico; en condiciones reales, al desplegar, puede que tengas tres réplicas de cada componente del control plane y cientos o miles de proxies en el data plane.
(Los rectángulos azules en este esquema simbolizan los límites de los pods de Kubernetes. Se puede ver que los contenedores con linkerd-proxy están en el mismo pod que los contenedores de la aplicación. Este tipo de esquema se conoce como contenedor sidecar.)
La arquitectura del service mesh tiene varias implicaciones importantes. Primero, dado que la tarea del proxy es interceptar llamadas entre servicios, el service mesh solo tiene sentido si tu aplicación fue construida como un conjunto de servicios. La malla en se puede usar con monolitos, pero es claramente redundante para un solo proxy, además su funcionalidad probablemente no será requerida.
Otra implicación importante es que el service mesh requiere una enorme cantidad de proxies. De hecho, Linkerd conecta un linkerd-proxy a cada instancia de cada servicio (otras implementaciones añaden proxies a cada nodo/anfitrión/máquina virtual. En cualquier caso, esto no es poco). Este uso intensivo de proxies trae consigo una serie de complicaciones adicionales:
- Los proxies en el data plane deben ser rápidos, ya que para cada llamada hay un par de solicitudes al proxy: una del lado del cliente, una del lado del servidor.
- Además, los proxies deben ser pequeños y ligeros. Cada uno consumirá recursos de memoria y CPU, y este consumo crecerá linealmente con la aplicación.
- Necesitarás un mecanismo para desplegar y actualizar una gran cantidad de proxies. Hacerlo manualmente no es una opción.
En general, una service mesh se ve así (al menos desde una perspectiva aérea): despliegas un montón de proxies de userspace que 'hacen algo' con el tráfico interno entre servicios, y utilizas un control plano para monitorear y gestionarlos.
Ha llegado el momento de la pregunta '¿Para qué?'
¿Para qué sirve una service mesh?
Es comprensible que quienes se enfrentan por primera vez a la idea de una service mesh sientan un leve temor. La estructura de la service mesh significa que no solo aumentará la latencia en la aplicación, sino que también consumirá recursos y agregará un montón de nuevos mecanismos a la infraestructura. Primero instalas la service mesh, y luego de repente te das cuenta de que necesitas gestionar cientos (si no miles) de proxies. La pregunta es, ¿quién se ofrece voluntario para esto?
La respuesta a esta pregunta se compone de dos partes. Primero, los costos operativos asociados con el despliegue de estos proxies pueden reducirse significativamente gracias a algunos cambios que están ocurriendo en el ecosistema (más sobre esto más adelante).
En segundo lugar, este tipo de dispositivo es en realidad una excelente manera de introducir lógica adicional en el sistema. Y no solo porque con una service mesh se pueden añadir muchas nuevas funciones, sino también porque esto se puede hacer sin interferir en el ecosistema. De hecho, todo el modelo de la service mesh se basa en este postulado: en un sistema de múltiples servicios, independientemente de lo que hagan los servicios individuales, el tráfico entre ellos es el punto ideal para añadir funcionalidad.
Por ejemplo, en Linkerd (al igual que en la mayoría de las mesh) la funcionalidad se centra principalmente en llamadas HTTP, incluyendo HTTP/2 y gRPC*. La funcionalidad es bastante rica; se puede dividir en tres clases:
- Funciones relacionadas con la fiabilidad. Reintentos, timeouts, enfoque canario (split/redirect traffic), etc.
- Funciones relacionadas con monitoreo.Agregación de métricas de éxito, latencias y volúmenes de solicitudes para cada servicio o direcciones individuales; construcción de mapas topológicos de servicios, etc.
- Funciones relacionadas con la seguridad. Mutual TLS, control de acceso, etc.
* Desde el punto de vista de Linkerd, gRPC no se diferencia prácticamente de HTTP/2: simplemente utiliza protobuf en la carga útil. Desde la perspectiva del desarrollador, estas dos cosas, por supuesto, son diferentes.
Muchos de estos mecanismos operan a nivel de peticiones (de ahí el término "proxy L7"). Por ejemplo, si el servicio Foo envía una llamada HTTP al servicio Bar, el linkerd-proxy en el lado de Foo puede realizar un balanceo de carga inteligente y dirigir las llamadas desde Foo a las instancias de Bar según la latencia observada; puede repetir la solicitud si es necesario (y si es idempotente); puede registrar el código de respuesta y el tiempo de espera, etc. De manera similar, el linkerd-proxy en el lado de Bar puede rechazar la solicitud si no está permitida o se supera el límite de solicitudes; puede registrar la latencia desde su lado, etc.
Los proxies también pueden "hacer algo" a nivel de conexión. Por ejemplo, el linkerd-proxy en el lado de Foo puede iniciar una conexión TLS, mientras que el linkerd-proxy en el lado de Bar puede interrumpirla, y ambas partes pueden verificar los certificados TLS entre sí*. Esto proporciona no solo cifrado entre servicios, sino también un método criptográficamente seguro para identificar los servicios: Foo y Bar pueden "demostrar" que son quienes dicen ser.
* "El uno al otro" significa que el certificado del cliente también se verifica (TLS mutuo). En el TLS "clásico", por ejemplo, entre un navegador y un servidor, generalmente solo se verifica el certificado de una de las partes (el servidor).
Independientemente de si operan a nivel de peticiones o de conexiones, es importante subrayar que todas las funciones de service mesh tienen un carácter operacional. Linkerd no puede transformar la semántica de la carga útil: por ejemplo, agregar campos a un fragmento JSON o realizar cambios en protobuf. En esta importante característica hablaremos más tarde, cuando tratemos sobre ESB y middleware.
Ese es el conjunto de funciones que ofrece el service mesh. Surge la pregunta: ¿por qué no implementarlas directamente en la aplicación? ¿Y por qué involucrarse con un proxy?
Por qué el service mesh es una buena idea.
Aunque las capacidades del service mesh son fascinantes, su verdadero valor radica no en las funciones. Al final, nosotros podemos implementarlos directamente en la aplicación (más adelante veremos que esta fue la origen del service mesh). Si intentamos expresar esta idea en una sola frase, el valor de service mesh radica en lo siguiente: proporciona funcionalidades críticas para el funcionamiento del software de servidor moderno de manera uniforme para toda la pila e independiente del código de la aplicación.
Analicemos esta oración.
«Funcionalidades críticas para el funcionamiento del software de servidor modernoSi está creando una aplicación de servidor transaccional relacionada con Internet público, que reciba solicitudes del mundo exterior y responda a ellas en un corto período de tiempo, como una aplicación web, un servidor API, y en efecto la gran mayoría de las otras aplicaciones modernas, y si lo implementa como un conjunto de servicios que interactúan entre sí de manera sincrónica, y si constantemente actualiza este software añadiendo nuevas funcionalidades, y si se ve obligado a mantener este sistema operando mientras realiza modificaciones, en este caso, le felicito, está creando software de servidor moderno. Y todas esas maravillosas funciones mencionadas anteriormente resultan ser críticas para usted. La aplicación debe ser confiable, segura, y debe tener la capacidad de monitorear lo que está haciendo. Precisamente estas cuestiones son las que ayuda a resolver el service mesh.
(Ok, en el párrafo anterior, todavía se coló mi convicción de que este enfoque es una manera moderna de crear software de servidor. Otros prefieren desarrollar monolitos, "microservicios reactivos" y otras cosas que no se ajustan a la definición dada anteriormente. Estas personas seguramente tienen una opinión diferente a la mía. Por mi parte, creo que "no tienen razón" — aunque de todos modos el service mesh no les es muy útil).
«Uniforme para toda la pilaLas funcionalidades proporcionadas por service mesh no solo son críticas. Se aplican a todos los servicios en la aplicación independientemente del lenguaje en el que estén escritos, qué marco utilizan, quién los escribió, cómo fueron desplegados y todas las demás sutilezas de su desarrollo y aplicación.
«Independiente del código de la aplicaciónFinalmente, la service mesh no solo proporciona capacidades funcionales unificadas para todo el stack, sino que lo hace de una manera que no requiere la modificación de la aplicación. La base fundamental de la funcionalidad de la service mesh, que incluye tareas de configuración, actualización, operación, mantenimiento, etc., reside exclusivamente a nivel de plataforma e independiente de la aplicación. La aplicación puede cambiar sin afectar a la service mesh. A su vez, la service mesh puede cambiar sin ninguna participación de la aplicación.
En resumen, la service mesh no solo proporciona funciones vitales, sino que lo hace de manera global, uniforme e independiente de la aplicación. Y por lo tanto, aunque la funcionalidad de la service mesh puede realizarse en el código del servicio (por ejemplo, como una biblioteca incluida en cada servicio), este enfoque no garantizará la homogeneidad y la independencia, tan valiosas en el caso de la service mesh.
¡Y todo lo que se necesita para esto es agregar un montón de proxies! Prometo que muy pronto analizaremos los costos operativos relacionados con la adición de estos proxies. Pero primero, detengámonos y miremos esta idea de independencia desde diferentes perspectivas. las personas.
¿A quién ayuda la service mesh?
Por incómodo que sea, para que una tecnología se convierta en una parte importante del ecosistema, debe ser adoptada por las personas. Entonces, ¿quién está interesado en la service mesh? ¿Quién se beneficia de su uso?
Si estás desarrollando software de servidor moderno, puedes imaginarte tu equipo más o menos como un grupo de propietarios de servicios, que desarrollan e implementan la lógica de negocio juntos, y propietarios de plataforma, que se encargan del desarrollo de la plataforma interna en la que operan estos servicios. En organizaciones pequeñas, estas pueden ser las mismas personas, pero a medida que la empresa crece, estos roles generalmente se vuelven más pronunciados e incluso se dividen en subroles... (Se puede hablar mucho sobre la naturaleza cambiante del devops, la influencia organizativa de los microservicios, etc. Pero por ahora, consideremos estas descripciones como un hecho).
Desde este punto de vista, los principales beneficiarios del service mesh son los propietarios de la plataforma. Al final, el objetivo del equipo de la plataforma es crear una plataforma interna sobre la cual los propietarios de servicios puedan implementar su lógica de negocio, y hacerlo de una manera que garantice su máxima independencia de los oscuros detalles de su operación. El service mesh no solo ofrece capacidades que son críticas para alcanzar este objetivo: lo hace de una manera que, a su vez, no impone dependencias sobre los propietarios de servicios.
Los propietarios de servicios también se benefician, aunque de una manera más indirecta. El objetivo del propietario del servicio es ser lo más productivo posible en la implementación de la lógica del proceso de negocio, y cuanto menos tenga que preocuparse por cuestiones operativas, mejor. En lugar de lidiar con la implementación, digamos, de políticas de reintentos o TLS, pueden concentrarse exclusivamente en las tareas comerciales y esperar que la plataforma se encargue de todo lo demás. Para ellos, esto es una gran ventaja.
El valor organizativo de esta división entre los propietarios de plataformas y servicios es difícil de sobrestimar. Creo que aporta principal valor al service mesh.
Aprendimos esta lección cuando uno de los primeros fanáticos de Linkerd nos contó por qué eligieron el service mesh: porque les permitió "reducir la charla al mínimo". Aquí hay algunos detalles: chicos de una gran empresa migraron su plataforma a Kubernetes. Dado que la aplicación trabajaba con información confidencial, querían cifrar toda la comunicación en los clústeres. Sin embargo, la situación se complicaba con cientos de servicios y cientos de equipos de desarrollo. La perspectiva de tener que comunicarse con todos y convencerlos de incorporar soporte para TLS en sus planes no les agradaba en absoluto. Al establecer Linkerd, trasladaron la responsabilidad de los desarrolladores (para quienes esto era una carga adicional) a los encargados de la plataforma, para quienes esto era una prioridad de alto nivel. En otras palabras, Linkerd resolvía para ellos no solo un problema técnico, sino también un problema organizativo.
En resumen, el service mesh es más bien una solución a un problema no técnico sino a un problema socio-técnico. (Gracias a Cindy Sridharan ¿Resolverá el service mesh todos mis problemas?
¿Resolverá el service mesh todos mis problemas?
Sí. Quiero decir, ¡no!
Si observamos las tres clases de funciones mencionadas anteriormente: confiabilidad, seguridad y observabilidad, se hace evidente que un service mesh no es una solución completa para ninguno de estos problemas. Aunque Linkerd puede enviar solicitudes repetidas (si sabe que son idempotentes), no es capaz de tomar decisiones sobre qué devolver al usuario si un servicio ha caído por completo; tales decisiones deben ser tomadas por la aplicación. Linkerd puede llevar estadísticas de las solicitudes exitosas, sin embargo, no puede espiar el servicio y proporcionar sus métricas internas; este tipo de herramientas deben estar en la aplicación. Y aunque Linkerd es capaz de organizar mTLS, las soluciones completas en materia de seguridad requieren mucho más.
Un subconjunto de funciones en estas áreas, ofrecidas por el service mesh, se refiere a las características de la plataforma. Con esto me refiero a funciones que:
- Son independientes de la lógica de negocio. La manera en que se construyen los histogramas de llamadas entre Foo y Bar no depende en absoluto de si por la cual Foo llama a Bar.
- Es difícil de implementar correctamente. En Linkerd, los reintentos se parametrizan con diversas características avanzadas como los presupuestos de reintentos (retry budgets), ya que un enfoque simple probablemente dará lugar a lo que se denomina "tormenta de reintentos" (retry storm) y otros problemas típicos de los sistemas distribuidos.
- Son más efectivos cuando se aplican de manera uniforme. El mecanismo TLS solo tiene sentido si se aplica en todas partes.
Dado que estas funciones se implementan a nivel de proxy (y no a nivel de aplicación), el service mesh las proporciona a nivel la plataforma, y no de aplicación. Por lo tanto, no importa en qué lenguaje estén escritos los servicios, qué marco usen, quién los escribió y por qué. Los proxies operan por fuera de todos estos detalles, y la base fundamental de esta funcionalidad, incluidas las tareas de configuración, actualización, operación, mantenimiento, etc., recae exclusivamente en el nivel de la plataforma.
Ejemplos de capacidades del service mesh
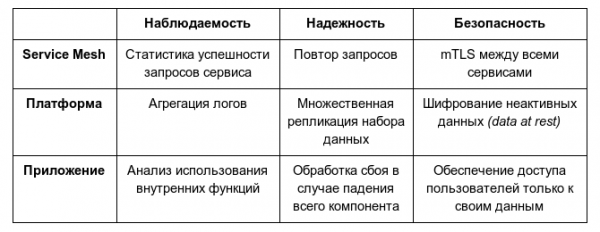
Para resumir, quiero decir que el service mesh no es una solución completa para garantizar la fiabilidad, la observabilidad o la seguridad. La magnitud de estas áreas implica la participación obligatoria de los propietarios de los servicios, equipos de Ops/SRE y otros actores de la empresa. El service mesh solo proporciona un «corte» a nivel de plataforma para cada una de estas áreas.
¿Por qué el service mesh se ha vuelto popular precisamente ahora?
Probablemente, en este momento te estés preguntando: está bien, si el service mesh es tan bueno, ¿por qué no comenzamos a desplegar millones de proxies en la pila hace diez años?
Hay una respuesta evidente a esta pregunta: hace diez años todos estaban construyendo monolitos, y el service mesh no era necesario para nadie. Es cierto, pero en mi opinión, este tipo de respuesta pierde la esencia. Incluso hace diez años, el concepto de microservicios como un enfoque prometedor para crear sistemas a gran escala se discutía y aplicaba ampliamente en empresas como Twitter, Facebook, Google y Netflix. La percepción general —al menos en las partes de la industria con las que he tenido contacto— era que los microservicios eran la «forma correcta» de construir sistemas grandes, aunque esto fuera extremadamente difícil.
Por supuesto, aunque hace diez años había empresas que utilizaban microservicios, no estaba generalizado el uso de proxies en todas partes para formar un service mesh. Sin embargo, si miramos de cerca, hacían algo similar: en muchas de estas empresas se requería utilizar una biblioteca interna especial para la interacción de red (a veces llamada biblioteca de cliente grueso, fat client library).
Netflix tenía Hysterix, Google tenía Stubby, Twitter tenía la biblioteca Finagle. Finagle, por ejemplo, era obligatoria para cada nuevo servicio en Twitter. Gestionaba tanto la parte del cliente como la del servidor de las conexiones, permitía realizar reintentos, soportaba el enrutamiento de solicitudes, la distribución de carga y las métricas. Proporcionaba una capa coherente de fiabilidad y observabilidad para toda la pila de Twitter, sin importar qué servicio estaba realizando la tarea. Por supuesto, solo funcionaba para lenguajes de la JVM y se basaba en el modelo de programación que se tenía que utilizar para toda la aplicación. Sin embargo, sus funcionalidades eran casi las mismas que las de un service mesh. (De hecho, la primera versión de Linkerd era simplemente Finagle envuelto en forma de proxy.)
Así, hace diez años no solo existían los microservicios, sino también bibliotecas proto-service-mesh especiales que resolvían los mismos problemas que service mesh resuelve hoy. Sin embargo, la service mesh en sí no existía todavía. Tenía que haber otro cambio antes de que apareciera.
Y aquí es donde se encuentra una respuesta más profunda, oculta en otra transformación que ha ocurrido en los últimos 10 años: ha habido una drástica reducción en el costo de desplegar microservicios. Las empresas mencionadas anteriormente que usaban microservicios hace diez años: Twitter, Netflix, Facebook, Google, eran empresas de gran escala y con enormes recursos. No solo tenían la necesidad, sino también la capacidad para crear, desplegar y operar grandes aplicaciones basadas en microservicios. La energía y el esfuerzo que los ingenieros de Twitter dedicaron a la transición de un enfoque monolítico a uno basado en microservicios son simplemente asombrosos. (Sinceramente, al igual que el hecho de que lo lograron.) Este tipo de maniobras de infraestructura eran imposibles para empresas de menor tamaño en ese entonces.
Viajemos al presente. Hoy existen startups donde la proporción de microservicios por desarrollador es de 5:1 (o incluso ), y lo que es más, ¡están manejando esto con éxito! Si una startup de 5 personas puede operar sin esfuerzo 50 microservicios, significa que algo ha reducido claramente el costo de su implementación.
1500 microservicios en Monzo; cada línea es una regla de red prescrita que permite el tráfico.
La drástica reducción del costo de operar microservicios es el resultado de un solo proceso: el aumento de la popularidad de los contenedores, y los orquestadores.. Esa es la respuesta profunda a la pregunta de qué ha contribuido al surgimiento de la service mesh. La misma tecnología ha hecho atractivos tanto la service mesh como los microservicios: Kubernetes y Docker.
¿Por qué? Bueno, Docker resuelve un gran problema: el problema del empaquetado. Al empaquetar una aplicación y sus dependencias de tiempo de ejecución (no relacionadas con la red) en un contenedor, Docker convierte la aplicación en una unidad intercambiable que se puede desplegar y ejecutar en cualquier lugar. Al mismo tiempo, simplifica enormemente la operación de multilingües. pila: dado que el contenedor es una unidad atómica de ejecución, para los propósitos de despliegue y operación no importa qué hay dentro, ya sea una aplicación en JVM, Node, Go, Python o Ruby. Solo lo ejecutas y listo.
Kubernetes lleva todo a un nuevo nivel. Ahora que hay un montón de "cosas ejecutables" y muchas máquinas para ejecutarlas, surge la necesidad de una herramienta que pueda hacer coincidir unas con otras. En términos generales, le das a Kubernetes muchos contenedores y muchas máquinas, y él los empareja. (Por supuesto, este es un proceso dinámico y en constante cambio: nuevos contenedores se mueven por el sistema, las máquinas se encienden y apagan, etc. Sin embargo, Kubernetes tiene en cuenta todo esto).
Después de configurar Kubernetes, el tiempo requerido para desplegar y operar un servicio apenas difiere del necesario para diez servicios (de hecho, son prácticamente equivalentes e incluso para 100 servicios). Añade a esto los contenedores como mecanismo de empaquetado que fomenta la implementación multilingüe, y obtendrás una multitud de nuevas aplicaciones implementadas en forma de microservicios escritos en varios idiomas, precisamente el entorno para el que servicio mesh es tan adecuado.
Así que hemos llegado a la respuesta a la pregunta de por qué la idea de servicio mesh se ha vuelto popular justo ahora: la homogeneidad que Kubernetes proporciona para los servicios se aplica directamente a las tareas operativas que enfrenta el servicio mesh. Empacas proxies en contenedores, le das a Kubernetes la tarea de organizarlos donde sea posible, ¡y voilà! Obtienes un servicio mesh, mientras que toda la mecánica de su despliegue es controlada por Kubernetes. (Al menos, desde una perspectiva general. Por supuesto, en este proceso hay muchos matices).
En resumen: la razón por la que el servicio mesh se ha vuelto popular ahora y no hace diez años es que Kubernetes y Docker no solo han aumentado significativamente la necesidad de ello, simplificando la implementación de aplicaciones como conjuntos de microservicios multilingües, sino que también han reducido considerablemente los costos de su operación, asegurando mecanismos de despliegue y soporte para parques de proxies sidecar.
¿Por qué hay tantas conversaciones sobre servicio mesh?
Advertencia: en esta sección recurriré a diversas suposiciones, conjeturas, especulaciones e información interna.
Al buscar la frase «service mesh», te encontrarás con una gran cantidad de contenido reciclado de bajo valor, proyectos extraños y un caleidoscopio de distorsiones dignas de cámaras de eco. Esto es habitual en cualquier nueva tecnología de moda, pero en el caso de service mesh, el problema es especialmente agudo. ¿Por qué?
Bueno, en parte es mi culpa. He hecho todo lo posible por promover Linkerd y service mesh cada vez que ha sido posible, a través de innumerables publicaciones en blogs y artículos como este. Pero no tengo tanto poder. Para responder realmente a esta pregunta, hay que hablar un poco sobre la situación general. Y no se puede hablar de esto sin mencionar un proyecto: — un service mesh de código abierto, desarrollado en conjunto por Google, IBM y Lyft.
(Estas tres empresas tienen roles muy diferentes: la participación de Lyft parece limitarse a un simple nombre; ellos son los creadores de Envoy, pero no usan Istio ni participan en su desarrollo. IBM está involucrada en el desarrollo de Istio y lo utiliza. Google participa activamente en el desarrollo de Istio, pero, según puedo juzgar, en realidad no lo utiliza.)
El proyecto Istio se destaca por dos características. Primero, los enormes esfuerzos de marketing que Google, en particular, está realizando para su promoción. Según mis estimaciones, la mayoría de las personas que conocen el concepto de service mesh lo han hecho gracias a Istio. La segunda característica es lo mal que ha sido recibido Istio. En este tema, soy, evidentemente, una parte interesada, pero tratando de ser lo más objetivo posible, no puedo evitar ser , algo que no es muy característico (aunque no único: me viene a la mente systemd, …) para un proyecto de código abierto.
(En la práctica, parece que Istio tiene problemas no solo con la complejidad y la experiencia del usuario, sino también con el rendimiento. Por ejemplo, durante la , realizada por un tercero, los especialistas descubrieron situaciones en las que las latencias de cola (tail latency) de Istio eran 100 veces superiores a las de Linkerd, así como situaciones de falta de recursos, donde Linkerd continuaba funcionando con éxito, mientras que Istio se detenía por completo.)
Dejando de lado mis teorías sobre por qué ocurrió esto, creo que el desmedido entusiasmo por los service mesh se explica precisamente por la participación de Google. En concreto, por la combinación de tres factores:
- la promoción insistente de Istio por parte de Google;
- la actitud crítica y desaprobatoria hacia el proyecto;
- el reciente auge vertiginoso de popularidad de Kubernetes, cuyas memorias aún son frescas.
Juntos, estos factores se combinan en un entorno embriagador y asfixiante, en el que la capacidad de juicio racional se debilita, quedando solo una maravillosa variedad de .
Desde la perspectiva de Linkerd, esto es... lo describiría como un bien ambiguo. Quiero decir, es maravilloso que los service mesh se hayan vuelto mainstream, algo que no ocurrió en 2016, cuando Linkerd apenas surgía y era realmente difícil atraer la atención de los demás hacia el proyecto. ¡Ahora ese problema no existe! Pero lo malo es que la situación de los service mesh hoy es tan confusa que es prácticamente imposible entender qué proyectos realmente pertenecen a la categoría de service mesh (sin mencionar que sea difícil entender cuál de ellos es el más adecuado para un caso de uso específico). Esto, sin duda, perjudica a todos (y, definitivamente, en algunos casos, Istio u otro proyecto es más adecuado que Linkerd, dado que este último no es una solución universal).
Desde el lado de Linkerd, nuestra estrategia ha sido ignorar el ruido, seguir concentrándonos en resolver los problemas reales de la comunidad y, en esencia, esperar a que el entusiasmo disminuya. Al final, el hype se desvanecerá, y podremos seguir trabajando tranquilamente.
Mientras tanto, todos tendremos que ser un poco pacientes.
¿Me será útil el service mesh como modesto ingeniero de software?
La siguiente encuesta ayudará a responder a esta pregunta:
¿Te dedicas exclusivamente a la implementación de lógica empresarial? En ese caso, el service mesh no te será útil. Es decir, por supuesto que puedes sentir interés en él, pero lo ideal es que el service mesh no deba influir directamente en nada en tu entorno. Sigue trabajando en lo que te pagan.
¿Soportas una plataforma en una empresa que usa Kubernetes? Sí, en este caso necesitas un service mesh (por supuesto, a menos que estés usando K8s solo para ejecutar un monolito o procesamiento por lotes — pero en ese caso me gustaría preguntarte, ¿por qué necesitas K8s?). Lo más probable es que te encuentres en una situación con múltiples microservicios, escritos por diferentes personas. Todos ellos interactúan entre sí y están entrelazados en un enredo de dependencias en tiempo de ejecución, y necesitas encontrar la manera de manejar todo esto. Utilizar Kubernetes te permite elegir un service mesh ‘a tu medida’. Para ello, revisa sus capacidades y características y responde a la pregunta de si realmente alguno de los proyectos existentes te conviene (recomiendo comenzar la investigación con Linkerd).
¿Estás a cargo de una plataforma en una empresa que NO utiliza Kubernetes, pero que usa microservicios? En este caso, un service mesh te será útil, sin embargo, su uso no será trivial. Claro que puedes imitar el funcionamiento de un service mesh, colocando un montón de proxies, pero la ventaja clave de Kubernetes es precisamente el modelo de implementación: mantener estos proxies manualmente requerirá mucha más tiempo, esfuerzo y costos.
¿Eres responsable de una plataforma en una empresa que trabaja con monolitos? En este caso, probablemente no necesites un service mesh. Si estás trabajando con monolitos (o incluso con conjuntos de monolitos) que tienen patrones de interacción bien definidos y que cambian raramente, un service mesh no podrá ofrecerte mucho. Así que puedes simplemente ignorarlo y esperar que desaparezca como una pesadilla…
Conclusión
Probablemente, no deberías llamar al service mesh “la tecnología más sobrevalorada del mundo” — ese dudoso honor probablemente le pertenezca a Bitcoin o a la IA. Tal vez esté entre las cinco primeras. Pero si logras penetrar las capas de ruido y estruendo, se hace evidente que el service mesh ofrece beneficios reales para quienes crean aplicaciones en Kubernetes.
Me gustaría que probaras Linkerd — su instalación en un clúster de Kubernetes (o incluso en Minikube en tu laptop) , y podrás ver por ti mismo de qué estoy hablando.
Preguntas Frecuentes
— Si ignoro el service mesh, ¿desaparecerá?
— Debo desilusionarte: el service mesh ha llegado para quedarse.
— ¡Pero NO QUIERO usar un service mesh!
— ¡Entonces no lo hagas! Solo lee mi cuestionario anterior para entender si deberías al menos familiarizarte con sus conceptos básicos.
— ¿No es esto el viejo y querido ESB/middleware con una nueva presentación?
— El service mesh se encarga de la lógica operativa, no del significado. del bus de servicios empresarial (). Mantener esta separación ayuda al service mesh a evitar el mismo destino.
— ¿En qué se diferencia un service mesh de los API gateways?
— Hay un millón de artículos sobre este tema. Simplemente búscalo en Google.
— ¿Envoy es un service mesh?
— No, Envoy no es un service mesh, es un servidor proxy. Se puede usar para organizar un service mesh (y mucho más, ya que es un proxy de propósito general). Pero por sí solo no es un service mesh.
— ¿Network Service Mesh es un service mesh?
— No. A pesar de su nombre, no es un service mesh (¿por las maravillas del marketing?).
— ¿Ayudará el service mesh con mi sistema reactivo asíncrono basado en colas de mensajes?
— No, el service mesh no te ayudará.
— ¿Qué service mesh debería usar?
— , es claro como el agua.
— ¡El artículo es una porquería! / ¡Al autor al correo!
— ¡Por favor, comparte el enlace con todos tus amigos para que puedan comprobarlo!
Agradecimientos
Como habrás adivinado por el título, este artículo estuvo inspirado en el fantástico tratado de Jay Kreps «». Conocí a Jay hace diez años cuando lo entrevisté en LinkedIn, y desde entonces ha sido una gran inspiración para mí.
Aunque me encanta llamarme a mí mismo «el desarrollador de Linkerd», la realidad es que soy más bien el mantenedor del archivo README.md en el proyecto. Actualmente, en Linkerd trabajan , , personas, y este proyecto no habría sido posible sin la participación de una maravillosa comunidad de contribuyentes y usuarios.
Y para terminar, un agradecimiento especial al creador de Linkerd, (primus inter pares), quien se lanzó conmigo hace muchos años a toda esta locura del service mesh.
P.D. del traductor
También puedes leer en nuestro blog:
- «»;
- «»;
- «»;
- «»;
- «».
Fuente: habr.com
