

Hola, habitantes de Habr. Hoy comienzan las clases en el primer grupo del curso . En este sentido, queremos hablarles sobre cómo fue el seminario web abierto sobre este curso.
En hablamos sobre los desafíos que enfrentan las bases de datos SQL en la era de las nubes y Kubernetes. Además, examinamos cómo las bases de datos SQL se adaptan y mutan bajo la influencia de estos desafíos.
El seminario web fue conducido por , Gerente de Entrega de Práctica en Google Cloud en EPAM Systems.
Cuando los árboles eran pequeños…
Para empezar, recordemos cómo comenzó la elección del SGBD a finales del siglo pasado. Sin embargo, esto no será difícil, ya que la elección del SGBD en esos días comenzaba y terminaba Oracle.
A finales de los 90 y principios de los 2000, realmente no había muchas opciones si hablamos de bases de datos escalables industriales. Sí, existían IBM DB2, Sybase y algunas otras bases de datos que aparecían y desaparecían, pero en general no eran tan notables en comparación con Oracle. Por lo tanto, las habilidades de los ingenieros de esos tiempos estaban, de una manera u otra, ligadas a esa única opción que existía.
Un DBA de Oracle debía saber:
- instalar Oracle Server desde el paquete de distribución;
- configurar Oracle Server:
- init.ora;
- listener.ora;
— crear:
- espacios de tabla;
- esquemas;
- usuarios;
— realizar copias de seguridad y recuperación;
— llevar a cabo la monitorización;
— combatir las consultas no óptimas.
Sin embargo, no se exigía mucho de un DBA de Oracle:
- saber elegir el SGBD óptimo u otra tecnología de almacenamiento y procesamiento de datos;
- garantizar la alta disponibilidad y escalabilidad horizontal (esto no siempre era una cuestión del DBA);
- tener un buen conocimiento del área temática, infraestructura, arquitectura de aplicaciones, sistemas operativos;
- realizar carga y descarga de datos, migración de datos entre diferentes SGBD.
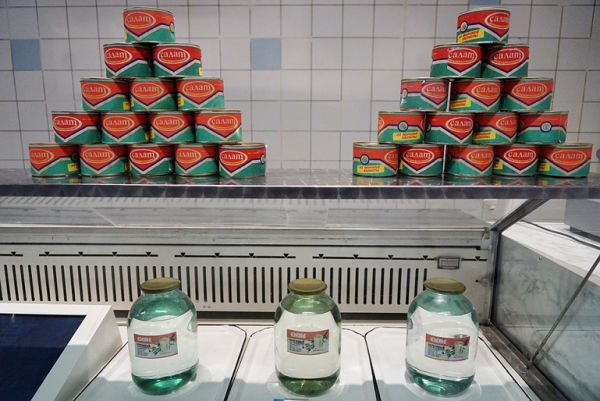
En resumen, si hablamos de la elección en esos tiempos, se asemeja a la elección en una tienda soviética a finales de los 80:
Nuestro tiempo
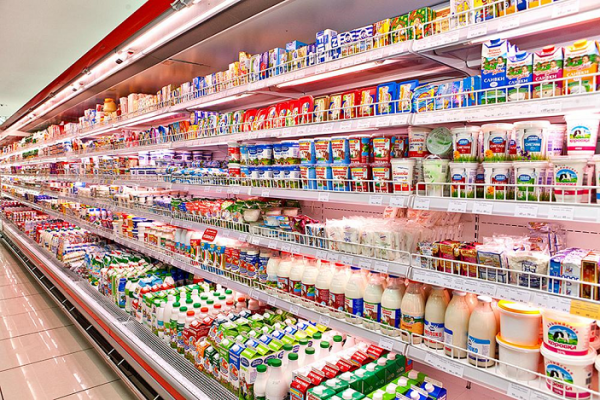
Desde entonces, por supuesto, los árboles han crecido, el mundo ha cambiado, y ahora es algo así:
También ha cambiado el mercado de los SGBD, como se puede ver en el reciente informe de la empresa Gartner:
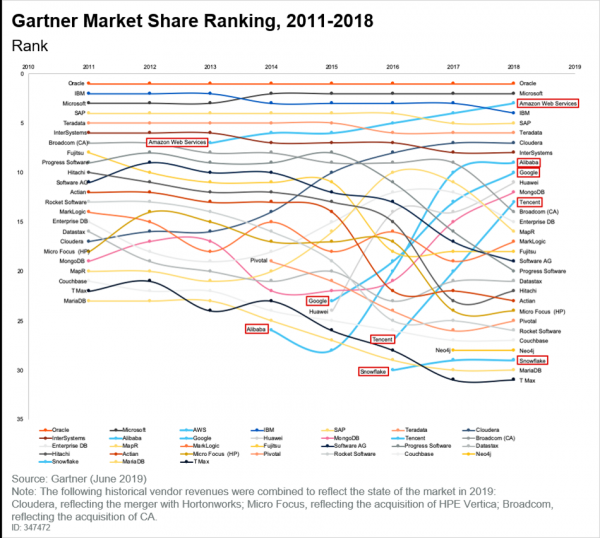
Y aquí no se puede dejar de notar que su nicho ha sido ocupado por las nubes, cuya popularidad está en aumento. Si leemos el mismo informe de la empresa Gartner, veremos las siguientes conclusiones:
- Muchos clientes están en el proceso de migrar aplicaciones a la nube.
- Las nuevas tecnologías primero aparecen en la nube y no está garantizado que alguna vez se trasladen a una infraestructura no nube.
- Se ha vuelto habitual el modelo de fijación de precios según el principio de pago por uso. Todos quieren pagar solo por lo que utilizan, y ya no es una tendencia, sino una simple constatación de la realidad.
¿Qué pasa ahora?
Hoy todos estamos en la nube. Las preguntas que surgen son cuestiones de elección. Y hay una gran variedad, incluso si solo hablamos de la elección de tecnologías de bases de datos en formato On-premises. También tenemos servicios gestionados y SaaS. Así que, la elección se complica con cada año que pasa.
Junto a las cuestiones de elección, también hay factores restrictivos:
- precio. Muchas tecnologías siguen costando dinero;
- habilidades. Si hablamos de software libre, surge la cuestión de las habilidades, ya que el software gratuito requiere de competencias suficientes de las personas que lo implementan y operan;
- funcionalidad. No todos los servicios disponibles en la nube, incluso aquellos construidos sobre la misma base de Postgres, poseen las mismas características que Postgres On-premises. Este es un factor importante que hay que conocer y entender. Aún más, este factor adquiere una importancia mayor que conocer alguna característica oculta de una base de datos específica.
¿Qué se espera actualmente de DA/DE:
- buena comprensión del dominio y arquitectura aplicada;
- capacidad para elegir correctamente la tecnología de base de datos adecuada según la tarea establecida;
- capacidad para seleccionar el método óptimo de implementación de la tecnología elegida considerando las restricciones existentes;
- capacidad para realizar la transferencia y migración de datos;
- capacidad para implementar y operar soluciones elegidas.
El siguiente ejemplo basado en GCP demuestra cómo se lleva a cabo la elección de una tecnología para trabajar con datos según su estructura:
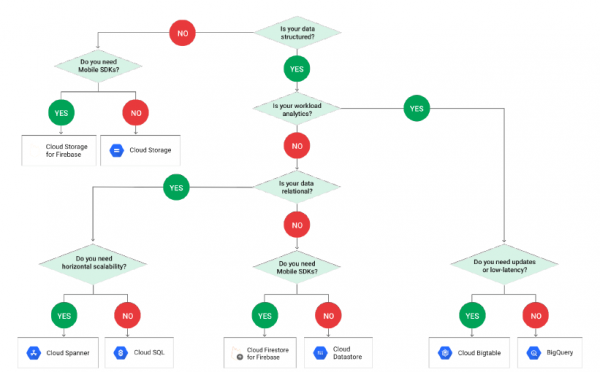
Tenga en cuenta que PostgreSQL no aparece en el esquema, porque se oculta bajo la terminología de Cloud SQL. Y cuando llegamos a Cloud SQL, debemos hacer otra elección:
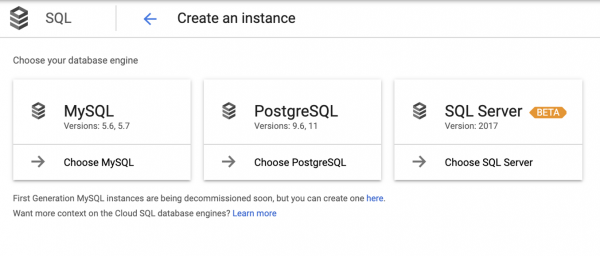
Cabe señalar que esta elección no siempre es clara, por lo que los desarrolladores de aplicaciones a menudo se guían por la intuición.
Total:
- Cuanto más lejos, más relevante se vuelve la cuestión de la elección. Y aunque solo se mire a GCP, servicios administrados y SaaS, alguna mención de RDBMS aparece solo en el cuarto paso (y allí está Spanner al lado). Además, la elección de PostgreSQL solo aparece en el quinto paso, y allí están MySQL y SQL Server, es decir, hay muchas opciones, pero hay que elegir.
- No se puede olvidar las limitaciones frente a las tentaciones. En general, todos quieren Spanner, pero es caro. En definitiva, una consulta típica se ve más o menos así: «Por favor, háganos Spanner, pero al precio de Cloud SQL, ¡ustedes son profesionales!»
¿Y qué hacer?
Sin pretender tener la verdad absoluta, digamos lo siguiente:
Es necesario cambiar el enfoque del aprendizaje:
- no tiene sentido enseñar como se enseñaba antes a los DBA;
- conocer un solo producto ahora ya no es suficiente;
- y conocer decenas al nivel de uno es imposible.
Es necesario conocer no solo el producto, sino también:
- el caso de uso de su aplicación;
- los diferentes métodos de despliegue;
- las ventajas y desventajas de cada método;
- productos similares y alternativos, para hacer una elección consciente y óptima y no siempre a favor del producto conocido.
Además, es necesario saber migrar datos y comprender los principios básicos de integración con ETL.
Caso real
Recientemente, se tuvo que desarrollar un backend para una aplicación móvil. En el momento en que se comenzó a trabajar en él, el backend ya estaba desarrollado y listo para la implementación, y el equipo de desarrolladores había dedicado alrededor de dos años a este proyecto. Se establecieron las siguientes tareas:
- construir CI/CD;
- realizar revisión de la arquitectura;
- poner todo esto en producción.
La aplicación en sí era microservicios, y el código en Python/Django fue desarrollado desde cero y directamente en GCP. En cuanto al público objetivo, se supuso que habría dos regiones: EE. UU. y UE, y el tráfico se distribuía a través del balanceador de carga global. Todas las cargas de trabajo y la carga computacional funcionaban en Google Kubernetes Engine.
En cuanto a los datos, había 3 estructuras:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
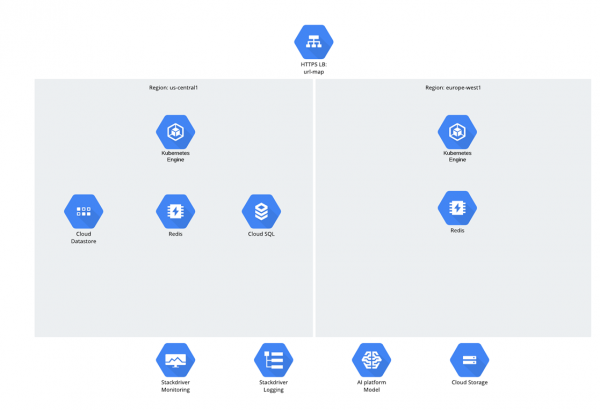
Puede surgir la pregunta de por qué se eligió Cloud SQL. A decir verdad, tal pregunta en los últimos años provoca una especie de pausa incómoda: da la sensación de que la gente ha comenzado a sentirse avergonzada de las bases de datos relacionales, ¡pero aun así continúan usándolas activamente! ;-).
En cuanto a nuestro caso, se eligió Cloud SQL por las siguientes razones:
- Como se mencionó, la aplicación fue desarrollada con Django, y contiene un modelo que muestra datos persistentes de una base de datos SQL en objetos de Python (Django ORM).
- El propio framework soportaba una lista bastante limitada de sistemas de gestión de bases de datos:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Por lo tanto, elegimos PostgreSQL de esta lista más por intuición (no se iba a elegir Oracle, la verdad).
Lo que faltaba:
- la aplicación estaba desplegada solo en 2 regiones, y estaba en planes añadir una tercera (Asia);
- la base de datos estaba ubicada en la región norteamericana (Iowa);
- había preocupaciones por parte del cliente sobre posibles retrazos en el acceso desde Europa y Asia y interrupciones en el servicio en caso de un tiempo de inactividad de la base de datos.
Aunque Django puede trabajar con varias bases de datos de manera paralela y dividirlas entre lectura y escritura, no había tantas grabaciones en la aplicación (más del 90 % eran lecturas). En general, si se pudiera hacer una réplica de lectura de la base de datos principal en Europa y Asia,sería una solución comprometida. Pero, ¿qué tiene de complicado?
La complejidad radicaba en que el cliente no quería renunciar al uso de servicios gestionados y Cloud SQL. Las capacidades de Cloud SQL en este momento son limitadas. Cloud SQL soporta alta disponibilidad (HA) y réplica de lectura (RR), pero la misma RR se soporta solo en una región. Al crear la base de datos en la región americana, no es posible hacer una réplica de lectura en la región europea utilizando las herramientas de Cloud SQL, aunque PostgreSQL no lo impida. La correspondencia con empleados de Google no llevó a nada y terminó en promesas del tipo "sabemos del problema y estamos trabajando en ello, algún día se resolverá".
Si enumeramos las capacidades de Cloud SQL de forma resumida, se vería algo así:
1. Alta disponibilidad (HA):
- dentro de una región;
- mediante replicación de discos;
- no se utilizan mecanismos de PostgreSQL;
- posible gestión automática y manual — failover/failback;
- durante el cambio, la base de datos no está disponible durante unos minutos.
2. Réplica de lectura (RR):
- dentro de una región;
- hot standby;
- replicación en streaming de PostgreSQL.
Además, como es habitual, al elegir una tecnología siempre te enfrentas a alguna limitación.:
- el cliente no quería crear entidades y usar IaaS, salvo a través de GKE;
- el cliente no querría desplegar PostgreSQL/MySQL de autoservicio;
- De hecho, Google Spanner sería bastante adecuado, si no fuera por su precio, aunque con él Django ORM no puede trabajar, pero es una buena herramienta.
Dada la situación, el cliente planteó una pregunta complicada: «¿Pueden hacer algo similar, que funcione como Google Spanner, pero que también sea compatible con Django ORM?»
Opción de solución nº 0
Lo primero que se me ocurrió fue:
- permanecer en el marco de CloudSQL;
- no habrá replicación integrada entre regiones de ninguna manera;
- intentar conectar una réplica a la instancia existente de Cloud SQL by PostgreSQL;
- en algún lugar y de alguna manera lanzar una instancia de PostgreSQL, pero al menos no tocar el master.
Lamentablemente, resultó que no se podía hacer, ya que no hay acceso al host (está en otro proyecto) — pg_hba y demás, y además no hay acceso como superusuario.
Opción de solución nº 1
Después de más reflexiones y teniendo en cuenta las circunstancias anteriores, la línea de pensamiento cambió un poco:
- aún intentamos permanecer en el marco de CloudSQL, pero cambiamos a MySQL, ya que Cloud SQL by MySQL tiene un master externo, que:
— es un proxy para MySQL externo;
— se presenta como una instancia de MySQL;
— fue diseñado para migrar datos de otras nubes o On-premises.
Dado que la configuración de replicación de MySQL no requiere acceso al host, en principio todo funcionaba, pero era muy inestable y poco práctico. Y al avanzar, se volvió aún más aterrador, ya que estábamos desplegando toda la estructura con terraform, y de repente resultó que el master externo no era compatible con terraform. Sí, Google tiene CLI, pero por alguna razón aquí también todo funcionaba de manera intermitente — a veces se creaba, a veces no. Tal vez porque CLI fue diseñado para migrar datos externamente y no para réplicas.
En realidad, en este punto quedó claro que Cloud SQL no es adecuado en absoluto. Como se suele decir, hicimos todo lo que pudimos.
Opción de solución nº 2
Como no pudimos permanecer en el marco de Cloud SQL, intentamos formular los requisitos para una solución de compromiso. Los requisitos resultaron ser los siguientes:
- trabajar en Kubernetes, maximizando el uso de recursos y capacidades de Kubernetes (DCS, ...) y GCP (LB, ...);
- ausencia de lastre de un montón de cosas innecesarias en la nube como HA proxy;
- posibilidad de ejecutar HA PostgreSQL o MySQL en la región principal; en las otras regiones — HA del RR de la región principal más su copia (para fiabilidad);
- multi master (no quería conectarme a él, pero no era muy crítico)
.
Como resultado de estos requisitos, por fin apareció un horizonte popciones adecuadas de SGBD y enlace:
- MySQL Galera;
- CockroachDB;
- herramientas de PostgreSQL
:
— pgpool-II;
— Patroni.
MySQL Galera
La tecnología MySQL Galera fue desarrollada por Codership y es un plugin para InnoDB. Características:
- multi maestro;
- replicación sincronizada;
- lectura desde cualquier nodo;
- escritura en cualquier nodo;
- mecanismo de HA integrado;
- existe un Helm chart de Bitnami.
CockroachDB
De acuerdo con la descripción, es una herramienta absolutamente impresionante y se presenta como un proyecto de código abierto, escrito en Go. El principal participante es Cockroach Labs (fundada por ex-empleados de Google). Este SGBD relacional fue creado para ser distribuido (con escalabilidad horizontal 'de fábrica') y tolerante a fallos. Sus autores han establecido como objetivo 'combinar la riqueza de la funcionalidad SQL con la disponibilidad horizontal, habitual en soluciones NoSQL'.
Como un agradable bono, admite el protocolo de conexión de PostgreSQL.
Pgpool
Es una capa sobre PostgreSQL, de hecho, una nueva entidad que acepta todas las conexiones y las gestiona. Tiene su propio balanceador de carga y parser, y está licenciada bajo la licencia BSD. Ofrece amplias posibilidades, pero puede parecer algo intimidante, ya que la existencia de una nueva entidad podría ser fuente de algunas aventuras adicionales.
Patroni
Esto es lo último que llamó mi atención y, como resultó, no sin razón. Patroni es una utilidad de código abierto que, en esencia, es un demonio en Python que permite gestionar automáticamente clústeres de PostgreSQL con diversos tipos de replicación y conmutación automática de roles. Resultó ser muy interesante, ya que se integra bien con Kubernetes y no introduce ninguna nueva entidad.
Entonces, ¿qué elegimos al final?
La elección no fue fácil:
- CockroachDB — está bien, pero es arriesgado;
- MySQL Galera — también está bien, se utiliza en muchos lugares, pero MySQL;
- Pgpool — muchas entidades innecesarias, integración regular con la nube y K8s;
- Patroni — excelente integración con K8s, sin entidades innecesarias, se integra bien con GCP LB.
Así, la decisión se tomó por Patroni.
Conclusiones
Ha llegado el momento de resumir brevemente. Sí, el mundo de la infraestructura de TI ha cambiado significativamente, y esto es solo el comienzo. Y si antes las nubes eran solo otro tipo de infraestructura, ahora todo es diferente. Además, las innovaciones en la nube están apareciendo constantemente, seguirán apareciendo y, quizás, solo aparecerán en la nube y, posteriormente, a través de startups, serán trasladadas a On-premises.
En cuanto a SQL, SQL seguirá existiendo. Esto significa que es necesario conocer PostgreSQL y MySQL y saber trabajar con ellos, pero aún más importante es saber aplicar correctamente estas herramientas.
Fuente: habr.com
