

Si al principio de la obra mencionas que hay un código en C++ colgado en la pared, al final debe dispararte en el pie.
Bjarne Stroustrup
Del 31 de octubre al 1 de noviembre se celebró en San Petersburgo la conferencia C++ Rusia Piter, una de las conferencias más importantes sobre programación en Rusia, organizada por JUG Ru Group. Entre los ponentes invitados se encontraban miembros del comité de estandarización de C++, oradores de CppCon, autores de libros de la editorial O'Reilly, así como mantenedores de proyectos como LLVM, libc++ y Boost. La conferencia está diseñada para desarrolladores experimentados en C++ que desean profundizar su experiencia y compartir saberes en un entorno de interacción. Los estudiantes, posgraduados y docentes universitarios reciben descuentos muy atractivos.
La edición moscovita de la conferencia se podrá visitar en abril del próximo año, mientras tanto nuestros estudiantes contarán lo que encontraron interesante en el evento reciente.
Foto de
Sobre nosotros
Este post fue trabajado por dos estudiantes de la Escuela Superior de Economía de San Petersburgo:
- Liza Vasilenko - estudiante de cuarto año de la licenciatura, cursando la especialidad en "Lenguajes de programación" dentro del programa de "Matemáticas aplicadas e informática". Tras conocer el lenguaje C++ en su primer año en la universidad, adquirió experiencia trabajando con él en prácticas en la industria. Su pasión por los lenguajes de programación en general y la programación funcional en particular influyó en la selección de las charlas en la conferencia.
- Danya Smirnov - estudiante de primer año de la maestría en "Programación y análisis de datos". Ya en la escuela escribió problemas de olimpiadas en C++, y luego, de alguna manera, el lenguaje apareció constantemente en su actividad escolar y al final se convirtió en su herramienta de trabajo principal. Decidió participar en la conferencia para mejorar sus conocimientos y también para conocer nuevas oportunidades.
En la newsletter, la dirección de la facultad suele compartir información sobre eventos educativos relacionados con nuestra especialidad. En septiembre vimos información sobre C++ Rusia y decidimos registrarnos como oyentes. Esta es nuestra primera experiencia participando en conferencias similares.
Estructura de la conferencia
Presentaciones
Durante dos días, los expertos leyeron 30 informes, abordando muchos temas candentes: usos ingeniosos de las características del lenguaje para resolver problemas prácticos, las próximas actualizaciones del lenguaje debido a un nuevo estándar, compromisos en el diseño de C++ y precauciones al trabajar con sus consecuencias, ejemplos de arquitecturas de proyectos interesantes y algunos detalles bajo el capó de la infraestructura del lenguaje. Simultáneamente, se llevaron a cabo tres presentaciones, generalmente dos en ruso y una en inglés.
Zonas de discusión
Después de las presentaciones, todas las preguntas no respondidas y las discusiones inconclusas se trasladaron a zonas de comunicación especialmente designadas con los ponentes, equipadas con pizarras. Una buena forma de pasar el tiempo entre presentaciones en una conversación amena.
Charlas relámpago y discusiones informales
Si te apetece hacer una presentación corta, puedes inscribirte en la pizarra para una charla relámpago por la noche y obtener cinco minutos para hablar sobre cualquier cosa relacionada con el tema de la conferencia. Por ejemplo, una rápida introducción a los sanitizers para C++ (algo novedoso para algunos) o una historia sobre un error en la generación de una senoide que solo se puede escuchar, pero no ver.
Otro formato fue el panel de discusión "Con el comité al alma". En el escenario, algunos miembros del comité de estandarización y, en la proyección, una chimenea (oficialmente, para crear una atmósfera acogedora, pero la razón "porque TODO ESTÁ EN LLAMAS" parece más divertida), las preguntas sobre el estándar y la visión general de C++, sin acaloradas discusiones técnicas ni conflictos. Resultó que en el comité también hay personas reales que pueden no estar completamente seguras de algo o no saber ciertas cosas.
Para los amantes de los debates, había otro evento: la sesión BOF "Go contra C++". Tomamos a un amante de Go, a un amante de C++, y antes de la sesión, juntos preparan 100500 diapositivas sobre el tema (como los problemas con los paquetes en C++ o la falta de generics en Go), y luego discuten animadamente entre ellos y con la audiencia, que intenta entender dos puntos de vista al mismo tiempo. Si comienza un debate sin sentido, el moderador interviene y reconcilia a las partes. Este formato es adictivo: algunas horas después de su inicio, solo se había cubierto la mitad de las diapositivas. El final tuvo que acelerarse mucho.
Stands de los socios
En los vestíbulos se presentaron los socios de la conferencia: en los stands se hablaba de proyectos actuales, se ofrecían prácticas y empleo, se realizaban cuestionarios y pequeñas competiciones, así como se sorteaban premios agradables. Algunas empresas incluso ofrecían pasar las primeras etapas de las entrevistas, lo que puede ser útil para aquellos que no solo vinieron a escuchar las presentaciones.
Detalles técnicos de las presentaciones
Escuchamos las presentaciones durante ambos días. A veces era difícil elegir una presentación entre las que se llevaban a cabo simultáneamente; decidimos separarnos y compartir los conocimientos adquiridos durante los descansos. Incluso así, parece que mucho ha quedado sin explorar. Aquí nos gustaría contar sobre el contenido de algunas presentaciones que nos parecieron más interesantes.
Excepciones en C++ a través de la óptica de las optimizaciones del compilador, Roman Rusiayev
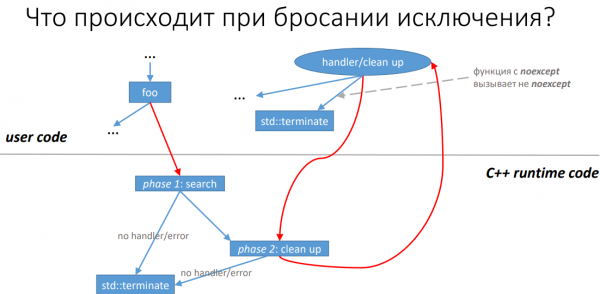
Diapositiva de
Como se deduce del título, Roman analizó el trabajo con excepciones usando LLVM como ejemplo. Sin embargo, para aquellos que no utilizan Clang en su trabajo, la presentación aún puede ofrecer una idea de cómo el código puede ser potencialmente optimizado. Esto se debe a que los desarrolladores de compiladores y las bibliotecas estándar correspondientes se comunican entre sí, y muchas soluciones exitosas pueden coincidir.
Así que, para manejar una excepción, se requiere realizar múltiples acciones: invocar el código de manejo (si lo hay) o liberar recursos en el nivel actual y desenrollar la pila hacia arriba. Todo esto lleva a que, para las llamadas que pueden generar excepciones, el compilador agrega instrucciones adicionales. Por lo tanto, si en efecto no se genera una excepción, el programa aún empezará a realizar acciones innecesarias. Para reducir los costos, LLVM tiene varias heurísticas para determinar situaciones en las que no es necesario agregar código de manejo de excepciones o donde se puede reducir la cantidad de 'instrucciones innecesarias'.
El presentador examina alrededor de una docena de ellas y muestra tanto situaciones en las que ayudan a acelerar la ejecución del programa como aquellas en las que esos métodos no son aplicables.
De este modo, Roman Rusiayev conduce a los oyentes a la conclusión de que el código que contiene trabajo con excepciones no siempre se puede ejecutar sin costos. Y ofrece los siguientes consejos:
- Al desarrollar bibliotecas, es recomendable renunciar a las excepciones en principio;
- si las excepciones son realmente necesarias, se deben añadir modificadores noexcept (y const) siempre que sea posible, para que el compilador pueda optimizar tanto como sea posible.
En general, el ponente confirmó la opinión de que las excepciones se deben usar lo menos posible o incluso renunciar a ellas por completo.
Las diapositivas de la presentación están disponibles en el siguiente enlace:
Generadores, corutinas y otras dulzuras que desafían la mente, Adi Shavit
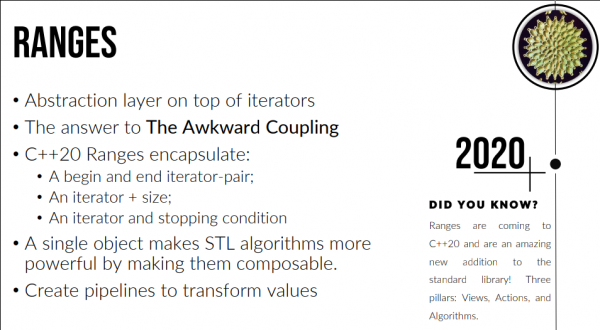
Diapositiva de
Una de las muchas charlas de esta conferencia, dedicada a las innovaciones de C++20, se destacó no solo por su presentación visualmente atractiva, sino también por la clara identificación de los problemas existentes con la lógica de procesamiento de colecciones (bucles for, callbacks).
Adi Shavit destaca lo siguiente: los métodos actuales procesan la colección por completo y al mismo tiempo no permiten el acceso a un cierto estado interno intermedio (o permiten en el caso de los callbacks, pero con muchos efectos secundarios desagradables, como el Callback Hell). Aparentemente, existen iteradores, pero incluso con ellos no es tan sencillo: no hay puntos de entrada y salida comunes (begin → end en contra de rbegin → rend, etc.), y no está claro cuánto tiempo vamos a iterar. ¡A partir de C++20, estos problemas se resolverán!
La primera opción: ranges. Al envolver iteradores, obtenemos una interfaz común para el inicio y el final de la iteración, así como la capacidad de composición. Todo esto permite construir fácilmente canales completos de procesamiento de datos. Pero no todo es tan sencillo: parte de la lógica de los cálculos se encuentra dentro de la implementación de un iterador específico, lo que puede complicar la comprensión y depuración del código.
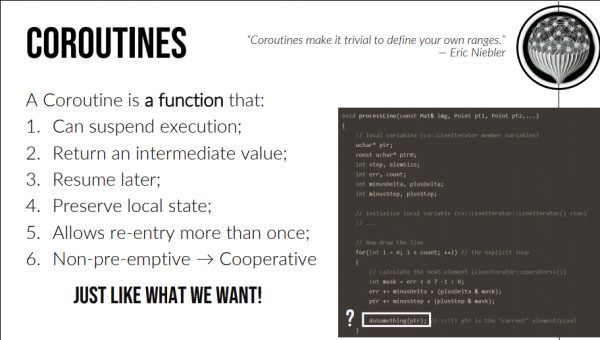
Diapositiva de
Bueno, para este caso, C++20 ha añadido corutinas (funciones cuyo comportamiento es similar a los generadores en Python): la ejecución se puede retrasar, devolviendo un cierto valor actual y preservando el estado intermedio. De esta manera, logramos no solo trabajar con datos a medida que aparecen, sino también encapsular toda la lógica dentro de una corutina específica.
Pero hay un inconveniente: por el momento, solo están parcialmente apoyados por los compiladores disponibles y no están implementados de manera tan cuidadosa como nos gustaría: por ejemplo, aún no es recomendable usar referencias y objetos temporales en corutinas. Además, hay ciertas restricciones sobre lo que puede ser una corutina, y las funciones constexpr, los constructores/destructores, así como main, no están incluidos en esta lista.
Así, las corutinas abordarán una parte significativa de los problemas relacionados con la simplicidad de la lógica de procesamiento de datos, pero sus implementaciones actuales requieren mejoras.
Materiales:
- Diapositivas de C++ Rusia —
Trucos de C++ de Yandex.Taxi, Anton Polukhin
En mi trabajo profesional, a veces tengo que implementar cosas puramente auxiliares: un envoltorio entre la interfaz interna y la API de alguna biblioteca, registro o análisis. En este caso, generalmente no hay necesidad de realizar una optimización adicional. Pero, ¿qué pasa si esos componentes se utilizan en algunos de los servicios más populares de Runet? En tal situación, ¡tendrás que procesar terabytes por hora solo de logs! Entonces, cada milisegundo cuenta y por eso hay que recurrir a varios trucos — de los cuales hablaba Anton Polukhin.
Sin duda, el ejemplo más interesante fue la implementación del patrón pointer-to-implementation (pimpl).
#include <third_party/json.hpp> //PROBLEMS!
struct Value {
    Value() = default;
    Value(Value&& other) = default;
    Value& operator=(Value&& other) = default;
    ~Value() = default;

    std::size_t Size() const { return data_.size(); }

private:
    third_party::Json data_;
};
En este ejemplo, al principio quiero deshacerme de los archivos de encabezado de bibliotecas externas — así se compilará más rápido y se puede proteger contra posibles conflictos de nombres y otros errores similares.
Bien, trasladamos #include al archivo .cpp: se necesita una forward-declaration de la API envuelta, así como std::unique_ptr. Ahora tenemos asignaciones dinámicas y otras cosas desagradables como datos dispersos en el montón y garantías reducidas. Todo esto puede ayudar std::aligned_storage.
struct Value {
// ...
private:
    using JsonNative = third_party::Json;
    const JsonNative* Ptr() const noexcept;
    JsonNative* Ptr() noexcept;

    constexpr std::size_t kImplSize = 32;
    constexpr std::size_t kImplAlign = 8;
    std::aligned_storage_t data_;
};
El único problema: es necesario especificar el tamaño y la alineación para cada envoltura — hagamos nuestro pimpl genérico con parámetros , usémoslo con algunos valores arbitrarios y añadamos en el destructor una verificación de que todo lo hemos adivinado correctamente:
~FastPimpl() noexcept {
    validate();
    Ptr()->~T();
}

template
static void validate() noexcept {
    static_assert(
        Size == ActualSize,
        "El tamaño y sizeof(T) no coinciden"
    );
    static_assert(
        Alignment == ActualAlignment,
        "La alineación y alignof(T) no coinciden"
    );
}
Dado que el destructor T ya está definido al procesar, este código se interpretará correctamente y mostrará los valores necesarios de tamaño y alineación en forma de errores en la etapa de compilación. De este modo, al costo de una compilación adicional, nos libramos de la asignación dinámica de clases envueltas, ocultamos la API en un archivo .cpp con la implementación y obtenemos una estructura más adecuada para la caché del procesador.
El registro y el análisis parecieron menos impresionantes, por lo que no se mencionarán en esta revisión.
Las diapositivas de la presentación están disponibles en el siguiente enlace:
Técnicas modernas para mantener tu código DRY, Björn Fahller
En esta charla, Björn Fahller muestra varias formas de lidiar con un defecto estilístico como las verificaciones de condiciones repetidas:
assert(a == IDLE || a == CONNECTED || a == DISCONNECTED);¿Te suena familiar? Usando algunas poderosas técnicas de C++, introducidas en estándares recientes, se puede implementar elegantemente la misma funcionalidad sin pérdidas de rendimiento. Comparémoslo:
assert(a == any_of(IDLE, CONNECTED, DISCONNECTED));Para manejar un número no fijo de verificaciones, es adecuado utilizar plantillas variádicas y expresiones de plegado. Supongamos que queremos verificar la igualdad de varias variables con un elemento enum llamado state_type. Lo primero que se nos ocurre es escribir una función auxiliar is_any_of:
enum state_type { IDLE, CONNECTED, DISCONNECTED };

template
bool is_any_of(state_type s, const Ts& ... ts) {
    return ((s == ts) || ...);
}
Este resultado intermedio es decepcionante. Hasta ahora, el código no se vuelve más legible:
assert(is_any_of(state, IDLE, DISCONNECTING, DISCONNECTED)); Un poco de ajuste ayudará mediante los parámetros de plantilla no tipo. Con ellos, transferiremos los elementos enumerados del enum a la lista de parámetros de la plantilla:
template
bool is_any_of(state_type t) {
    return ((t == states) | ...);
}

assert(is_any_of(state));
Con el uso de auto en un parámetro de plantilla no tipo (C++17), el enfoque simplemente se generaliza para comparaciones no solo con elementos de state_type, sino también con tipos primitivos que se pueden usar como parámetros de plantilla no tipo:
plantilla <auto ... alternativas, typename T>
bool is_any_of(const T& t) {
    return ((t == alternatives) | ...);
}
A través de estas mejoras consecutivas se logra la sintaxis fluida deseada para las verificaciones:
plantilla <class ... Ts>
struct any_of : private std::tuple<Ts ...> {
// tomémonos la libertad de heredar los constructores de tuple
        using std::tuple<Ts ...>::tuple;
        template <typename T>
        bool operator ==(const T& t) const {
                return std::apply(
                        [&t](const auto& ... ts) {
                                return ((ts == t) || ...);
                        },
                        static_cast<const std::tuple<Ts ...>&>(*this));
        }
};

template <class ... Ts>
any_of(Ts ...) -> any_of<Ts ... >;

assert(any_of(IDLE, DISCONNECTING, DISCONNECTED) == state);
En este ejemplo, la guía de deducción sirve para sugerir los parámetros de plantilla deseados de la estructura al compilador, que conoce los tipos de los argumentos del constructor.
Lo que viene es aún más interesante. Björn enseña cómo generalizar el código resultante para los operadores de comparación más allá de ==, y luego para operaciones arbitrarias. A su vez, se explican características como el atributo no_unique_address (C++20) y los parámetros de plantilla en funciones lambda (C++20) con ejemplos de uso. (Sí, ahora la sintaxis de las lambdas es aún más fácil de recordar: son cuatro pares consecutivos de paréntesis de todo tipo.) La solución final, utilizando funciones como componentes del constructor, calienta mucho mi alma, sin mencionar la expresión de tupla en la mejor tradición del cálculo lambda.
Al final, no olvidemos dar un acabado:
- Recordemos que las lambdas son constexpr de forma gratuita;
- Agreguemos perfect forwarding y veamos su sintaxis poco atractiva en relación con los packs de parámetros en el cierre de las lambdas;
- Demos al compilador más oportunidades para optimizaciones con conditional noexcept;
- Nos ocuparemos de dar salidas de errores más comprensibles en las plantillas gracias a los valores de retorno explícitos de las lambdas. Esto obligará al compilador a realizar más verificaciones antes de la llamada a la función de plantilla, en la etapa de verificación de tipos.
Para más detalles, consulte los materiales de la conferencia:
- Presentaciones del informe:
Nuestras impresiones
Nuestra primera participación en C++ Rusia fue memorable por su intensidad. Se tuvo la impresión de que C++ Rusia es un evento acogedor, donde la línea entre el aprendizaje y la comunicación en vivo es casi imperceptible. Todo, desde la disposición de los ponentes hasta los concursos de los socios del evento, invita a debates animados. La parte sustantiva de la conferencia, que consiste en las presentaciones, abarca un amplio espectro de temas, incluyendo innovaciones en C++, ejemplos de la práctica de grandes proyectos y consideraciones arquitectónicas ideológicas. Pero sería injusto no prestar atención a la componente social del evento, que ayuda a superar las barreras lingüísticas no solo en relación a C++.
Agradecemos a los organizadores de la conferencia por la oportunidad de participar en un evento así.
El post de los organizadores sobre el pasado, presente y futuro de C++ Rusia lo pudiste ver .
¡Gracias por leer, y esperamos que nuestro resumen de los eventos haya sido útil!
Fuente: habr.com
