

Me encontré con una tarea del siguiente tipo. Es necesario implementar un contenedor de almacenamiento de datos que brinde la siguiente funcionalidad:
- insertar un nuevo elemento
- eliminar un elemento por número de orden
- obtener un elemento por número de orden
- los datos se almacenan de forma ordenada
Los datos se agregan y eliminan constantemente, la estructura debe garantizar una velocidad de trabajo rápida. Al principio intenté implementar algo así utilizando los contenedores estándar de std. Este camino no tuvo éxito y llegó la comprensión de que necesitaba implementar algo por mi cuenta. Lo único que se me ocurrió fue usar un árbol binario de búsqueda. Dado que cumple con el requisito de una rápida inserción, eliminación y almacenamiento de datos de forma ordenada. Solo quedaba pensar en cómo indexar todos los elementos y recalcular los índices cuando el árbol cambia.
struct node_s {
    data_t data;

    uint64_t weight; // peso del nodo

    node_t *left;
    node_t *right;

    node_t *parent;
};
En el artículo habrá más imágenes y teoría que código. El código se podrá ver en el enlace de abajo.
Peso
Para esto, el árbol sufrió una pequeña modificación, se agregó información adicional sobre peso del nodo. El peso de un nodo es el número de descendientes de dicho nodo + 1 (peso de un elemento unitario).
Función para obtener el peso del nodo:
uint64_t bntree::get_child_weight(node_t *node) {
    if (node) {
        return node->weight;
    }

    return 0;
}
Para una hoja, el peso es igual a 0.
A continuación, pasemos a la representación visual de un ejemplo de tal árbol. En negro se mostrará la clave del nodo (no se mostrará el valor, ya que no es necesario), en rojo — el peso del nodo, en verde — el índice del nodo.
Cuando el árbol está vacío, su peso es 0. Agreguemos el elemento raíz:
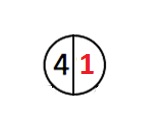
El peso del árbol se convierte en 1, el peso del elemento raíz es 1. El peso del elemento raíz es el peso del árbol.
Agreguemos algunos elementos más:
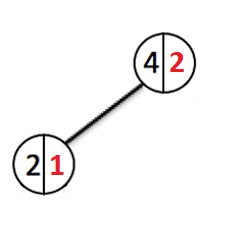
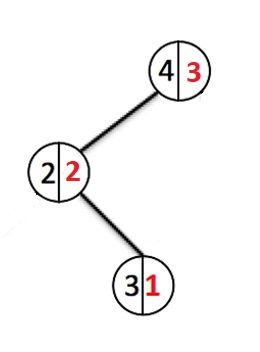
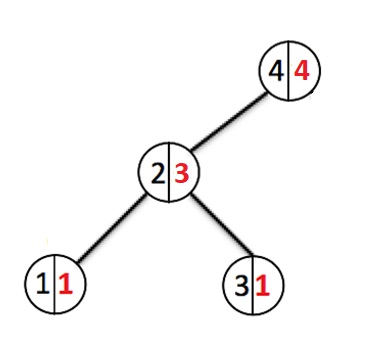
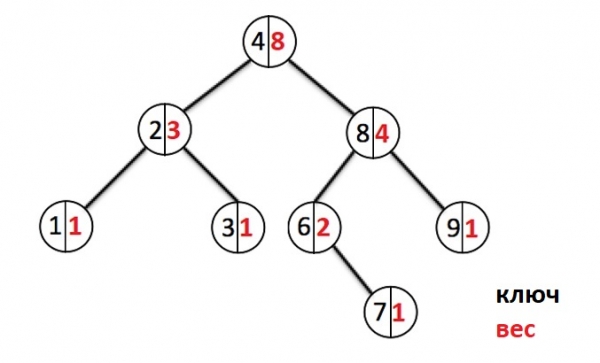
Cada vez que se agrega un nuevo elemento, descendemos por los nodos y aumentamos el contador de peso de cada nodo atravesado. Al crear un nuevo nodo, se le asigna un peso 1. Si ya existe un nodo con esa clave, sobrescribimos el valor y regresamos hacia arriba hasta la raíz, cancelando los cambios de pesos en todos los nodos que hemos pasado.
Si se elimina un nodo, descendemos y decrementamos los pesos de los nodos atravesados.
Índices
Ahora pasemos a cómo indexar los nodos. Los nodos no almacenan explícitamente su índice, se calcula en función del peso de los nodos. Si almacenaran su índice, se requeriría O(n) tiempo para actualizar los índices de todos los nodos después de cada modificación del árbol.
Pasemos a una representación visual. Nuestro árbol está vacío, agreguemos el primer nodo:
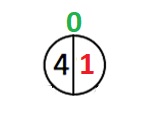
El primer nodo tiene un índice 0, y ahora hay dos casos posibles. En el primero, el índice del elemento raíz cambiará, en el segundo, no cambiará.
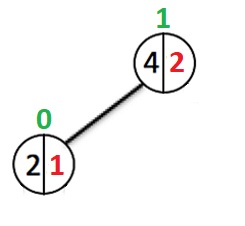
La raíz tiene un subárbol izquierdo que pesa 1.
Segundo caso:
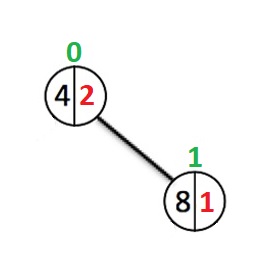
El índice de la raíz no ha cambiado, ya que el peso de su subárbol izquierdo se ha mantenido en 0.
Cómo se calcula el índice de un nodo, es el peso de su subárbol izquierdo más el número que se le pasa desde el padre. ¿Qué número es este?, Es el contador de índices, que inicialmente es 0, ya que la raíz no tiene padre. Luego, todo depende de si descendemos al hijo izquierdo o derecho. Si vamos al izquierdo, no se suma nada al contador. Si vamos al derecho, sumamos el índice del nodo actual.
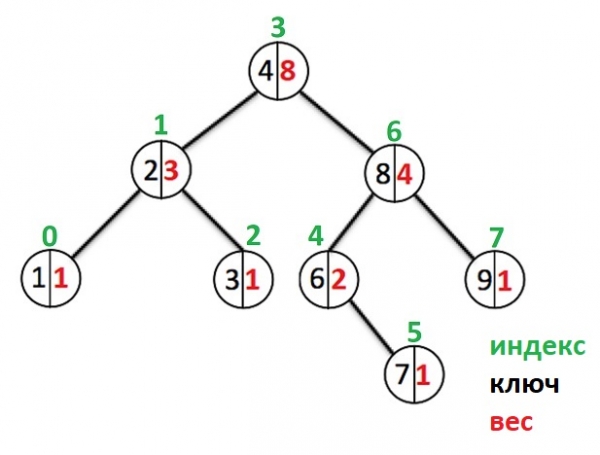
Por ejemplo, cómo se calcula el índice del elemento con clave 8 (hijo derecho de la raíz). Es "Índice de la raíz" + "peso del subárbol izquierdo del nodo con clave 8" + "1" == 3 + 2 + 1 == 6
El índice del elemento con clave 6 será "Índice de la raíz" + 1 == 3 + 1 == 4
Por lo tanto, para obtener o eliminar un elemento por índice se requiere tiempo O(log n), ya que para obtener el elemento necesario primero debemos encontrarlo (descender desde la raíz hasta este elemento).
Profundidad
También se puede calcular la profundidad del árbol en función del peso. Necesaria para el balanceo.
Para ello, el peso del nodo actual debe redondearse al primer número en potencia de 2 que sea mayor o igual al peso dado y tomar el logaritmo binario de este número. De esta manera, obtendremos la profundidad del árbol, bajo la condición de que esté balanceado. El árbol se balancea después de insertar un nuevo elemento. No entraré en la teoría de cómo balancear árboles. La función de balanceo se presenta en los códigos fuente.
Código para ajustar el peso a la profundidad.
/*
 * Возвращает первое число в степени 2, которое больше или ровно x
 */
uint64_t bntree::cpl2(uint64_t x) {
    x = x - 1;
    x = x | (x >> 1);
    x = x | (x >> 2);
    x = x | (x >> 4);
    x = x | (x >> 8);
    x = x | (x >> 16);
    x = x | (x >> 32);

    return x + 1;
}

/*
 * Двоичный логарифм от числа
 */
long bntree::ilog2(long d) {
    int result;
    std::frexp(d, &result);
    return result - 1;
}

/*
 * Вес к глубине
 */
uint64_t bntree::weight_to_depth(node_t *p) {
    if (p == NULL) {
        return 0;
    }

    if (p->weight == 1) {
        return 1;
    } else if (p->weight == 2) {
        return 2;
    }

    return this->ilog2(this->cpl2(p->weight));
}
Resultados
- La inserción de un nuevo elemento ocurre en O(log n)
- la eliminación de un elemento por número ordinal ocurre en O(log n)
- la obtención de un elemento por número ordinal ocurre en O(log n)
Velocidad O(log n) pagamos por el hecho de que todos los datos se almacenan en orden.
No sé dónde puede ser útil tal estructura. Solo es un ejercicio para entender mejor cómo funcionan los árboles. Gracias por su atención.
Enlaces
El proyecto contiene datos de prueba para comprobar la velocidad de operación. El árbol se llena 1000000 de elementos. Y se llevan a cabo eliminaciones, inserciones y obtenciones de elementos de manera secuencial. 1000000 veces. Es decir, 3000000 operaciones. El resultado fue bastante bueno, aproximadamente 8 segundos.
Fuente: habr.com
