

Ante ti está de nuevo la tarea de detección de objetos. La prioridad es la velocidad de trabajo con una precisión aceptable. Utilizas la arquitectura YOLOv3 y la ajustas. La precisión (mAp75) es mayor a 0.95. Pero la velocidad de procesamiento sigue siendo baja. Maldita sea.
Hoy evitaremos la cuantización. Y en el siguiente apartado abordaremos Model Pruning — el recorte de partes redundantes de la red para acelerar la inferencia sin pérdida de precisión. Visualmente, de dónde, cuánto y cómo se puede recortar. Analizaremos cómo hacerlo manualmente y dónde se puede automatizar. Al final, un repositorio en keras.
Introducción
En mi trabajo anterior, en Macroscop de Perm, adquirí un hábito: siempre prestar atención al tiempo de ejecución de los algoritmos. Y el tiempo de procesamiento de las redes siempre se verifica a través de un filtro de adecuación. Por lo general, los últimos avances en producción no superan este filtro, lo que me llevó al Pruning.
El Pruning es un tema antiguo, del que se habló en en 2017. La idea principal es reducir el tamaño de la red entrenada sin pérdida de precisión mediante la eliminación de varios nodos. Suena genial, pero rara vez escucho sobre su aplicación. Probablemente faltan implementaciones, no hay artículos en ruso o simplemente todos consideran el pruning como un secreto y no dicen nada.
Pero vamos a analizarlo.
Una mirada a la biología
Me gusta cuando en Deep Learning se incorporan ideas provenientes de la biología. A ellas, al igual que a la evolución, se les puede confiar (¿sabías que ReLU es muy similar a ?)
El proceso de Model Pruning también se asemeja a la biología. La reacción de la red aquí se puede comparar con la plasticidad del cerebro. Hay un par de ejemplos interesantes en el libro :
- El cerebro de una mujer que nació con solo una mitad reprogramó por sí mismo para cumplir las funciones de la mitad que falta.
- Un chico se disparó en la parte del cerebro responsable de la visión. Con el tiempo, otras partes del cerebro asumieron esas funciones. (no intentamos repetirlo)
Así también se puede recortar parte de las convoluciones débiles de tu modelo. En última instancia, las convoluciones restantes ayudarán a reemplazar las recortadas.
¿Te gusta el Transfer Learning o aprendes desde cero?
Opción número uno. Estás utilizando Transfer Learning en Yolov3. Retina, Mask-RCNN o U-Net. Pero, a menudo, no necesitamos reconocer 80 clases de objetos, como en COCO. En mi experiencia, todo se limita a 1-2 clases. Se puede suponer que la arquitectura para 80 clases aquí es excesiva. Surge la idea de que la arquitectura necesita reducirse. Además, me gustaría hacerlo sin perder los pesos preentrenados existentes.
La opción número dos. Tal vez tengas muchos datos y recursos computacionales o simplemente necesites una arquitectura altamente personalizada. No importa. Pero estás entrenando la red desde cero. El orden habitual es observar la estructura de los datos, seleccionar una arquitectura SOBREDIMENSIONADA en términos de potencia y aplicar dropout para evitar el sobreajuste. He visto dropouts de 0.6, Carl.
En ambos casos, se puede reducir la red. Nos han motivado. Ahora vamos a aclarar qué es la reducción pruning.
Algoritmo general
Hemos decidido que podemos eliminar convoluciones. Esto parece bastante simple:
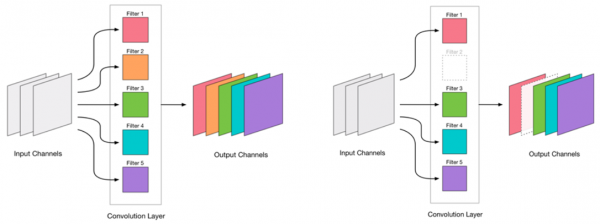
Eliminar cualquier convolución es un estrés para la red, que generalmente conlleva un aumento en el error. Por un lado, este aumento en el error es un indicador de cuán correctamente estamos eliminando las convoluciones (por ejemplo, un gran aumento indica que estamos haciendo algo mal). Pero un pequeño aumento es perfectamente aceptable y a menudo se corrige con un ligero reentrenamiento utilizando un LR bajo. Añadimos un paso de reentrenamiento:
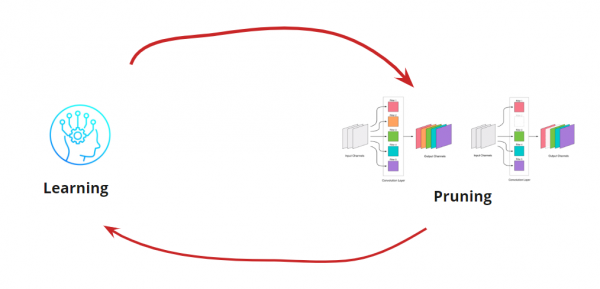
Ahora necesitamos entender cuándo queremos detener nuestro ciclo LearningPruning. Aquí pueden haber variantes exóticas, donde necesitamos reducir la red a un tamaño y velocidad de ejecución específicos (por ejemplo, para dispositivos móviles). Sin embargo, la opción más común es continuar el ciclo hasta que el error supere el umbral permitido. Añadimos una condición:
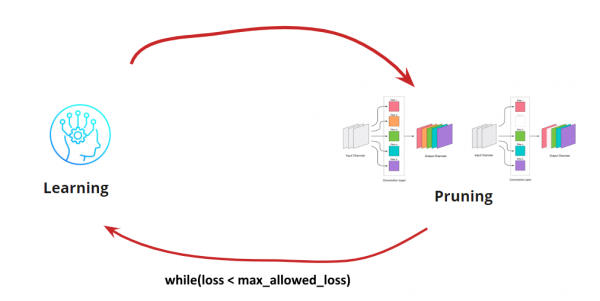
Así que el algoritmo se vuelve claro. Ahora queda desglosar cómo determinar las convoluciones que se eliminarán.
Búsqueda de convoluciones eliminables
Necesitamos eliminar algunas convoluciones. Ir a ciegas y "disparar" cualquier convolución es una mala idea, aunque funcionará. Pero dado que tenemos un cerebro, podemos pensar y tratar de identificar las convoluciones "débilmente" significativas para su eliminación. Hay varias opciones:
- . La idea de que las convoluciones con valores de peso bajos tienen una contribución mínima en la decisión final.
- La menor medida L1 teniendo en cuenta la media y la desviación estándar. Complementado con una evaluación de la naturaleza de la distribución.
- . Definición más precisa de convoluciones insignificantes, pero muy costosa en tiempo y recursos.
- Otros
Cada una de las opciones tiene derecho a existir y sus características de implementación. Aquí consideraremos la opción con la menor medida L1.
Proceso manual para YOLOv3.
La arquitectura original contiene bloques residuales. Pero por muy buenos que sean para redes profundas, nos dificultan un poco. La complicación es que no se pueden eliminar las convoluciones con diferentes índices en estas capas:
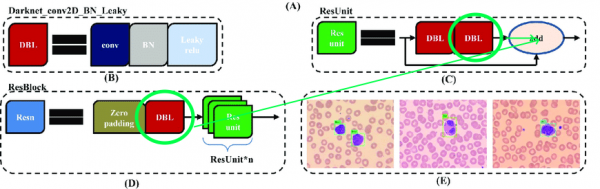
Por lo tanto, identificaremos las capas de las que podemos eliminar libremente las convoluciones:

Ahora construimos un ciclo de trabajo:
- Extracción de activaciones.
- Establecemos cuánto recortar.
- Recortamos.
- Entrenamos durante 10 épocas con LR=1e-4.
- Probamos
Es útil extraer las convoluciones para evaluar qué parte podemos eliminar en un paso determinado. Ejemplos de extracción:
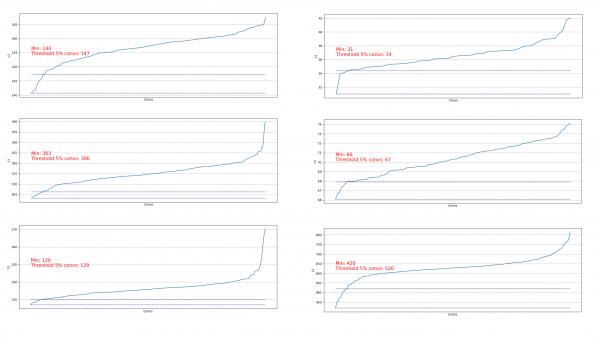
Vemos que prácticamente en todas partes el 5% de las convoluciones tienen una norma L1 muy baja y podemos eliminarlas. En cada paso, se repitió esta extracción y se evaluó de qué capas y cuánto se podía recortar.
Todo el proceso se llevó a cabo en 4 pasos (aquí y en todas partes los números son para RTX 2060 Super):
| Paso | mAp75 | Número de parámetros, millones. | Tamaño de la red, MB. | De la original, % | Tiempo de ejecución, ms. | Condición de recorte. |
|---|---|---|---|---|---|---|
| 0 | 0.9656 | 60 | 241 | 100 | 180 | — |
| 1 | 0.9622 | 55 | 218 | 91 | 175 | 5% de todos. |
| 2 | 0.9625 | 50 | 197 | 83 | 168 | 5% de todos. |
| 3 | 0.9633 | 39 | 155 | 64 | 155 | 15% para capas con más de 400 convoluciones. |
| 4 | 0.9555 | 31 | 124 | 51 | 146 | 10% para capas con más de 100 convoluciones. |
En el paso 2, se agregó un efecto positivo: el tamaño del lote 4 entró en la memoria, lo que aceleró considerablemente el proceso de reentrenamiento.
En el paso 4, el proceso se detuvo, ya que incluso un largo reentrenamiento no elevaba el mAp75 a los antiguos valores.
Al final, se logró acelerar el inferencia en 15%, reducir el tamaño en 35% y no perder precisión.
Automatización para arquitecturas más simples.
Para arquitecturas de red más simples (sin bloques condicionales de adición, concatenación y residuales), es bastante posible orientarse en el procesamiento de todas las capas convolucionales y automatizar el proceso de recorte de convoluciones.
Esta opción la implementé. .
Es simple: solo necesita la función de pérdida, optimizador y generadores de lotes:
import pruning
from keras.optimizers import Adam
from keras.utils import Sequence

train_batch_generator = BatchGenerator...
score_batch_generator = BatchGenerator...

opt = Adam(lr=1e-4)
pruner = pruning.Pruner("config.json", "categorical_crossentropy", opt)

pruner.prune(train_batch, valid_batch)
Si es necesario, se pueden cambiar los parámetros de la configuración:
{
    "input_model_path": "model.h5",
    "output_model_path": "model_pruned.h5",
    "finetuning_epochs": 10, # el número de épocas para entrenar entre los pasos de poda
    "stop_loss": 0.1, # pérdida para detener el proceso
    "pruning_percent_step": 0.05, # parte de las convoluciones a eliminar en cada paso de poda
    "pruning_standart_deviation_part": 0.2 # desplazamiento para limitar la parte de poda
}
Además, se ha implementado una restricción basada en la desviación estándar. El objetivo es limitar la parte eliminada, excluyendo las convoluciones con medidas L1 ya 'suficientes':
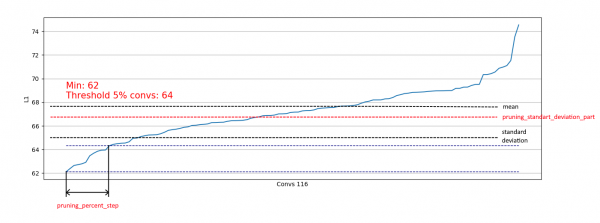
De esta forma, permitimos eliminar solo las convoluciones débiles de distribuciones similares a la derecha y no influir en la eliminación de distribuciones similares a la izquierda:
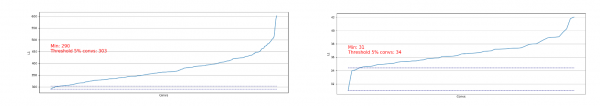
Al acercarse la distribución a la normal, el coeficiente pruning_standart_deviation_part se puede ajustar a:
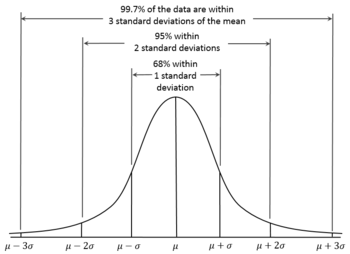
Recomiendo un margen de 2 sigmas. O se puede no considerar esta característica, dejando el valor < 1.0.
Al final se obtiene un gráfico del tamaño de la red, la pérdida y el tiempo de ejecución de la red a lo largo de toda la prueba, normalizados a 1.0. Por ejemplo, aquí el tamaño de la red se redujo casi a la mitad sin pérdida de calidad (una pequeña red convolucional con 100k parámetros):
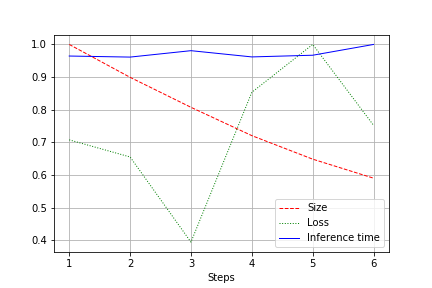
La velocidad de ejecución está sujeta a fluctuaciones normales y prácticamente no ha cambiado. Esto tiene una explicación:
- El número de convoluciones cambia de convenientes (32, 64, 128) a no tan convenientes para las tarjetas gráficas — 27, 51, etc. Aquí podría estar equivocado, pero lo más probable es que esto impacte.
- La arquitectura no es amplia, pero es secuencial. Al reducir el ancho, no tocamos la profundidad. De esta manera, reducimos la carga, pero no cambiamos la velocidad.
Por lo tanto, la mejora se tradujo en una reducción de la carga de CUDA durante la ejecución de 20-30%, pero no en la reducción del tiempo de ejecución.
Resultados
Reflexionemos. Hemos considerado 2 opciones de poda — para YOLOv3 (cuando se tiene que trabajar manualmente) y para redes con arquitecturas más simples. Se observa que en ambos casos se puede lograr una reducción del tamaño de la red y un aumento de la velocidad sin pérdida de precisión. Resultados:
- Reducción de tamaño
- Aceleración de la ejecución
- Reducción de la carga de CUDA
- Como consecuencia, sostenibilidad (Optimizamos el uso futuro de recursos computacionales. En algún lugar, una está contenta )
Anexo
- Después del paso de poda, se puede ajustar la cuantización (por ejemplo, con TensorRT)
- Tensorflow ofrece oportunidades para . Funciona.
- quiero desarrollarme y estaré encantado de recibir ayuda
Fuente: habr.com
