

Se sabe que la competencia de un CTO se verifica solo en el segundo intento de ejercer este rol. Porque es una cosa trabajar varios años en una empresa, evolucionar con ella y, estando en el mismo contexto cultural, asumir gradualmente más responsabilidades. Y es otra muy diferente llegar de inmediato al puesto de director técnico en una empresa con una carga de legado y un montón de problemas que se han barrido cuidadosamente debajo de la alfombra.
En este sentido, la experiencia de Leon Feirer, que compartió en , no es que sea única, pero multiplicada por la antigüedad y la cantidad de diferentes roles que ha desempeñado durante 20 años, es muy útil. A continuación, la cronología de eventos durante 90 días y muchas anécdotas que es agradable reírse cuando les sucede a alguien más, pero con las que no es tan divertido lidiar personalmente.
Leon cuenta de manera muy colorida en ruso, así que si tienes 35-40 minutos, te recomiendo ver el video. La versión textual para ahorrar tiempo está a continuación.
La primera versión del informe era una descripción bien estructurada del trabajo con las personas y los procesos, conteniendo recomendaciones útiles. Pero no transmitió todas las sorpresas que encontré en el camino. Así que cambié el formato y expuse los problemas que surgían ante mí en la nueva empresa, como un génio de la lámpara, y los métodos para resolverlos en orden cronológico.
Un mes antes de
Como muchas buenas historias, esta comenzó con alcohol. Estábamos sentados con conocidos en un bar, y como es habitual en el entorno de los informáticos, cada uno compartía sus problemas. Uno de ellos acaba de cambiar de trabajo y hablaba sobre sus problemas tanto con las tecnologías como con las personas y el equipo. Cuanto más lo escuchaba, más entendía que solo necesitaba contratarme, porque esos eran precisamente los problemas que he resuelto en los últimos 15 años. Se lo dije así, y al día siguiente nos encontramos en un entorno laboral. La empresa se llamaba Teaching Strategies.
Teaching Strategies lidera el mercado de programas educativos para niños muy pequeños, desde el nacimiento hasta los tres años. La empresa tradicional de "papel" lleva funcionando alrededor de 40 años, y la versión digital SaaS de la plataforma tiene 10. Recientemente comenzó el proceso de adaptación de la tecnología digital a los estándares de la empresa. La "nueva" versión se lanzó en 2017 y era casi como la antigua, solo que funcionaba peor.
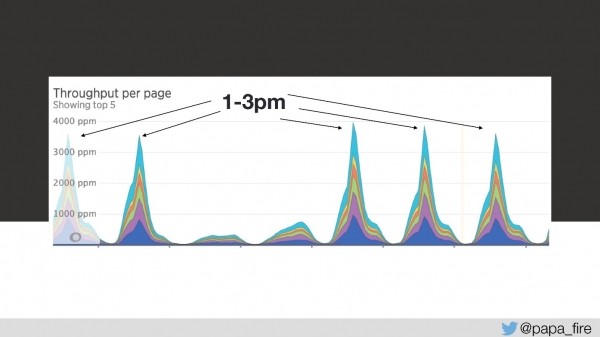
Lo más interesante es que el tráfico de esta empresa es muy predecible: de un día para otro, de un año a otro, se puede prever con mucha claridad cuántas personas vendrán y cuándo. Por ejemplo, entre la 1 y las 3 de la tarde, todos los niños en las guarderías se van a dormir, y los maestros comienzan a ingresar información. Y esto sucede todos los días, excepto los fines de semana, porque casi nadie trabaja en esos días.
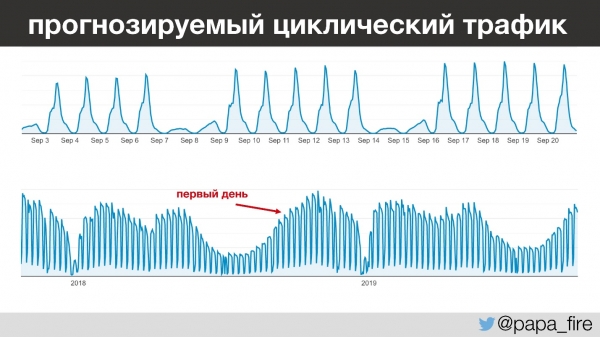
Anticipándome un poco, diré que comencé mi trabajo en el periodo de mayor tráfico anual, lo que es interesante por varias razones.
La plataforma, que parecía tener solo 2 años, tenía un stack peculiar: ColdFusion y SQL Server 2008. ColdFusion, si no lo saben, y probablemente no, es una especie de PHP empresarial que surgió a mediados de los años 90, y desde entonces no he oído hablar de él. También había: Ruby, MySQL, PostgreSQL, Java, Go, Python. Pero el monolito principal funcionaba con ColdFusion y SQL Server.
Problemas
Cuanto más hablaba con los empleados de la empresa sobre el trabajo y los problemas que encontraban, más comprendía que los problemas no eran solo de carácter técnico. Vale, la tecnología es antigua, y hemos trabajado con cosas peores, pero había problemas con el equipo y los procesos, y la empresa empezaba a darse cuenta de ello.
Tradicionalmente, los técnicos estaban en un rincón ocupándose de su propio trabajo. Pero cada vez más negocios comenzaron a pasar por la versión digital. Por lo tanto, en el año anterior al inicio de mi trabajo, surgieron nuevos roles: junta directiva, CTO, CPO y director de QA. Es decir, la empresa comenzó a invertir en el ámbito tecnológico.
Las huellas de un legado complicado no solo estaban en los sistemas. En la empresa había procesos legacy, personas legacy, cultura legacy. Todo esto necesitaba un cambio. Pensé que definitivamente no me iba a aburrir, así que decidí intentarlo.
Dos días antes de
Dos días antes de comenzar el nuevo trabajo, llegué a la oficina, llené los últimos documentos, conocí al equipo y descubrí que en ese momento el equipo estaba lidiando con un problema. Consistía en que el tiempo de carga promedio de las páginas había saltado a 4 segundos, es decir, se duplicó.
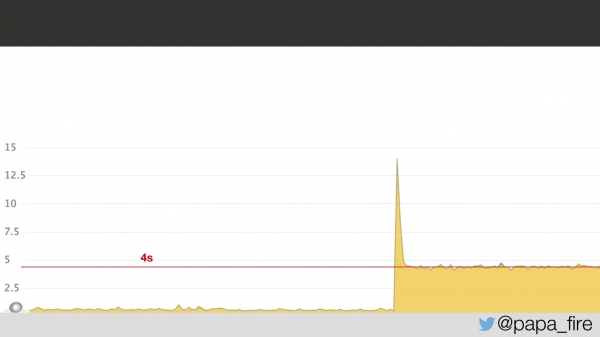
A juzgar por el gráfico, claramente algo había ocurrido, pero no estaba claro qué. Resultó que el problema estaba en la latencia de la red en el centro de datos: 5 ms de latencia en el centro de datos se transformaron en 2 segundos para los usuarios. No sabía por qué había sucedido, pero en cualquier caso se supo que el problema estaba en el centro de datos.
Día uno
Han pasado dos días y en mi primer día de trabajo descubrí que el problema no se había solucionado.
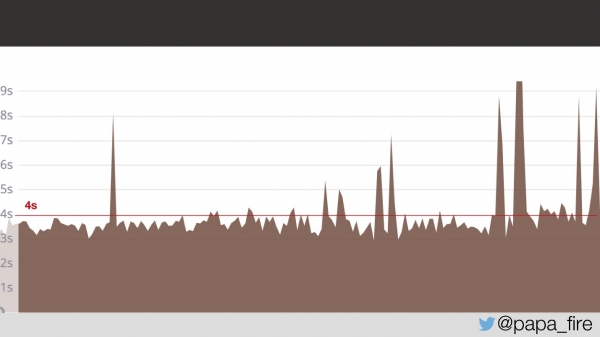
Durante dos días, las páginas se cargaban en promedio en 4 s. Pregunté si habían encontrado el problema.
— Sí, abrimos un ticket.
— ¿Y?
— Bueno, aún no nos han respondido.
En ese momento entendí que todo lo que me habían contado anteriormente era solo la pequeña punta del iceberg con la que había que lidiar.
Hay una buena cita que se adapta muy bien a esta situación:
«A veces, para cambiar la tecnología, se necesita cambiar la organización».
Pero como comencé a trabajar en el momento más ocupado del año, era necesario considerar ambas opciones para resolver el problema: la rápida y la a largo plazo. Y empezar por lo que era crítico en ese momento.
Día tres
Así que la carga dura 4 segundos, y de 13 a 15 son los picos más altos.
En el tercer día, durante ese intervalo, la velocidad de carga era así:
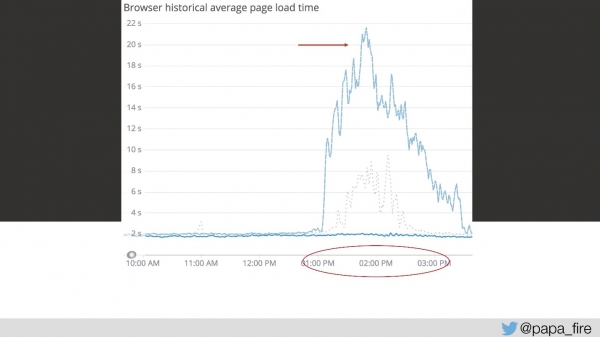
Desde mi punto de vista, nada funcionaba. Desde el punto de vista de los demás, funcionaba un poco más lento de lo habitual. Pero eso no puede ser casual — es un problema serio.
Intenté convencer al equipo, a lo que me respondieron que simplemente necesitábamos más servidores. Esa, por supuesto, es una solución al problema, pero no siempre es la única y más efectiva. Pregunté por qué no había suficientes servidores, cuál era el volumen de tráfico. Extrapolando datos, concluí que teníamos aproximadamente 150 solicitudes por segundo, lo cual, en principio, está dentro de límites razonables.
Pero hay que recordar que antes de obtener la respuesta correcta, hay que formular la pregunta correcta. Mi siguiente pregunta fue: ¿cuántos servidores frontend tenemos? La respuesta me «dejó un poco perplejo» — ¡teníamos 17 servidores frontend!
— Me atrevo a preguntar, ¿150 dividido por 17 da aproximadamente 8? ¿Quiere decir que cada servidor maneja 8 solicitudes por segundo, y si mañana hubiera 160 solicitudes por segundo, necesitaríamos 2 servidores más?
Por supuesto, no necesitábamos servidores adicionales. La solución estaba en el código mismo, y era evidente:
var currentClass = classes.getCurrentClass();
return currentClass;
Había una función getCurrentClass(), porque todo en el sitio web funciona en el contexto de una clase — correcto. Y esta única función en cada página recibía más de 200 solicitudes.
La solución fue muy simple, ni siquiera había que reescribir nada: simplemente no solicitar la misma información repetidamente.
if ( !isDefined("REQUEST.currentClass") ) {
    var classes = new api.private.classes.base();
   REQUEST.currentClass = classes.getCurrentClass();
}
return REQUEST.currentClass;
Me alegré mucho porque pensé que solo en el tercer día había encontrado el problema principal. Qué ingenuo fui, era solo uno de muchos problemas.
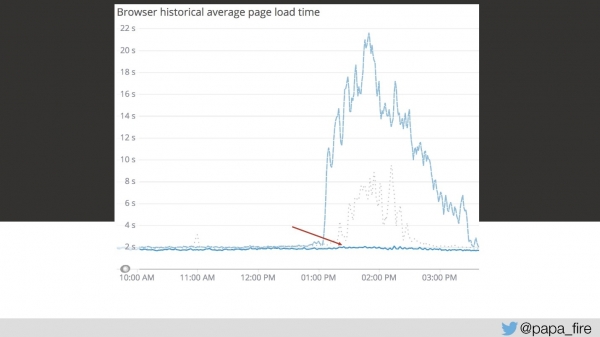
Pero la solución de este primer problema llevó el cronograma mucho más abajo.
Al mismo tiempo, estábamos trabajando en otras optimizaciones. Había muchas cosas visibles que podían ser reparadas. Por ejemplo, en ese mismo tercer día descubrí que había caché en el sistema (al principio pensé que todas las solicitudes iban directamente de la base de datos). Cuando pienso en caché, imagino Redis o Memcached estándar. Pero solo yo pensaba así, porque para el almacenamiento en caché en ese sistema se usaban MongoDB y SQL Server, el mismo del cual recientemente habíamos leído los datos.
Día diez
La primera semana estuve lidiando con problemas que necesitaban solución inmediata. Alrededor de la segunda semana asistí por primera vez a un standup para interactuar con el equipo, ver qué estaba pasando y cómo avanzaba todo el proceso.
De nuevo surgió algo interesante. El equipo estaba formado por: 18 desarrolladores; 8 testers; 3 gerentes; 2 arquitectos. Y todos participaban en los rituales comunes, es decir, más de 30 personas asistían a la reunión cada mañana y contaban lo que habían estado haciendo. Está claro que la reunión no duraba 5 ni 15 minutos. Nadie escuchaba a nadie, ya que todos trabajaban en diferentes sistemas. En esa forma, 2-3 tickets por hora en la sesión de grooming ya eran un buen resultado.
Lo primero que hicimos fue dividir el equipo en varios según las líneas de productos. Para diferentes secciones y sistemas, formamos equipos separados que incluían desarrolladores, testers, gerentes de producto y analistas de negocio.
Como resultado, obtuvimos:
- Reducción de standups y reuniones.
- Conocimiento del producto.
- Sentido de pertenencia. Cuando antes las personas rotaban constantemente entre sistemas, sabían que probablemente tendrían que trabajar en sus propios errores, pero no ellos mismos.
- Colaboración entre grupos. No es necesario decir que el QA no se comunicaba mucho con los programadores, el product estaba haciendo su propio trabajo, etc. Ahora tienen un punto de responsabilidad compartido.
Principalmente nos enfocamos en la eficiencia, el rendimiento y la calidad; esos eran precisamente los problemas que tratamos de resolver mediante la transformación del equipo.
Día once
En el proceso de cambiar la estructura del equipo, descubrí cómo cuentan HistoriaPuntos. 1 SP equivalía a un día, y cada ticket tenía SP tanto para desarrollo como para QA, es decir, al menos 2 SP.
¿Cómo lo descubrí?
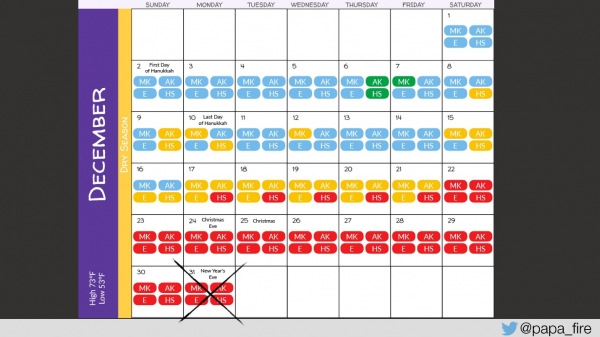
Encontramos un bug: en uno de los informes donde se introduce la fecha de inicio y fin del período requerido, no se considera el último día. Es decir, en algún lugar de la consulta estaba <, en lugar de <=. Me dijeron que esto equivalía a tres Story Points, es decir, 3 días.
Después de eso nosotros:
- Revisamos el sistema de evaluación de Story Points. Ahora la corrección de pequeños bugs, que se pueden pasar rápidamente por el sistema, llega más rápido al usuario.
- Empezamos a agrupar tickets relacionados para desarrollo y pruebas. Antes, cada ticket, cada bug era un ecosistema cerrado, no vinculado a nada más. Cambiar tres botones en una página podría ser tres tickets diferentes con tres procesos de QA distintos en lugar de una sola prueba automática en la página.
- Comenzamos a trabajar con los desarrolladores en el enfoque para evaluar el esfuerzo. Tres días para cambiar un botón no es gracioso.
Día veinte
Hacia la mitad del primer mes, la situación se estabilizó un poco, entendí lo que estaba sucediendo en general y ya comenzaba a mirar hacia el futuro y pensar en soluciones a largo plazo.
Mantener la compatibilidad con el formato discográfico del repositorio git (sin mantener la compatibilidad con las herramientas);
- Plataforma gestionada. Cientos de solicitudes en cada página — eso no es serio.
- Tendencias predecibles. Hubo picos de tráfico periódicos que a primera vista no correlacionaban con otras métricas — era necesario entender por qué ocurrían y aprender a predecir.
- Expansión de la plataforma. El negocio sigue creciendo, llegan más usuarios, aumenta el tráfico.
En el pasado se solía decir: «¡Reescribamos todo en [lenguaje/framework], todo funcionará mejor!»
En la mayoría de los casos, esto no funciona; es bueno si lo reescrito llega a funcionar. Así que necesitábamos crear un roadmap: una estrategia concreta que ilustre paso a paso cómo se lograrán los objetivos comerciales (qué haremos y por qué), que:
- refleje la misión y los objetivos del proyecto;
- priorice los objetivos principales;
- contenga un cronograma para alcanzarlos.
Hasta ahora, nadie había hablado con el equipo sobre el propósito de cualquier cambio. Para esto, se necesitan indicadores de éxito adecuados. Por primera vez en la historia de la empresa, establecimos KPIs para el grupo técnico, vinculado a los organizacionales.
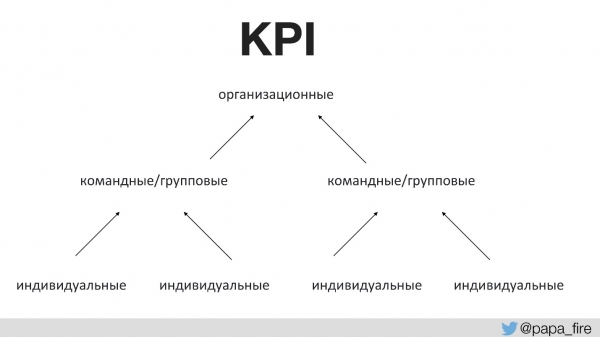
Es decir, los KPIs organizacionales son respaldados por los equipos, y los KPIs de equipo son respaldados por los indicadores individuales. De lo contrario, si los KPIs tecnológicos no coinciden con los organizacionales, cada uno tira del manto para sí.
Por ejemplo, uno de los KPIs organizacionales es aumentar la cuota de mercado a través de nuevos productos.
¿Qué se puede hacer para apoyar el objetivo de tener más productos nuevos?
- En primer lugar, queremos gastar más tiempo desarrollando nuevos productos en lugar de reparar defectos. Es una solución lógica que se puede medir fácilmente.
- En segundo lugar, queremos respaldar el aumento del volumen de transacciones, porque cuanto mayor sea la cuota de mercado, más usuarios habrá y, por lo tanto, más tráfico.
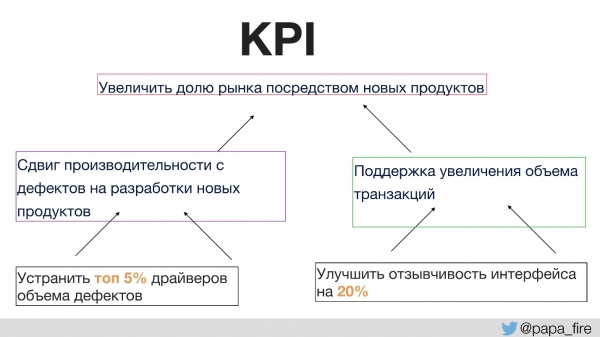
Entonces, los KPIs individuales que pueden ejecutarse dentro del grupo serán, por ejemplo, en el lugar de donde provienen los principales defectos. Si nos enfocamos exactamente en esa sección, se puede hacer que haya muchos menos defectos, lo que aumentará el tiempo para desarrollar nuevos productos y, nuevamente, apoyar los KPIs organizacionales.
Así, cada decisión, incluida reescribir el código, debe respaldar objetivos específicos que la empresa nos ha establecido (crecimiento organizacional, nuevas funciones, contratación de personal).
Durante este proceso, surgió algo interesante que fue una noticia no solo para los técnicos, sino para toda la empresa: todos los tickets deben estar orientados a al menos un KPI. Es decir, si el product manager dice que quiere hacer una nueva característica, la primera pregunta debe ser: “¿Qué KPI respalda esta característica?” Si no hay ninguno, lo siento, parece que es una característica innecesaria.
Día treinta
Al final del mes, descubrí otro matiz: que nadie de mi equipo de Ops jamás había visto los contratos que firmamos con los clientes. Puedes preguntar, ¿por qué es importante ver los contratos?
- En primer lugar, porque en los contratos están especificados los SLA.
- En segundo lugar, los SLA son todos diferentes. Cada cliente venía con sus propios requisitos, y el departamento de ventas firmaba sin mirar.
Otro matiz interesante: en el contrato con uno de los clientes más grandes está escrito que todas las versiones de software que soporta la plataforma deben ser n-1, es decir, no la versión más reciente, sino la penúltima.
Está claro cuán alejados estábamos de n-1, ya que la plataforma estaba en ColdFusion y SQL Server 2008, que dejaron de ser soportados en julio.
Día cuarenta y cinco
Hacia la mitad del segundo mes, tuve suficiente tiempo para sentarme y hacer valuestreammapeo un análisis completo del proceso. Estos son los pasos necesarios que debemos seguir, desde crear el producto hasta entregárselo al consumidor, y deben ser descriptos con el mayor detalle posible.
Divides el proceso en pequeñas partes y observas qué ocupa demasiado tiempo, qué se puede optimizar, mejorar, etc. Por ejemplo, cuánto tiempo lleva una solicitud desde el producto, pasando por grooming, hasta llegar al ticket que un desarrollador puede tomar, QA, etc. Así analizas cada paso individualmente y piensas en cómo se puede optimizar.
Cuando hacía esto, noté dos cosas:
- un alto porcentaje de tickets de QA que regresan a los desarrolladores;
- las revisiones de pull requests llevaban demasiado tiempo.
El problema era que eran conclusiones como: parece que lleva mucho tiempo, pero no estamos seguros de cuánto exactamente.
«No se puede mejorar lo que no se puede medir».
¿Cómo justificar cuán grave es el problema? ¿Consume días u horas?
Para medir esto, añadimos un par de pasos en el proceso de Jira: «listo para desarrollo» y «listo para QA», para medir cuánto tiempo cada ticket espera y cuántas veces regresa a un paso determinado.
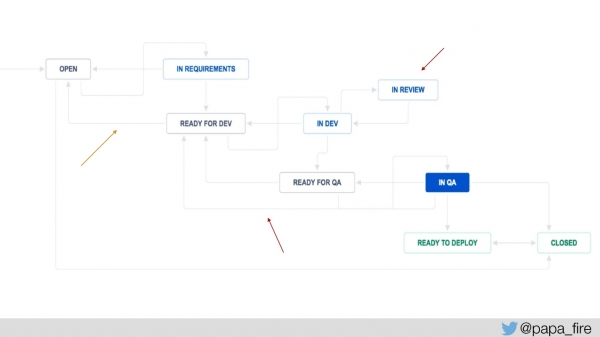
También añadimos «en revisión», para saber cuánto tiempo en promedio los tickets están en revisión, y a partir de eso avanzar. Teníamos métricas del sistema, ahora añadimos nuevas métricas y empezamos a medir:
- La eficiencia del proceso: la productividad y lo planificado/entregado.
- La calidad del proceso: el número de defectos, defectos desde QA.
Esto realmente ayuda a entender qué va bien y qué va mal.
Día cincuenta
Todo esto es, por supuesto, bueno e interesante, pero hacia el final del segundo mes ocurrió algo que, en principio, era predecible, aunque no esperaba tal magnitud. La gente comenzó a irse porque la dirección cambió. Nuevas personas entraron en la gerencia, comenzaron a cambiar todo, y los anteriores fueron despedidos. Y, generalmente, en una empresa que tiene varios años, todos son amigos y se conocen entre sí.
Esto era predecible, pero la magnitud de los despidos fue inesperada. Por ejemplo, en una semana, dos líderes de equipo presentaron simultáneamente sus renuncias. Por lo tanto, tuve que no solo dejar de lado otros problemas, sino concentrarme en crear un equipo. Este es un problema largo y difícil de resolver, pero había que abordarlo porque quería conservar a las personas que quedaron (o a la mayoría de ellas). Tenía que reaccionar de alguna manera ante la salida de las personas, para mantener la moral en el equipo.
En teoría es bueno: entra una nueva persona, que tiene un lienzo en blanco completo, que puede evaluar las habilidades del equipo y reemplazar al personal. En la práctica, no se puede simplemente traer a nuevas personas por muchas razones. Siempre se necesita un equilibrio.
- Entre los antiguos y los nuevos. Hay que retener a las personas que pueden adaptarse y mantener la misión. Pero al mismo tiempo, hay que aportar nueva sangre, de esto hablaremos más adelante.
- Experiencia. Hablé mucho con buenos juniors que estaban entusiasmados y querían trabajar con nosotros. Pero no pude contratarlos porque no había suficientes seniors para apoyar a los juniors y ser sus mentores. Primero tenía que reclutar a la alta dirección y solo después a los jóvenes.
- La vara y la caricia.
No tengo una buena respuesta a la pregunta de cuál es el equilibrio correcto, cómo mantenerlo, cuántas personas dejar y cuánto presionar. Es un proceso completamente individual.
Día cincuenta y uno
Empecé a observar al equipo para entender quién tenía y recordé una vez más:
«La mayoría de los problemas son problemas con las personas».
Descubrí que en el equipo, tanto entre los desarrolladores como en Ops, hay tres grandes problemas:
- Satisfacción con la situación actual.
- Falta de responsabilidad — porque nadie jamás relacionó los resultados del trabajo de los ejecutores con el impacto en el negocio.
- El miedo al cambio.
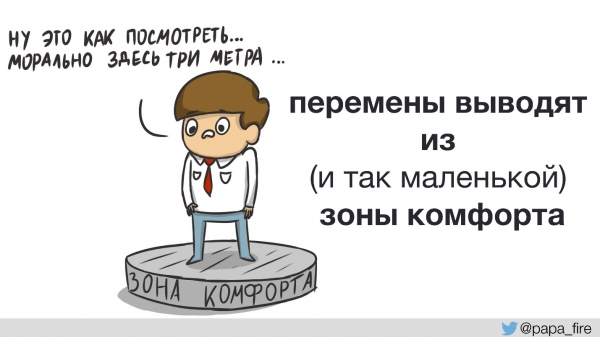
Los cambios siempre sacan a la gente de su zona de confort, y cuanto más jóvenes son, menos les gusta el cambio, porque no comprenden el porqué y cómo. La respuesta más común que he escuchado es: «Nunca lo hicimos de esa manera». Se llegó a un absurdo total: el más mínimo cambio provocaba la indignación de alguien. No importaba cuánto afectara el cambio su trabajo, la gente decía: «No, ¿por qué? Esto no funcionará».
Pero no se puede mejorar sin cambiar nada.
Tuve una conversación absolutamente absurda con un empleado, le contaba mis ideas sobre optimización, a lo que él me respondió:
— Ah, ¿no viste lo que teníamos el año pasado!
— ¿Y qué?
— Ahora es mucho mejor que antes.
— Entonces, ¿no puede ser aún mejor?
— ¿Y para qué?
Buena pregunta — ¿para qué? Como si, si ahora es mejor que antes, entonces todo está bastante bien. Esto lleva a la falta de responsabilidad, lo cual es, en principio, absolutamente normal. Como dije, el equipo técnico estaba un poco al margen. En la empresa creían que debían estar, pero nadie nunca estableció estándares. En el soporte técnico nunca vieron un SLA, por lo que para el grupo era bastante "aceptable" (y esto me sorprendió más):
- 12 segundos de carga;
- 5-10 minutos de inactividad en cada lanzamiento;
- la resolución de fallos críticos tardaba días y semanas;
- falta de guardias 24/7 / de guardia.
Nadie nunca intentó preguntar por qué no podíamos hacerlo mejor, y nadie entendía que no debería ser así.
Como bono, había otro problema: falta de experiencia. Los senior se fueron, y el joven equipo restante creció en el antiguo modo y fue envenenado por ello.
Además, la gente también tenía miedo de fracasar y parecer incompetente. Esto se expresa en que, en primer lugar, bajo ninguna circunstancia pidieron ayuda.. Cuántas veces hemos hablado en grupo e individualmente, y yo decía: «Haz una pregunta si no sabes cómo hacer algo». Estoy seguro de mí mismo y sé que puedo resolver cualquier problema, pero tomará tiempo. Así que si se puede preguntar a alguien que sepa cómo resolverlo en 10 minutos, lo haré. Cuanto menos experiencia tengas, más miedo tienes de preguntar, porque piensas que te considerarán incompetente.
Este miedo a hacer preguntas se manifiesta de formas interesantes. Por ejemplo, preguntas: «¿Cómo va esta tarea?» — «Me quedan un par de horas, ya estoy terminando». Al día siguiente vuelves a preguntar, recibes la respuesta de que todo va bien, pero ha surgido un pequeño problema, y estará listo para el final del día. Pasa otro día, y hasta que no empujes a la persona contra la pared y la obligues a hablar con alguien, así seguirá todo. La persona quiere resolver la tarea por sí misma, considera que si no lo hace, será un gran fracaso.
Es por eso que los desarrolladores sobreestiman las estimaciones. Fue una anécdota cuando discutíamos una tarea específica, me dieron un número que me sorprendió mucho. A lo que me dijeron que en las estimaciones, el desarrollador incluye también el tiempo que el ticket pasará en QA, porque encontrarán errores allí, y el tiempo que tomará el PR, y el tiempo que las personas que deben revisarlo estarán ocupadas, es decir, todo lo que sea posible.
En segundo lugar, las personas que temen parecer incompetentes, analizan en exceso. Cuando dices lo que se necesita hacer, comienza: «No, ¿y si pensamos aquí?» En este sentido, nuestra empresa no es única; es un problema estándar de la juventud.
En respuesta, introduje las siguientes prácticas:
- Regla de 30 minutos. Si en media hora no puedes resolver el problema, pide a alguien que te ayude. Esto funciona con éxito variable, porque la gente aún no pide ayuda, pero al menos el proceso ha comenzado.
- Excluir todo menos lo esencial, en la evaluación del tiempo de ejecución de la tarea, es decir, contar solo el tiempo que tomará escribir el código.
- Aprendizaje continuo para aquellos que analizan en exceso. Es simplemente un trabajo constante con las personas.
Día sesenta
Mientras hacía todo esto, llegó el momento de revisar el presupuesto. Por supuesto, encontré muchas cosas interesantes sobre a dónde estábamos gastando el dinero. Por ejemplo, teníamos un rack entero en un centro de datos separado, que albergaba un servidor FTP utilizado por un solo cliente. Resultó que '... nos mudamos, y él se quedó allí, no lo cambiamos'. Eso fue hace 2 años.
Un interés particular era la factura por servicios en la nube. Estoy seguro de que la razón principal de la elevada factura por servicios en la nube son los desarrolladores, quienes por primera vez en su vida tienen acceso ilimitado a los servidores. No necesitan pedir: 'Dame, por favor, un servidor de prueba', pueden tomarlos por sí mismos. Además, los desarrolladores siempre quieren construir un sistema tan increíble que Facebook y Netflix se pondrían celosos.
Pero los desarrolladores no tienen experiencia en la compra de servidores ni la habilidad para determinar el tamaño adecuado de los servidores, porque nunca lo han necesitado antes. Y generalmente no comprenden bien la diferencia entre escalabilidad y rendimiento.
Resultados del inventario:
- Salimos de un centro de datos.
- Terminamos el contrato con 3 servicios de registro. Porque teníamos 5: cada desarrollador que comenzaba a experimentar tomaba uno nuevo.
- Apagamos 7 sistemas de AWS. De nuevo, los proyectos fallidos no se detuvieron; todos siguieron funcionando.
- Reducimos los gastos de software en 6 veces.
Día setenta y cinco
El tiempo pasaba, y después de dos meses y medio tenía que reunirme con el consejo de administración. Nuestro consejo de administración no es mejor ni peor que otros, como todos los consejos quiere saberlo todo. Las personas invierten dinero y quieren entender en qué medida lo que hacemos se ajusta a los KPI establecidos.
El consejo de administración recibe mucha información cada mes: el número de usuarios, su crecimiento, qué servicios utilizan y cómo, la productividad y, por último, la velocidad promedio de carga de las páginas.
El problema es que creo que el promedio es pura maldad. Pero es muy difícil explicar esto al consejo de administración. Están acostumbrados a trabajar con números agregados, y no, por ejemplo, con la dispersión del tiempo de carga en segundos.
En este sentido, hubo momentos interesantes. Por ejemplo, dije que debemos dividir el tráfico entre los servidores web individuales según el tipo de contenido.
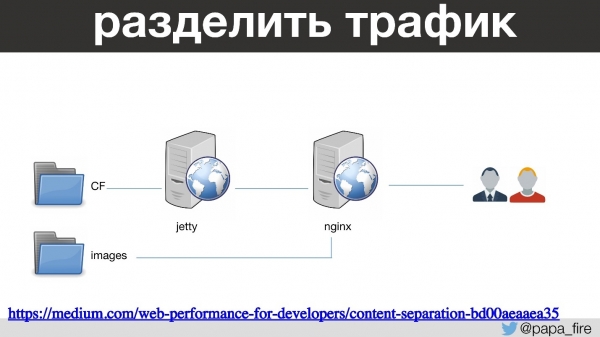
Es decir, ColdFusion pasa a través de Jetty y nginx y lanza las páginas. Las imágenes, JS y CSS se manejan a través de un nginx separado con sus propias configuraciones. Esta es una práctica bastante estándar de la que hablé hace un par de años. Como resultado, las imágenes se cargan mucho más rápido, y… la velocidad media de carga ha aumentado en 200 ms.
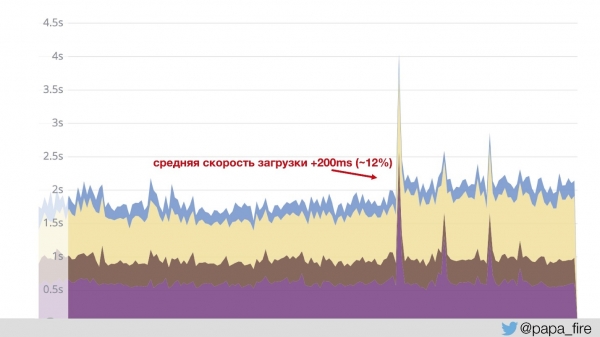
Esto sucedió porque el gráfico se construye en base a los datos que vienen de Jetty. Es decir, el contenido rápido no se incluye en el cálculo — el promedio se disparó. Nosotros lo entendimos, nos reímos, pero ¿cómo explicarle a la junta directiva por qué hicimos algo y resultó en un 12% peor?
Día ochenta y cinco
Al final del tercer mes me di cuenta de que había algo para lo que no estaba preparado: el tiempo. Todo lo que he mencionado requiere tiempo.
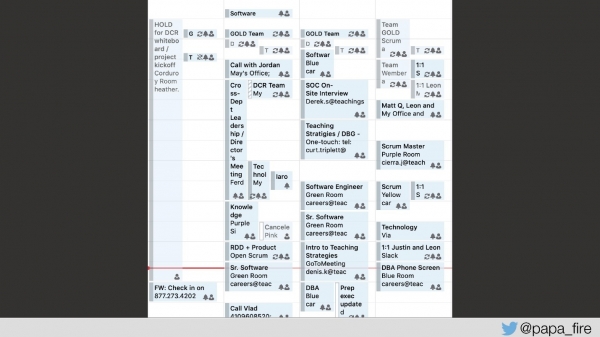
Este es mi verdadero calendario de la semana — solo una semana laboral, no muy sobrecargada. No tengo suficiente tiempo para todo. Por eso, de nuevo, necesitamos contratar personas que ayuden a resolver problemas.
Conclusión
Eso no es todo. En esta historia, aún no he llegado a cómo trabajamos con el producto y tratamos de sintonizarnos en la misma onda, o cómo integramos el soporte técnico, o cómo resolvimos otros problemas técnicos. Por ejemplo, me enteré completamente por casualidad de que en las tablas más grandes de la base de datos no usamos Solo. Tenemos una función personalizada nextID, y no se utiliza en la transacción.
Hubo un millón de cosas similares de las que se podría hablar por mucho tiempo. Pero lo más importante, de lo que aún vale la pena hablar, es sobre la cultura.
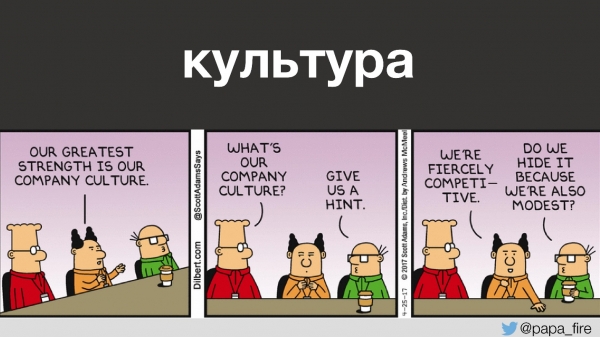
Es precisamente la cultura o su ausencia la que conduce a todos los demás problemas. Estamos tratando de construir una cultura donde las personas:
- no temen al fracaso;
- aprenden de los errores;
- colaboran con otros equipos;
- muestran iniciativa;
- asumen la responsabilidad;
- celebran el resultado como un objetivo;
- celebran el éxito.
Con eso, todo lo demás vendrá.
Leon Fire , y en .
En términos de legado, hay dos estrategias: evitar trabajar con él a toda costa, o afrontar valientemente las dificultades que lo acompañan. Nosotros estamos siguiendo el segundo camino, cambiando procesos y enfoques. Únete a nosotros en , y , y trabajemos juntos para implementar la cultura DevOps.
Fuente: habr.com
