

En este artículo, les presento mis reflexiones sobre la historia y las perspectivas del desarrollo de Internet, redes centralizadas y descentralizadas, y como resultado, la posible arquitectura de la red descentralizada de próxima generación.
Algo no está bien con Internet
Conocí Internet por primera vez en el año 2000. Por supuesto, esto no es el comienzo, la red ya existía antes, pero ese tiempo se puede considerar como el primer auge de Internet. La World Wide Web es un invento brillante de Tim Berners-Lee, web 1.0 en su forma clásica y canónica. Muchos sitios y páginas que se enlazan entre sí mediante hiperenlaces. A primera vista, una arquitectura simple, como todo lo genial: descentralizada y libre. Quiero, navego por los sitios de otras personas, siguiendo hiperenlaces; quiero, creo mi propio sitio donde publico lo que me interesa, por ejemplo, mis artículos, fotos, programas, hiperenlaces a sitios que me resultan interesantes. Y otros publican enlaces a mí.
¿Parecería una imagen idílica? Pero ya saben cómo terminó todo esto.
Las páginas se volvieron demasiadas, y la búsqueda de información se convirtió en una tarea bastante no trivial. Los hiperenlaces escritos por los autores simplemente no podían estructurar ese enorme volumen de información. Primero aparecieron los catálogos, alimentados manualmente, y luego gigantescos motores de búsqueda que comenzaron a usar ingeniosos algoritmos heurísticos de clasificación. Los sitios se creaban y se abandonaban, la información se duplicaba y se distorsionaba. Internet se comercializaba rápidamente y se alejaba cada vez más de la red académica ideal. El lenguaje de marcado pronto se convirtió en un lenguaje de formateo. Apareció la publicidad, molestos y desagradables banners y la tecnología de promoción y engaño de motores de búsqueda: SEO. La red se llenaba rápidamente de basura informativa. Los hiperenlaces dejaron de ser herramientas de conexión lógica y se convirtieron en herramientas de promoción. Los sitios se aislaban, se cerraban sobre sí mismos, transformándose de "páginas" abiertas en "aplicaciones" herméticas, convirtiéndose solo en medios para obtener ingresos.
Incluso entonces, tuve la sensación de que "algo no estaba bien". Un montón de diferentes sitios, desde páginas personales primitivas con un diseño llamativo, hasta "megaportales" sobrecargados de banners parpadeantes. Incluso si los sitios trataban sobre el mismo tema, no estaban relacionados en absoluto; cada uno tenía su propio diseño, su propia estructura, banners molestos, un buscador que funcionaba mal y problemas de descarga (sí, quería tener la información sin conexión). Ya en ese momento, Internet comenzaba a parecerse a una especie de televisión, donde al contenido útil le estaban pegadas diversas distracciones.
La descentralización se convirtió en una pesadilla.
¿Qué es lo que quiero?
Paradójicamente, incluso entonces, sin saber nada sobre web 2.0 o p2p, como usuario no necesitaba la descentralización. Recordando mis reflexiones claras de esa época, llego a la conclusión de que lo que necesitaba era... una base de datos unificada! Una que devuelva todos los resultados a una consulta, en lugar de los que mejor se ajustan al algoritmo de clasificación. Una en la que todos esos resultados estén presentados de manera uniforme y estilizados con mi propio diseño único, y no con los llamativos diseños improvisados de numerosos Vasya Pupkin. Una que pudiera guardar sin conexión y no temer que mañana el sitio desaparezca y la información se pierda para siempre. Una en la que pudiera introducir mi propia información, como comentarios y etiquetas. Una en la que pudiera buscar, ordenar y filtrar con mis propios algoritmos personales.
Web 2.0 y redes sociales
Mientras tanto, apareció la concepto de Web 2.0. Formulada en 2005 por Tim O'Reilly, como "una metodología para diseñar sistemas que, al tener en cuenta las interacciones en la red, se vuelven mejores cuanto más personas los utilizan" — implicando una participación activa de los usuarios en la creación y edición colectiva del contenido de la red. Sin exagerar, el pico y triunfo de este concepto fueron las Redes Sociales. Gigantescas plataformas que reúnen miles de millones de usuarios y almacenan cientos de petabytes de datos.
¿Qué hemos obtenido en las redes sociales?
- unificación de la interfaz; resultó que a los usuarios no les interesan todas las posibilidades para crear un diseño extravagante; todas las páginas de todos los usuarios tienen el mismo diseño y esto a todos les parece bien e incluso conveniente; solo difiere el contenido.
- unificación de la funcionalidad; toda la variedad de scripts resultó también innecesaria. 'Feed', amigos, álbumes... a lo largo de la existencia de las redes sociales, su funcionalidad se ha estabilizado más o menos y difícilmente cambiará: la funcionalidad está determinada por los tipos de actividad de las personas, y las personas prácticamente no cambian.
- base de datos única; trabajar con esta base de datos resultó ser mucho más cómodo que con múltiples sitios dispares; la búsqueda se volvió mucho más sencilla. En lugar de escanear continuamente diversas páginas débilmente relacionadas, almacenar en caché todo esto y clasificarlas según algoritmos heurísticos complejos, se realiza una solicitud unificada relativamente simple a una única base con una estructura conocida.
- interfaz de retroalimentación: likes y reposts; en la web convencional, incluso Google no podía obtener retroalimentación de los usuarios después de hacer clic en un enlace en los resultados de búsqueda. En las redes sociales, esta conexión resultó ser simple y natural.
¿Qué hemos perdido? Hemos perdido la descentralización, y por lo tanto, la libertad.. Se considera que ahora nuestros datos no nos pertenecen. Si antes podíamos alojar nuestra página de inicio en nuestra propia computadora, ahora entregamos todos nuestros datos a los gigantes de Internet.
Además, a medida que Internet ha evolucionado, gobiernos y corporaciones se han interesado en él, lo que ha generado problemas de censura política y restricciones de derechos de autor. Nuestras páginas en las redes sociales pueden ser bloqueadas y eliminadas si el contenido no cumple con las reglas de la red social; por una publicación imprudente, podemos enfrentarnos a responsabilidad administrativa e incluso penal.
Y así nos preguntamos nuevamente: ¿deberíamos recuperar la descentralización? Pero en otra forma, libre de las deficiencias del primer intento?
redes P2P
Las primeras redes p2p surgieron mucho antes del web 2.0 y se desarrollaron paralelamente a la evolución de la web. La aplicación clásica principal del p2p es el intercambio de archivos; las primeras redes se diseñaron para compartir música. Las primeras redes (como Napster) eran en esencia centralizadas, y por lo tanto, los propietarios de derechos las cerraron rápidamente. Sus seguidores optaron por la descentralización. En 2000 surgen los protocolos ED2K (el primer cliente eDokney) y Gnutella, en 2001 - el protocolo FastTrack (cliente KaZaA). Gradualmente, el grado de descentralización aumentó y las tecnologías mejoraron. A los sistemas con 'colas de descarga' les siguieron los torrents, y se introdujo el concepto de tablas hash distribuidas DHT. A medida que los gobiernos apretaron las tuercas, la anonimidad de los participantes se volvió más demandada. Desde 2000 se desarrolla la red Freenet, desde 2003 - I2P, en 2006 se lanzó el proyecto RetroShare. Se pueden mencionar numerosas redes p2p, tanto las que existieron anteriormente y ya han desaparecido como las que están operativas ahora: WASTE, MUTE, TurtleF2F, RShare, PerfectDark, ARES, Gnutella2, GNUNet, IPFS, ZeroNet, Tribbler y muchas más. Hay muchas. Son diversas. Muy diversas, tanto en propósito como en estructura... Probablemente a muchos de ustedes no les son familiares todos estos nombres. Y eso es solo una parte.
Sin embargo, las redes p2p tienen muchas desventajas. Aparte de los inconvenientes técnicos propios de cada implementación específica del protocolo y del cliente, se puede señalar una desventaja bastante común: la dificultad de búsqueda (es decir, todo aquello con lo que se enfrentó la Web 1.0, pero en una variante aún más compleja). Aquí no hay Google con su búsqueda omnipresente e instantánea. Y si bien en las redes de intercambio de archivos se puede utilizar la búsqueda por nombre de archivo o por metainformación, encontrar algo, por ejemplo, en las redes superpuestas onion o i2p, es bastante complicado, si es que es posible en absoluto.
En términos generales, si se hacen analogías con el internet clásico, la mayoría de las redes descentralizadas se han quedado atascadas en un nivel similar al de FTP. Imagina un internet en el que no hay nada más que FTP: ni sitios modernos, ni web 2.0, ni YouTube... Así es más o menos como están las redes descentralizadas. Y a pesar de algunos intentos aislados de cambiar algo, los cambios son escasos.
Contenido
Volvamos a un aspecto importante de este rompecabezas: el contenido. El contenido es el principal problema de cualquier recurso en línea, especialmente de uno descentralizado. ¿De dónde se obtiene? Claro, se puede depender de un grupo de entusiastas (como ocurre con las redes P2P existentes), pero entonces el desarrollo de la red será bastante lento y habrá poco contenido.
Trabajar con internet convencional es buscar y estudiar contenido. A veces, se trata de guardarlo (si el contenido es interesante y útil, muchos, especialmente quienes llegaron a la red en la época del dial-up —yo incluido— lo guardan prudentemente para no perderlo; porque internet es algo que no podemos controlar: hoy un sitio existe, mañana ya no, hoy hay un video en YouTube, mañana lo eliminan, etc.).
Y para los torrents (que consideramos más como un medio de entrega que como una red P2P), se espera que el almacenamiento suceda. Y esta es, de hecho, uno de los problemas de los torrents: mover un archivo descargado a un lugar donde sea más fácil de usar es complicado (generalmente, hay que regenerar manualmente la distribución) y el archivo no se puede renombrar (se puede hacer un enlace duro, pero eso es algo que muy pocos conocen).
En general, muchos de alguna u otra manera guardan contenido. ¿Cuál es su futuro? Normalmente, los archivos guardados terminan en algún lugar del disco, en una carpeta como Descargas, en medio de una gran cantidad, y permanecen ahí junto a miles de otros archivos. Esto es malo —y es malo para el propio usuario. Si internet tiene motores de búsqueda, la computadora local del usuario no tiene nada parecido. Es bueno si el usuario es ordenado y está acostumbrado a clasificar los archivos descargados «entrantes». Pero no todos son así...
En realidad, ahora hay varios que no guardan nada y dependen completamente de lo online. Pero en las redes P2P, se supone que el contenido se almacena localmente en el dispositivo del usuario y se distribuye a otros participantes. ¿Es posible encontrar una solución que permita involucrar a ambas categorías de usuarios en una red descentralizada, sin cambiar sus hábitos, y además —facilitándoles la vida?
La idea es bastante sencilla: ¿qué pasaría si creamos una herramienta que facilite y haga transparente para el usuario la conservación de contenido de la web normal, y que además realice una conservación inteligente — con metainformación semántica, no en un solo lugar, sino en una estructura definida que permita una posterior estructuración, y al mismo tiempo distribuya el contenido guardado en una red descentralizada?
Comencemos con la conservación
No consideraremos el uso utilitario de internet para ver previsiones del tiempo o horarios de vuelos. Nos interesan más los objetos autosuficientes y relativamente inmutables: artículos (desde tuits/publicaciones en redes sociales hasta artículos extensos, como aquí en Habr), libros, imágenes, programas, grabaciones de audio y video. ¿De dónde proviene principalmente la información? Usualmente es
- redes sociales (noticias diversas, notas breves — "tuits", imágenes, audio y video)
- artículos en recursos temáticos (como Habr); no hay muchos recursos buenos, generalmente estos recursos también están estructurados como redes sociales
- sitios de noticias
Por lo general, tienen funciones estándar: "me gusta", "compartir", "compartir en redes sociales", etc.
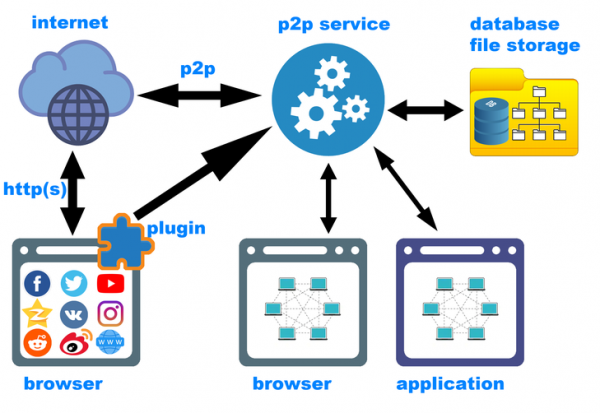
Imaginemos un plugin para el navegador, que guardará de manera especial todo aquello que nos gusta, que compartimos, que añadimos a "favoritos" (o que presionamos un botón especial del plugin, si el sitio no tiene función de "me gusta"/"compartir"/"añadir a favoritos"). La idea principal es que simplemente presionas "me gusta" — como lo has hecho un millón de veces antes, y el sistema guarda el artículo, imagen o video en un almacenamiento offline especial, y ese artículo o imagen se vuelve accesible — tanto para su visualización offline a través de la interfaz de un cliente descentralizado, como en la propia red descentralizada. Para mí, es muy conveniente. Sin acciones innecesarias, y resolvemos muchas tareas a la vez:
- conservación de contenido valioso, que puede perderse o ser eliminado
- llenado rápido de la red descentralizada
- agregación de contenido de diferentes fuentes (puedes estar registrado en decenas de recursos de internet, y todos los "me gusta"/"comparticiones" se acumularán en una base local única)
- estructuración del contenido que te interesa según tus reglas
Es evidente que el complemento del navegador debe configurarse según la estructura de cada sitio web (esto es bastante factible; ya existen complementos para guardar contenido de YouTube, Twitter, VK, etc.). No son muchos los sitios por los cuales vale la pena crear complementos personalizados. Por lo general, se trata de redes sociales populares (pocas más de una docena) y algunos sitios temáticos de alta calidad como Habr (que también son pocos). Con código abierto y especificaciones, el desarrollo de un nuevo complemento basado en una plantilla no debería llevar mucho tiempo. Para otros sitios se puede utilizar un botón de guardar universal, que almacene toda la página en mhtml, posiblemente eliminando previamente la publicidad.
Ahora sobre la estructuración
Entiendo por "guardado inteligente" como mínimo la posibilidad de guardar con metainformación: fuente del contenido (URL), conjunto de 'me gusta' anteriores, etiquetas, comentarios, sus identificadores, etc. Porque en un guardado normal, esta información se pierde... Por fuente puede entenderse no solo la URL directa, sino también el componente semántico: por ejemplo, un grupo en una red social o un usuario que haya compartido. El complemento puede ser lo suficientemente inteligente como para utilizar esta información para estructurar y etiquetar automáticamente. Además, es importante que el usuario siempre pueda agregar cierta metainformación al contenido que guarda, para lo cual se deben prever herramientas de interfaz lo más cómodas posible (tengo muchas ideas sobre cómo hacerlo).
De este modo, se resuelve la cuestión de la estructuración y organización de los archivos locales del usuario. Esto ya es una utilidad lista para ser utilizada incluso sin ningún p2p. Simplemente es una base de datos offline que sabe qué, de dónde y en qué contexto se guardó, y permite llevar a cabo pequeñas investigaciones. Por ejemplo, encontrar usuarios de una red social externa que hayan dado más 'me gusta' a las mismas publicaciones que tú. ¿Muchas redes sociales permiten esto de manera explícita?
Aquí ya se debe mencionar que un solo complemento del navegador, por supuesto, no es suficiente. El segundo componente más importante del sistema es un servicio de red descentralizada que opera en segundo plano y gestiona tanto la misma red p2p (solicitudes desde la red y solicitudes desde el cliente) como el almacenamiento de nuevo contenido mediante el complemento. El servicio, trabajando junto con el complemento, colocará el contenido en el lugar adecuado, calculará los hashes (y posiblemente determinará si ese contenido ya se ha almacenado anteriormente), y añadirá la metainformación necesaria a la base de datos local.
Lo interesante es que el sistema ya sería útil en esta forma, sin ningún p2p. Muchos utilizan recortadores web que añaden contenido interesante de la web, por ejemplo, a Evernote. La arquitectura propuesta es una versión ampliada de dicho recortador.
Y, finalmente, el intercambio p2p
Lo más agradable es que se puede intercambiar información y metainformación (tanto la capturada de la web como la propia). La concepto de una red social se adapta perfectamente a la arquitectura p2p. Se puede decir que la red social y el p2p están hechos el uno para el otro. Cualquier red descentralizada, en su ideal, debe construirse como una red social, solo así funcionará de manera efectiva. 'Amigos', 'Grupos' — son esos mismos nodos, que deben tener conexiones sólidas, y estas provienen de una fuente natural: los intereses comunes de los usuarios.
Los principios de almacenamiento y distribución de contenido en una red descentralizada son completamente idénticos a los principios de almacenamiento (captura) de contenido de la internet convencional. Si utilizas algún contenido de la red (es decir, lo has almacenado), cualquiera puede utilizar tus recursos (disco y canal), necesarios para obtener específicamente ese contenido.
Me gusta — es la herramienta más sencilla para almacenar y compartir. Si me gusta — no importa si en la internet externa o dentro de la red descentralizada — significa que me gusta el contenido, y dado eso, estoy dispuesto a mantenerlo localmente y compartirlo con otros participantes de la red descentralizada.
- El contenido no se 'perderá'; ahora está guardado localmente, podré volver a él más tarde, en cualquier momento, sin preocuparme de que alguien lo elimine o bloquee.
- Puedo categorizarlo (de inmediato o más tarde), etiquetarlo, comentarlo, asociarlo con otro contenido; en general, hacer algo significativo con él: llamémoslo "formación de metainformación".
- Puedo compartir esta metainformación con otros participantes de la red.
- Puedo sincronizar mi metainformación con la metainformación de otros participantes.
Probablemente, renunciar a los 'dislikes' también tiene sentido: si no me gusta el contenido, es lógico que no quiera ocupar espacio en mi disco para almacenarlo y usar mi ancho de banda para distribuir ese contenido. Por lo tanto, los 'dislikes' no encajan de manera orgánica en la descentralización (aunque a veces sí resulta útil). ).
A veces es necesario guardar lo que "no gusta". Hay una palabra: "necesidad" :)
«Marcadores.Las "marcas" (o "favoritos") no expresan mi opinión sobre el contenido, pero las guardo en mi base local de marcadores. La palabra "favoritos" no encaja completamente en su sentido (para eso están los 'likes' y su posterior categorización), mientras que "marcadores" (bookmarks) sí lo hace. El contenido en los "marcadores" también se distribuye: si lo 'necesitas' (es decir, lo 'usas' de alguna manera), es lógico que también pueda ser 'necesario' para alguien más. ¿Por qué no utilizar tus recursos para esto?
La función "amigos" es bastante evidente. Son grupos, personas con intereses similares, lo que significa que probablemente tendrán contenido interesante. En una red descentralizada, esto significa, sobre todo, suscribirse al feed de noticias de amigos y acceder a sus catálogos (álbumes) con el contenido que han guardado.
De manera análoga, la función "grupo" son ciertos feeds colectivos, foros o algo similar, en los que también se puede suscribir, lo que significa recibir todo el material del grupo y distribuirlo. Es posible que los "grupos", al igual que los grandes foros, deban ser jerárquicos: esto permitirá estructurar mejor el contenido de los grupos y limitar el flujo de información, sin recibir o distribuir lo que no te interesa mucho.
Todo lo demás.
Es importante señalar que la arquitectura descentralizada siempre es más compleja que la centralizada. En los recursos centralizados, hay una rígida dictadura del código del servidor. En los descentralizados, hay que llegar a acuerdos entre numerosos participantes iguales. Por supuesto, esto no se puede lograr sin criptografía, cadenas de bloques y otros logros que han sido desarrollados principalmente para las criptomonedas.
Supongo que pueden ser necesarios ciertos rankings de confianza criptográficos, generados por los participantes de la red entre sí. La arquitectura debería permitir combatir de manera efectiva a los botnets, que, existiendo en cierta nube, pueden por ejemplo auto-generar calificaciones para sí mismos. Realmente espero que las corporaciones y las granjas de botnets, a pesar de su superioridad tecnológica, no tomen el control de una red descentralizada; que su principal recurso sean las personas reales, capaces de crear y estructurar contenido interesante y útil para otros seres humanos.
También espero que tal red impulse la civilización hacia el progreso. Tengo muchas ideas al respecto, que sin embargo no se ajustan a los límites de este artículo. Solo diré que, de cierta manera, el contenido científico, técnico, médico, etc., debe tener prioridad sobre el contenido de entretenimiento, y esto requiere cierta moderación. La moderación de una red descentralizada es una tarea no trivial, pero es resoluble (aunque la palabra “moderación” es completamente incorrecta y no refleja en absoluto la esencia del proceso, ni externa ni internamente... ni siquiera he encontrado una palabra adecuada para describir este proceso).
Probablemente sea superfluo mencionar la necesidad de garantizar el anonimato, ya sea a través de medios integrados (como en i2p o Retroshare), o pasando todo el tráfico a través de TOR o VPN.
Y, finalmente, la arquitectura del software (esquemáticamente ilustrada en la imagen del artículo). Como se mencionó anteriormente, el primer componente del sistema es un complemento para el navegador que captura contenido con metainformación. El segundo componente clave es un servicio de p2p que funciona en segundo plano (“backend”). La operativa de la red no debe depender de si el navegador está activo. El tercer componente es el software del cliente — frontend. Esto puede ser un servicio web local (en este caso, el usuario podrá interactuar con la red descentralizada sin salir de su navegador favorito) o una aplicación GUI independiente para un sistema operativo específico (Windows, Linux, MacOS, Android, iOS, etc.). Me gusta la idea de que todas las variantes de frontend existan simultáneamente. Además, esto requerirá una arquitectura más rigurosa del backend.
Existen muchos otros aspectos que no se incluyen en este artículo. La conexión a la distribución de almacenes de archivos existentes (es decir, cuando ya tienes un par de terabytes descargados, y permites que el cliente los escanee, obtenga hashes, los compare con lo que hay dentro de la red y se una a la distribución, además de obtener de la red metainformación sobre tus propios archivos — nombres correctos, descripciones, calificaciones, comentarios, etc.), la conexión a fuentes externas de metainformación (como bases de datos de Libgen), el uso opcional de espacio en disco para almacenar contenido cifrado ajeno (como en Freenet), la arquitectura de integración con redes descentralizadas existentes (aquí es completamente confuso), la idea de hash multimedia (uso de hashes perceptivos especiales para contenido multimedia — imágenes, audio y video, lo que permitirá comparar archivos multimedia con el mismo significado, aunque difieran en tamaño, resolución, etc.) y mucho más.
Resumen breve del artículo
1. En redes descentralizadas no hay Google con su búsqueda y clasificación — pero en cambio, hay una comunidad de personas reales. Una red social con sus mecanismos de retroalimentación (me gusta, reenvíos…) y un grafo social (amigos, comunidades…) es el modelo ideal de nivel aplicable para una red descentralizada.
2. La idea principal que traigo con este artículo es el guardado automático de contenido interesante de la web convencional al dar un like/reposte; esto puede ser útil incluso sin p2p, simplemente manteniendo un archivo personal de información curiosa.
3. Este contenido también puede alimentar automáticamente una red descentralizada.
4. El principio de guardado automático de contenido interesante funciona también con likes/repostes dentro de la propia red descentralizada.
Fuente: habr.com
