

Artem Denisov ( , )
Badoo es el sitio de citas más grande del mundo. Actualmente, tenemos registrados alrededor de 330 millones de usuarios en todo el mundo. Pero, lo que es mucho más importante en el contexto de nuestra conversación de hoy, es que almacenamos alrededor de 3 petabytes de fotos de usuarios. Cada día, nuestros usuarios suben aproximadamente 3,5 millones de nuevas fotos, y la carga de lectura es de alrededor de 80,000 solicitudes por segundo. Esto es bastante para nuestro backend, y a veces tenemos dificultades con ello.
Voy a contarles sobre el diseño de este sistema que almacena y entrega fotos en general, y daré una perspectiva desde el punto de vista del desarrollador. Habrá una breve retrospectiva sobre cómo ha evolucionado, donde señalaré los hitos principales, pero hablaré con más detalle solo sobre las soluciones que estamos utilizando actualmente.
Y ahora, empecemos.
Como ya mencioné, será una retrospectiva, y para comenzar, tomemos el ejemplo más básico.
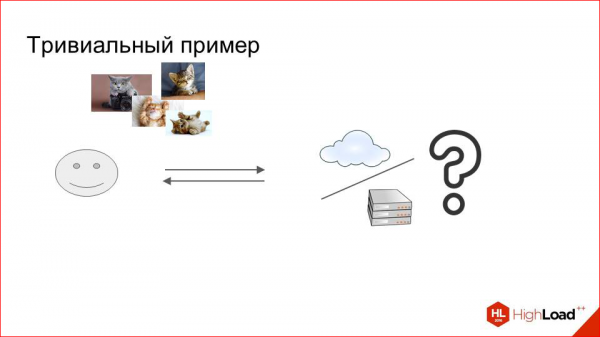
Tenemos una tarea común, necesitamos recibir, almacenar y entregar las fotos de los usuarios. En esta forma, la tarea es general, podemos usar cualquier cosa:
- almacenamiento en la nube moderno,
- una solución en caja, de las cuales también hay muchas ahora;
- podemos configurarlo en varias máquinas en nuestro centro de datos y colocar discos duros grandes para almacenar las fotos allí.
Badoo históricamente — y ahora, y en su momento (cuando esto apenas comenzaba) — opera en sus propios servidores, dentro de nuestros propios centros de datos. Por lo tanto, esta opción fue óptima para nosotros.
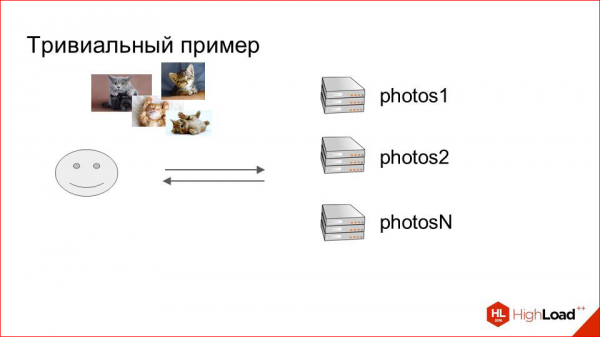
Simplemente tomamos varias máquinas, las llamamos "photos", y obtuvimos un clúster que almacena fotos. Pero, parece que falta algo. Para que todo esto funcione, necesitamos de alguna manera determinar en qué máquina almacenaremos qué fotos. Y aquí tampoco hay que descubrir América.
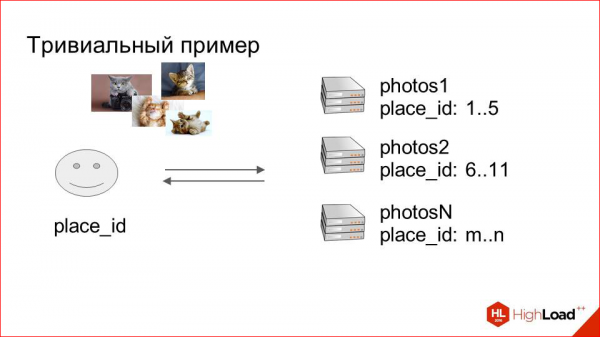
Agregamos a nuestro almacenamiento con información de los usuarios un campo. Este será la clave de sharding. En nuestro caso, lo llamamos place_id, y este id de lugar indica dónde se almacenan las fotos de los usuarios. Creamos mapas.
En la primera etapa, esto se puede hacer incluso manualmente: decimos que la fotografía de este usuario con esa ubicación se almacenará en ese servidor. Gracias a este mapa, siempre sabemos cuándo el usuario sube una fotografía, dónde guardarla y desde dónde entregarla.
Es un esquema absolutamente trivial, pero tiene ventajas bastante significativas. Primero, es simple, como ya mencioné, y segundo, con este enfoque podemos escalar horizontalmente fácilmente, simplemente añadiendo nuevos nodos y sumándolos al mapa. No hay que hacer nada más.
Así fue durante algún tiempo.
Esto ocurrió alrededor de 2009. Estábamos entregando máquinas, entregando...
Y en algún momento comenzamos a notar que este esquema tenía ciertas desventajas. ¿Cuáles eran las desventajas?
Primero, es la capacidad limitada. En un servidor físico no podemos alojar tantos discos duros como nos gustaría. Con el tiempo y el crecimiento del dataset, eso se convirtió en un problema.
Y segundo. Esta es una configuración poco común de máquinas, ya que es difícil reutilizarlas en otros clústeres; son bastante específicas, es decir, deben tener un rendimiento bajo, pero al mismo tiempo un gran disco duro.
Todo esto era para el año 2009, pero en principio, estos requisitos siguen siendo relevantes hasta hoy. Tenemos una retrospectiva, así que en 2009 todo era malo con esto.
Y el último punto es el precio.
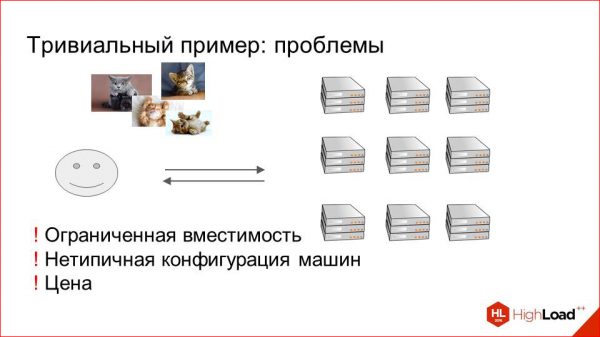
El precio era bastante alto en ese momento, y necesitábamos buscar alternativas. Es decir, teníamos que mejorar la utilización tanto del espacio en los centros de datos como de los servidores físicos donde todo esto estaba alojado. Nuestros ingenieros de sistemas iniciaron una gran investigación donde revisaron varias opciones. Miraron a sistemas de archivos en clúster, como PolyCeph y Lustre. Hubo problemas con el rendimiento y un mantenimiento bastante complicado. Decidieron no seguir con eso. Intentaron montar todo el dataset por NFS en cada nodo para escalar de alguna manera. La lectura también fue problemática, probaron varias soluciones de diferentes proveedores.
Y al final decidimos utilizar lo que se llama una Red de Área de Almacenamiento.
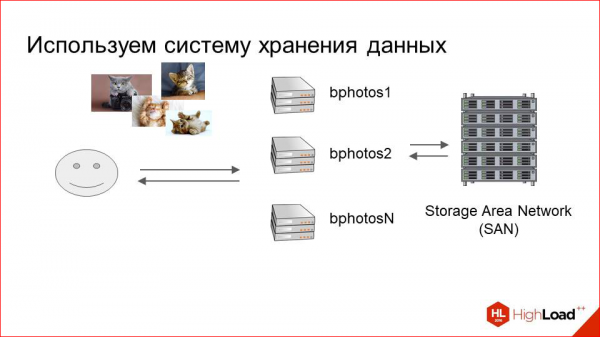
Estos son grandes SHD, que están diseñados para almacenar grandes volúmenes de datos. Consisten en estantes con discos que están montados en máquinas de entrega finales a través de fibra óptica. Así, tenemos un grupo de máquinas, bastante pequeño, y estos SHD, que son transparentes para nuestra lógica de entrega, es decir, para nuestro nginx o quien sea, manejan las solicitudes de estas fotografías.
Esta solución tenía ventajas evidentes. Es un SHD. Está diseñado para almacenar fotos. Resulta ser más económico que simplemente configurar máquinas con discos duros.
El segundo beneficio.
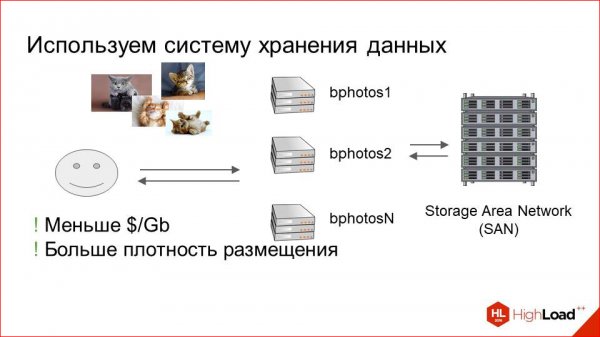
Es que la capacidad ha aumentado considerablemente, es decir, podemos alojar mucho más almacenamiento en un volumen mucho menor.
Pero también hubo desventajas que se hicieron evidentes bastante rápido. A medida que creció el número de usuarios y la carga en este sistema, comenzaron a surgir problemas de rendimiento. Y el problema aquí es bastante obvio: cualquier SHD diseñado para almacenar muchas fotos en un pequeño volumen, generalmente sufre de lecturas intensivas. Esto es realmente relevante tanto para cualquier almacenamiento en la nube como para cualquier otra cosa. En este momento, no existe un almacenamiento ideal que sea infinitamente escalable, en el que se pueda meter cualquier cosa y que soporte muy bien las lecturas. Especialmente las lecturas aleatorias.
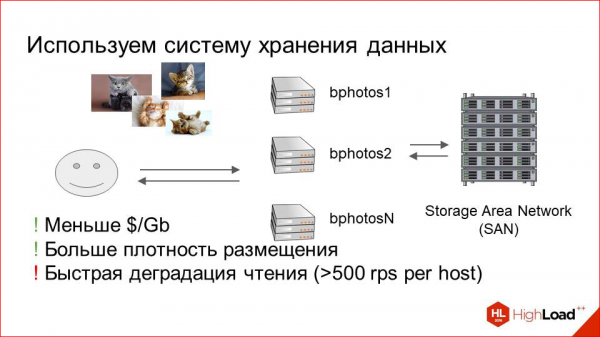
Al igual que con nuestras fotos, porque las fotografías se solicitan de manera no secuencial, y esto afecta enormemente su rendimiento.
Incluso según las cifras de hoy, si tenemos más de 500 RPS en las solicitudes de fotos por máquina a la que está conectado el almacenamiento, ya comienzan los problemas. Y esto ha sido bastante malo para nosotros, porque el número de usuarios sigue creciendo, y todo debería empeorar. Esto necesita ser optimizado de alguna manera.
Para optimizar, en ese momento decidimos, evidentemente, mirar el perfil de carga — qué está sucediendo, qué necesitamos optimizar.
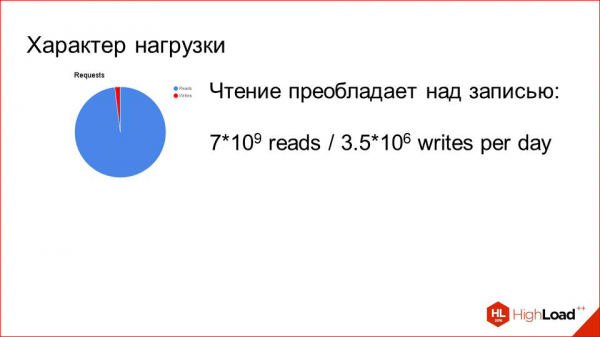
Y aquí todo juega a nuestro favor.
Ya mencioné en la primera diapositiva: tenemos 80 mil solicitudes por segundo para lectura con solo 3,5 millones de cargas por día. Es decir, hay una diferencia de tres órdenes de magnitud. Es obvio que necesitamos optimizar la lectura y prácticamente está claro cómo hacerlo.
Hay un pequeño detalle más. La especificidad del servicio es tal que una persona se registra, sube una foto, luego comienza a ver activamente a otras personas, les da 'me gusta', y es mostrado activamente a los demás. Luego encuentra una pareja o no, eso depende, y por un tiempo deja de usar el servicio. En ese momento, cuando está usando, sus fotos son muy 'calientes' — son bastante solicitadas, muchas personas las ven. Tan pronto como deja de hacerlo, rápidamente deja de ser mostrado de manera intensa a los demás, como lo era antes, y sus fotos prácticamente dejan de ser solicitadas.
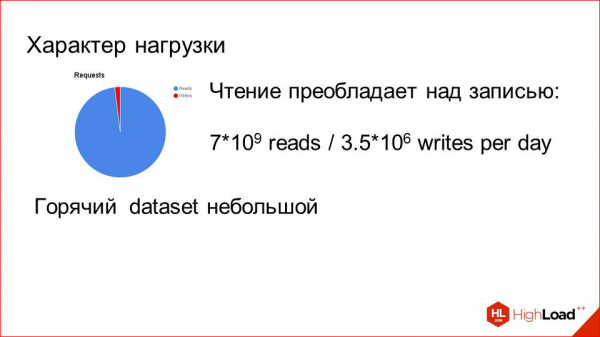
Es decir, tenemos un dataset muy pequeño y 'caliente'. Pero, al mismo tiempo, recibe muchas solicitudes. Y la solución obvia aquí es añadir caché.
El caché con LRU resolverá todos nuestros problemas. ¿Qué hacemos?
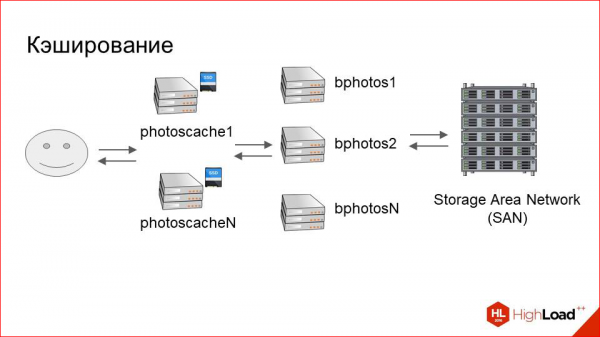
Añadimos ante nuestro gran clúster con almacenamiento otro relativamente pequeño, que llamamos cachés de fotos (photoscache). Esto es, en esencia, un proxy de caché.
¿Cómo funciona esto internamente? Aquí está nuestro usuario, aquí está el almacenamiento. Todo como antes. ¿Qué añadimos entre ellos?
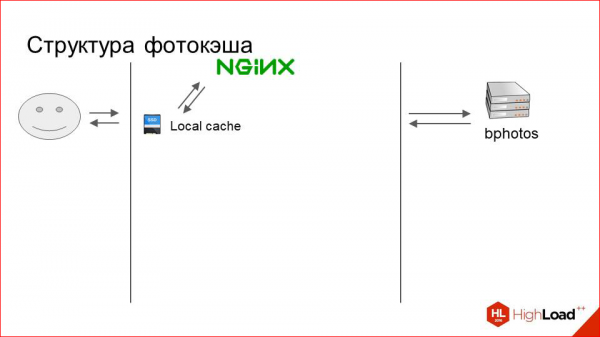
Es simplemente una máquina con un disco físico local, que es rápido. Es un SSD, por ejemplo. Y en este disco se almacena algún caché local.
¿Cómo se ve esto? El usuario envía una solicitud por una foto. NGINX primero la busca en el caché local. Si no está, simplemente hace proxy_pass a nuestro almacenamiento, descarga la fotografía desde allí y se la da al usuario.
Pero esto es muy básico y no está claro qué sucede internamente. Funciona aproximadamente así.
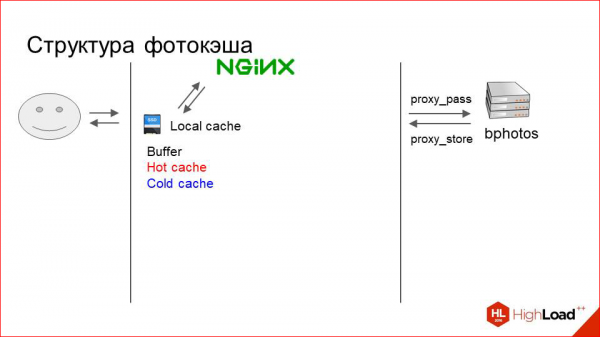
El caché está lógicamente dividido en tres capas. Cuando digo 'tres capas', no significa que haya un sistema complejo. No, son simplemente tres directorios en el sistema de archivos:
- Este es un búfer, donde entran las fotos recién cargadas desde el proxy.
- Este es un caché caliente, donde se almacenan las fotos que están siendo activamente solicitadas en este momento.
- Y un caché frío, donde lentamente las fotos son expulsadas del caliente cuando reciben menos solicitudes.
Para que esto funcione, necesitamos gestionar este caché de alguna manera, necesitamos mover las fotos dentro de él, etc. También es un proceso muy primitivo.
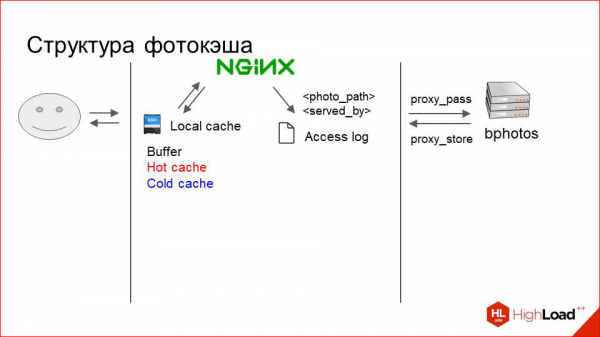
Nginx simplemente escribe en RAMDisk access.log para cada solicitud, donde indica la ruta de la foto que está siendo servida (ruta relativa, por supuesto) y qué sección la está sirviendo. Es decir, puede mencionarse «foto 1» y luego el buffer, o caché caliente, o caché frío, o proxy.
Dependiendo de esto, necesitamos tomar una decisión sobre qué hacer con la foto.
En cada máquina, tenemos un pequeño demonio que constantemente lee este log y almacena en su memoria las estadísticas sobre el uso de ciertas fotos.
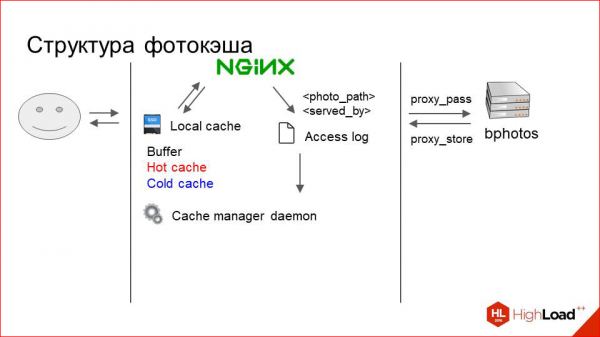
Simplemente recopila información, lleva contadores y periódicamente hace lo siguiente. Las fotos que se solicitan activamente, que reciben muchas solicitudes, las mueve al caché caliente, sin importar dónde estén.
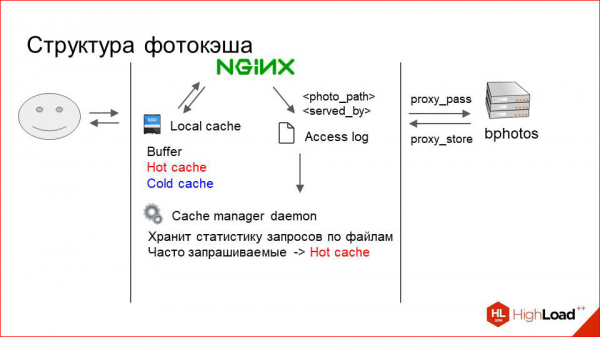
Las fotos que se solicitan raramente y cuyos pedidos han disminuido, las empuja gradualmente del caché caliente al frío.
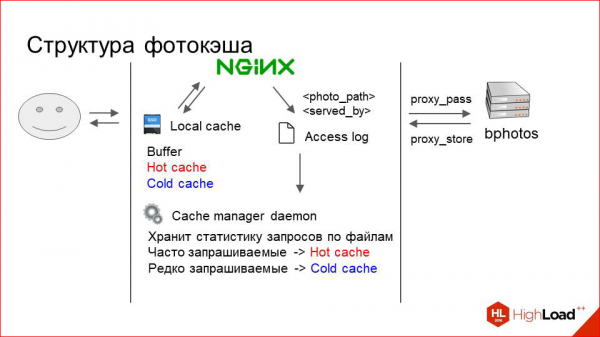
Y cuando rompemos espacio en el caché, simplemente comenzamos a eliminar indiscriminadamente del caché frío. Y, de hecho, funciona bien.
Para que la foto se guarde de inmediato al ser proxy, utilizamos la directiva proxy_store y el buffer también es un RAMDisk, es decir, para el usuario funciona muy rápido. Esto se refiere a las entrañas del servidor de caché.
Sigue la pregunta de cómo distribuir las solicitudes entre estos servidores.
Supongamos que hay un clúster de veinte máquinas de almacenamiento y tres servidores de caché (así resultó).
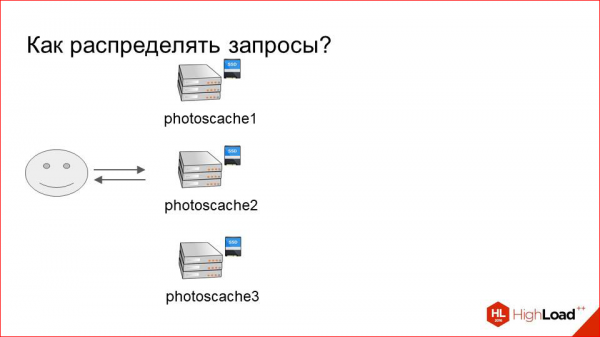
Necesitamos de alguna forma determinar qué solicitudes corresponden a qué fotos y dónde deben aterrizar.
La opción más banal es Round Robin. ¿O hacer esto de manera aleatoria?
Esto, evidentemente, tiene una serie de desventajas, porque vamos a utilizar el caché de manera muy ineficiente en tal situación. Las solicitudes caerán en máquinas aleatorias: aquí se cacheó, en la vecina ya no está. Y si esto funciona, lo hará muy mal. Incluso con un número pequeño de máquinas en el clúster.
Necesitamos de alguna manera determinar de forma inequívoca en qué servidor aterrizar cada solicitud.
Hay una forma simple. Tomamos el hash de la URL o el hash de nuestra clave de partición, que está en la URL, y lo dividimos por la cantidad de servidores. ¿Funciona? Funciona.
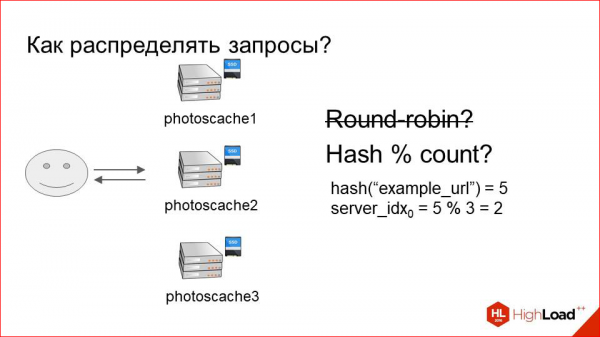
Es decir, tenemos un request del cien por ciento, por ejemplo, por algún «example_url» siempre se aterrizará en el servidor con el índice «2», y la caché se utilizará de la mejor manera posible.
Pero surge un problema con el resharding en tal esquema. Resharding, me refiero al cambio en la cantidad de servidores.
Supongamos que nuestro clúster de cacheo ha dejado de ser efectivo y hemos decidido agregar otra máquina.
Agregamos.
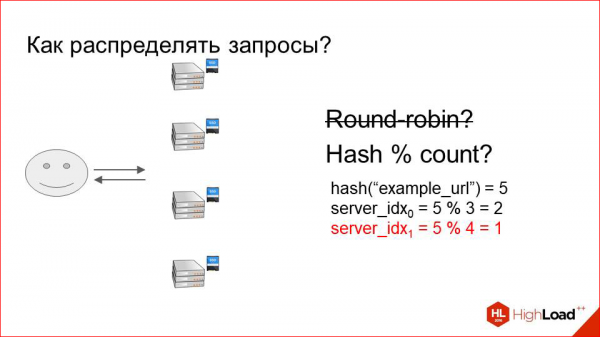
Ahora estamos dividiendo todo no entre tres, sino entre cuatro. Así, prácticamente todas las claves que teníamos antes, prácticamente todas las URL ahora residen en otros servidores. Toda la caché se invalidó de inmediato. Todas las solicitudes se dirigieron a nuestro clúster de almacenamiento, se volvió inestable, hubo una interrupción del servicio y usuarios descontentos. No queremos que eso ocurra.
Esta opción tampoco nos conviene.
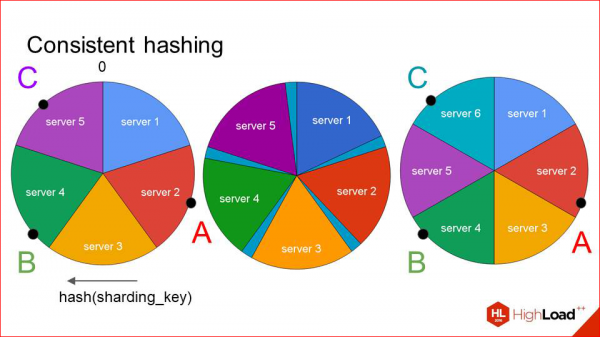
Entonces, ¿qué debemos hacer? Debemos de alguna manera utilizar la caché de manera efectiva, aterrizando constantemente un request en el mismo servidor, pero al mismo tiempo ser resilientes al resharding. Y hay una solución para eso, no es que sea complicada. Se llama hashing consistente.
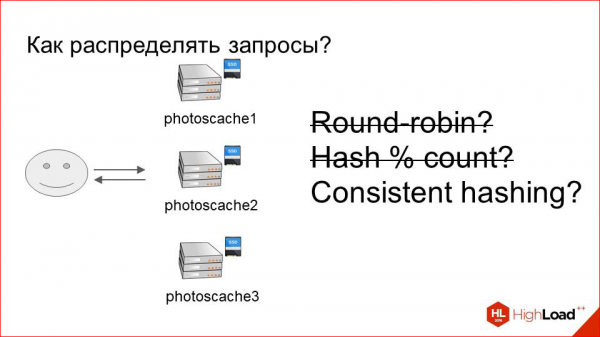
¿Cómo se ve esto?
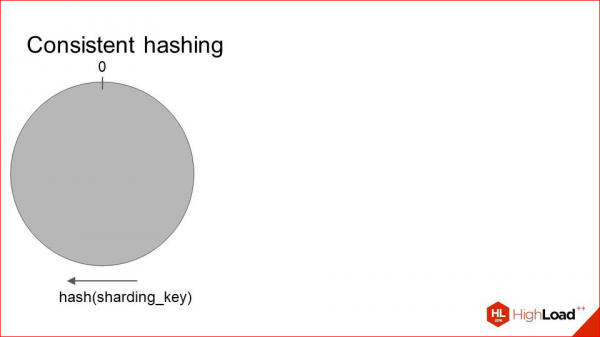
Tomamos alguna función de la clave de sharding y dispersamos todos sus valores en una circunferencia. Es decir, en el punto 0 se encuentran sus valores mínimos y máximos. Luego, colocamos todos nuestros servidores en esa misma circunferencia de esta manera:
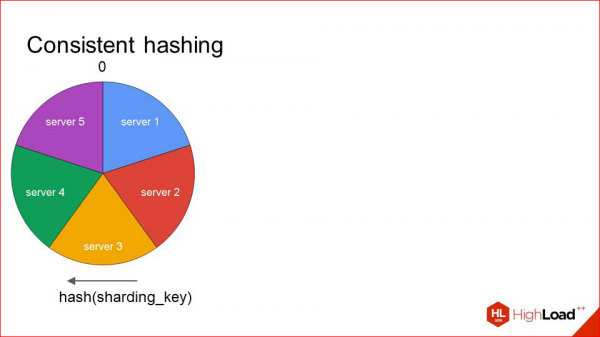
Cada servidor se define por un punto, y el sector que va hasta él en el sentido de las agujas del reloj, corresponde a este host. Cuando recibimos solicitudes, vemos de inmediato que, por ejemplo, la solicitud A — tiene un hash así — y es atendida por el servidor 2. La solicitud B — por el servidor 3. Y así sucesivamente.
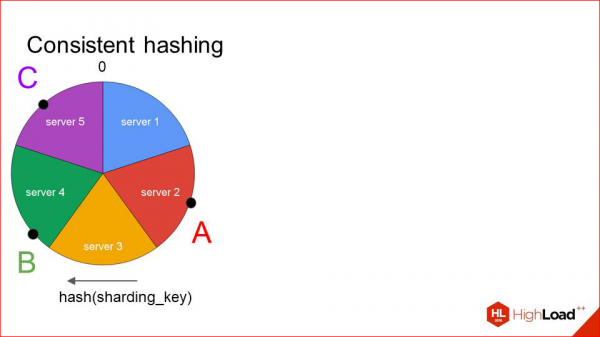
¿Qué sucede en esta situación durante el resharding?
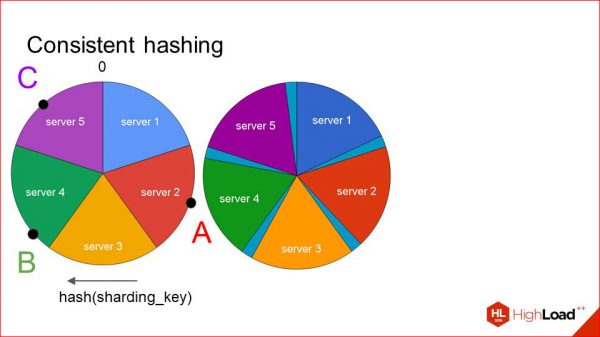
No invalidamos toda la caché, como hacíamos antes, y no desplazamos todas las claves, sino que movemos cada sector una pequeña distancia de tal manera que en el espacio libre, por así decirlo, quepa nuestro sexto servidor que queremos agregar, y lo añadimos allí.
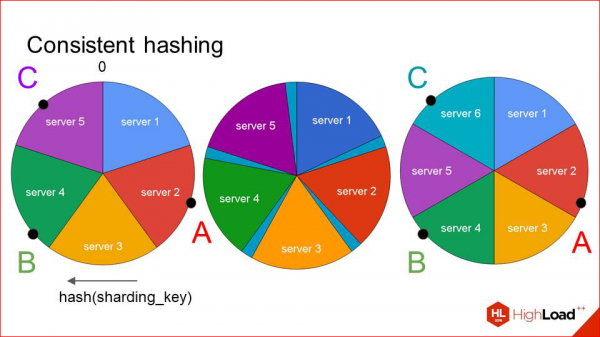
Por supuesto, en tal situación, las claves también se desajustan. Pero se desajustan mucho menos que antes. Y vemos que nuestras dos primeras claves permanecen en sus servidores, mientras que solo el servidor de caché cambió para la última clave. Esto funciona de manera bastante efectiva, y si agregas nuevos hosts de manera incremental, no hay un gran problema aquí. Agregas poco a poco, esperas a que la caché se llene nuevamente, y todo funciona bien.
La única pregunta que queda es sobre las fallas. Supongamos que alguno de nuestros servidores se ha averiado.
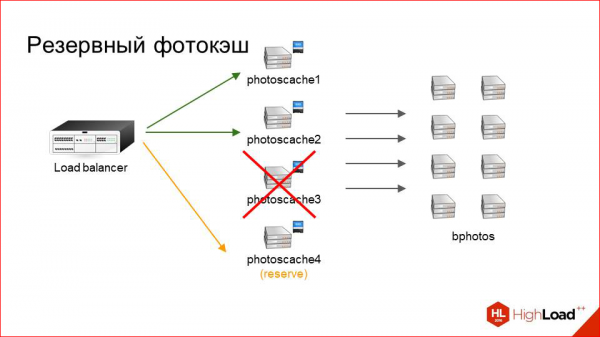
Y no nos gustaría en ese momento regenerar este mapa, invalidar parte de la caché, etc., si, por ejemplo, la máquina se reinició y necesitamos atender las solicitudes de alguna manera. Simplemente mantenemos en cada sitio un caché fotográfico de reserva que actúa como reemplazo para cualquier máquina que esté fuera de servicio en ese momento. Y si de repente algún servidor se vuelve inaccesible, el tráfico se dirige allí. En este caso, naturalmente no hay caché, es decir, está frío, pero, al menos, se procesan las solicitudes de los usuarios. Si es un intervalo corto, lo manejamos sin problemas. Simplemente hay más carga en el almacenamiento. Si el intervalo es largo, entonces podemos decidir si quitar este servidor del mapa o no, o tal vez reemplazarlo por otro.
Esto es respecto al sistema de caché. Veamos los resultados.
Aparentemente, no hay nada complicado aquí. Pero este método de gestión de la caché nos dio una tasa de aciertos del 98%. Es decir, de esas 80,000 solicitudes por segundo, solo 1,600 llegan a los almacenes, y esta es una carga completamente normal, ellos la manejan sin problemas, siempre tenemos un margen.
Hemos colocado estos servidores en nuestros tres centros de datos, y obtuvimos tres puntos de presencia: Praga, Miami y Hong Kong.
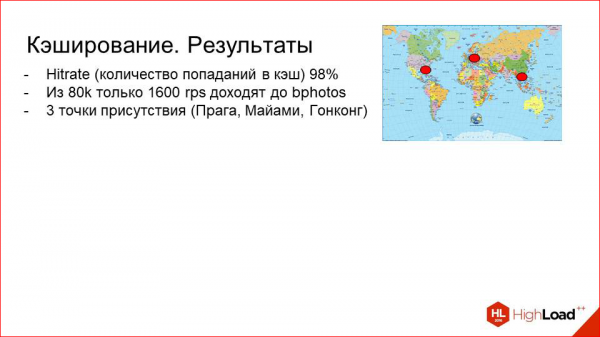
Por lo tanto, están más o menos localizados cerca de cada uno de nuestros mercados objetivo.
Y como bonificación agradable, obtuvimos este proxy de caché, en el que la CPU, de hecho, está ociosa, porque no se necesita tanto para servir contenido. Y allí, con NGINX + Lua, implementamos mucha lógica utilitaria.
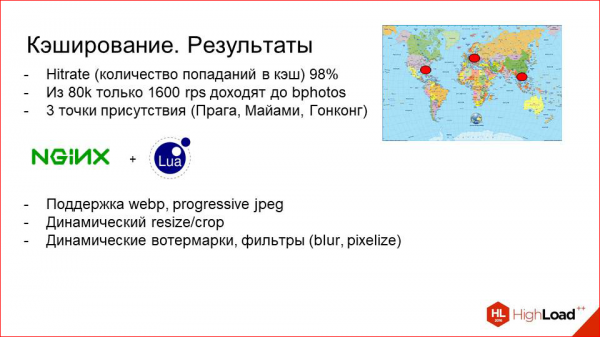
Por ejemplo, podemos experimentar con webp o jpeg progresivo (formatos modernos y eficientes), ver cómo afecta al tráfico, tomar decisiones, activar para ciertos países, etc.; hacer un cambio dinámico de tamaño o recortar fotos al vuelo.
Este es un buen caso de uso, cuando, por ejemplo, tienes una aplicación móvil que muestra fotos, y la aplicación no quiere utilizar la CPU del cliente para solicitar una foto grande y luego redimensionarla a un tamaño específico para insertarla en la vista. Simplemente podemos especificar dinámicamente algunos parámetros en la URL, y la caché de fotos redimensionará la imagen. Generalmente, elegirá el tamaño que tenemos físicamente en el disco, lo más cercano a lo solicitado, y lo ajustará en las coordenadas específicas.
Por cierto, hemos publicado en acceso abierto las grabaciones de video de los últimos cinco años de la conferencia de desarrolladores de sistemas de alta carga. Mira, estudia, comparte y suscríbete al .
También podemos añadir mucha lógica de producto allí. Por ejemplo, podemos agregar diferentes marcas de agua según los parámetros de la URL, podemos desenfocar fotos, difuminar o pixelar. Esto es cuando queremos mostrar una foto de una persona, pero no queremos enseñar su cara, funciona bien, todo esto está implementado aquí.
¿Qué hemos logrado? Hemos creado tres puntos de presencia, buena tasa de aciertos, y al mismo tiempo, el CPU de estas máquinas no está inactivo. Ahora, por supuesto, se ha vuelto más importante que antes. Necesitamos poner máquinas más potentes, pero vale la pena.
Esto es lo que respecta a la entrega de fotos. Todo esto es bastante claro y obvio. Creo que no estoy descubriendo América, así es como funciona prácticamente cualquier CDN.
Y, probablemente, a un oyente experimentado le pueda surgir la pregunta: ¿por qué no simplemente cambiar todo a un CDN? Sería más o menos lo mismo, todos los CDN modernos pueden hacer eso. Y aquí hay varias razones.
La primera son las fotos.
Este es uno de los aspectos clave de nuestra infraestructura, y necesitamos tener control sobre ellas tanto como sea posible. Si es una solución de un proveedor externo, y no tienes ningún control sobre ella, te será bastante difícil vivir con ello cuando tienes un gran conjunto de datos y un flujo muy alto de solicitudes de usuarios.
Voy a dar un ejemplo. Ahora en nuestra infraestructura, por ejemplo, en caso de algún problema o golpes subterráneos, podemos acceder a la máquina, depurar allí, por decirlo de alguna manera. Podemos añadir la recopilación de métricas que solo a nosotros nos interesan, podemos experimentar de alguna manera, observar cómo esto impacta en los gráficos, etc. Actualmente, se recopilan muchas estadísticas sobre este clúster de caché. Y de vez en cuando las revisamos y analizamos a fondo algunas anomalías. Si esto estuviera del lado del CDN, sería mucho más difícil de controlar. O, por ejemplo, si ocurre algún accidente, sabemos qué ha pasado, sabemos cómo sobrellevarlo y cómo solucionarlo. Esta es la primera conclusión.
La segunda conclusión también es más bien histórica, porque el sistema ha estado evolucionando durante mucho tiempo y ha habido muchos requisitos comerciales diferentes en varias etapas, y no siempre se ajustan a la concepción del CDN.
Y el punto que se deriva de lo anterior es:
Es que en los fotocaches tenemos mucha lógica específica, que no siempre se puede añadir bajo solicitud. Dudo que algún CDN vaya a añadir cosas personalizadas a petición suya. Por ejemplo, el cifrado de URLs, si no desea que el cliente pueda modificar algo. Quiere cambiar la URL en el servidor y cifrarla, y luego pasar aquí algunos parámetros dinámicos.
¿Qué conclusión se puede sacar? En nuestro caso, el CDN no es una alternativa muy buena.
Y en su caso, si tiene algunos requisitos comerciales específicos, puede implementar por su cuenta lo que le he mostrado. Y esto funcionará perfectamente con un perfil de carga similar.
Pero si tiene una solución general y la tarea no es muy particular, puede optar por el CDN sin problemas. O si para usted es mucho más importante el tiempo y los recursos que el control.
Y los CDN modernos tienen prácticamente todo lo que les he contado ahora. A excepción de algunas características, más o menos.
Esto en relación con la entrega de fotos.
Ahora, movámonos un poco hacia adelante en nuestra retrospectiva y hablemos sobre almacenamiento.
El año 2013 estaba en curso.
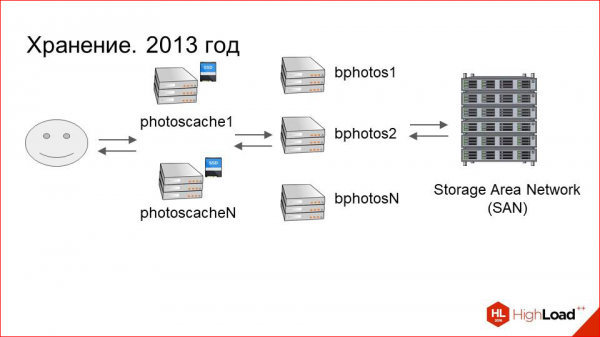
Los servidores de caché se han añadido, los problemas de rendimiento han desaparecido. Todo está bien. El conjunto de datos está creciendo. En 2013 teníamos alrededor de 80 servidores conectados a los almacenamiento, y aproximadamente 40 servidores de caché en cada centro de datos. Esto equivale a 560 terabytes de datos en cada centro de datos, es decir, aproximadamente un petabyte en total.
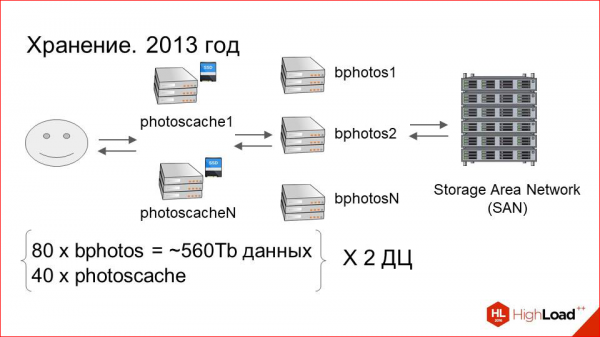
Y con el crecimiento del conjunto de datos, los costos operativos comenzaron a aumentar significativamente. ¿En qué se manifestaba esto?
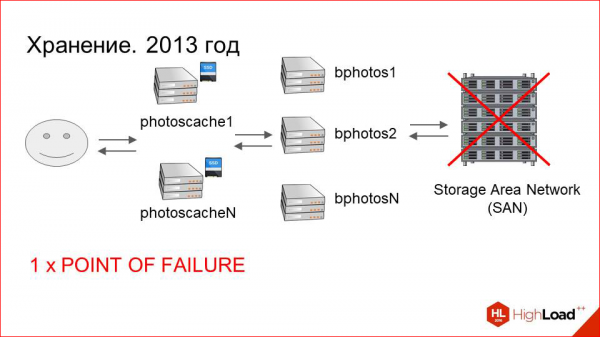
En este esquema, que está representado, con el SAN, las máquinas conectadas a él y las cachés, hay muchos puntos de fallo. Mientras que con la falla de los servidores de caché ya habíamos logrado resolverlo, allí todo es más o menos predecible y entendible, en el lado del almacenamiento la situación era mucho peor.
Primero, la propia Red de Área de Almacenamiento (SAN), que puede fallar.
En segundo lugar, está conectada por fibra óptica a las máquinas finales. Pueden haber problemas con las tarjetas ópticas y los switches.
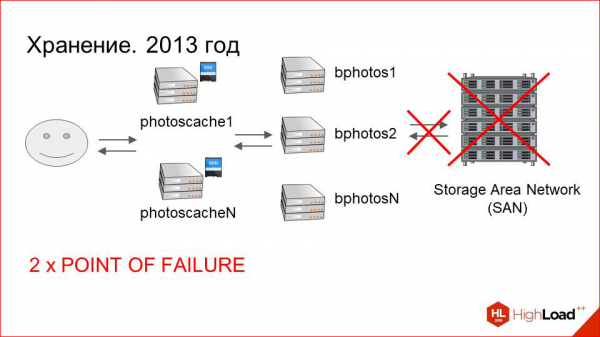
Claro que no son tan numerosos como con el propio SAN, pero, aun así, son puntos de fallo.
Luego está la propia máquina que está conectada al almacenamiento. También puede fallar.
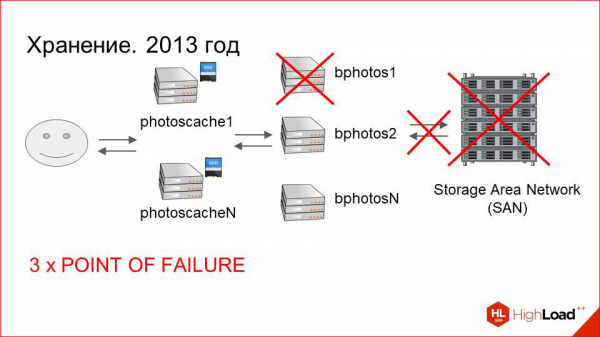
En total, tenemos tres puntos de fallo.
Además, aparte de los puntos de fallo, el mantenimiento de las propias unidades de almacenamiento es complejo.
Es un sistema multicompontente complicado, y a veces es difícil para los ingenieros de sistemas.
Y por último, el punto más importante. Si ocurre una falla en cualquiera de estos tres puntos, existe una probabilidad no nula de perder datos del usuario, ya que el sistema de archivos puede dañarse.
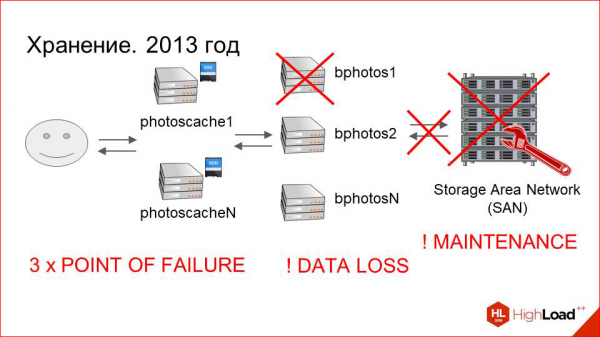
Supongamos que nuestro sistema de archivos se ha dañado. Su recuperación lleva, en primer lugar, mucho tiempo — puede tardar una semana con un gran volumen de datos. Y en segundo lugar, lo más probable es que terminemos con un montón de archivos desconocidos que hay que relacionar de alguna manera con las fotos de los usuarios. Y corremos el riesgo de perder datos. El riesgo es bastante alto. Cuanto más a menudo ocurren tales situaciones, y cuanto más problemas surgen en toda esta cadena, mayor es este riesgo.
Tenía que hacerse algo al respecto. Y decidimos que simplemente debíamos respaldar los datos. Esta es en realidad una solución obvia y buena. ¿Qué hicimos?
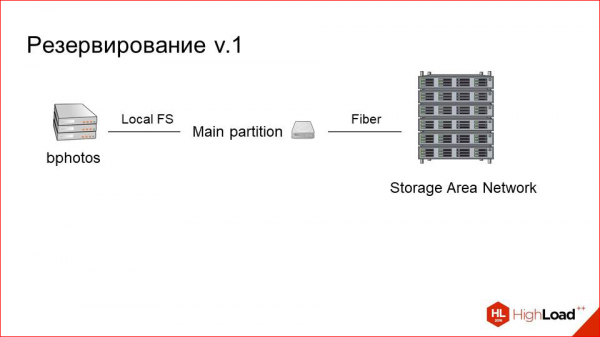
Así es como se veía nuestro servidor, que estaba conectado al almacenamiento antes. Es una partición principal, simplemente un dispositivo de bloques que de hecho representa un montaje en el almacenamiento remoto a través de fibra óptica.
Simplemente añadimos una segunda partición.
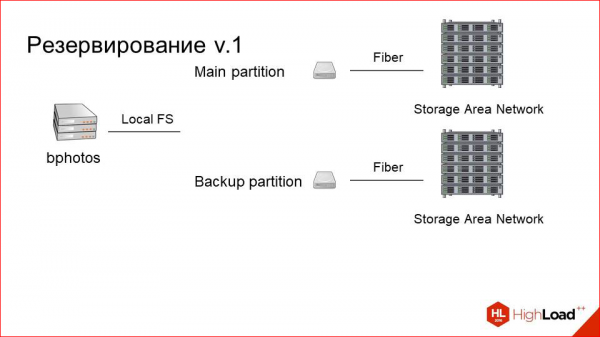
Colocamos un segundo almacenamiento al lado (afortunadamente, no fue tan costoso) y lo llamamos sección de respaldo. También está conectado por fibra óptica, en la misma máquina. Pero necesitamos sincronizar los datos entre ellos de alguna manera.
Aquí simplemente creamos una cola asíncrona al lado.
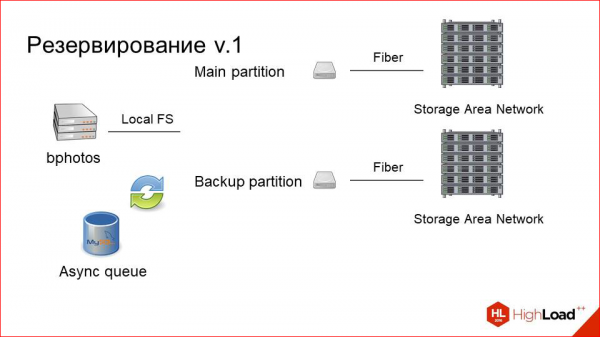
No está muy cargada. Sabemos que tenemos pocas entradas. La cola es simplemente una tabla en MySQL donde se escriben líneas como "necesito hacer una copia de seguridad de esta fotografía". En cualquier cambio o al subir, copiamos desde la sección principal a la de respaldo de forma asíncrona o simplemente con algún trabajador en segundo plano.
Y así, siempre tenemos dos secciones consistentes. Incluso si una parte de este sistema falla, siempre podemos cambiar la sección principal con la de respaldo, y todo seguirá funcionando.
Pero debido a esto, la carga de lectura aumenta significativamente, ya que, además de los clientes que leen desde la sección principal (porque primero ven la fotografía allí, ya que está más actualizada), luego buscan en la de respaldo si no la encuentran (pero esto lo gestiona simplemente NGINX), nuestra sistema de respaldo también lee desde la sección principal. No es que sea un punto crítico, pero no queríamos aumentar la carga innecesariamente.
Y añadimos un tercer disco, que es un pequeño SSD, y lo llamamos búfer.
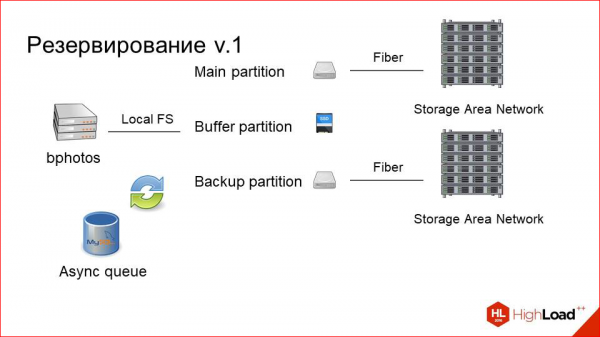
Así es como funciona ahora.
El usuario sube una foto al búfer, luego se envía un evento a la cola informando que debe copiarse en las dos secciones. Se copia, y la fotografía vive en el búfer por un tiempo (digamos, un día) antes de ser purgada. Esto mejora significativamente la experiencia del usuario, porque cuando el usuario sube la fotografía, generalmente recibe solicitudes inmediatamente después, o actualiza la página. Pero todo depende de la aplicación que realiza la carga.
O, por ejemplo, otras personas a las que se les empieza a mostrar la foto envían también solicitudes de inmediato. En la caché aún no está, la primera solicitud se realiza muy rápido. En esencia, es como el caché de fotos. El almacenamiento lento no participa en esto. Y cuando sea purgada después de un día, ya estará almacenada en nuestra capa de caché, o es probable que ya no le interese a nadie. Es decir, la experiencia del usuario ha mejorado mucho gracias a estas simples manipulaciones.
Y lo más importante: hemos dejado de perder datos.
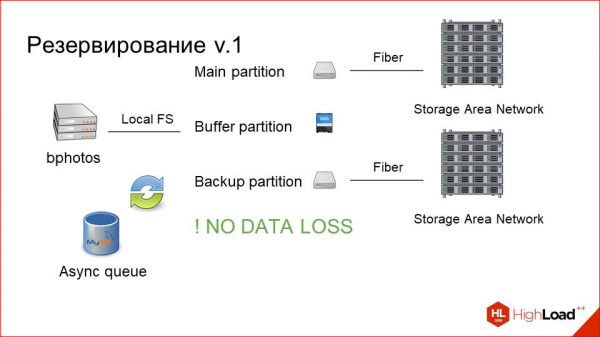
Digamos que hemos dejado de hacerlo. potencialmente perder datos, porque realmente no los perdimos. Pero había un peligro. Vemos que esta solución, por supuesto, es buena, pero se asemeja un poco a tratar los síntomas del problema en lugar de resolverlo por completo. Y aquí algunos problemas quedaron.
En primer lugar, existe un punto de fallo en forma del propio host físico, en el que toda esta maquinaria opera, y no ha desaparecido.
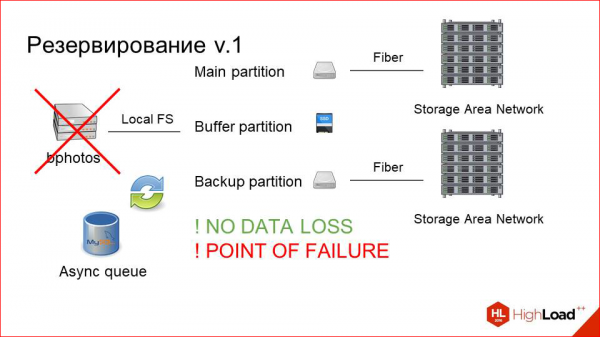
En segundo lugar, quedan problemas con los SAN, su mantenimiento pesado, etc. No era un factor crítico, pero nos gustaría intentar vivir sin ello.
Y hicimos una tercera versión (en realidad, es la segunda) — la versión de respaldo. ¿Cómo fue eso?
Esto es lo que había –
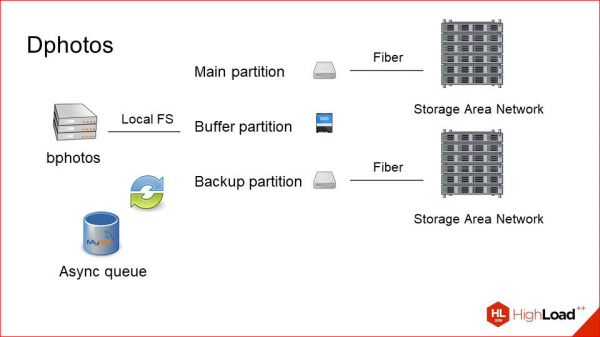
Nuestros principales problemas son que es un host físico.
Primero, eliminamos los SAN porque queremos experimentar, queremos probar simplemente discos duros locales.
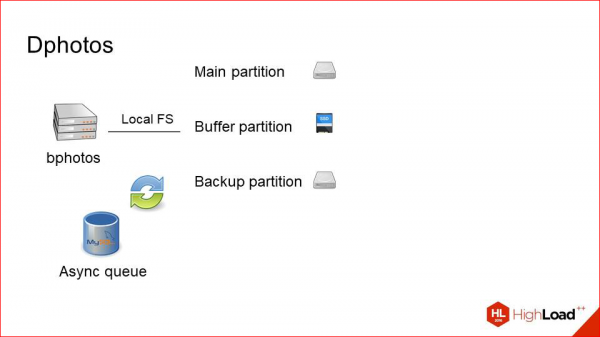
Ya era 2014-2015, y en ese momento la situación con los discos y su capacidad en un solo host había mejorado considerablemente. Decidimos, ¿por qué no intentarlo?
Y luego simplemente tomamos nuestra partición de respaldo y la trasladamos físicamente a una máquina separada.
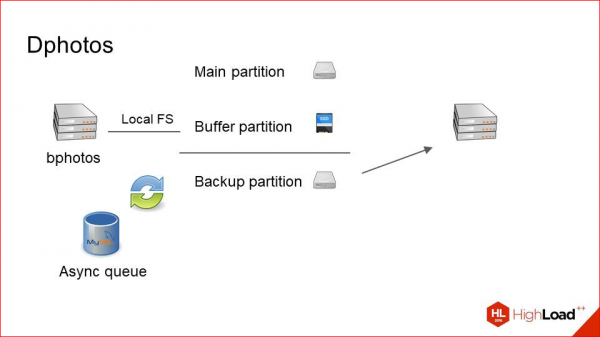
De esta manera, obtenemos un esquema como este. Tenemos dos máquinas que almacenan los mismos conjuntos de datos. Se respaldan mutuamente por completo y sincronizan los datos a través de la red mediante una cola asíncrona en el mismo MySQL.
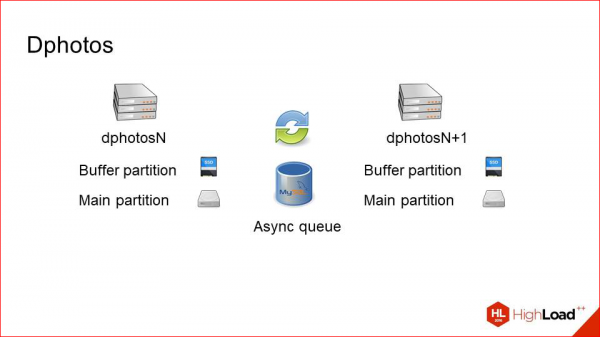
¿Por qué esto funciona bien? Porque tenemos pocas escrituras. Es decir, si la escritura fuera comparable a la lectura, probablemente tendríamos algún overhead de red y problemas. Hay pocas escrituras, muchas lecturas — este método funciona bien, es decir, rara vez copiamos fotos entre estos dos servidores.
¿Cómo funciona esto, si miramos un poco más en detalle?
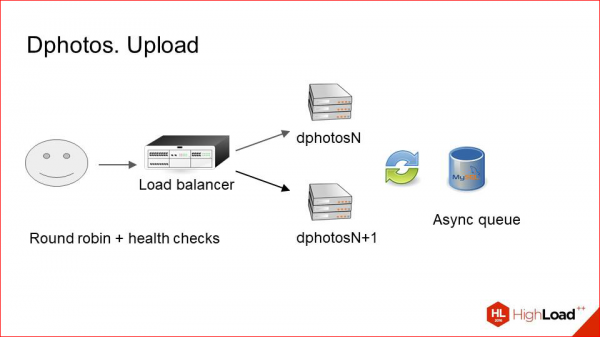
Subida. El balanceador simplemente elige hosts aleatorios de un par y hace la carga en uno de ellos. Al mismo tiempo, por supuesto, realiza controles de salud, revisa que la máquina no haya caído. Es decir, solo carga fotos en un servidor activo, y luego, a través de una cola asíncrona, se copia todo a su vecino. Con la carga, todo es simplemente claro.
La tarea es un poco más complicada.
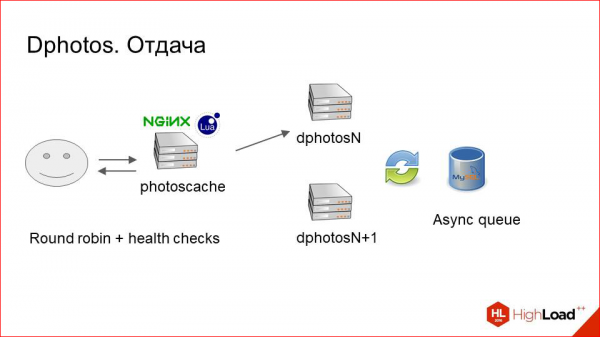
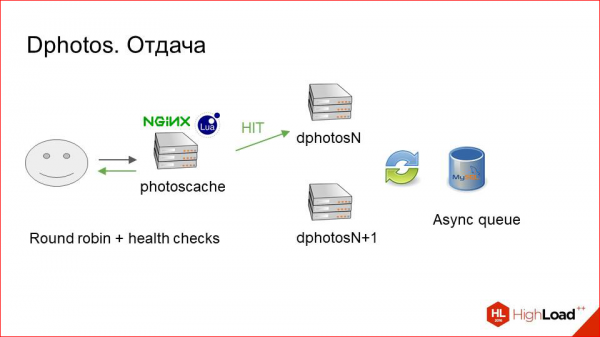
Aquí nos ayudó Lua, porque en NGINX vanilla es complicado implementar tal lógica. Primero hacemos una solicitud al primer servidor, verificamos si la fotografía está ahí, porque potencialmente podría haberse subido, por ejemplo, al vecino, y aquí todavía no ha llegado. Si la fotografía está ahí, es genial. La entregamos de inmediato al cliente y, posiblemente, la almacenamos en caché.
Si no está, simplemente hacemos una solicitud al vecino y allí la obtenemos garantizadamente.
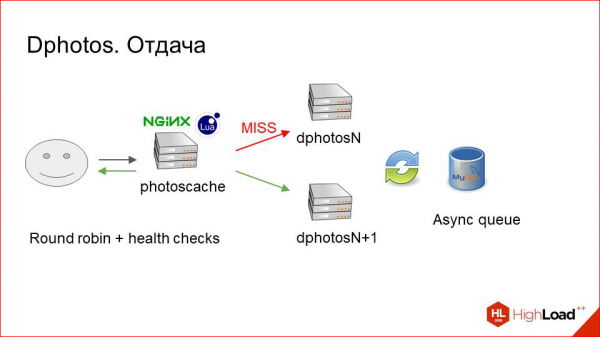
Así que, nuevamente se puede decir: pueden haber problemas con el rendimiento, porque los constantes viajes de ida y vuelta — se subió la fotografía, aquí no está, hacemos dos solicitudes en lugar de una, eso debería funcionar lentamente.
En nuestra situación, esto no funciona lentamente.
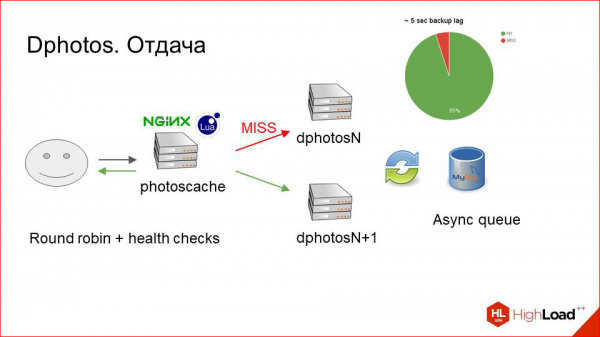
Estamos recopilando un montón de métricas sobre este sistema, y la tasa de aciertos de dicho mecanismo es de aproximadamente 95%. Es decir, la latencia de este respaldo es pequeña, y gracias a eso prácticamente garantizamos que después de que la foto ha sido cargada, la recuperamos en el primer intento y no tenemos que ir dos veces.
Así que, ¿qué más hemos conseguido, y qué es realmente genial?
Antes teníamos la sección principal de respaldo, y leíamos de forma secuencial. Es decir, siempre buscábamos primero en la principal y luego en el respaldo. Era un solo recorrido.
Ahora estamos utilizando la lectura de dos máquinas simultáneamente. Distribuimos las solicitudes en Round Robin. En un pequeño porcentaje de casos hacemos dos solicitudes. Pero en general ahora tenemos el doble de capacidad de lectura que antes. Y la carga ha disminuido significativamente, tanto en las máquinas que entregan, como en los storages que teníamos en ese momento.
En cuanto a la resistencia a fallos. En realidad, eso era con lo que principalmente luchábamos. La resistencia a fallos ha resultado ser fantástica aquí.
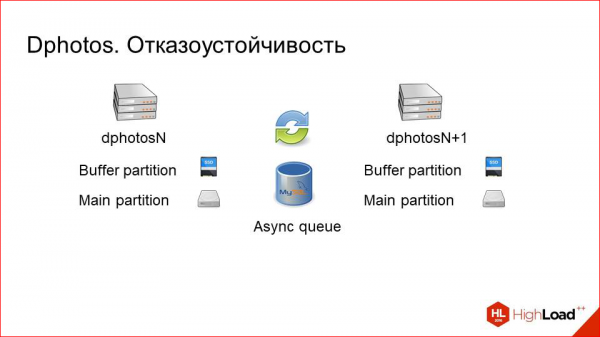
Una máquina deja de funcionar.
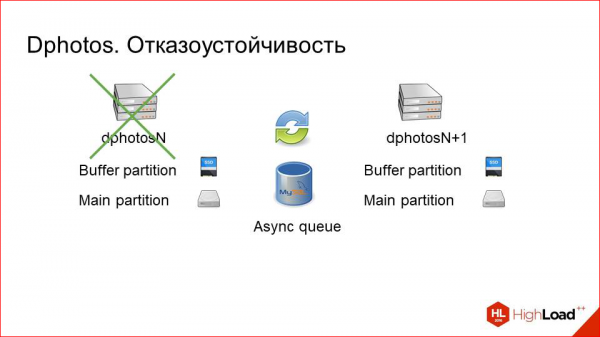
¡Sin problemas! El ingeniero de sistemas ni siquiera tiene que despertarse por la noche, puede esperar hasta la mañana, no pasará nada.
Incluso si, al fallar esta máquina, se interrumpe la cola, tampoco hay problemas, simplemente el registro comenzará a acumularse primero en la máquina viva, y luego pasará a la cola, y después a aquella máquina que volverá a estar operativa después de un tiempo.
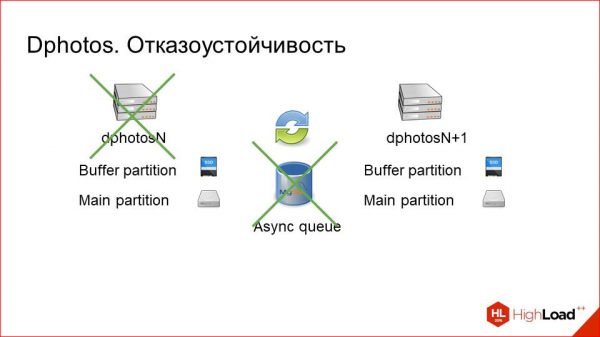
Lo mismo ocurre con el mantenimiento. Simplemente apagamos una de las máquinas, la sacamos manualmente de todos los grupos, deja de recibir tráfico, realizamos algún mantenimiento, hacemos algunos ajustes y luego la reincorporamos. Este backup se recupera bastante rápido. Es decir, un día de inactividad de una máquina se compensa en un par de minutos. Eso es realmente muy poco. Con la tolerancia a fallos, como dije, aquí todo funciona muy bien.
¿Qué conclusiones se pueden sacar de este esquema de redundancia?
Hemos conseguido tolerancia a fallos.
Explotación sencilla. Dado que las máquinas tienen discos duros locales, esto es mucho más conveniente desde el punto de vista de los ingenieros que trabajan con ellos.
Hemos logrado un doble margen para la lectura.
Esto es un muy buen bonus además de la tolerancia a fallos.
Pero también hay problemas. Ahora tenemos un desarrollo mucho más complicado de algunas características relacionadas, porque el sistema se ha vuelto 100% eventualmente consistente.
Debemos, digamos, en algún trabajo en segundo plano, estar siempre pensando: '¿En qué servidor estamos ahora?', '¿Hay aquí una foto actualizada?' y así sucesivamente. Esto, por supuesto, está envuelto en capas, y para el programador que escribe la lógica de negocio, es transparente. Pero, sin embargo, ha aparecido una capa compleja considerable. Pero estamos dispuestos a lidiar con esto a cambio de las ventajas que hemos obtenido.
Y aquí de nuevo surge un cierto conflicto.
Al principio dije que almacenar todo en discos duros locales es malo. Y ahora digo que nos ha gustado.
Sí, realmente con el tiempo la situación ha cambiado mucho y ahora este enfoque tiene muchas ventajas. En primer lugar, obtenemos una explotación mucho más sencilla.
En segundo lugar, es más eficiente porque no tenemos esos controladores automáticos y conexiones a estanterías de discos.
Allí hay una maquinaria enorme, mientras que aquí solo hay unos pocos discos que están configurados en RAID en la máquina.
Pero también hay desventajas.
Es aproximadamente 1.5 veces más caro que usar SAN, incluso a los precios de hoy. Por lo tanto, decidimos no convertir todo nuestro gran clúster en máquinas con discos duros locales y optamos por dejar una solución híbrida.
Casi la mitad de nuestras máquinas trabaja con discos duros (bueno, no la mitad, probablemente alrededor del 30%). Y el resto son máquinas antiguas, en las que antes había un primer esquema de respaldo. Simplemente las reconfiguramos, ya que no necesitamos nuevos datos ni nada más, solo movimos los montajes de un anfitrión físico a dos.
Y ahora tenemos un gran margen en lectura, y hemos ampliado. Antes montábamos un almacenamiento por máquina, ahora montamos cuatro en una pareja, por ejemplo. Y eso funciona bien.
Vamos a hacer un breve resumen de lo que hemos logrado, por qué luchamos y si lo conseguimos.
Resultados
Tenemos usuarios: un total de 33 millones.
Contamos con tres puntos de presencia: Praga, Miami, Hong Kong.
En ellos hay una capa de caché, que consiste en máquinas con discos locales rápidos (SSD), en las que opera un simple sistema basado en NGINX, su access.log y demonios en Python que procesan y gestionan la caché.
Si lo deseas, en tu proyecto, si las fotos no son tan críticas para ti como para nosotros, o si el intercambio entre control y velocidad de desarrollo y gasto de recursos te favorece en otro sentido, entonces puedes reemplazarlo por un CDN, que los modernos hacen muy bien.
A continuación, está la capa de almacenamiento, donde tenemos clústeres de pares de máquinas que se respaldan entre sí, los archivos se copian de uno a otro de forma asíncrona ante cualquier cambio.
Parte de estas máquinas trabaja con discos duros locales.
Parte de estas máquinas están conectadas a SAN.
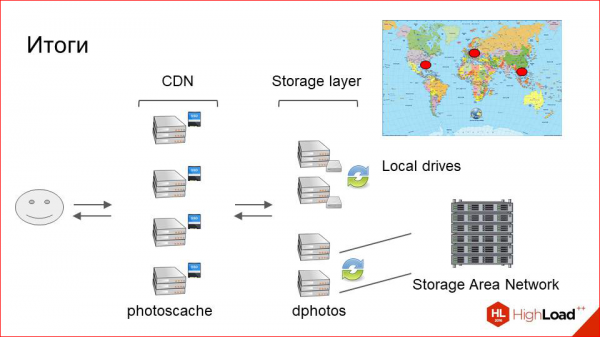
Y, por un lado, esto es más conveniente en la operación y un poco más eficiente; por otro lado, es cómodo en términos de densidad de colocación y costo por gigabyte.
Esta es una breve revisión de la arquitectura de lo que hemos logrado y cómo ha evolucionado todo esto.
Un par de consejos sencillos del jefe.
Primero, si alguna vez decides que necesitas mejorar urgentemente toda tu infraestructura de fotos, primero mide, porque puede que no necesites mejorar nada.
Un ejemplo. Tenemos un clúster de máquinas que entrega fotos desde los attachments en los chats, y allí todavía funciona un esquema de 2009, y nadie se queja. A todos les va bien, a todos les gusta.
Para medir, primero necesitas establecer una serie de métricas, observarlas y luego decidir qué te desagrada y qué necesitas mejorar. Para medir esto, tenemos una herramienta genial llamada Pinba.
Permite recopilar estadísticas de NGINX de manera muy detallada para cada solicitud y códigos de respuesta, así como la distribución de tiempos: todo lo que desees. Tiene integraciones con diferentes sistemas de análisis, y luego puedes visualizar todo esto de manera clara.
Primero medimos, luego mejoramos.
A continuación. Optimizar la lectura con caché, la escritura con particionamiento, pero este es un punto obvio.
A continuación. Si estás comenzando a construir tu sistema, es mucho mejor tratar las imágenes como archivos inmutables. Esto te evita perder una clase entera de problemas relacionados con la invalidación de caché y con la lógica que debe encontrar la versión correcta de la imagen, entre otros.
Supongamos que subiste una foto y luego la rotaste; asegúrate de que sea un archivo físicamente diferente. Es decir, no pienses: voy a ahorrar un poco de espacio, grabando en el mismo archivo y cambiando la versión. Esto siempre resulta contraproducente y genera muchos dolores de cabeza después.
El siguiente punto. Sobre el redimensionamiento en tiempo real.
Antes, cuando los usuarios subían una foto, cortábamos un montón de tamaños para todas las eventualidades, para diferentes clientes, y todos estaban almacenados en el disco. Ahora hemos abandonado esa práctica.
Hemos conservado solo tres tamaños básicos: pequeño, mediano y grande. Todo lo demás lo redimensionamos a partir del tamaño que se solicita en Uport, simplemente hacemos un downscale y se lo entregamos al usuario.
El costo de la capa de caché de CPU es mucho menor aquí que si tuviéramos que regenerar continuamente esos tamaños en cada almacenamiento. Supongamos que queremos añadir uno nuevo, eso puede tardar un mes: ejecutar un script en todas partes que haga esto cuidadosamente sin colapsar el clúster. Es decir, si hay posibilidad de elección, es mejor tener la menor cantidad posible de tamaños físicos, pero mantener alguna distribución, digamos, tres. Y el resto simplemente redimensionarlo sobre la marcha utilizando módulos ya disponibles. Esto es ahora muy fácil y accesible.
Y una copia de seguridad incremental asíncrona es algo bueno.
Nuestra experiencia ha demostrado que este esquema funciona muy bien con la copia diferida de archivos modificados.
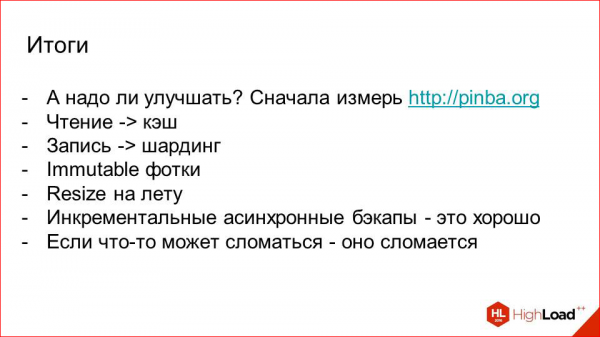
El último punto también es obvio. Si en su infraestructura actualmente no hay estos problemas, pero hay algo que puede fallar, seguramente fallará cuando ese algo aumente un poco. Por lo tanto, es mejor pensar en esto de antemano y no experimentar problemas en el camino. Eso es todo de mi parte.
Contactos
»
»
Este informe es la transcripción de una de las mejores presentaciones en la conferencia de desarrolladores de sistemas de alta carga . Queda menos de un mes para la conferencia HighLoad++ 2017.
Ya tenemos listo , actualmente se está formando el horario.
Este año continuamos explorando el tema de arquitecturas y escalado:
- / Игорь Васильев
- / Дмитрий Егоров
- / Анатолий Пласковский
- / Роман Шеховцов, Алексей Громатчиков
- / Филипп Дельгядо
También algunos de estos materiales son utilizados por nosotros en un curso en línea de formación en desarrollo de sistemas de alta carga es una cadena de cartas, artículos, materiales y videos cuidadosamente seleccionados. Ya en nuestro libro de texto hay más de 30 materiales únicos. ¡Únete!
Fuente: habr.com
