

¿Cómo se pueden traducir los requisitos del negocio en estructuras de datos específicas tomando como ejemplo el diseño de una base de datos de mensajería desde cero?
- Parte 1: diseñamos la estructura de la base
Nuestra base no será tan masiva y distribuida, o , sino que será 'suficiente', pero bien, es decir, funcional, rápida y que quepa en un solo servidor PostgreSQL – para poder desplegar una instancia separada del servicio en algún lugar, por ejemplo.
Por lo tanto, no abordaremos cuestiones de sharding, replicación y sistemas geodistribuidos, sino que nos enfocaremos en soluciones esquemáticas dentro de la base de datos.
Paso 1: un poco de especificidad del negocio
No vamos a diseñar nuestro sistema de mensajería de forma abstracta, sino que lo integraremos en el entorno . Es decir, las personas no 'simplemente intercambian mensajes', sino que se comunican entre sí en el contexto de la solución de ciertos problemas de negocio.
¿Qué tipo de problemas enfrenta el negocio?.. Veamos el ejemplo de Vasily, el jefe del departamento de desarrollo.
- ‘Nikolai, ¡necesitamos un parche para esta tarea hoy!’
Por lo tanto, la conversación puede llevarse a cabo en el contexto de algún del documento. - ‘¿Kolia, vamos esta noche a Dota?’
Es decir, incluso en una pareja de interlocutores, la comunicación puede ocurrir simultáneamente sobre diferentes temas. - ‘Petr, Nikolai, miren en el adjunto el precio del nuevo servidor.’
Así, un mensaje puede tener varios destinatarios. Al mismo tiempo, el mensaje puede contener archivos adjuntos. - ‘Semyon, tú también echa un vistazo.’
Y debe haber la posibilidad de invitar a un nuevo participante a la conversación que ya existe. Detengámonos por ahora en esta lista de necesidades 'evidentes'..
Sin entender la especificidad aplicada de la tarea y las limitaciones que impone, es prácticamente imposible diseñar
un esquema de base de datos eficaz para su solución. Paso 2: esquema lógico mínimo
Por ahora, el esquema se parece mucho a una conversación por correo electrónico, una herramienta tradicional para llevar a cabo negocios. Así que sí, ‘algorítmicamente’ muchos problemas de negocio son similares entre sí, por lo que las herramientas para resolverlos también serán estructuralmente similares.
Vamos a fijar el esquema lógico de relaciones entre entidades ya obtenido. Para facilitar la comprensión de nuestro modelo, utilizaremos la variante más primitiva de representación
del modelo ER sin complicaciones de UML o notaciones IDEF:
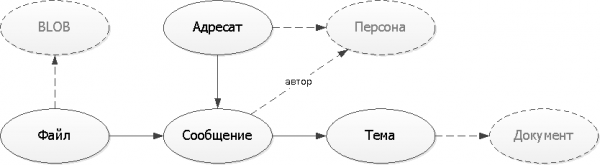
En nuestro ejemplo, el personaje, el documento y el «cuerpo» binario del archivo son entidades «externas» que existen por sí solas, incluso sin nuestro servicio. Por lo tanto, simplemente las consideraremos a partir de ahora como enlaces «hacia» algo mediante UUID.
Dibujen diagramas lo más simples posible — la mayoría de aquellos a quienes se los mostrarán no son expertos en leer UML/IDEF. Pero — dibujen sin falta.
Paso 3: Esbozamos la estructura de las tablas
Sobre los nombres de las tablas y los camposSe pueden tener diferentes opiniones sobre los nombres 'rusos' de campos y tablas, pero es cuestión de gusto. Dado que no tenemos desarrolladores extranjeros, y PostgreSQL nos permite nombrar incluso con jeroglíficos, siempre que estén entre comillas, preferimos nombrar los objetos de forma clara y comprensible para evitar malentendidos.
Dado que muchos autores escriben los mensajes al mismo tiempo, algunos de ellos pueden hacerlo fuera de línea, la opción más sencilla es usar UUID como identificadores no solo para entidades externas, sino también para todos los objetos dentro de nuestro servicio. Además, se pueden generar incluso del lado del cliente — esto nos ayudará a mantener el envío de mensajes durante la breve indisponibilidad de la base de datos, y la probabilidad de colisiones es extremadamente baja.
La estructura preliminar de las tablas en nuestra base tendrá este aspecto:
Tablas: RU
CREATE TABLE "Tema"(
  "Tema"
    uuid
      PRIMARY KEY
, "Documento"
    uuid
, "Título"
    text
);

CREATE TABLE "Mensaje"(
  "Mensaje"
    uuid
      PRIMARY KEY
, "Tema"
    uuid
, "Autor"
    uuid
, "FechaHora"
    timestamp
, "Texto"
    text
);

CREATE TABLE "Destinatario"(
  "Mensaje"
    uuid
, "Persona"
    uuid
, PRIMARY KEY("Mensaje", "Persona")
);

CREATE TABLE "Archivo"(
  "Archivo"
    uuid
      PRIMARY KEY
, "Mensaje"
    uuid
, "BLOB"
    uuid
, "Nombre"
    text
);
Tablas: EN
CREATE TABLE theme(
  theme
    uuid
      PRIMARY KEY
, document
    uuid
, title
    text
);

CREATE TABLE message(
  message
    uuid
      PRIMARY KEY
, theme
    uuid
, author
    uuid
, dt
    timestamp
, body
    text
);

CREATE TABLE message_addressee(
  message
    uuid
, person
    uuid
, PRIMARY KEY(message, person)
);

CREATE TABLE message_file(
  file
    uuid
      PRIMARY KEY
, message
    uuid
, content
    uuid
, filename
    text
);
Lo más simple al describir el formato es empezar a "desenredar" el gráfico de relaciones a partir de las tablas que no hacen referencia a ninguna.
Paso 4: Identificamos necesidades no evidentes
Ya hemos diseñado una base en la que se puede escribir y de alguna manera leer con facilidad.
Pongámonos en el lugar del usuario de nuestro servicio: ¿qué querríamos hacer con su ayuda?
- Últimos mensajes
Es un registro cronológicamente ordenado de mis mensajes, clasificados por diversos criterios. Donde soy uno de los destinatarios, donde soy el autor, donde me escribieron y no respondí, donde no me respondieron, … - Participantes de la conversación
¿Quiénes participan en este largo, largo chat?
Nuestra estructura permite abordar ambas tareas "en general", pero rápidamente no. El problema es que para la clasificación en el marco de la primera tarea es imposible crear un índice, que sea adecuado para cada uno de los participantes (tendremos que extraer todos los registros), y para resolver la segunda necesitamos extraer todos los mensajes sobre el tema.
Las tareas de usuario no previstas pueden poner un fuerte parón en el rendimiento.
Paso 5: Denormalización razonable
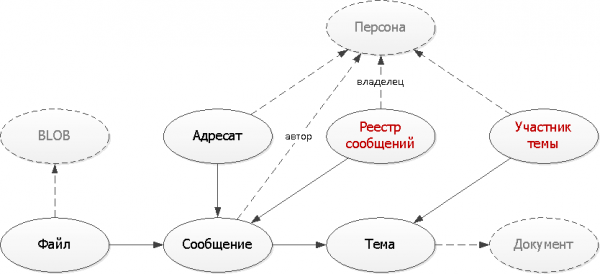
Ambos problemas se pueden resolver con tablas adicionales, en las que vamos a duplicar parte de los datos, necesarios para formar índices adecuados para nuestras tareas sobre ellas.
Tablas: RU
CREATE TABLE "RegistroMensajes"(
  "Propietario"
    uuid
, "TipoRegistro"
    smallint
, "FechaHora"
    timestamp
, "Mensaje"
    uuid
, PRIMARY KEY("Propietario", "TipoRegistro", "Mensaje")
);
CREATE INDEX ON "RegistroMensajes"("Propietario", "TipoRegistro", "FechaHora" DESC);

CREATE TABLE "ParticipanteTema"(
  "Tema"
    uuid
, "Persona"
    uuid
, PRIMARY KEY("Tema", "Persona")
);
Tablas: EN
CREATE TABLE message_registry(
  owner
    uuid
, registry
    smallint
, dt
    timestamp
, message
    uuid
, PRIMARY KEY(owner, registry, message)
);
CREATE INDEX ON message_registry(owner, registry, dt DESC);

CREATE TABLE theme_participant(
  theme
    uuid
, person
    uuid
, PRIMARY KEY(theme, person)
);
Aquí hemos aplicado dos enfoques típicos utilizados al crear tablas auxiliares:
- Multiplicación de registros
Generamos múltiples registros derivativos a partir de un solo registro original de mensaje en diferentes tipos de registros para diferentes propietarios, tanto para el remitente como para el destinatario. Pero cada uno de los registros ahora se ajusta al índice, ya que en un caso típico desearemos ver solo la primera página. - Unificación de registros
Al enviar un mensaje dentro de un tema específico, basta con comprobar si ya existe dicho registro. Si no, lo añadimos a nuestro "diccionario".
En la siguiente parte del artículo hablaremos sobre en nuestra estructura de base de datos.
Fuente: habr.com
