

El 9 de enero se lanzó Pandas 1.0.0rc. La versión anterior de la biblioteca es 0.25.
Este primer lanzamiento mayor contiene muchas novedades maravillosas, incluidas mejoras en la suma automática de DataFrames, más formatos de salida, nuevos tipos de datos y hasta un nuevo sitio de documentación.
Todos los cambios se pueden ver , en este artículo nos limitaremos a un breve y menos técnico resumen de lo más importante.
Puedes instalar la biblioteca como de costumbre usando pip, pero dado que en el momento de escribir este artículo Pandas 1.0 aún es release candidate, será necesario especificar la versión explícitamente:
pip install --upgrade pandas==1.0.0rc0¡Ten cuidado! Dado que este es un lanzamiento mayor, la actualización puede romper el código antiguo.
Por cierto, con esta versión se ha eliminado completamente el soporte para Python 2 (lo que puede ser una buena razón — nota del traductor.). Pandas 1.0 requiere al menos Python 3.6+, así que si no estás seguro, verifica cuál tienes instalado:
$ pip --version
pip 19.3.1 from /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Es más fácil comprobar la versión de Pandas así:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Mejoras en la auto-suma con DataFrame.info
Mi novedad favorita fue la actualización del método DataFrame.info. La función se ha vuelto mucho más legible, lo que hace que el proceso de exploración de datos sea aún más fácil:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["adiós", "cruel", "mundo"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Exportación de tablas en formato Markdown
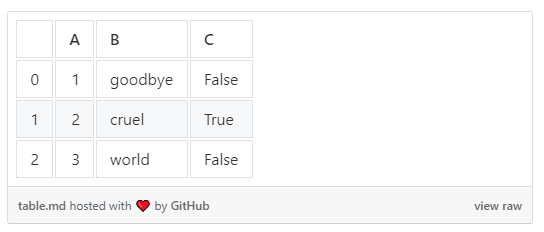
Otra novedad muy agradable fue la posibilidad de exportar DataFrames a tablas Markdown usando DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | adiós   | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | mundo   | False |
Esto simplifica enormemente la publicación de tablas en sitios como Medium usando gists de github.
Nuevos tipos para cadenas y valores booleanos
En el lanzamiento de Pandas 1.0 también se agregaron nuevos experimental tipos. Su API aún puede cambiar, así que úsalo con cuidado. Pero en general, Pandas recomienda usar nuevos tipos en todas partes que tenga sentido.
Por ahora, la conversión debe realizarse explícitamente:
>>> B = pd.Series(["adiós", "cruel", "mundo"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Observe cómo la columna Dtype muestra nuevos tipos — string y bool.
Una de las características más útiles del nuevo tipo de string es la posibilidad de seleccionar solo columnas de string de los dataframes. Esto puede simplificar significativamente el análisis de datos textuales:
df.select_dtypes("string")Anteriormente, no se podían seleccionar columnas de string sin especificar sus nombres explícitamente.
Puede leer más sobre los nuevos tipos .
Gracias por leer. Puede ver la lista completa de cambios, como se mencionó anteriormente, .
Fuente: habr.com
