

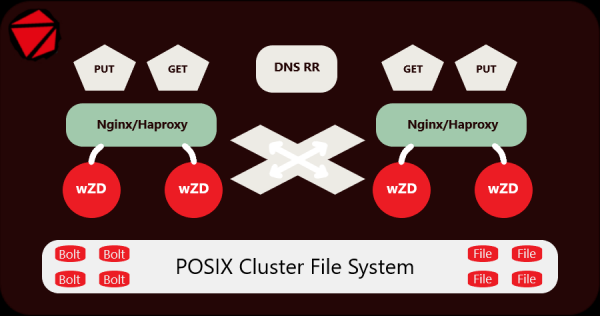
Estimado comunidad, este artículo estará dedicado al almacenamiento y recuperación eficientes de cientos de millones de pequeños archivos. En esta etapa, se presenta una solución final para sistemas de archivos compatibles con POSIX con soporte completo para bloqueos, incluidos los de clúster, y parece que incluso sin parches.
Por lo tanto, para este propósito, escribí mi propio servidor especializado.
A medida que implementaba esta tarea, pude resolver el problema principal y, al mismo tiempo, lograr un ahorro en el espacio en disco y la memoria RAM que consumía nuestra sistemática de archivos en clúster. Tal cantidad de archivos es perjudicial para cualquier sistema de archivos de clúster.
La idea es la siguiente:
En términos simples, a través del servidor se cargan archivos pequeños, que se almacenan directamente en un archivo de archivero, y así también se leen desde él, mientras que los archivos grandes se colocan al lado. Esquema: 1 carpeta = 1 archivo de archivero, lo que resulta en varios millones de archivos de archivero con pequeños archivos, en lugar de varios cientos de millones de archivos. Y todo esto está completamente implementado, sin ningún script y distribuciones de archivos en archivos tar/zip.
Trataré de exponerlo más brevemente, pido disculpas de antemano si la publicación es extensa.
Todo comenzó porque no pude encontrar un servidor adecuado en el mundo que pudiera almacenar datos recibidos a través del protocolo HTTP directamente en archivos de archivero, de manera que no hubiera las desventajas inherentes a los archivos de archivero comunes y a los almacenes de objetos. La razón de la búsqueda fue el clúster de Origin, que se había expandido a gran escala con 10 servidores, y que ya acumulaba 250,000,000 archivos pequeños, mientras que la tendencia de crecimiento no mostraba signos de detenerse.
Para aquellos que no les gusta leer artículos y prefieren una documentación más simple:
y .
Y docker también, ahora hay una opción solo junto con nginx por si acaso:
docker run -d --restart=always -e host=localhost -e root=\/var\/storage
-v \/var\/storage:\/var\/storage --name wzd -p 80:80 eltaline\/wzd
Siguiente:
Si hay muchos archivos, se requieren recursos significativos, y lo más lamentable es que parte de ellos se desperdicia. Por ejemplo, al utilizar un sistema de archivos en clúster (en este caso, MooseFS), un archivo, independientemente de su tamaño real, siempre ocupa un mínimo de 64 KB. Es decir, para archivos de 3, 10 o 30 KB se requieren 64 KB en el disco. Si hay un cuarto de mil millones de archivos, perdemos entre 2 y 10 terabytes. No será posible crear nuevos archivos indefinidamente, ya que en MooseFS hay una limitación: no más de 1 mil millones con una réplica de cada archivo.
A medida que aumenta la cantidad de archivos, se necesita mucha memoria RAM para los metadatos. Además, los frecuentes grandes volúmenes de metadatos contribuyen al desgaste de las unidades SSD.
Servidor wZD. Organizando los discos.
El servidor está escrito en Go. Primero necesitaba reducir la cantidad de archivos. ¿Cómo hacerlo? A través de la archivación, pero en este caso sin compresión, ya que mis archivos son imágenes comprimidas. BoltDB fue de gran ayuda, aunque hubo que eliminarle algunos inconvenientes, lo que está reflejado en la documentación.
En total, en lugar de un cuarto de mil millones de archivos, en mi caso solo quedaron 10 millones de archivos Bolt. Si hubiera tenido la posibilidad de cambiar la estructura actual de llenado de las carpetas, posiblemente se podría haber reducido a aproximadamente 1 millón de archivos.
Todos los archivos pequeños se empaquetan en archivos Bolt, que automáticamente reciben los nombres de las carpetas en las que se encuentran, mientras que todos los archivos grandes permanecen al lado de los archivos comprimidos, no tiene sentido empaquetarlos, esto es configurable. Los pequeños, se archivan, los grandes, se dejan sin cambios. El servidor funciona de manera transparente con ambos.
Arquitectura y características del servidor wZD.
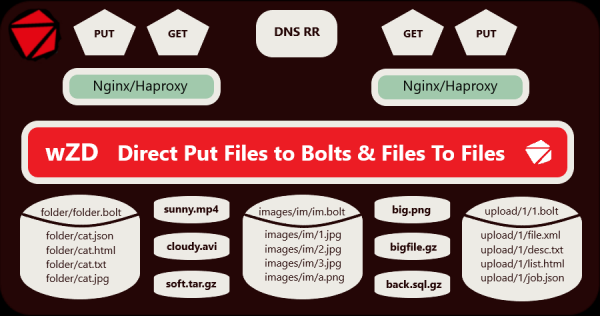
El servidor funciona bajo sistemas operativos Linux, BSD, Solaris y OSX. Solo lo he probado para la arquitectura AMD64 bajo Linux, pero debería ser adecuado también para ARM64, PPC64, MIPS64.
Principales características:
- Servidor de composición y ventanas
- Multiservidoridad, que asegura alta disponibilidad y balanceo de carga;
- Máxima transparencia para el usuario o desarrollador;
- Métodos HTTP soportados: GET, HEAD, PUT y DELETE;
- Control del comportamiento de lectura y escritura a través de encabezados de cliente;
- Soporte para hosts virtuales configurables de manera flexible;
- Soporte para la integridad de datos CRC al escribir/leer;
- Buffers semi-dinámicos para un consumo mínimo de memoria y una configuración óptima del rendimiento de red;
- Compactación de datos diferida;
- Además, se ofrece el archivador multihilo wZA para migrar archivos sin detener el servicio.
Experiencia real:
He estado desarrollando y probando un servidor y un archivador con datos reales durante bastante tiempo, y ahora funciona con éxito en un clúster que incluye 250,000,000 de pequeños archivos (imágenes), repartidos en 15,000,000 de directorios en discos SATA separados. El clúster de 10 servidores actúa como un servidor de origen, instalado detrás de una red CDN. Para su mantenimiento, se utilizan 2 servidores Nginx + 2 servidores wZD.
Aquellos que decidan utilizar este servidor deben planificar la estructura de directorios antes de usarlo, si es aplicable. Aclaro de inmediato que el servidor no está diseñado para que todo se concentre en un archivo Bolt.
Pruebas de rendimiento:
Cuanto menor sea el tamaño del archivo comprimido, más rápidas serán las operaciones GET y PUT realizadas con él. Compararemos el tiempo total de escritura de un cliente HTTP en archivos normales y en archivos Bolt, así como la lectura. Se comparan archivos de 32 KB, 256 KB, 1024 KB, 4096 KB y 32768 KB.
Al trabajar con archivos Bolt, se verifica la integridad de los datos de cada archivo (se utiliza CRC), antes de la escritura y también se realiza una lectura en tiempo real y un recálculo después de la escritura, lo cual naturalmente introduce retrasos, pero lo más importante es la seguridad de los datos.
Realicé pruebas de rendimiento en unidades SSD, ya que en discos SATA las pruebas no muestran una diferencia clara.
Gráficos de los resultados de las pruebas:
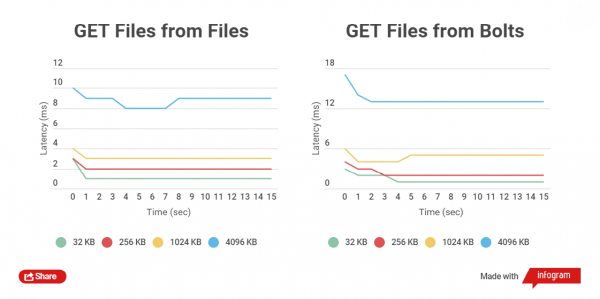
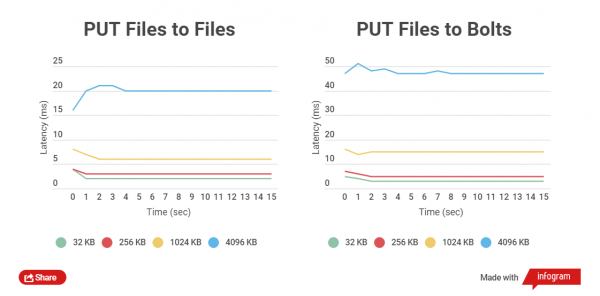
Como se puede ver, para archivos pequeños la diferencia en el tiempo de lectura y escritura entre archivos comprimidos y no comprimidos no es significativa.
Ya obtendremos una imagen completamente diferente al probar la lectura y escritura de archivos de 32 MB:
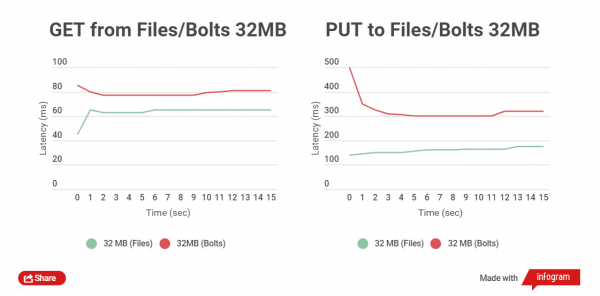
La diferencia de tiempo entre la lectura de archivos es de entre 5-25 ms. La escritura es un poco peor, con una diferencia de aproximadamente 150 ms. Pero en este caso, no se requiere subir archivos grandes, no tiene sentido, pueden existir por separado de los archivos comprimidos.
*Técnicamente, este servidor también se puede usar para tareas que requieren NoSQL.
Métodos principales de trabajo con el servidor wZD:
Subida de un archivo normal:
curl -X PUT --data-binary @test.jpg http://localhost/test/test.jpgSubida de un archivo en un archivo Bolt (si no se supera el parámetro del servidor fmaxsize, que determina el tamaño máximo de archivo que puede incluirse en el archivo, si se supera, el archivo se cargará normalmente junto al archivo):
curl -X PUT -H "Archive: 1" --data-binary @test.jpg http://localhost/test/test.jpgDescarga de archivo (si hay archivos con los mismos nombres en el disco y en el archivo comprimido, al descargar se da prioridad por defecto al archivo no comprimido):
curl -o test.jpg http://localhost/test/test.jpgDescarga de archivo del archivo Bolt (forzado):
curl -o test.jpg -H "FromArchive: 1" http://localhost/test/test.jpgLa descripción de otros métodos está en la documentación.
El servidor solo admite el protocolo HTTP por el momento; HTTPS aún no está operativo. También, el método POST no es compatible (aún no se ha decidido si es necesario o no).
Quien examine el código fuente encontrará un dulce, no a todos les gusta, pero no he vinculado el código principal a las funciones del marco web, excepto al manejador de interrupciones, así que en el futuro puedo reescribirlo rápidamente en casi cualquier motor.
ToDo:
- Desarrollo de un replicador y distribuidor propio + geolocalización para su uso en sistemas grandes sin sistemas de archivos en clúster (todo de manera profesional)
- Posibilidad de recuperación inversa total de metadatos en caso de pérdida total (si se usa el distribuidor)
- Protocolo nativo para permitir el uso de conexiones de red permanentes y controladores para diferentes lenguajes de programación
- Funcionalidades avanzadas para el uso de componentes NoSQL
- Compresiones de diferentes tipos (gzip, zstd, snappy) para archivos o valores dentro de los archivos Bolt y para archivos comunes
- Cifrado de diferentes tipos para archivos o valores dentro de los archivos Bolt y para archivos comunes
- Conversión de video en servidor diferido, incluyendo en GPU
Eso es todo, espero que este servidor le sea útil a alguien, licencia BSD-3, copyright dual, ya que si no fuera por la empresa donde trabajo, no habría escrito el servidor. Soy el único desarrollador. Agradecería los errores encontrados y las solicitudes de características.
Fuente: habr.com
