

Todos hablan sobre los procesos de desarrollo y pruebas, capacitación de personal, aumento de la motivación, pero esos procesos son insuficientes cuando un minuto de inactividad del servicio cuesta una fortuna. ¿Qué hacer cuando realizas transacciones financieras bajo un SLA estricto? ¿Cómo aumentar la fiabilidad y resistencia a fallos de tus sistemas, dejando de lado el desarrollo y las pruebas?
La próxima conferencia HighLoad++ se llevará a cabo el 6 y 7 de abril de 2020 en San Petersburgo. Más detalles y entradas en . 9 de noviembre, 18:00. HighLoad++ Moscú 2018, sala "Delhi + Calcuta". Las ponencias y .
Evgeny Kuzovlev (en adelante – EK): – Amigos, ¡hola! Me llamo Evgeny Kuzovlev. Soy de la empresa EcommPay, específicamente del departamento EcommPay IT, la división de TI del grupo de empresas. Y hoy vamos a hablar sobre el tiempo de inactividad: cómo evitarlo y cómo minimizar sus consecuencias si no es posible evitarlo. El tema está planteado así: “¿Qué hacer cuando un minuto de inactividad cuesta 100,000 dólares”? Avanzando, los números son comparables.
¿A qué se dedica EcommPay IT?
¿Quiénes somos? ¿Por qué estoy aquí delante de ustedes? ¿Por qué tengo derecho a contarles algo aquí? ¿Y sobre qué hablaremos aquí más en detalle?
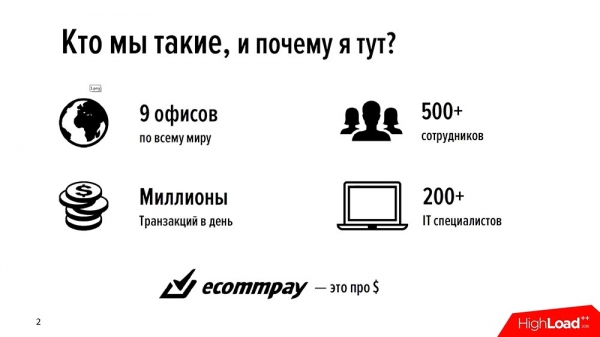
El grupo de empresas EcommPay es un procesador internacional de pagos. Procesamos pagos en todo el mundo: en Rusia, Europa y en el Sudeste Asiático (All Around the World). Tenemos 9 oficinas, 500 empleados en total y aproximadamente un poco menos de la mitad son especialistas en TI. Todo lo que hacemos, todo lo que genera ingresos, lo hemos hecho nosotros mismos.
Todos nuestros productos (y tenemos bastante, en nuestra línea de grandes productos de TI contamos con alrededor de 16 componentes distintos) los hemos desarrollado nosotros; nosotros mismos programamos, nosotros mismos los mejoramos. Actualmente realizamos cerca de un millón de transacciones al día (millones, probablemente así sería correcto decir). Somos una empresa relativamente joven: tenemos alrededor de seis años.
Hace 6 años, era una startup cuando llegaron unos chicos con un negocio. Estaban unidos por una idea (no había nada más que la idea), y salimos corriendo. Como cualquier startup, corríamos más rápido... Para nosotros era más importante la velocidad que la calidad.
En algún momento nos detuvimos: nos dimos cuenta de que ya no podíamos vivir con esa velocidad y con esa calidad, y que necesitábamos enfocarnos ante todo en la calidad. En ese momento, tomamos la decisión de escribir una nueva plataforma que fuera adecuada, escalable y confiable. Comenzamos a desarrollar esta plataforma (empezamos a invertir, desarrollar, probar), pero en algún momento nos dimos cuenta de que el desarrollo y las pruebas no nos permitían alcanzar un nuevo nivel de calidad del servicio.
Usted crea un nuevo producto, lo pone en producción, pero de todos modos algo puede salir mal. Hoy hablaremos sobre cómo alcanzar un nuevo nivel de calidad (cómo lo logramos, nuestra experiencia), dejando de lado el desarrollo y las pruebas; hablaremos sobre lo que está disponible para la explotación: lo que la explotación puede hacer por sí misma y lo que puede ofrecer a las pruebas para influir en la calidad.
Tiempos de inactividad. Mandamientos de la explotación.
Siempre, la piedra angular de lo que vamos a hablar hoy es el tiempo de inactividad. Una palabra temible. Si experimentamos un tiempo de inactividad, todo está mal. Corremos para levantarlo, los administradores sostienen el servidor: Dios quiera que no caiga, como se dice en esa canción. Eso es lo que vamos a discutir hoy.
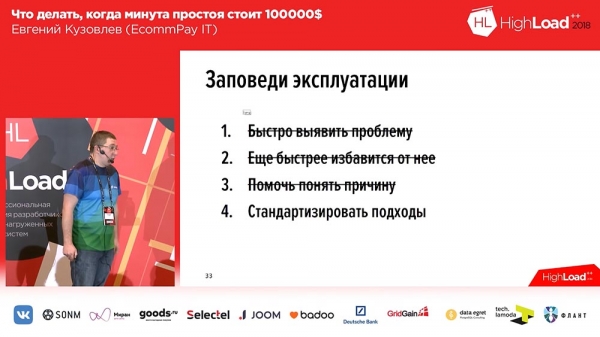
Cuando comenzamos a cambiar nuestro enfoque, formulamos 4 mandamientos. Los tengo presentados en las diapositivas:
Estos mandamientos son bastante simples:
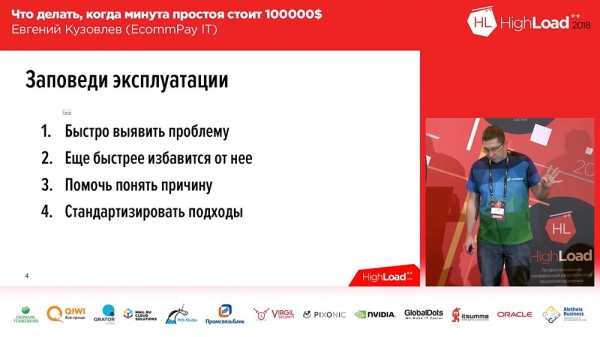
- Identificar rápidamente el problema.
- Eliminarlos aún más rápido.
- Ayudar a comprender la causa (más tarde, para los desarrolladores).
- Estandarizar los enfoques.
Llamo su atención sobre el punto n.º 2. Nos deshacemos del problema, no lo resolvemos. Resolverlo es secundario. Para nosotros, lo primordial es que el usuario esté protegido de este problema. Existirá en un entorno aislado, pero ese entorno no tendrá contacto con él. En realidad, recorreremos juntos estos cuatro grupos de problemas (algunos con más detalle, otros con menos), y les contaré qué utilizamos, cuál es nuestra experiencia correspondiente en las soluciones.
Resolución de problemas: cuándo ocurren y qué hacer con ellos?
Pero comenzaremos no en orden, sino en el punto número 2: ¿cómo deshacerse rápidamente del problema? Hay un problema, y necesitamos resolverlo. "¿Qué hacemos con esto?" es la pregunta principal. Y cuando comenzamos a pensar en cómo resolver el problema, desarrollamos algunos requisitos que la resolución de problemas debe seguir.
Para formular estos requisitos, decidimos hacernos la pregunta: "¿Cuándo tenemos problemas?" Y los problemas, como resultó, se presentan en cuatro casos:
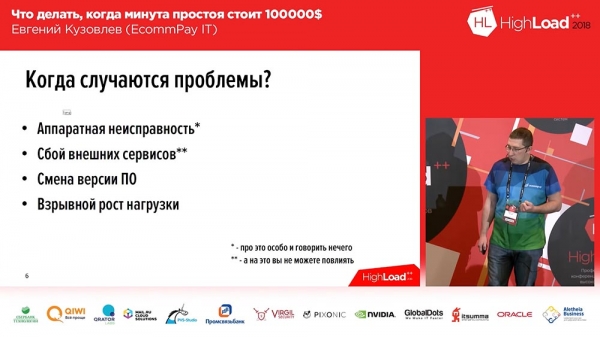
- Fallo de hardware.
- Falla de servicios externos.
- Cambio de versión de software (ese despliegue).
- Crecimiento explosivo de carga.
No hablaremos de los dos primeros. El fallo de hardware se resuelve de manera bastante sencilla: todo debe estar duplicado. Si se trata de discos, deben estar configurados en RAID; si es un servidor, el servidor debe estar duplicado; si tiene una infraestructura de red, debe configurar una segunda copia de la infraestructura de red; es decir, debe duplicar. Y si algo falla, se cambia a las capacidades de respaldo. Aquí es difícil decir algo más.
Lo segundo es la falla de servicios externos. Para la mayoría de las personas, esto no es un problema, pero no para nosotros. Como procesamos pagos, somos un intermediario entre el usuario (que introduce sus datos de tarjeta) y los bancos, las sistemas de pago (como "Visa", "MasterCard", "Mir" y similares). A nuestros servicios externos (sistemas de pago, bancos) les ocurre con frecuencia fallas. Ni nosotros ni usted (si tiene tales servicios) podemos influir en esto.
¿Qué hacer entonces? Aquí hay dos opciones. Primero, si puede, debe duplicar este servicio de alguna manera. Por ejemplo, nosotros, cuando podemos, redirigimos el tráfico de un servicio a otro: procesamos, por ejemplo, tarjetas a través de "Sberbank", si "Sberbank" tiene problemas, redirigimos el tráfico [condicionalmente] a "Raiffeisen". Lo segundo que podemos hacer es detectar muy rápidamente fallas en los servicios externos, y por lo tanto hablaremos de la velocidad de reacción en la siguiente parte de la presentación.
De hecho, de estos cuatro, podemos influir específicamente en el cambio de las versiones de software: realizar acciones que mejoren la situación en el contexto de los despliegues y en el contexto del crecimiento explosivo de la carga. De hecho, eso es lo que hicimos. Aquí, una pequeña observación...
De estos cuatro problemas, varios se resuelven de inmediato si tiene una nube. Si se encuentra en las nubes de 'Microsoft Azure', 'Ozon', usa nuestras nubes de 'Yandex' o 'Mail', al menos la falla de hardware se convierte en su problema y todo mejora de inmediato en el contexto de la falla de hardware.
Somos una empresa un poco atípica. Aquí todos hablan de 'Kubernetes', de nubes, pero no tenemos ni 'Kubernetes' ni nubes. En cambio, tenemos servidores con hardware en múltiples centros de datos, y con ese hardware tenemos que vivir, somos responsables de todo eso. Por lo tanto, en este contexto, hablaremos. Así que, sobre los problemas. Excluimos los dos primeros.
Cambio de versión de software. Bases
Nuestros desarrolladores no tienen acceso a producción. ¿Por qué es así? Simplemente estamos certificados por PCI DSS, y nuestros desarrolladores no tienen derecho a entrar en producción. Eso es todo. Definitivamente. Por lo tanto, la responsabilidad del desarrollo termina en el momento en que se entrega la versión para el lanzamiento.
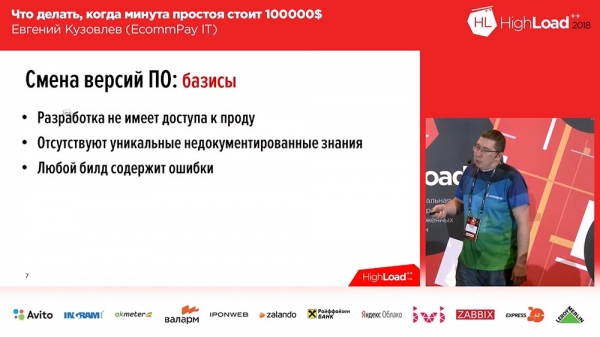
Nuestra segunda base, que también nos ayuda mucho, es que no hay conocimientos únicos no documentados. Espero que también sea así para ustedes. Porque si no es así, tendrán problemas. Los problemas surgirán cuando esos conocimientos únicos no documentados no estén presentes en el lugar y en el momento adecuados. Supongamos que hay una persona que sabe cómo desplegar un componente específico: si esa persona no está, está de vacaciones o enferma, tendrán problemas.
Y la tercera base a la que hemos llegado. Hemos llegado a través del dolor, la sangre, las lágrimas: hemos llegado a la conclusión de que cualquier build contiene errores, incluso si parece estar sin errores. Para nosotros, hemos decidido que cuando desplegamos algo, cuando llevamos algo a producción, nuestro build tiene errores. Hemos establecido requisitos que nuestro sistema debe cumplir.
Requisitos para el cambio de versión de software
Estos requisitos son tres:
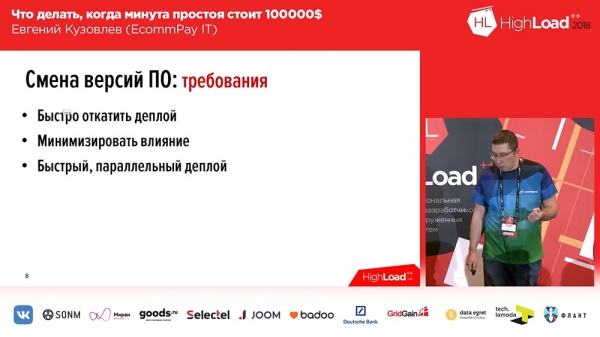
- Debemos poder revertir el despliegue rápidamente.
- Debemos minimizar el impacto de un despliegue fallido.
- Y debemos tener la capacidad de desplegarnos rápidamente en paralelo.
¡Exactamente en ese orden! ¿Por qué? Porque, en primer lugar, al desplegar una nueva versión la velocidad no es lo más importante, pero es crucial poder retroceder rápidamente si algo sale mal y causar el mínimo impacto. Sin embargo, si tienes un conjunto de versiones en producción y se identifica un error (como un rayo en el cielo, no hubo despliegue, pero hay un error), la velocidad del despliegue posterior es vital. ¿Qué hicimos para cumplir con estos requisitos? Nos apoyamos en la siguiente metodología:
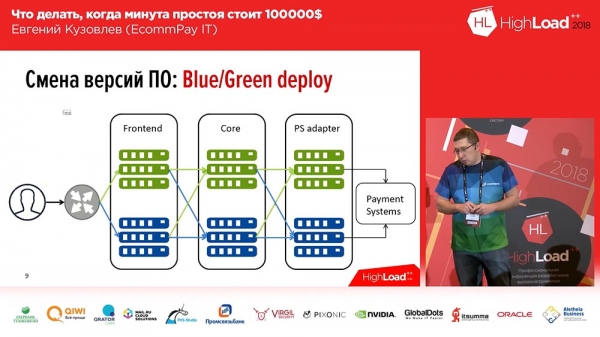
Es bastante conocida, no la hemos inventado nosotros: es el despliegue Blue/Green. ¿Qué es eso? Para cada grupo de servidores donde están tus aplicaciones, debe haber una copia. Una copia "caliente": no tiene tráfico, pero en cualquier momento se puede enviar tráfico a esa copia. Esta copia contiene la versión anterior. En el momento del despliegue, se lanza el código en la copia inactiva. Luego, se dirige parte del tráfico (o todo) a la nueva versión. Así, para cambiar el flujo de tráfico de la versión antigua a la nueva, solo necesitas realizar una acción: debes cambiar el balanceador en el upstream, cambiar la dirección, de un upstream a otro. Es muy conveniente y resuelve el problema de un cambio rápido y un retroceso ágil.Aquí también se resuelve la segunda cuestión: la minimización. Puedes enviar a la nueva línea, a la línea con el nuevo código, solo una parte de tu tráfico (digamos, un 2%). Y ese 2% no es el 100%. Si perdiste el 100% del tráfico durante un despliegue fallido, eso es grave; si perdiste el 2%, es incómodo, pero no catastrófico. Además, es probable que los usuarios ni siquiera lo noten, porque en algunos casos (no en todos) el mismo usuario, al pulsar F5, caerá en otra versión que está funcionando.
Despliegue Blue/Green. Enrutamiento
Sin embargo, no es tan simple "desplegar en Blue/Green"... Todos nuestros componentes se pueden dividir en tres grupos:
- es el frontend (páginas de pago que ven nuestros clientes);
- el núcleo de procesamiento;
- adaptador para trabajar con sistemas de pago (bancos, "MasterCard", "Visa", etc.).
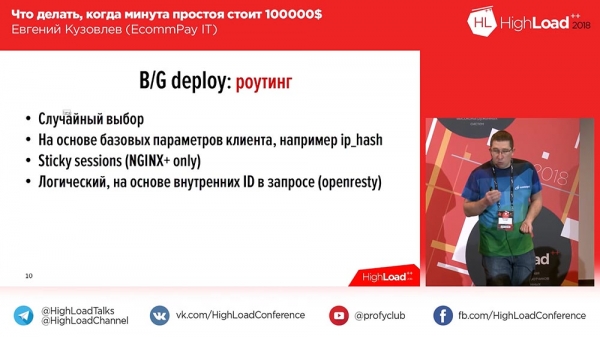
Y aquí hay un matiz: el matiz radica en el enrutamiento entre las líneas. Si simplemente cambias el 100% del tráfico, no tendrás esos problemas. Pero si quieres cambiar el 2%, comienzas a tener preguntas: "¿Y cómo lo hago?" La forma más sencilla, directa: puedes configurar un aleatorio, Round Robin en nginx, y obtienes 2% a la izquierda, 98% a la derecha. Pero esto no siempre es adecuado.
Por ejemplo, un usuario interactúa con el sistema no con una sola solicitud. Eso es normal: 2, 3, 4, 5 solicitudes; tus sistemas pueden ser igual. Y si es importante que todas las solicitudes del usuario lleguen a la misma línea que la primera solicitud, o (el segundo aspecto) que todas las solicitudes del usuario lleguen a una nueva línea después del cambio (él podría haber comenzado a trabajar antes con el sistema, antes del cambio), entonces esta distribución aleatoria no te sirve. Entonces hay las siguientes opciones:
La primera opción, la más sencilla, es basada en parámetros básicos del cliente (IP Hash). Tienes una IP, y divides a la derecha e izquierda según esa dirección. Entonces funcionará el segundo caso que describí, cuando se realizó el despliegue, el usuario ya pudo empezar a trabajar con tu sistema, y desde el momento del despliegue todas las solicitudes irán a la nueva línea (a la misma, digamos).Si por alguna razón esto no te conviene y necesitas enviar obligatoriamente las solicitudes a la línea donde llegó la primera solicitud del usuario, entonces tienes dos opciones…
La primera opción: puedes obtener nginx+ de pago. Allí hay un mecanismo de Sticky sessions, que al realizar la primera solicitud del usuario establece una sesión y la vincula a un determinado upstream. Todas las solicitudes subsecuentes del usuario dentro de la duración de la sesión irán al mismo upstream donde se estableció la sesión.Esto no nos funcionó, ya que ya teníamos nginx normal. Pasar a nginx+ no es que sea caro, simplemente fue algo doloroso y no muy correcto para nosotros. Por ejemplo, 'Sticky sessions' no funcionaron para nosotros por la simple razón de que 'Sticky sessions' no dan la posibilidad de enrutar por el criterio 'O-o'. Allí se puede establecer que hacemos 'Sticky sessions', por ejemplo, por IP o por IP y cookies o por parámetros POST, pero 'O-o' ya es más complicado.
Por lo tanto, llegamos a la cuarta opción. Tomamos nginx 'potenciado' (es decir, openresty), que es el mismo nginx que además soporta la inclusión de scripts de última instancia. Puede escribir un script de última instancia, proporcionárselo a este 'openresty', y este script se ejecutará cuando llegue una solicitud del usuario.
Y, de hecho, escribimos un pequeño script, instalamos 'openresty' y en este script iteramos sobre 6 parámetros diferentes concatenando 'O'. Dependiendo de la presencia de uno u otro parámetro, sabemos si el usuario ha llegado a una página o a otra, a una línea o a otra.
Despliegue Blue/Green. Ventajas y desventajas.
Por supuesto, quizá se podría haber hecho un poco más simple (usando las mismas 'Sticky sessions'), pero hay un matiz adicional: no solo el usuario interactúa con nosotros en el marco de un solo procesamiento de transacción... También interactúan con nosotros los sistemas de pago: después de procesar la transacción (enviando una solicitud al sistema de pago), recibimos un callback.
Y supongamos que, dentro de nuestro circuito, podemos pasar la dirección IP del usuario en todas las solicitudes y, en base a la dirección IP de los usuarios, diferenciar, no le diremos a 'Visa': 'Chicos, somos una empresa retro, somos internacionales (en el sitio web y en Rusia)... ¡Y por favor, mándenme también la dirección IP del usuario en un campo adicional, su protocolo estandarizado!' Es obvio que no aceptarían.
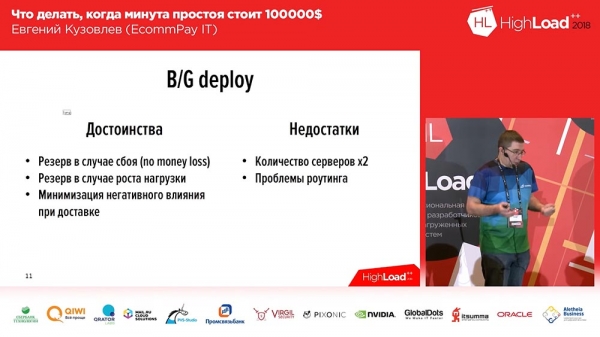
Por lo tanto, esto no funcionó para nosotros; hicimos openresty. Así que, respecto al enrutamiento, nos quedó de esta manera:El despliegue 'Blue/Green' tiene, por lo tanto, ventajas, de las que hablé, y desventajas.
Hay dos desventajas:
- debes preocuparte por el enrutamiento;
- la segunda desventaja principal son los costos.
Necesitas el doble de servidores, necesitas el doble de recursos operativos, necesitas gastar el doble de esfuerzo para mantener todo este zoológico.
Por cierto, entre las ventajas, hay una cosa más que no mencioné antes: tienes un respaldo en caso de aumento de la carga. Si experimentas un crecimiento explosivo en la carga, y recibes una gran cantidad de usuarios, simplemente activas la segunda línea en la distribución 50 a 50, y de inmediato duplicas los servidores en tu clúster, mientras resuelves el problema de la disponibilidad de más servidores.
¿Cómo hacer un despliegue rápido?
Hemos hablado sobre cómo resolver el problema de la minimización y la reversión rápida, pero la pregunta sigue siendo: "¿Cómo desplegar rápidamente?"
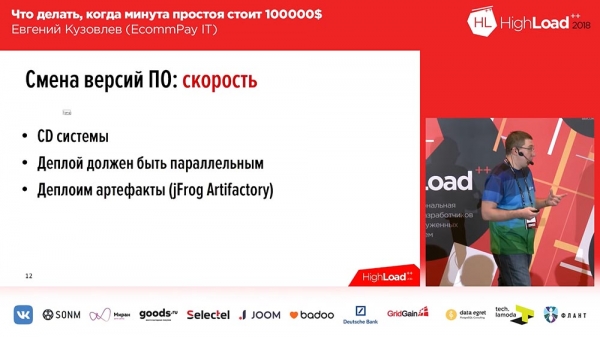
Aquí es breve y todo es simple.- Debes tener un sistema de CD (Entrega Continua), sin él no vas a ningún lado. Si solo tienes un servidor, puedes desplegar manualmente. Tenemos aproximadamente mil quinientos servidores y, evidentemente, no podemos poner un departamento del tamaño de esta sala solo para desplegar.
- El despliegue debe ser paralelo. Si tu despliegue es secuencial, todo va mal. Un servidor está bien, con mil quinientos servidores estarás desplegando todo el día.
- De nuevo, para acelerar, esto ya no es obligatorio, supongo. Durante el despliegue, normalmente se realiza la construcción del proyecto. Tienes un proyecto web, hay una parte frontend (ahí haces el webpack, recolectas con npm, algo así), y este proceso es, en principio, breve: unos 5 minutos, pero esos 5 minutos pueden ser críticos. Por eso nosotros, por ejemplo, no lo hacemos de esa manera: eliminamos esos 5 minutos y desplegamos los artefactos.
¿Qué es un artefacto? Un artefacto es una construcción completada, en la que ya se ha realizado todo el proceso de construcción. Este artefacto lo almacenamos en un repositorio de artefactos. En su momento, utilizamos dos de estos repositorios: fue Nexus y ahora jFrog Artifactory. Inicialmente utilizamos "Nexus" porque comenzamos a practicar este enfoque en aplicaciones Java (se adaptaba bien a ello). Luego, ahí también incluimos algunas aplicaciones escritas en PHP; y "Nexus" ya no se adaptaba, por lo que elegimos jFrog Artifactory, que puede manejar prácticamente todo. Hemos llegado al punto de que en este repositorio de artefactos almacenamos nuestros propios paquetes binarios que generamos para los servidores.
Crecimiento explosivo de la carga
Hablamos sobre el cambio de versión del software. Lo siguiente que tenemos es el crecimiento explosivo de la carga. Aquí, probablemente, entiendo por crecimiento explosivo de la carga algo que no es del todo correcto...
Hemos desarrollado un nuevo sistema: es orientado a servicios, moderno, bello, con trabajadores en todas partes, colas en todas partes, y asincronía en todas partes. En estos sistemas, los datos pueden fluir por diferentes rutas. Para la primera transacción, pueden estar involucrados el primer, tercer y décimo trabajador; para la segunda transacción, el segundo, cuarto y quinto. Y hoy, digamos que en la mañana fluye un flujo de datos que utiliza los tres primeros trabajadores, pero por la tarde cambia abruptamente, y todos utilizan otros tres trabajadores.
Por lo tanto, se presenta la necesidad de escalar los trabajadores y escalar sus servicios, pero sin permitir la inflación de recursos.
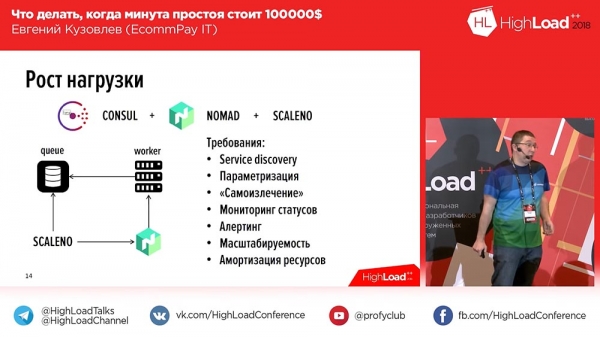
Hemos definido nuestros requisitos. Estos requisitos son bastante simples: debe haber descubrimiento de servicios, parametrización, todo estándar para construir sistemas escalables, excepto un punto: la amortización de recursos. Dijimos que no estábamos listos para amortizar recursos, para que los servidores sólo calienten aire. Utilizamos 'Consul' y 'Nomad', que gestiona nuestros trabajadores.¿Por qué es esto un problema para nosotros? Retrocedamos un poco. Ahora mismo tenemos alrededor de 70 sistemas de pago. Por la mañana, el tráfico pasa a través de 'Sberbank', luego, por ejemplo, 'Sberbank' se cae, y lo cambiamos a otro sistema de pago. Teníamos 100 trabajadores funcionando con 'Sberbank', y después de eso, necesitamos levantar rápidamente 100 trabajadores para otro sistema de pago. Y todo esto debería suceder idealmente sin la intervención humana. Porque si hay intervención humana, debe haber un ingeniero 24/7 que se dedique solo a esto, ya que tales fallos ocurren regularmente con 70 sistemas a nuestro cargo.
Por eso miramos a 'Nomad', que tiene una IP abierta, y escribimos nuestra herramienta Scale-Nomad – ScaleNo, que hace algo parecido: monitorea el crecimiento de la cola y ajusta el número de trabajadores según la dinámica de cambio de la cola. Una vez hecho esto, pensamos: «¿Quizás deberíamos hacerlo de código abierto?» Luego la revisamos: es tan simple como dos centavos.
Hasta ahora no lo hemos hecho de código abierto, pero si después de la presentación sientes que necesitas algo así, en la última diapositiva están mis contactos – por favor, envíame un mensaje. Si se reúne al menos 3-5 personas, lo haremos de código abierto.
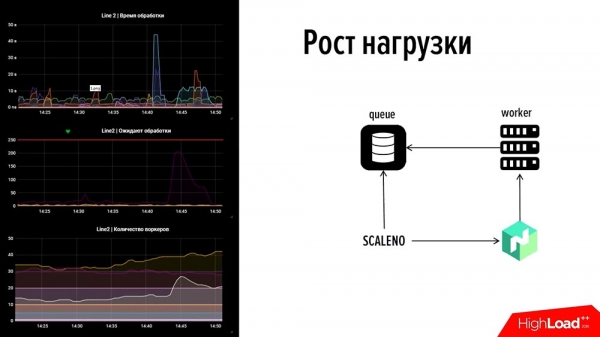
¿Cómo funciona? ¡Veamos! Para anticipar: a la izquierda hay un fragmento de nuestra monitorización: es una línea, en la parte superior está el tiempo de procesamiento de eventos, en el medio está la cantidad de transacciones, y en la parte inferior está la cantidad de trabajadores.Si miramos, en esta imagen hay una falla. En el gráfico superior, una de las gráficas se disparó durante 45 segundos: uno de los sistemas de pago colapsó. Justo ahí se mostró el tráfico durante 2 minutos y comenzó el aumento de la cola en otro sistema de pago, donde no había trabajadores (no estábamos utilizando recursos de manera indebida, al contrario, estábamos gestionando los recursos adecuadamente). No queríamos sobrecargar; había una cantidad mínima, alrededor de 5-10 trabajadores, pero no podían manejar la carga.
En el último gráfico se puede ver un «bulto», que indica que «SkaLen» duplicó esta cantidad. Y luego, cuando el gráfico disminuyó un poco, también se redujo; la cantidad de trabajadores se ajustó automáticamente. Así es como funciona esta herramienta. Hablamos sobre el punto nº 2 – «Cómo eliminar rápidamente las causas».
Monitorización. ¿Cómo detectar un problema rápidamente?
Ahora, el primer punto – «¿Cómo detectar un problema rápidamente?» ¡Monitorización! Necesitamos entender rápidamente ciertas cosas. ¿Qué cosas debemos comprender rápidamente?
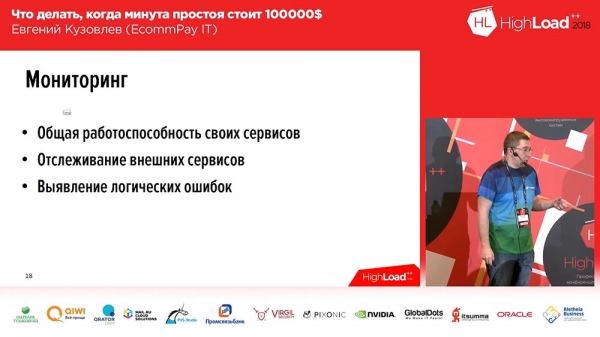
¡Tres cosas!- Debemos entender rápidamente y evaluar la operatividad de nuestros propios recursos.
- Debemos comprender rápidamente la falla, monitorizar la funcionalidad de los sistemas externos que son relevantes para nosotros.
- El tercer punto – la detección de errores lógicos. Esto sucede cuando el sistema funciona, todos los indicadores son normales, pero algo no va bien.
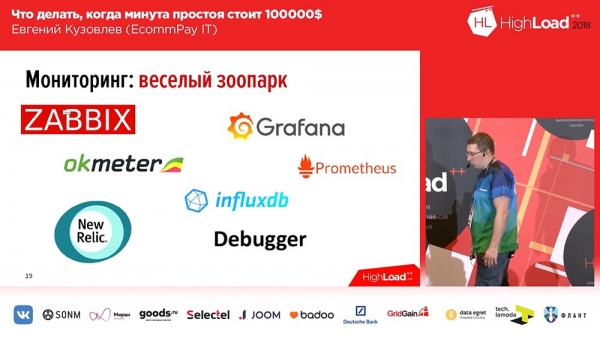
Aquí, probablemente, no tengo mucho que contar que sea impresionante. Seré el Capitán Obviedad. Buscamos qué hay en el mercado. Nos formamos un «zoológico divertido». Este es el zoológico que tenemos ahora:
Estamos utilizando «Zabbix» para el monitoreo del «hardware», para monitorear los indicadores clave de los servidores. «Okmeter» lo usamos para bases de datos. Usamos «Grafana» y «Prometheus» para todos los demás indicadores que no encajaron en los primeros dos, además, parte de los datos provienen de «Grafana» y «Prometheus», mientras que otra parte es «Grafana» con «Influx» y Telegraf.Hace un año queríamos utilizar New Relic. Es una herramienta impresionante, puede hacer de todo. Pero cuanto más puede hacer, más cara es. Cuando crecimos hasta tener 1500 servidores, vino un vendedor y nos dijo: “Vamos a firmar un contrato para el próximo año”. Vimos el precio y dijimos que no, que no íbamos a hacer eso. Actualmente estamos dejando de usar New Relic, nos quedan alrededor de 15 servidores bajo su monitoreo. El precio resultó ser completamente ridículo.
Y hay una herramienta que implementamos nosotros mismos: es el Debugger. Al principio lo llamamos ‘Bagger’, pero luego vino nuestro profesor de inglés, se rió a carcajadas, y lo renombramos a ‘Debugger’. ¿Qué es esto? Es una herramienta que, en realidad, en 15-30 segundos, sobre cada componente, como una ‘caja negra’ del sistema, ejecuta pruebas sobre el funcionamiento general del componente.
Por ejemplo, si es una página externa (página de pago) – simplemente la abre y verifica cómo debería verse. Si es un procesamiento, lanza una ‘transacción’ de prueba – comprueba que esa ‘transacción’ haya llegado. Si es la conexión con los sistemas de pago – lanzamos una solicitud de prueba donde podemos, y verificamos que todo esté bien.
¿Cuáles son los indicadores importantes para el monitoreo?
¿Qué monitoreamos principalmente? ¿Cuáles son los indicadores importantes para nosotros?
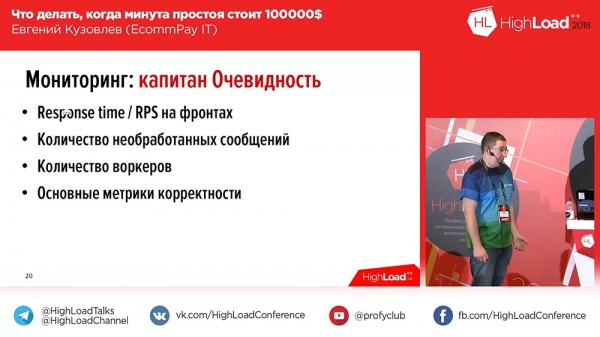
- El tiempo de respuesta / RPS en los frontales – es un indicador muy importante. Responde inmediatamente que algo no está bien.
- Cantidad de mensajes procesados en todas las colas.
- Cantidad de trabajadores.
- Principales métricas de corrección.
El último punto es una métrica ‘de negocio’. Si quieres monitorear lo mismo, debes definir una o dos métricas que sean tus indicadores clave. Para nosotros, esa métrica es la tasa de éxito (es la proporción de transacciones exitosas respecto al flujo total de transacciones). Si hay algo que cambia en un intervalo de 5-10-15 minutos – significa que tenemos problemas (si cambia drásticamente).
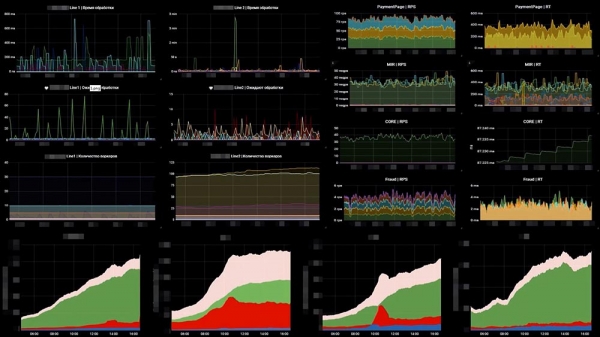
Así es como se ve en nuestro ejemplo de uno de nuestros tableros:
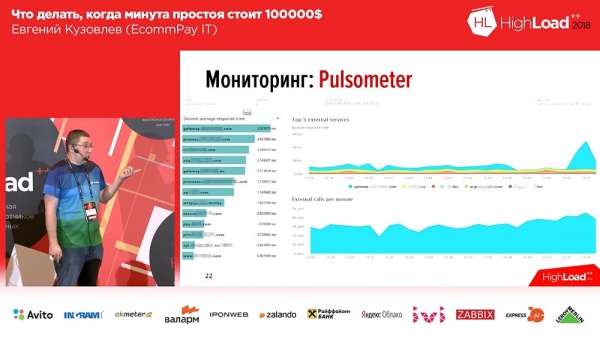
A la izquierda hay 6 gráficos que corresponden a las líneas: el número de trabajadores y el número de mensajes en las colas. A la derecha, tenemos RPS y RTS. Abajo, está la métrica 'empresarial'. Y en la métrica 'empresarial' se puede ver de inmediato que algo salió mal en los dos gráficos intermedios... Esto se debe a que cayó otro sistema que está detrás de nosotros.Lo segundo que teníamos que hacer era monitorear la caída de los sistemas de pago externos. Aquí utilizamos OpenTracing, un mecanismo, estándar y paradigma que permite rastrear sistemas distribuidos; y lo modificamos un poco. El paradigma estándar de OpenTracing indica que construimos el rastreo de cada solicitud individual. No necesitábamos eso, así que lo empaquetamos en un rastreo total, de agregación. Creamos una herramienta que nos permite monitorear la velocidad de los sistemas que están detrás de nosotros.
El gráfico nos muestra que uno de los sistemas de pago comenzó a responder en 3 segundos, lo que indica que tenemos problemas. Además, esta cosa reaccionará cuando comiencen los problemas, en un intervalo de 20 a 30 segundos.Y la tercera clase de errores de monitoreo que existen es el monitoreo lógico.
Honestamente, no sabía qué dibujo poner en esta diapositiva porque estuvimos buscando durante mucho tiempo en el mercado algo que nos sirviera. No encontramos nada, así que tuvimos que hacerlo nosotros mismos.
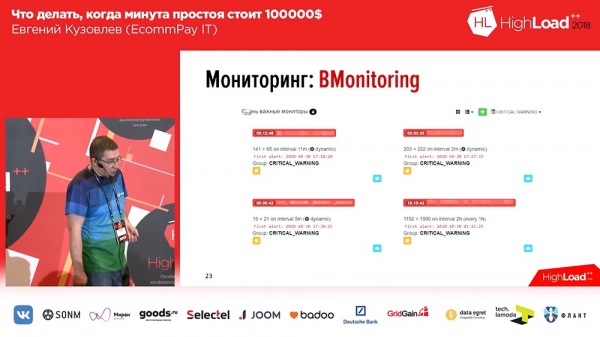
¿Qué quiero decir con monitoreo lógico? Bien, imaginen que crean un sistema (por ejemplo, un clon de 'Tinder'); lo crean y lo lanzan. El exitoso gerente Vasya Pupkin lo instala en su teléfono, ve a una chica, le da 'me gusta'... pero el 'me gusta' no llega a la chica, sino que se lo envía al guardia Mikhailovich de ese mismo centro de negocios. El gerente baja y luego se pregunta: '¿Por qué este guardia Mikhailovich le sonríe tan agradablemente?'En tales situaciones... Para nosotros, esta situación suena un poco diferente, porque (como mencioné) es una pérdida de reputación que indirectamente lleva a pérdidas financieras. Nuestra situación es inversa: podemos enfrentar pérdidas financieras directas, por ejemplo, si registramos una transacción como exitosa y en realidad fue fallida (o viceversa). Tuvimos que crear nuestra propia herramienta que rastrea, a través de indicadores comerciales, la cantidad de transacciones exitosas en dinámica en un intervalo de tiempo. ¡No encontramos nada en el mercado! Eso es lo que quería transmitir. Para resolver este tipo de problemas, no hay nada en el mercado.
Esto fue en relación a cómo detectar rápidamente un problema.
Cómo determinar las causas del despliegue
El tercer grupo de tareas que resolvemos es, después de haber identificado el problema y haberlo solucionado, sería bueno entender la causa para el desarrollo, para las pruebas y hacer algo al respecto. Por lo tanto, necesitamos investigar, necesitamos levantar los registros.
Si hablamos de los registros (la causa principal son los registros), la mayor parte de nuestros registros está en ELK Stack, prácticamente todos lo tienen así. Algunos, tal vez, no estén en ELK, pero si escribes registros por gigabytes, tarde o temprano llegarás a ELK. Nosotros los escribimos por terabytes.
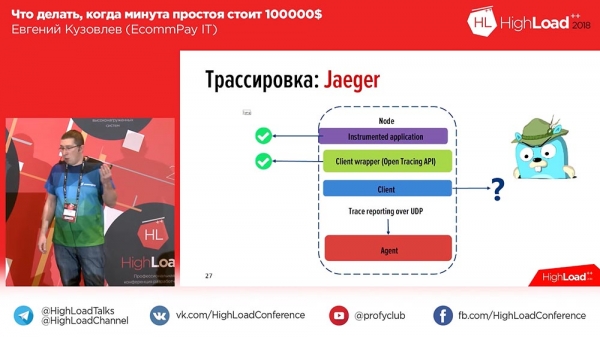
Aquí hay un problema. Arreglamos el error para el usuario, comenzamos a investigar qué había sucedido, entramos en 'Kibana', introdujimos el ID de la transacción y obtuvimos un gran volumen de datos (muestra mucho). Y en este volumen de datos no se entiende nada en absoluto. ¿Por qué? Porque no está claro qué parte se refiere a qué trabajador, qué parte se refiere a qué componente. Y en ese momento entendimos que necesitábamos trazabilidad – ese mismo OpenTracing del que hablé.Pensamos en esto hace un año, dirigimos nuestra mirada hacia el mercado y encontramos dos herramientas: 'Zipkin' y 'Jaeger'. 'Jaeger' es en realidad un sucesor ideológico, un continuador ideológico de 'Zipkin'. En 'Zipkin' todo está bien, excepto que no puede agregar, no puede incluir en la trazabilidad registros, solo trazabilidad de tiempo. Y 'Jaeger' lo soportaba.
Miramos a "Eger"; se pueden instrumentar aplicaciones, se puede escribir en Api (el estándar Api para PHP en ese momento, sin embargo, no estaba aprobado - hace un año, y ahora ya está aprobado), y no había cliente en absoluto. "Está bien", pensamos, y escribimos nuestro propio cliente. ¿Qué obtuvimos? Así es como se ve:
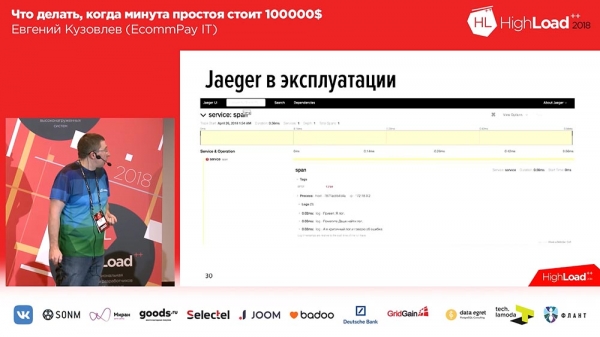
En "Eger", se crean spans para cada mensaje. Es decir, cuando un usuario abre el sistema, ve uno o dos bloques por cada solicitud entrante (1-2-3 - cuántas solicitudes entrantes tenía el usuario, tantos bloques hay). Para facilitar a los usuarios, añadimos etiquetas a los registros y a la trazabilidad temporal. Por lo tanto, en caso de error, nuestra aplicación marcará el registro con la etiqueta correspondiente Error. Se puede filtrar por la etiqueta Error y solo se mostrarán los spans que contienen ese bloque con el error. Así es como se ve si expandimos el span:
Dentro del span hay un conjunto de trazas. En este caso, son tres trazas de prueba, y la tercera traza nos dice que ocurrió un error. En este punto, también vemos la trazabilidad temporal: tenemos una línea de tiempo en la parte superior y vemos en qué intervalo de tiempo se registró cada registro.Por lo tanto, nos fue muy bien. Escribimos nuestra propia extensión y la hemos open-sourceado. Si deseas trabajar con la trazabilidad, si deseas trabajar con "Eger" en el lenguaje PHP, aquí tienes nuestra extensión, bienvenido a usarla, como se dice:
Nuestra extensión es un cliente para trabajar con la Api de OpenTracing, hecha como php-extention, es decir, tendrás que compilarla e integrarla en el sistema. Hace un año no había nada más. Ahora han aparecido otros clientes que son como componentes. Aquí depende de ti: puedes obtener los componentes mediante composer o usar la extensión, tú decides.Estándares corporativos
Hablamos sobre los tres mandamientos. El cuarto mandamiento es estandarizar los enfoques. ¿De qué se trata esto? Es aproximadamente de esto:
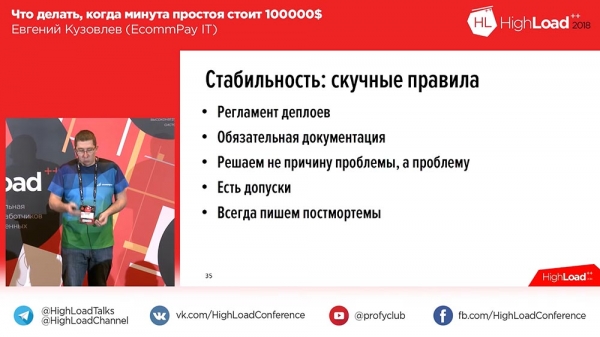
¿Por qué aquí la palabra "corporativa"? No porque seamos una empresa grande o burocrática, ¡no! Quería usar la palabra "corporativa" en el contexto de que cada empresa, cada producto debe tener sus propios estándares, y tú también tienes que tener los tuyos. ¿Cuáles son nuestros estándares?- Tenemos un reglamento de despliegues. Sin él, no avanzamos, no podemos. Realizamos despliegues alrededor de 60 veces a la semana, es decir, nuestros despliegues ocurren prácticamente de forma constante. Al mismo tiempo, tenemos, por ejemplo, en el reglamento de despliegues una prohibición de desplegar el viernes; en principio, no desplegamos.
- Contamos con documentación obligatoria. Ningún nuevo componente entra en producción sin su documentación, incluso si fue desarrollado por nuestros ingenieros de I+D. Exigimos de ellos instrucciones de despliegue, un mapa de monitoreo y una descripción general (bueno, como los programadores pueden escribir) de cómo funciona este componente y cómo resolver problemas.
- Nosotros resolvemos no la causa del problema, sino el problema, como ya mencioné. Para nosotros es importante proteger al usuario de los inconvenientes.
- Tenemos tolerancias. Por ejemplo, no consideramos downtime si hemos perdido el 2 % del tráfico durante dos minutos. Esto, en principio, no entra en nuestras estadísticas. Si es más en proporción porcentual o temporal, ya lo consideramos.
- Y siempre redactamos postmortems. Cualquier situación que ocurra y no se comporte como se espera en producción se reflejará en el postmortem. Un postmortem es un documento en el que escribes lo que te sucedió, el cronograma detallado, lo que hiciste para corregirlo y (esto es obligatorio) lo que harás para evitar que vuelva a suceder en el futuro. Es obligatorio, necesario para el análisis posterior.
¿Qué se considera downtime?
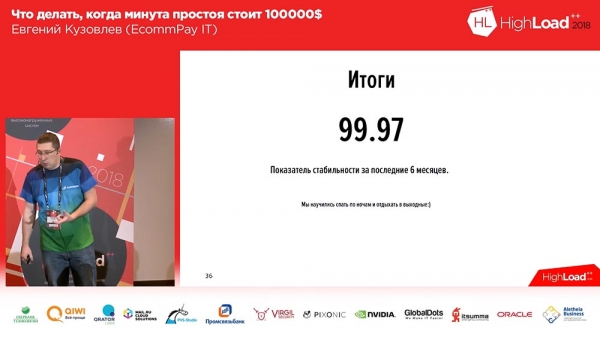
¿A qué ha conducido todo esto?Esto ha llevado a que (teníamos ciertos problemas de estabilidad, que no satisfacían ni a los clientes ni a nosotros) en los últimos 6 meses nuestro indicador de estabilidad fue del 99,97. Se puede decir que no es mucho. Sí, tenemos mucho que mejorar. De este indicador, aproximadamente la mitad es estabilidad que no es precisamente nuestra, sino de nuestro firewall de aplicación web, que está delante de nosotros y se utiliza como servicio, pero a los clientes no les importa.
Hemos aprendido a dormir por la noche. ¡Finalmente! Hace seis meses no sabíamos cómo. Y en esta nota de resultados, quiero hacer una pequeña observación. Ayer por la noche hubo una excelente charla sobre el sistema de gestión de un reactor nuclear. Si hay personas escuchando que escribieron ese sistema, por favor, olvídense de lo que dije sobre "el 2% no es downtime". Para ustedes, el 2% es downtime, incluso si es por dos minutos.
¡Eso es todo! Sus preguntas.
Sobre los balanceadores de carga y la migración de bases de datos
Pregunta de la audiencia (en adelante - P): – Buenas tardes. ¡Muchas gracias por una presentación tan técnica! La pregunta es breve, sobre sus balanceadores de carga. Mencionaron que tienen un WAF, es decir, como entiendo, como balanceador utilizan algún servicio externo...
EK: – No, como balanceador utilizamos nuestros propios servicios. En este caso, el WAF es únicamente una herramienta de protección contra DDoS.
Q: – ¿Podrían decir algunas palabras sobre los balanceadores de carga?
EK: – Como ya mencioné, es un grupo de servidores en openresty. Actualmente tenemos 5 grupos de reserva que se encargan exclusivamente... es decir, el servidor que tiene únicamente openresty, solo hace proxy del tráfico. Para entender cuánto mantenemos: en este momento, nuestro flujo de tráfico está en varios cientos de megabits. Ellos están funcionando bien, no les resulta difícil.
Q: – También una pregunta sencilla. Existe el despliegue Blue/Green. ¿Qué hacen, por ejemplo, con las migraciones de bases de datos?
EK: – ¡Buena pregunta! Miren, en el despliegue Blue/Green tenemos colas separadas para cada línea. Es decir, si hablamos de las colas de eventos que se transmiten de un trabajador a otro, hay colas separadas para la línea azul y la línea verde. Si hablamos de la base de datos, la hemos reducido deliberadamente; casi todo se ha trasladado a colas, en la base de datos solo se almacena la pila de transacciones. Y la pila de transacciones es única para todas las líneas. En este contexto sobre la base de datos: no la separamos en azul y verde, porque ambas versiones del código deben saber lo que sucede con la transacción.
Amigos, tengo otro pequeño premio para motivarlos: un libro. Y necesito entregárselo por la mejor pregunta.
Q: – Hola. Gracias por la presentación. La pregunta es la siguiente. Ustedes monitorean los pagos, monitorean los servicios con los que están en contacto... Pero, ¿cómo monitorean que una persona haya llegado a su página de pago, realizó el pago y el proyecto le acreditó el dinero? Es decir, ¿cómo monitorean que el comerciante está disponible y aceptó su callback?
EK: – El "comerciante" en este caso es un servicio externo tan importante como el sistema de pagos. Monitoreamos el tiempo de respuesta del comerciante.
Sobre el cifrado de bases de datos
Q: – Hola. Tengo una pregunta relacionada. Ustedes manejan datos sensibles según PCI DSS. Quería saber, ¿cómo almacenan los PAN en las colas que necesitan procesar? ¿Utilizan algún tipo de cifrado? Y la segunda pregunta que surge de esto: según PCI DSS es necesario volver a cifrar la base periódicamente en caso de cambios (despido de administradores, etc.) – ¿cómo se maneja la disponibilidad en este caso?
EK: – ¡Esa es una excelente pregunta! Primero que nada, no almacenamos los PAN en las colas. No tenemos derecho a almacenar los PAN en abierto, por lo tanto, utilizamos un servicio especial (lo llamamos ‘Keydemon’) – este servicio hace una sola cosa: recibe un mensaje y devuelve el mensaje cifrado. Y almacenamos todo en ese mensaje cifrado. Por lo tanto, la longitud de la clave es de hasta un kilobyte, para que sea realmente seria y confiable.Q: – ¿Ahora se necesitan 2 kilobytes?
EK: – Aparentemente, ayer era 256... ¿Pero hasta dónde más?!
Por lo tanto, eso es lo primero. Y en segundo lugar, la solución que tenemos soporta el procedimiento de re-cifrado – hay dos pares de ‘KEKs’ (claves) que generan ‘DEKs’ que cifran (key – son las claves, dek – son derivados de las claves que cifran). Y en el caso de iniciar el procedimiento (se realiza regularmente, de 3 meses a ± algunos) cargamos un nuevo par de ‘KEKs’, y hacemos el re-cifrado de datos. Tenemos servicios separados que extraen todos los datos, los cifran de nuevo; cada dato tiene un identificador de la clave con la que fueron cifrados. Por lo tanto, tan pronto como los datos son cifrados con nuevas claves, eliminamos las claves antiguas.
A veces, es necesario realizar pagos manualmente…
Q: – Entonces, si se recibe un reembolso por alguna operación, ¿descifran con la clave antigua?
EK: – Sí.
Q: – Entonces, otra pregunta pequeña. Cuando ocurre algún fallo, caída o incidente, es necesario empujar la transacción manualmente. A veces sucede eso.
EK: – Sí, sucede.
Q: – ¿De dónde obtienen esos datos? ¿O van ustedes manualmente a ese almacenamiento?
EK: – No, por supuesto, tenemos un sistema back-office que contiene la interfaz para nuestro soporte. Si no sabemos en qué estado está la transacción (por ejemplo, mientras se espera la respuesta de la pasarela de pago debido a un timeout), no sabemos, es decir, asignamos el estado final solo con total seguridad. En este caso, asignamos la transacción a un estado especial para procesamiento manual. A la mañana siguiente, tan pronto como el soporte recibe la información de que en la pasarela de pago quedan estas transacciones, las procesan manualmente en esta interfaz.
Q: – Tengo un par de preguntas. Una de ellas es sobre la zona de PCI DSS: ¿cómo extraen los registros de su contorno? Pregunto esto porque el desarrollador podría haber registrado cualquier cosa en los logs. La segunda pregunta: ¿cómo implementan los hotfixes? Hacerlo manualmente en la base de datos es una opción, pero pueden existir hotfixes gratuitos, ¿cuál es el procedimiento allí? Y la tercera pregunta, probablemente relacionada con RTO y RPO. Ustedes tienen una disponibilidad del 99.97%, casi cuatro nueves, pero entiendo que tienen un segundo centro de datos, un tercer centro de datos y un quinto centro de datos… ¿Cómo manejan su sincronización, replicación y todo lo demás?EK: – Comencemos con la primera. ¿La primer pregunta era sobre los logs? Cuando se generan los logs, hay una capa que enmascara todos los datos sensibles. Mira según la máscara y campos adicionales. Por lo tanto, nuestros logs salen con datos ya enmascarados y en el contorno de PCI DSS. Esta es una de las tareas regulares asignadas al departamento de pruebas. Ellos deben verificar cada tarea, incluidas las logs que generan, y esto es una de las tareas regulares en la revisión de código, para controlar que el desarrollador no registre algo indebido. La verificación posterior de esto se realiza regularmente por el departamento de seguridad informática aproximadamente una vez a la semana: se seleccionan aleatoriamente los logs del día anterior, y se procesan a través de un escáner de análisis en servidores de prueba para revisar todo.
Sobre los hot-fixes. Esto está incluido en nuestro reglamento de despliegues. Hemos separado un punto sobre los hot-fixes. Creemos que desplegamos hot-fixes las 24 horas cuando lo necesitamos. Tan pronto como se compila la versión, tan pronto como se prueba y tan pronto como tenemos un artefacto, se activa un administrador de sistemas de guardia a petición del soporte, y lo despliega en el momento en que es necesario.Sobre los «cuatro nueves». El número que tenemos ahora realmente ha sido alcanzado, y aspiramos a él en otro centro de datos. Ahora tenemos un segundo centro de datos y comenzamos a enrutar entre ellos, y la cuestión de la replicación entre centros de datos es, de hecho, un asunto no trivial. Intentamos resolverlo en su momento de varias maneras: intentamos usar el mismo «Tarantula» – no funcionó, lo digo directamente. Por lo tanto, llegamos a la conclusión de que hacemos un pedido de «sensación» manualmente. Cada aplicación en realidad opera en modo asincrónico de sincronización necesaria «cambio - hecho» entre los centros de datos.
Q: – Si tienes un segundo, ¿por qué no hay un tercero? Porque el Split-brain aún nadie...
EK: – Y no tenemos «Split-brain». Debido a que cada aplicación nuestra opera en multimaestro, no nos importa en qué centro llegó la solicitud. Estamos preparados para que, en caso de que un centro de datos falle (y eso lo contemplamos), y en medio de la solicitud del usuario cambiemos al segundo centro de datos, estamos listos para perder a ese usuario, de verdad; pero serán unas pocas, realmente unas pocas.
Q: – Buenas noches. Gracias por la presentación. Hablaste de tu depurador, que realiza ciertas transacciones de prueba en producción. ¡Cuéntanos sobre las transacciones de prueba! ¿Qué tan profundo se adentra?
EK: – Pasa por todo el ciclo de todo el componente. No hay diferencias entre una transacción de prueba y una transacción real para el componente. Y desde el punto de vista de la lógica, es simplemente un proyecto separado en el sistema, donde solo se ejecutan transacciones de prueba.
Q: – ¿Y dónde lo detienes? Core enviado...
EK: – Seguimos a «Core» en este caso para las transacciones de prueba... Tenemos un concepto llamado enrutamiento: «Core» sabe a qué sistema de pago se debe enviar – nosotros enviamos a un sistema de pago ficticio, que simplemente da una respuesta http y eso es todo.
Q: – Por favor, dígame, ¿tienen su aplicación escrita como un enorme monolito, o la han dividido en algún tipo de servicios o incluso microservicios?
EK: – No es un monolito, por supuesto, tenemos una aplicación orientada a servicios. Tenemos una broma que dice que tenemos un servicio de monolitos, ya que son realmente bastante grandes. A esto no se le puede llamar microservicios de ninguna manera, pero son, de hecho, servicios dentro de los cuales trabajan trabajadores de máquinas distribuidas.
Si el servicio en el servidor está comprometido...
Q: – Entonces tengo la siguiente pregunta. Incluso si fuera un monolito, aún diría que tienen muchos de esos instantáneos servidores, todos ellos, en principio, procesan datos, y la pregunta es: "En caso de que un servidor instantáneo o la aplicación, alguna parte específica, esté comprometida, ¿tienen algún control de acceso? ¿Quién puede hacer qué? ¿A quién dirigir preguntas, por qué datos?"
EK: – Sí, sin duda. Los requisitos de seguridad son bastante serios. En primer lugar, tenemos flujos de datos abiertos y puertos solo aquellos que anticipamos para el tráfico. Si un componente se comunica con la base de datos (digamos, con 'MySQL') a través de 5-4-3-2, solo se abrirán 5-4-3-2, y otros puertos, otras direcciones de tráfico no estarán disponibles. Además, hay que entender que en producción existen alrededor de 10 diferentes perímetros de seguridad. Y aunque la aplicación se hubiera comprometido de alguna manera, Dios no lo quiera, el intruso no podrá acceder a la consola de gestión del servidor, porque es otra zona de seguridad de red.Q: – En este contexto, me interesa más el punto de que ustedes tienen ciertos contratos con los servicios: qué pueden hacer, a través de qué 'acciones' pueden comunicarse entre sí... Y en un flujo normal, ciertos servicios solicitan una serie específica de 'acciones' de otros. En condiciones normales, no se comunican con otros, y tienen diferentes áreas de responsabilidad. Si uno de ellos se ve comprometido, ¿podría hacer 'acciones' de ese servicio?
EK: – Entiendo. Si en una situación normal con otro servidor la comunicación estaba permitida, entonces sí. De acuerdo con el contrato SLA, no supervisamos que solo te están permitidos los primeros 3 "acciones", mientras que la 4 "acción" no está permitida. Eso, probablemente, sería redundante para nosotros, porque ya tenemos un sistema de defensa de 4 niveles por diseño. Preferimos protegernos mediante contornos, no a nivel interno.
Cómo funcionan Visa, MasterCard y "Sberbank"
Q: – Quiero aclarar un punto sobre el cambio de usuario de un centro de datos a otro. Hasta donde sé, "Visa" y "MasterCard" operan bajo el protocolo binario síncrono 8583, donde hay mezclas. Y quería saber, ¿se refiere el cambio directamente a "Visa" y "MasterCard" o se refiere a los sistemas de pagos y a los procesadores?
EK: – Es hasta las mezclas. Las mezclas están en un solo centro de datos.
Q: – En términos generales, ¿tienes un solo punto de conexión?
EK: – Para "Visa" y "MasterCard" – sí. Simplemente porque "Visa" y "MasterCard" requieren inversiones bastante serias en infraestructura para establecer contratos separados para obtener un segundo par de mezclas, por ejemplo. Están reservados dentro del mismo centro de datos, pero si, Dios no lo quiera, se cae el centro de datos donde están las mezclas para conectarse a "Visa" y "MasterCard", entonces perderemos la conexión con "Visa" y "MasterCard"...
Q: – ¿Cómo pueden estar reservados? ¡Sé que "Visa" solo permite mantener una conexión en principio!
EK: – Ellos mismos suministran el equipo. En cualquier caso, nos llegó un equipo que está internamente reservado.
Q: – Entonces, ¿la estantería es de sus Connects Orange?..
EK: – Sí.
Q: – Pero, ¿qué pasa en este caso: si tu centro de datos desaparece, cómo continuar usándolo? ¿O simplemente se detiene el tráfico?
EK: – No. En este caso, simplemente redirigiremos el tráfico a otro canal, que, evidentemente, nos costará más, a los clientes también. Pero el tráfico no pasará a través de nuestra conexión directa con "Visa", "MasterCard", sino a través de un "Sberbank" condicional (muy exagerado).
Lamento mucho si ofendí a los empleados de "Sberbank". Pero según nuestras estadísticas, entre los bancos rusos, "Sberbank" falla con mayor frecuencia. No pasa un mes sin que algo se caiga en "Sberbank".

Un poco de publicidad 🙂
Gracias por permanecer con nosotros. ¿Te gustan nuestros artículos? ¿Quieres ver más contenido interesante? Apóyanos haciendo un pedido o recomendando a tus conocidos, , un análogo único de servidores entry-level que hemos diseñado para Ti: (disponibles opciones con RAID1 y RAID10, hasta 24 núcleos y hasta 40GB DDR4).
¿Dell R730xd a mitad de precio en el centro de datos Equinix Tier IV en Ámsterdam? Solo aquí ¡en los Países Bajos! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — ¡desde $99! Lee sobre cómo
Fuente: habr.com
