

¡Hola a todos! Soy desarrollador backend, escribo microservicios en Java + Spring. Trabajo en uno de los equipos de desarrollo de productos internos en Tinkoff.
En nuestro equipo, con frecuencia surge la cuestión de la optimización de consultas en la base de datos. Siempre queremos que sea un poco más rápido, pero no siempre podemos hacerlo solo con índices bien estructurados; a veces tenemos que buscar caminos alternativos. Durante uno de esos recorridos por la red en busca de optimizaciones razonables al trabajar con bases de datos, encontré , autor del libro SQL Performance Explained. Este es uno de esos raros tipos de blogs en el que se pueden leer todos los artículos de un tirón.
Quiero traducir para ustedes un pequeño artículo de Markus. Se puede considerar como una especie de manifiesto que busca llamar la atención sobre un viejo, pero aún relevante problema de rendimiento de la operación offset según el estándar SQL.
En algunos lugares, añadiré aclaraciones y comentarios del autor. Todas esas partes las marcaré como «pró.» para mayor claridad.
Una pequeña introducción
Creo que muchos saben cuán problemático y lento puede resultar trabajar con selecciones paginadas a través de offset. Pero, ¿sabían que se puede reemplazar por una construcción más eficiente de manera bastante sencilla?
Así que, la palabra clave offset indica a la base de datos que debe omitir los primeros n registros en la consulta. Sin embargo, la base de datos aún tiene que leer esos primeros n registros desde el disco, y en el orden especificado (pró.: aplicar ordenación si está especificada), y solo después de eso podrá devolver los registros comenzando desde n+1 en adelante. Lo más interesante es que el problema no está en una implementación específica en la base de datos, sino en la definición original según el estándar:
…las filas se ordenan primero de acuerdo con la <cláusula order by> y luego se limitan descartando el número de filas especificado en la <cláusula result offset> desde el principio…
-SQL:2016, Parte 2, 4.15.3 Tablas derivadas (pró.: ahora el estándar más utilizado)
El punto clave aquí es que offset toma un único parámetro: el número de registros que se deben omitir, y eso es todo. Siguiendo esta definición, la base de datos solo puede recuperar todos los registros y luego descartar los innecesarios. Es obvio que tal definición de offset obliga a realizar trabajo innecesario. Y aquí ni siquiera importa si es SQL o NoSQL.
Un poco más de dolor
Los problemas de offset no terminan aquí, y esta es la razón. Si entre la lectura de dos páginas de datos desde el disco, otra operación inserta un nuevo registro, ¿qué sucederá en este caso?
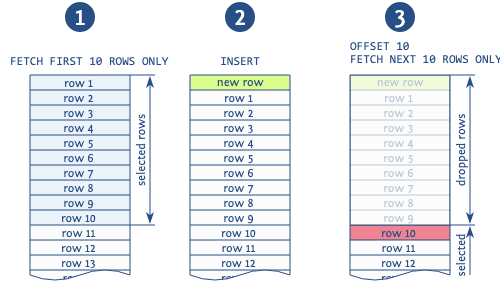
Cuando se utiliza offset para omitir registros de páginas anteriores, en la situación de agregar un nuevo registro entre las operaciones de lectura de diferentes páginas, es probable que obtenga duplicados (por ejemplo: esto puede suceder cuando leemos página por página utilizando la cláusula order by, ya que un nuevo registro puede insertarse en medio de nuestra salida).
La imagen ilustra claramente tal situación. La base de datos lee los primeros 10 registros, después se inserta un nuevo registro que desplaza todos los registros leídos en 1. Luego la base toma la nueva página de los siguientes 10 registros y empieza no desde el 11, como debería, sino desde el 10, duplicando este registro. Hay otras anomalías relacionadas con el uso de esta expresión, pero esta es la más común.
Como ya hemos determinado, este no es un problema específico de una base de datos o sus implementaciones. El problema radica en la definición de la paginación según el estándar SQL. Le decimos a la base de datos qué página debe obtener o cuántos registros debe omitir. La base simplemente no puede optimizar tal consulta, ya que tiene muy poca información.
También es importante aclarar que este problema no se debe a una palabra clave específica, sino más bien a la semántica de la consulta. Hay varias sintaxis idénticas en términos de problemática:
- La palabra clave offset, como se mencionó anteriormente.
- La construcción de dos palabras clave limit [offset] (aunque limit por sí mismo no es tan malo).
- Filtración basada en límites inferiores, construida sobre la numeración de filas (por ejemplo, row_number(), rownum, etc.).
Todas estas expresiones simplemente indican cuántas filas deben omitirse, sin ninguna información o contexto adicional.
A partir de este artículo, la palabra clave offset se utiliza como una generalización de todas estas variantes.
La vida sin OFFSET
Y ahora imaginemos cómo sería nuestro mundo sin todos estos problemas. Resulta que la vida sin offset no es tan complicada: se puede seleccionar solo aquellas filas que aún no hemos visto (por ejemplo: es decir, aquellas que no estaban en la página anterior), utilizando una condición en where.
En este caso, partimos del hecho de que los selects se ejecutan sobre un conjunto ordenado (el viejo y querido order by). Dado que tenemos un conjunto ordenado, podemos usar un filtro bastante simple para obtener solo los datos que están más allá del último registro de la página anterior:
    SELECT ...
    FROM ...
    WHERE ...
    AND id < ?last_seen_id
    ORDER BY id DESC
    FETCH FIRST 10 ROWS ONLY
Así es todo el principio de este enfoque. Por supuesto, al ordenar por múltiples columnas, todo se vuelve más divertido, pero la idea sigue siendo la misma. Es importante notar que esta estructura se puede aplicar en muchos -soluciones.
Este enfoque se llama método seek o paginación por conjunto de claves. Resuelve el problema de los resultados flotantes (nota: la situación con un registro entre lecturas de páginas, descrita anteriormente) y, por supuesto, lo que todos amamos, funciona más rápido y de manera más estable que el clásico offset. La estabilidad radica en que el tiempo de procesamiento de la solicitud no aumenta proporcionalmente al número de la tabla solicitada (nota: si quieres saber más sobre los diferentes enfoques de paginación, puedes . Allí también puedes encontrar comparativas de benchmarks sobre diferentes métodos).
Una de las diapositivas ¿Y qué hay de las herramientas?
La paginación por claves a menudo no es adecuada debido a la falta de soporte de herramientas para este método. La mayoría de las herramientas de desarrollo, incluidos diversos frameworks, no ofrecen la opción de qué método se usará para realizar la paginación.
La situación se complica debido a que el método descrito requiere soporte integral en las tecnologías utilizadas, desde la base de datos hasta la ejecución de solicitudes AJAX en el navegador durante el scroll infinito. En lugar de solo indicar el número de página, ahora tendrás que especificar un conjunto de claves para todas las páginas a la vez.
Ситуацию усугубляет то, что описанный метод требует сквозной поддержки в используемых технологиях — начиная от СУБД и заканчивая исполнением AJAX-запроса в браузере при бесконечном скроллинге. Вместо того чтобы указывать только номер страницы, теперь придется указывать набор ключей для всех страниц сразу.
Sin embargo, la cantidad de frameworks que admiten la paginación basada en claves está aumentando gradualmente. Esto es lo que hay hasta el momento:
- para Java;
- para Ruby;
- y para Django;
- para Python;
- — API de criterios para implementaciones de JPA;
- para Perl;
- , мапер для Node.js .
(Nota: algunos enlaces han sido eliminados debido a que, en el momento de la traducción, algunas bibliotecas no se habían actualizado desde 2017-2018. Si te interesa, puedes consultar la fuente original.)
Justo en este momento es donde necesito tu ayuda. Si desarrollas o mantienes un framework que de alguna manera utiliza paginación, por favor, te pido, te exhorto, te ruego que hagas soporte nativo para la paginación basada en claves. Si tienes preguntas o necesitas ayuda, estaré encantado de ayudar (, , ) (nota: por mi experiencia tratando con Markus, puedo decir que realmente se entusiasma con la divulgación de este tema).
Si utilizas soluciones listas que crees que merecen tener soporte para la paginación basada en claves, crea un request o incluso propone una solución lista, si es posible. También puedes mencionar este artículo en tu enlace.
Conclusión
La razón por la que un enfoque tan simple y útil como la paginación basada en claves es poco común no es porque sea complicado de implementar técnicamente o requiera un gran esfuerzo. La razón principal es que muchos están acostumbrados a ver y trabajar con offset — este enfoque está dictado por el propio estándar.
Como resultado, pocos piensan en cambiar su enfoque hacia la paginación, y por ello el soporte en herramientas por parte de frameworks y bibliotecas se desarrolla de manera lenta. Por lo tanto, si te atrae la idea y el objetivo de la paginación sin offset, ¡ayuda a difundirla!
Fuente:
Autor: Markus Winand
Fuente: habr.com
