

El principio de incertidumbre de Heisenberg establece que no se puede medir simultáneamente la posición de un objeto y su velocidad. Si un objeto se está moviendo, no tiene una ubicación precisa. Y si hay una ubicación determinada, entonces no tiene velocidad.
En lo que respecta a los microservicios en la plataforma Red Hat OpenShift (y bajo Kubernetes), gracias al software de código abierto, pueden informar simultáneamente sobre su rendimiento y estado. Esto no refuta al viejo Heisenberg, pero elimina la incertidumbre en el trabajo con aplicaciones en la nube. Istio facilita la organización del seguimiento y monitoreo de estas aplicaciones para mantener todo bajo control.
Definamos la terminología
Por trazado (Tracing) entendemos el registro de la actividad del sistema. Suena bastante general, pero en realidad una de las reglas principales aquí es que los datos de trazado se envíen a un almacenamiento correspondiente sin preocuparse por su formato. Todo el trabajo de búsqueda y análisis de datos recae en el consumidor. En Istio, se utiliza el sistema de trazado Jaeger, que implementa el modelo de datos OpenTracing.
Trazas (Traces, y el término ‘trazas’ se utiliza aquí con el significado de ‘huellas’, como en la balística) llamaremos a los datos que describen completamente el paso de una solicitud o unidad de trabajo, es decir, desde el origen hasta el final. Por ejemplo, todo lo que ocurre desde el momento en que un usuario presiona un botón en una página web hasta que se devuelven los datos, incluidos todos los microservicios involucrados. Se puede decir que una trazas describe completamente (o modela) el paso de la solicitud de ida y vuelta. En la interfaz de Jaeger, las trazas se descomponen en componentes a lo largo del tiempo, al igual que una cadena puede descomponerse en eslabones individuales. Solo que en lugar de eslabones, la traza consiste en lo que se llama span.
Span – es el intervalo desde el inicio hasta la finalización de una unidad de trabajo. Siguiendo la analogía, se puede decir que cada span representa un eslabón individual de la cadena. Un span puede tener (o no tener) uno o varios spans secundarios. Como consecuencia, el span de más alto nivel (root span) tendrá la misma duración total que la traza a la que se refiere.
Monitoreo – es, en esencia, la observación de su sistema, ya sea a través de la interfaz de usuario o mediante herramientas de automatización. La base del monitoreo reside en los datos de trazado. En Istio, el monitoreo se implementa a través de Prometheus y cuenta con una interfaz de usuario correspondiente. Prometheus soporta el monitoreo automático utilizando alertas y gestores de alertas.
Hacemos marcas
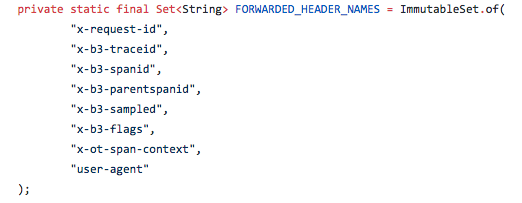
Para que el trazado sea posible, la aplicación debe crear una colección de spans. Luego, deben exportarse a Jaeger, que a su vez generará una representación visual del trazado. Entre otras cosas, estos spans etiquetan el nombre de la operación, así como las marcas de tiempo de inicio y finalización. La transmisión de spans se realiza redirigiendo los encabezados HTTP destinados a Jaeger de las solicitudes entrantes a las salientes. Dependiendo del lenguaje de programación utilizado, puede ser necesaria una pequeña modificación en el código fuente de las aplicaciones. A continuación, se presenta un ejemplo de código en Java (utilizando el marco de trabajo Spring Boot), que agrega encabezados B3 (al estilo Zipkin) a su solicitud en la clase de configuración de Spring:
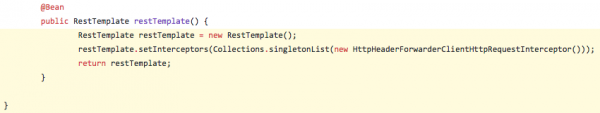
Para esto se utilizan las siguientes configuraciones de encabezados:
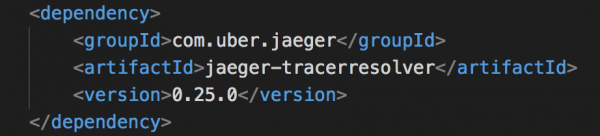
Si utiliza Java, no es necesario modificar el código, simplemente agregue algunas líneas en el archivo POM de Maven y defina las variables de entorno. Estas son las líneas que deben añadirse al archivo POM.XML para integrar el Resolvedor de Tracer de Jaeger:
Y las variables de entorno correspondientes se definen en el Dockerfile:
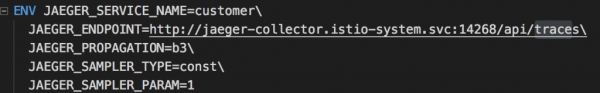
Listo, ahora todo está configurado y nuestros microservicios comenzarán a generar datos de trazado.
Observemos en términos generales
Istio incluye un panel de control sencillo basado en Grafana. Cuando todo está configurado y funcionando en la plataforma Red Hat OpenShift PaaS (en nuestro ejemplo, Red Hat OpenShift y Kubernetes están desplegados en minishift), este panel se inicia con el siguiente comando:
open "$(minishift openshift service grafana -u)\/d\/1\/istio-dashboard?refresh=5⩝Id=1"
El panel de Grafana permite evaluar rápidamente el rendimiento del sistema. Un fragmento de este panel se muestra en la imagen abajo:
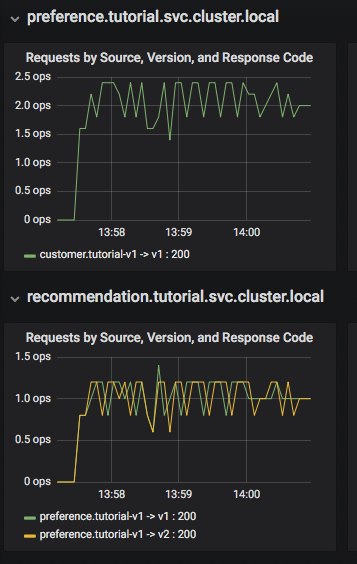
Aquí se puede ver que el microservicio customer llama al microservicio preference v1, y este a su vez llama a los microservicios recommendation v1 y v2. En el panel de Grafana hay un bloque Dashboard Row para métricas de alto nivel, como el número total de solicitudes (Global Request Volume), la tasa de solicitudes exitosas (success rates) y errores 4xx. Además, hay una representación de Server Mesh con gráficos para cada servicio y un bloque Services Row para ver detalles específicos de cada contenedor para cada servicio.
Ahora profundicemos un poco más
Con un rastreo correctamente configurado en Istio, que literalmente permite profundizar en el análisis del rendimiento del sistema desde el primer momento. En la interfaz de Jaeger se pueden ver los rastreos y observar cuán lejos y profundo llegan, así como localizar visualmente los cuellos de botella en el rendimiento. Al usar Red Hat OpenShift en la plataforma minishift, puedes lanzar la interfaz de Jaeger con el siguiente comando:
minishift openshift service jaeger-query --in-browser
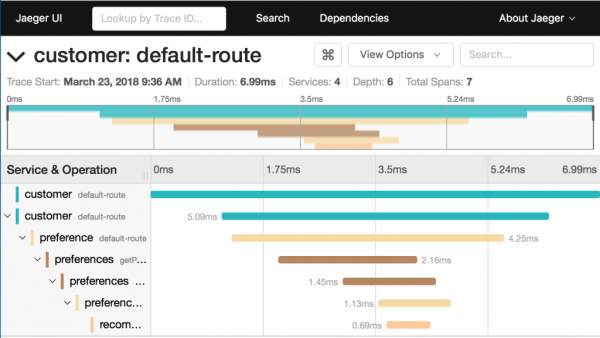
Qué se puede decir sobre el rastreo en esta captura:
- Se divide en 7 spans.
- El tiempo total de ejecución es de 6.99 ms.
- Se gastan 0.69 ms en el microservicio recommendation, que es el último en la cadena.
Diagramas de este tipo permiten entender rápidamente la situación cuando el rendimiento de todo el sistema se ve afectado por un único servicio mal funcionando.
Ahora bien, completemos la tarea y lancemos dos instancias del microservicio recommendation:v2 con el comando oc scale —replicas=2 deployment/recommendation-v2. Estos serán nuestros pods después de eso:
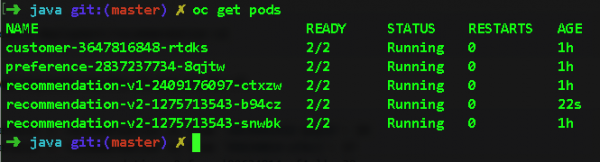
Si ahora regresamos a Jaeger y desplegamos el span para el servicio recommendation, veremos a qué pod se enrutan las solicitudes. De este modo, podemos localizar fácilmente los retardos en el nivel de un pod específico. Hay que prestar atención al campo node_id:
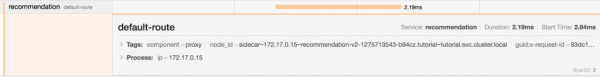
A dónde y cómo va todo
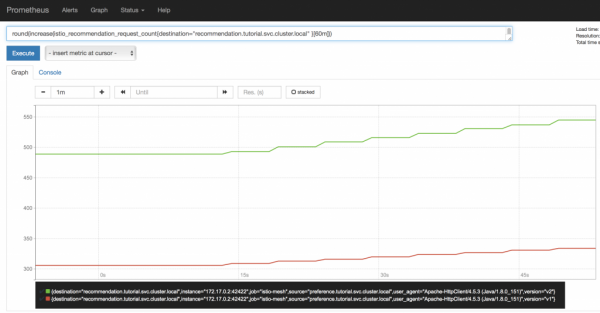
Ahora pasemos a la interfaz de Prometheus y, como era de esperar, vemos que las solicitudes entre la segunda y la primera versión del servicio recommendation se dividen en una proporción de 2:1, estrictamente según la cantidad de pods en funcionamiento. Además, este gráfico cambiará dinámicamente al escalar los pods hacia arriba o hacia abajo, lo que será especialmente útil en un Canary Deployment (discutiremos este tipo de despliegue en más detalle la próxima vez).
Todo apenas comienza
En realidad, hoy hemos apenas tocado la vasta fuente de información sobre Jaeger, Grafana y Prometheus. Esa era nuestra intención: guiarte en la dirección correcta y mostrarte las perspectivas de Istio.
Y recuerda, todo esto ya está integrado en Istio. Al usar ciertos lenguajes de programación (como Java) y frameworks (como Spring Boot), se puede implementar todo esto sin modificar el código de las aplicaciones. Sí, necesitarás hacer algunas modificaciones si utilizas otros lenguajes, principalmente Node.js o C#. Pero dado que la trazabilidad es uno de los requisitos esenciales para construir sistemas en la nube robustos, de cualquier manera tendrás que ajustar el código, ya tengas Istio o no. Así que, ¿por qué no dedicar tus esfuerzos de manera más efectiva?
Al menos para poder responder siempre a las preguntas "¿dónde?" y "¿qué tan rápido?" con un 100% de certeza.
Ingeniería de caos en Istio: así fue diseñado.
Saber romper cosas ayuda a que no se rompan.
Las pruebas de software son no solo complicadas, sino también importantes. Al mismo tiempo, las pruebas de corrección (por ejemplo, verificar si una función devuelve el resultado correcto) son una cosa, mientras que las pruebas en condiciones de red poco confiables son un desafío completamente diferente (a menudo se asume que la red siempre funciona sin falla, y este es el primer mito de los ocho en relación con la computación distribuida). Una de las dificultades para abordar este problema es cómo simular fallas en el sistema o introducirlas de manera intencionada mediante lo que se conoce como inyección de fallas. Esto puede hacerse modificando el código fuente de la aplicación. Pero entonces estarás probando no tu código original, sino una versión que simula fallas. Como resultado, corres el riesgo de caer en los peligros de la inyección de fallas y enfrentarte a los "geisenbugs" — fallas que desaparecen al intentar detectarlas.
Ahora te mostraremos cómo Istio ayuda a manejar estas complejidades de manera rápida.
Así es como se ve todo cuando funciona perfectamente.
Consideremos el siguiente escenario: tenemos dos pods para nuestro microservicio de recomendaciones, que tomamos del tutorial de Istio. Un pod está etiquetado como v1 y el otro como v2. Como podemos ver, todo funciona perfectamente.
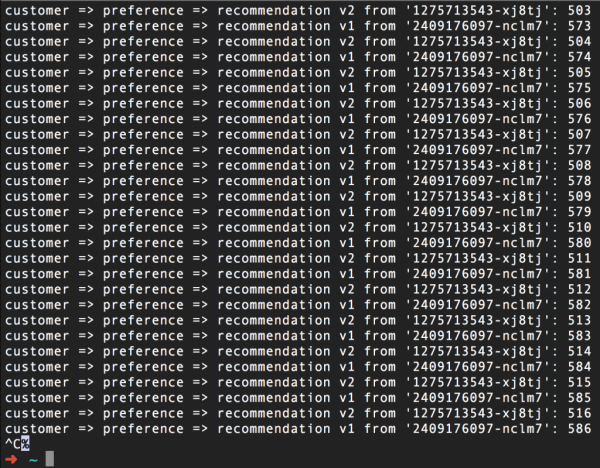
(Por cierto, el número de la derecha es simplemente un contador de llamadas para cada pod.)
Pero no necesitamos eso, ¿verdad? Bien, intentemos romper todo sin tocar el código fuente.
Causamos interrupciones en el microservicio
A continuación se muestra el archivo yaml para la regla de enrutamiento de Istio, que fallará en la mitad de los casos (error) servidores 503):
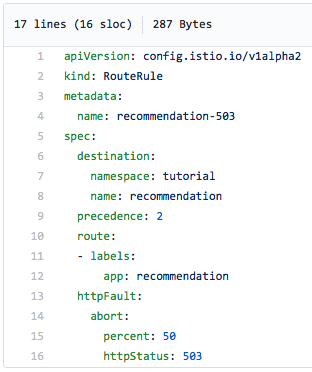
Tenga en cuenta que especificamos claramente que en la mitad de los casos debe devolverse un error 503.
Así es como se verá una captura de pantalla del comando curl ejecutándose en un ciclo después de activar esta regla para simular fallos. Como se puede ver, la mitad de las solicitudes devuelven un error 503, independientemente de a qué pod – v1 o v2 – se envíen:
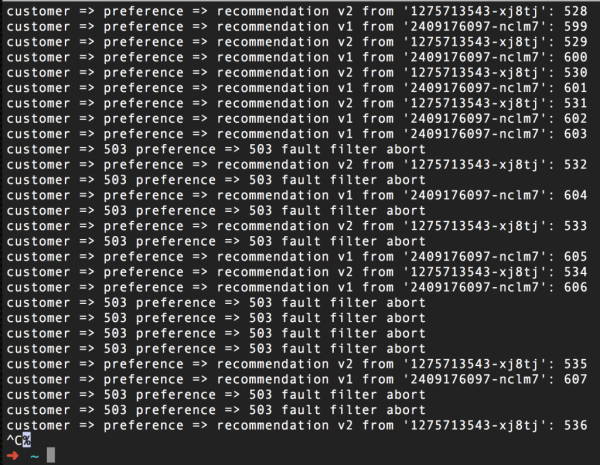
Para restaurar el funcionamiento normal, simplemente elimine esta regla, en nuestro caso con el comando istioctl delete routerule recommendation-503 -n tutorial. Aquí, Tutorial es el nombre del proyecto Red Hat OpenShift en el que se desarrolla nuestro tutorial de Istio.
Introducimos retrasos artificiales
Los errores 503 artificiales ayudan a probar el sistema en cuanto a su resistencia a fallos, pero la capacidad de prever y manejar los retrasos debe impresionarle aún más. De hecho, los retrasos en la vida real ocurren con más frecuencia que los fallos. Un microservicio que funciona lentamente es un veneno del cual sufre todo el sistema. Con Istio se puede probar el código relacionado con el manejo de retrasos sin necesidad de modificarlo. Para empezar, mostraremos cómo hacerlo en el caso de retrasos de red introducidos artificialmente.
Tenga en cuenta que después de dicha prueba, es posible que necesite (o desee) ajustar su código. La buena noticia aquí es que, en este caso, actuará de manera proactiva en lugar de reactiva. Así es como debe construirse el ciclo de desarrollo: codificación-pruebas-retroalimentación-codificación-pruebas…
Así es como se ve la regla, que… Aunque, ¿sabe qué? Istio es tan simple, y este archivo yaml es tan comprensible, que todo en este ejemplo habla por sí mismo, solo observe:
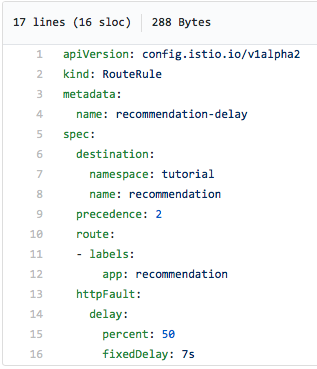
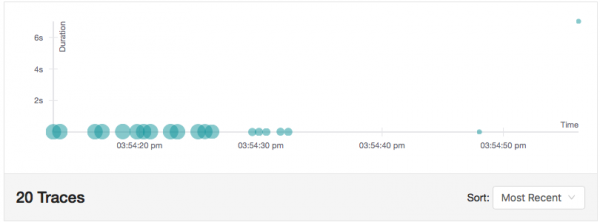
En la mitad de los casos, experimentaremos un retraso de 7 segundos. Y esto no es lo mismo que si hubiéramos insertado un comando sleep en el código fuente, ya que Istio realmente retrasa la solicitud por 7 segundos. Dado que Istio admite el rastreo de Jaeger, este retraso se observa claramente en la interfaz de usuario de Jaeger, como se muestra en la captura de pantalla a continuación. Presta atención a la larga solicitud en la esquina superior derecha del gráfico: su duración es de 7.02 segundos:
Este escenario permite probar el código en condiciones de retrasos en la red. Y está claro que, al eliminar esta regla, eliminaremos el retraso artificial. Lo repetimos, pero nuevamente hicimos todo esto sin tocar el código fuente.
No rendirse ni ceder
Otra función útil para la ingeniería del caos en Istio es la reintento de consultas a un servicio un número determinado de veces. La idea aquí es no dejar de intentar cuando la primera solicitud termina con un error 503 – y así, tal vez en el intento N, tengamos suerte. Puede ser que el servicio simplemente se haya caído temporalmente por alguna razón. Sí, esa razón debe ser investigada y solucionada. Pero eso es después; por ahora, intentemos que el sistema siga funcionando.
Así que queremos que el servicio ocasionalmente emita un error 503, y que Istio después intente comunicarse nuevamente. Y aquí claramente necesitamos una manera de generar un error 503 sin tocar el código mismo...
¡Espera, espera! ¡Acabamos de hacer esto!
Este archivo hará que el servicio recommendation-v2 ocasionalmente emita un error 503:
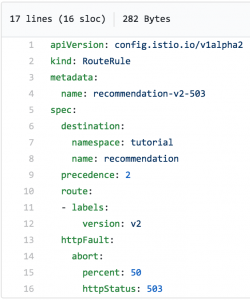
Es evidente que algunas solicitudes fallarán:
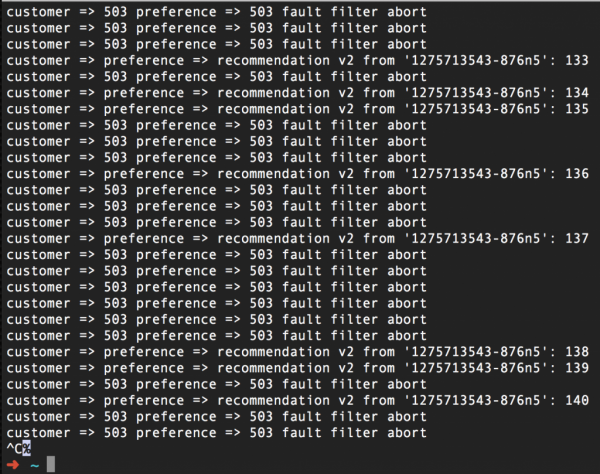
Ahora activemos la función Retry de Istio:
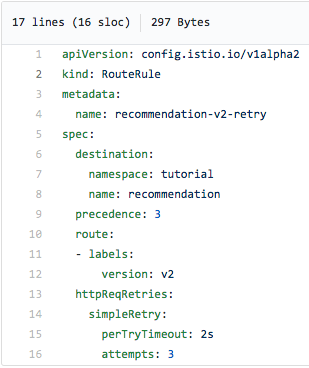
Esta regla de enrutamiento realiza tres reintentos con un intervalo de dos segundos y debería reducir (y en ideal, eliminar del radar) los errores 503:
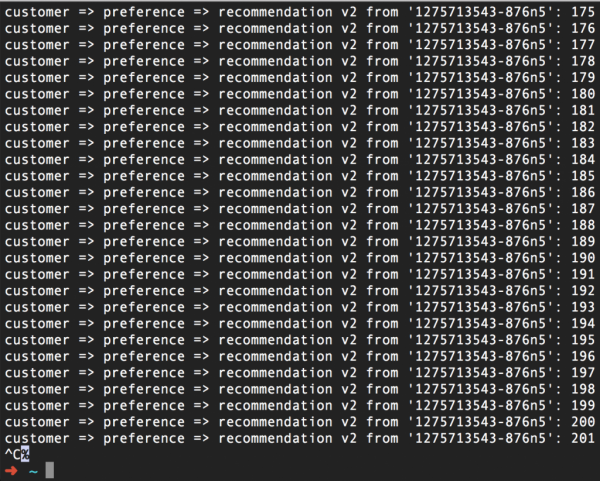
En resumen: hemos hecho que Istio, por un lado, genere un error 503 para la mitad de las solicitudes. Y por otro lado, el mismo Istio realiza tres intentos de volver a conectarse al servicio en caso de un error 503. Como resultado, todo funciona simplemente de maravilla. Así, utilizando la función Retry, cumplimos nuestra promesa de no rendirnos ni ceder.
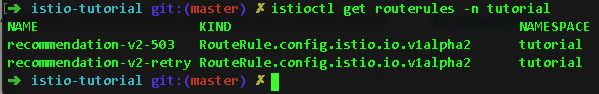
Y sí, lo hicimos nuevamente, sin tocar en absoluto el código. Todo lo que necesitábamos eran dos reglas de enrutamiento de Istio:
Cómo no decepcionar al usuario o siete no esperan
Ahora invirtamos la situación y consideremos un escenario en el que no retroceder y no rendirse vale la pena solo durante un tiempo fijo. Luego, simplemente debemos dejar de intentar procesar la solicitud para no hacer esperar a todos a un servicio que causa retrasos. En otras palabras, no defenderemos una posición perdida, sino que retrocederemos a una línea de seguridad para no decepcionar al usuario del sitio y no forzarlo a permanecer en la incertidumbre.
En Istio se puede establecer un tiempo de espera para la ejecución de la solicitud. Si el servicio supera este tiempo de espera, devuelve un error 504 (Gateway Timeout), y todo esto se realiza a través de la configuración de Istio. Pero tendremos que añadir en el código fuente del servicio un comando sleep (y luego, por supuesto, realizar un rebuild y redeploy) para simular el funcionamiento lento del servicio. Lamentablemente, de otra manera no se puede hacer.
Así que hemos insertado un sleep de tres segundos en el código del servicio recommendation v2, hemos reconstruido la imagen correspondiente y hemos hecho el redeploy del contenedor, y ahora añadiremos un tiempo de espera mediante la siguiente regla de enrutamiento de Istio:
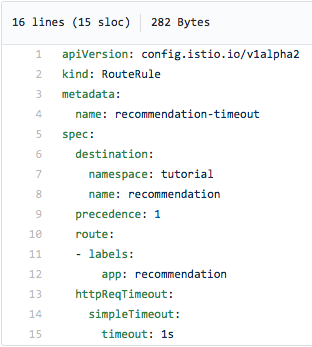
En la imagen de arriba se puede ver que dejamos de intentar comunicarnos con el servicio recommendation si no recibimos respuesta en un segundo, es decir, incluso antes de que ocurra el error 504. Después de aplicar esta regla de enrutamiento (y añadir el sleep de tres segundos en el código del servicio recommendation:v2), obtendremos lo siguiente:
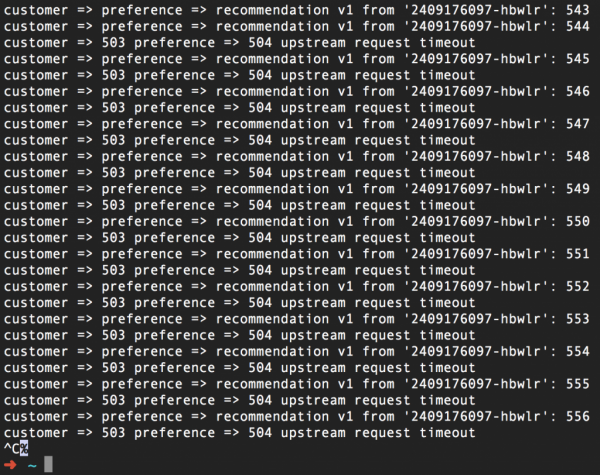
Una vez más, repetimos, pero el tiempo de espera se puede establecer sin tocar el código fuente. Un beneficio adicional aquí es que ahora puedes modificar tu código para que responda al tiempo de espera y probar fácilmente estas mejoras con Istio.
Y ahora todo junto
Introducir un poco de caos con Istio es una excelente manera de probar tu código y la robustez de tu sistema en general. Los patrones de fallback, bulkhead y circuit breaker, los mecanismos para crear fallos y retrasos artificiales, así como los reintentos y los tiempos de espera, serán muy útiles en la creación de sistemas en la nube resistentes a fallos. Combinados con Kubernetes y Red Hat OpenShift, estas herramientas ayudarán a enfrentar el futuro con confianza.
Fuente: habr.com
