

Para dominar completamente Kubernetes, es necesario conocer las diferentes formas de escalamiento de los recursos del clúster: por , esta es una de las principales tareas de Kubernetes. Hemos preparado una visión general de alto nivel de los mecanismos de escalado horizontal y vertical, así como recomendaciones sobre cómo utilizarlos de manera efectiva.
El artículo fue traducido por el equipo que implementó el escalado automático en .
Por qué es importante pensar en el escalado
— una herramienta para gestionar recursos y orquestar. Por supuesto, no estaría mal jugar con las increíbles funciones de implementación, monitoreo y gestión de pods (el módulo pod es un grupo de contenedores que se inician en respuesta a una solicitud).
Sin embargo, también se deben considerar las siguientes preguntas:
- ¿Cómo escalar módulos y aplicaciones?
- ¿Cómo mantener los contenedores en un estado operativo y eficiente?
- ¿Cómo reaccionar a los cambios constantes en el código y las cargas de trabajo de los usuarios?
Configurar clústeres de Kubernetes para equilibrar recursos y rendimiento puede ser una tarea compleja, que requiere conocimientos expertos sobre el funcionamiento interno de Kubernetes. La carga de trabajo de su aplicación o servicios puede variar a lo largo del día o incluso en una sola hora, así que es mejor imaginar el equilibrio como un proceso continuo.
Los niveles de escalado automático de Kubernetes
El escalado automático efectivo requiere coordinación entre dos niveles:
- El nivel de pods, que incluye el escalado horizontal (Horizontal Pod Autoscaler, HPA) y el escalado vertical (Vertical Pod Autoscaler, VPA). Este es el escalado de los recursos existentes para sus contenedores.
- El nivel del clúster, que es gestionado por el sistema de escalado automático de clústeres (Cluster Autoscaler, CA), que aumenta o disminuye el número de nodos dentro del clúster.
El módulo de escalado automático horizontal (HPA)
Como su nombre indica, el HPA escala el número de réplicas de los pods. Como triggers para cambiar el número de réplicas, la mayoría de los DevOps utilizan la carga en la CPU y la memoria. Sin embargo, también se puede escalar el sistema basado en , su o incluso .
Esquema de alto nivel del funcionamiento del HPA:
- HPA verifica continuamente los valores de métricas especificados durante la configuración, con un intervalo predeterminado de 30 segundos.
- HPA intenta aumentar el número de módulos si se alcanza el umbral establecido.
- HPA actualiza la cantidad de réplicas dentro del controlador de despliegue/replicación.
- El controlador de despliegue/replicación luego lanza todos los módulos adicionales necesarios.
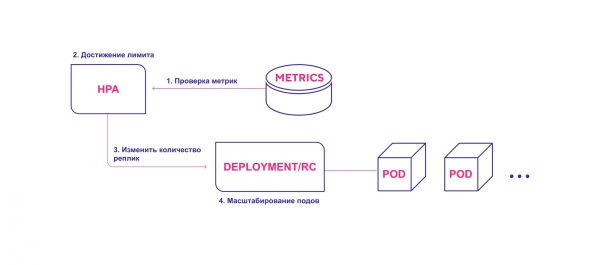
HPA inicia el proceso de despliegue de módulos al alcanzar un valor umbral de métricas.
Al utilizar HPA, considere lo siguiente:
- El intervalo de verificación de HPA por defecto es de 30 segundos. Esto se establece mediante el flag. horizontal-pod-autoscaler-sync-period en el gestor de controladores.
- El error relativo predeterminado es del 10%.
- Después del último incremento del número de módulos, HPA espera la estabilización de las métricas durante tres minutos. Este intervalo se establece mediante el flag. horizontal-pod-autoscaler-upscale-delay.
- Después de la última reducción del número de módulos, HPA espera la estabilización durante cinco minutos. Este intervalo se establece mediante el flag. horizontal-pod-autoscaler-downscale-delay.
- HPA funciona mejor con objetos de despliegue en lugar de controladores de replicación. La autoescalado horizontal no es compatible con la actualización gradual (rolling update) que manipula directamente los controladores de replicación. Al desplegar, el número de réplicas depende directamente de los objetos de despliegue.
Escalado vertical de los pods
El escalado vertical (VPA) asigna más (o menos) tiempo de CPU o memoria a los pods existentes. Es adecuado para pods con estado (stateful) o sin estado (stateless), pero principalmente está destinado a servicios stateful. Sin embargo, puede aplicar VPA también a módulos sin estado si se requiere ajustar automáticamente la cantidad de recursos inicialmente asignados.
VPA también reacciona a eventos OOM (fuera de memoria). Para cambiar el tiempo de CPU y la cantidad de memoria, se requiere reiniciar los pods. Al reiniciar, VPA respeta el presupuesto de distribución () para garantizar el número mínimo necesario de módulos.
Puede establecer un límite mínimo y máximo de recursos para cada módulo. Por ejemplo, se puede limitar la cantidad máxima de memoria asignada a 8 GB. Esto es útil si los nodos actuales no pueden asignar más de 8 GB de memoria a un contenedor. Las especificaciones detalladas y el mecanismo de funcionamiento se describen en .
Además, VPA cuenta con una interesante función de recomendaciones (VPA Recommender). Esta función rastrea el uso de recursos y los eventos OOM de todos los módulos para ofrecer nuevos valores de memoria y tiempo de CPU basándose en un algoritmo inteligente que considera métricas históricas. También hay una interfaz API que acepta un descriptor de pod y devuelve los valores de recursos recomendados.
Es importante destacar que VPA Recommender no rastrea el 'límite' de recursos. Esto puede llevar a que un módulo monopolice los recursos dentro de los nodos. Es mejor establecer un límite a nivel de espacio de nombres para evitar un consumo excesivo de memoria o tiempo de CPU.
Esquema de funcionamiento de VPA a alto nivel:
- VPA verifica continuamente los valores de las métricas especificadas en la instalación, con un intervalo predeterminado de 10 segundos.
- Si se alcanza el umbral establecido, VPA intenta cambiar la cantidad de recursos asignados.
- VPA actualiza la cantidad de recursos dentro del controlador de despliegue/replicación.
- Al reiniciar los módulos, se aplican todos los nuevos recursos a las instancias creadas.
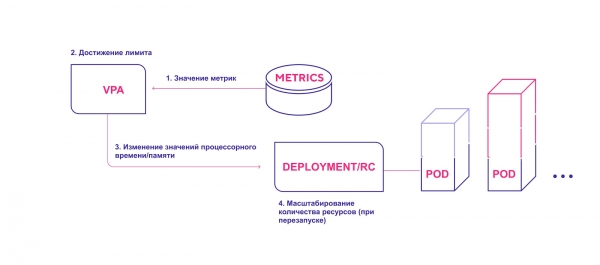
VPA añade la cantidad necesaria de recursos.
Considere los siguientes aspectos al utilizar VPA:
- La escalabilidad requiere el reinicio obligatorio del pod. Esto es necesario para evitar un funcionamiento inestable tras realizar cambios. Para mayor fiabilidad, los módulos se reinician y distribuyen entre nodos en función de los nuevos recursos asignados.
- VPA y HPA actualmente son incompatibles entre sí y no pueden funcionar en los mismos pods. Si aplica ambos mecanismos de escalado en un mismo clúster, asegúrese de que las configuraciones no permitan que se activen en los mismos objetos.
- VPA configura las solicitudes de contenedores de recursos únicamente en función de su uso pasado y presente. No establece límites en el uso de recursos. Pueden surgir problemas con el funcionamiento inadecuado de las aplicaciones que comiencen a consumir cada vez más recursos, lo que llevará a que Kubernetes apague este pod.
- VPA todavía está en una etapa temprana de desarrollo. Esté preparado para que el sistema pueda sufrir algunos cambios en un futuro cercano. Puede leer sobre y . Así, se planea implementar la colaboración entre VPA y HPA, así como el despliegue de módulos junto con la política de escalado automático vertical para ellos (por ejemplo, una etiqueta especial ‘requires VPA’).
Escalado automático del clúster de Kubernetes
El Escalador Automático del Clúster (Cluster Autoscaler, CA) cambia la cantidad de nodos según la cantidad de pods pendientes. El sistema verifica periódicamente la existencia de pods pendientes y aumenta el tamaño del clúster si se requieren más recursos y si el clúster no excede los límites establecidos. CA interactúa con el proveedor de servicios en la nube, solicita nodos adicionales o libera los inactivos. La primera versión pública de CA fue presentada en Kubernetes 1.8.
Esquema de funcionamiento a alto nivel de CA:
- CA verifica la existencia de pods en estado pendiente cada 10 segundos por defecto.
- Si uno o más pods están pendientes debido a que no hay suficientes recursos disponibles en el clúster para asignarlos, intenta provisionar uno o varios nodos adicionales.
- Cuando el proveedor de servicios en la nube asigna el nodo necesario, este se une al clúster y está listo para atender los pods.
- El programador de Kubernetes distribuye los pods pendientes en el nuevo nodo. Si después de esto algunos pods siguen en estado pendiente, el proceso se repite y se añaden nuevos nodos al clúster.
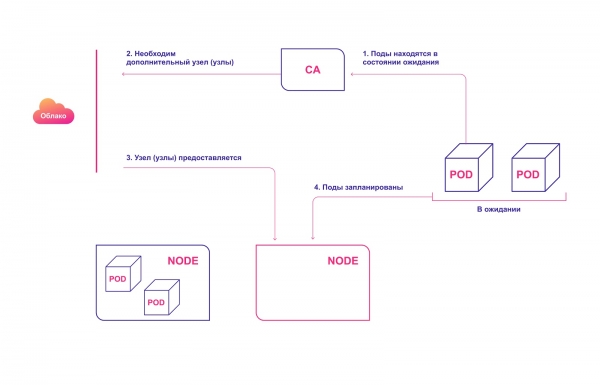
Asignación automática de nodos del clúster en la nube
Tenga en cuenta lo siguiente al utilizar CA:
- CA garantiza que todos los pods en el clúster tengan espacio para ejecutarse, independientemente del nivel de carga del CPU. Además, intenta garantizar que no haya nodos innecesarios en el clúster.
- CA registra la necesidad de escalado aproximadamente cada 30 segundos.
- Una vez que el nodo ya no es necesario, CA espera 10 minutos por defecto antes de escalar el sistema.
- En el sistema de autoescalado hay un concepto de expansores (expanders). Estas son distintas estrategias para seleccionar un grupo de nodos a los que se añadirán nuevos.
- Utilice la opción de manera responsable cluster-autoscaler.kubernetes.io/safe-to-evict (true). Si se crean muchos pod o si muchos de ellos están dispersos en todos los nodos, perderá en gran medida la capacidad de reducir el tamaño del clúster.
- desde cualquier lugar del mundo. Es la solución ideal para crear una oficina en la nube, donde todos los programas y datos de los empleados están en un entorno seguro , para evitar la eliminación de pod, ya que esto podría hacer que parte de su aplicación se interrumpa por completo.
Cómo interactúan entre sí los sistemas de autoescalado de Kubernetes
Para una armonía ideal, se debe aplicar el autoescalado tanto a nivel de pod (HPA/VPA) como a nivel de clúster. Se comunican relativamente fácil entre sí:
- HPA o VPA actualizan las réplicas de pod o los recursos asignados a los pod existentes.
- Si faltan nodos para el escalado planificado, CA nota que hay pod en estado de espera.
- CA asigna nuevos nodos.
- Los módulos se distribuyen en los nuevos nodos.
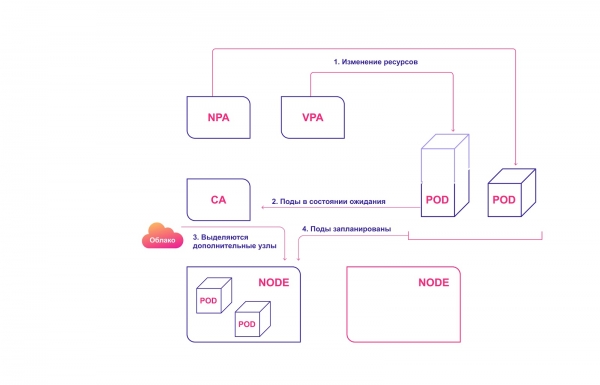
Sistema de escalado conjunto de Kubernetes
Errores típicos en el autoescalado de Kubernetes
Hay varios problemas comunes que enfrentan los DevOps al intentar implementar el autoescalado.
HPA y VPA dependen de métricas y ciertos datos históricos. Si se asignan recursos insuficientes, los módulos se archivan y no pueden generar métricas. En este caso, el autoescalado nunca ocurrirá.
La operación de escalado en sí es sensible al tiempo. Queremos que los módulos y el clúster escalen rápidamente, antes de que los usuarios noten problemas y fallos. Por lo tanto, se deben considerar los tiempos medios de escalado de pod y del clúster.
El escenario ideal es de 4 minutos:
- 30 segundos. Actualización de métricas objetivo: 30−60 segundos.
- 30 segundos. HPA verifica los valores de métricas: 30 segundos.
- Menos de 2 segundos. Módulos pod creados y pasando a estado de espera: 1 segundo.
- Menos de 2 segundos. CA ve módulos en espera y envía llamadas para preparar nodos: 1 segundo.
- 3 minutos. El proveedor de la nube asigna nodos. K8s espera a que estén listos: hasta 10 minutos (depende de varios factores).
El peor (y más realista) escenario — 12 minutos:
- 30 segundos. Actualización de métricas objetivo.
- 30 segundos. HPA verifica los valores de las métricas.
- Menos de 2 segundos. Los módulos pod se crean y pasan a un estado de espera.
- Menos de 2 segundos. CA ve los módulos en espera y envía llamadas para preparar los nodos.
- 10 minutos. El proveedor de la nube asigna nodos. K8s espera a que estén listos. El tiempo de espera depende de varios factores, como la latencia del proveedor, la latencia del sistema operativo y el funcionamiento de herramientas auxiliares.
No confunda los mecanismos de escalado de los proveedores de la nube con nuestro CA. Este último opera dentro del clúster de Kubernetes, mientras que el mecanismo del proveedor de la nube funciona en base a la distribución de nodos. No sabe lo que sucede con sus pod o aplicaciones. Estos sistemas funcionan en paralelo.
Cómo gestionar el escalado en Kubernetes
- Kubernetes es una herramienta de gestión de recursos y orquestación. Las operaciones de gestión de pods y recursos del clúster son un hito clave en el aprendizaje de Kubernetes.
- Domine la lógica de escalabilidad de los pods teniendo en cuenta HPA y VPA.
- Se debe usar CA solo si comprende bien las necesidades de sus pods y contenedores.
- Para optimizar la configuración del clúster, es necesario entender cómo diferentes sistemas de escalado trabajan juntos.
- Al evaluar el tiempo de escalado, tenga en cuenta el peor y el mejor escenario.
Fuente: habr.com
