

Basado en la discusión en el chat
Últimamente, se están librando verdaderas batallas sobre la definición de los conceptos de DevOps y SRE.
A pesar de que gran parte de las discusiones sobre este tema ya han cansado, incluido yo mismo, decidí someter a juicio la perspectiva de la comunidad de Habr sobre este asunto. Aquellos que estén interesados, están invitados a continuar leyendo. ¡Y que comience todo de nuevo!
Antecedentes
Así que, en tiempos antiguos, había un equipo de desarrolladores de software y administradores de servidores. Los primeros escribían código con éxito, mientras que los segundos, usando varias palabras cálidas y cariñosas hacia los primeros, configuraban los servidores, y de vez en cuando iban a los desarrolladores solo para escuchar «en mi máquina todo funciona». El negocio esperaba software, todo se estancaba, a menudo fallaba, y todos estaban nerviosos. Especialmente quien pagaba por todo este desorden. La gloriosa era de la lámpara. Pero ustedes ya saben de dónde surge DevOps.
El nacimiento de las prácticas DevOps
Luego llegaron unos tíos serios y dijeron: esto no es una industria, así no se puede trabajar. Y trajeron modelos de ciclo de vida. Por ejemplo, el modelo V.
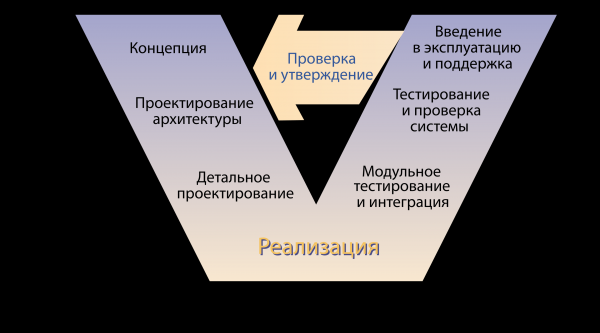
Entonces, ¿qué vemos? El negocio llega con una concepción, los arquitectos diseñan soluciones, los desarrolladores escriben código, y luego — el colapso. Alguien prueba el producto de alguna manera, alguien lo entrega al usuario final, y en algún lugar de la salida de este modelo milagroso, un solitario cliente del negocio espera la prometida solución. Llegamos a la conclusión de que se necesitan métodos que permitan organizar este proceso. Y decidieron crear prácticas que los implementaran.
Una digresión lírica sobre qué es una práctica
Por práctica entiendo la combinación de tecnología y disciplina. Un ejemplo: la práctica de describir la infraestructura como código usando terraform. La disciplina es cómo describir la infraestructura con código, está en la mente del desarrollador, y la tecnología es el propio terraform.
Y decidieron llamarlos prácticas DevOps; creo que se referían a de Development a Operations. Inventaron diferentes conceptos complejos: prácticas de CI/CD, prácticas basadas en el principio de IaC, miles de ellas. Y comenzó, los desarrolladores escriben código, los ingenieros DevOps transforman la descripción del sistema en forma de código en sistemas funcionales (sí, el código, desafortunadamente, es solo una descripción, pero no la realización del sistema), la entrega avanza, y así sucesivamente. Los administradores de ayer, tras aprender nuevas prácticas, se reconvirtieron orgullosamente en ingenieros DevOps, y todo empezó. Y hubo tarde, y hubo mañana… perdón, no era de ahí.
Todo de nuevo no va bien
Solo se habían asentado las cosas, y varios astutos ‘metodólogos’ comenzaron a escribir gruesos libros sobre prácticas DevOps, surgían silenciosamente disputas sobre quién era realmente el célebre ingeniero DevOps y qué significa que DevOps es una cultura de producción, la insatisfacción volvió a surgir. De repente, se descubrió que la entrega de software es una tarea absolutamente no trivial. Cada infraestructura de desarrollo tiene su propio stack, en algunos lugares hay que compilar, en otros desplegar un entorno, aquí se necesita tomcat, allí otro método complicado de arranque—en fin, la cabeza duele. Además, el problema, curiosamente, se encontraba principalmente en la organización de los procesos: esta función de entrega, como un cuello de botella, empezó a bloquear los procesos. Además, la operación (Operations) no se ha cancelado. No es visible en el modelo V, y allí aún está todo el ciclo de vida a la derecha. Al final, se necesita mantener la infraestructura, observar el monitoreo, resolver incidentes y, además, ocuparse de la entrega. Es decir, tener un pie en el desarrollo y otro en la operación—y de repente surgió ese Development & Operations. Y además llegó el furor por los microservicios. Con ellos también comenzó la migración del desarrollo de máquinas locales a la nube—intenta depurar algo localmente si tienes decenas y cientos de microservicios, aquí la entrega constante se convierte en un medio de supervivencia. Para una 'pequeña y modesta empresa' está bien, pero ¿y Google?
SRE de Google
Llegó Google, se comió los cactus más grandes y decidió: no necesitamos eso, necesitamos confiabilidad. Y la confiabilidad necesita gestión. Y decidió: necesitamos especialistas que gestionen la confiabilidad. Los llamó ingenieros SR y les dijo: aquí tienen todo, háganlo bien como siempre. Aquí tienen SLI, aquí tienen SLO, aquí tienen monitoreo. Y los dirigió hacia operaciones. Y llamó a su 'DevOps confiable' SRE. Parecía que todo iba bien, pero hay un truco sucio que Google pudo permitirse: contratar a personas para el puesto de ingenieros SR que tuvieran la calificación de desarrolladores y que además conocieran un poco sobre el funcionamiento de sistemas operativos. Además, Google tiene problemas para contratar a estas personas, principalmente porque compite consigo mismo: alguien tiene que describir la lógica empresarial. Dejó la entrega a los ingenieros de lanzamiento, los ingenieros SR gestionan la confiabilidad (obviamente, no de manera directa, sino influyendo en la infraestructura, modificando la arquitectura, siguiendo cambios y métricas, lidiando con incidentes). Es hermoso, se puede . ¿Y qué hacer si no eres Google, pero la confiabilidad sigue preocupándote?
Desarrollo de ideas DevOps
Aquí es donde apareció Docker, que nació de lxc, y luego vinieron diversos sistemas de orquestación como Docker Swarm y Kubernetes, y los ingenieros DevOps respiraron aliviados— la unificación de prácticas simplificó la entrega. Se simplificó tanto que ahora es posible incluso dejar la entrega a los desarrolladores, ¿qué hay de deployment.yaml? La contenedorización resuelve el problema. Y la madurez de los sistemas CI/CD ya está en un nivel donde con un solo archivo todo está en marcha — los desarrolladores se las arreglarán solos. Y aquí comenzamos a hablar de cómo establecer nuestro SRE, con... cualquiera.
SRE no en Google
Bueno, hemos entregado el servicio, parece que podemos respirar de nuevo y regresar a los buenos viejos tiempos, cuando los administradores miraban la carga de los procesadores, ajustaban los sistemas y disfrutaban en silencio de algo misterioso... Espera. No fue por esto por lo que empezamos todo (¡qué pena!). De repente, resulta que en el enfoque de Google podemos adoptar excelentes prácticas: no es la carga del procesador lo que importa, ni con qué frecuencia cambiamos los discos, o cuánto optimizamos los costos en la nube, sino las métricas de negocio: todos esos tan mencionados SLx. Y la gestión de la infraestructura sigue siendo nuestra responsabilidad, hay que resolver incidentes, permanecer de guardia de vez en cuando, y, en general, estar al tanto de los procesos de negocio. Y chicos, empiecen a programar a un buen nivel, Google ya los está esperando.
Resumiendo. De repente, pero ya están cansados de leer y no pueden esperar para comentar al autor del artículo. DevOps como práctica de entrega ha sido, es y seguirá siendo. No va a desaparecer. SRE como conjunto de prácticas operativas hace que dicha entrega sea exitosa.
Fuente: habr.com
