

Continuamos con nuestra serie de artículos dedicados a explorar poco conocidos métodos para mejorar el rendimiento de consultas «aparentemente simples» en PostgreSQL:
No piensen que no me gusta el JOIN tanto… 🙂
Pero a menudo, sin él, la consulta resulta notablemente más eficiente que con él. Así que hoy intentaremos eliminar el costoso JOIN — mediante el uso de un diccionario.
A partir de PostgreSQL 12, parte de las situaciones descritas a continuación pueden comportarse de manera algo diferente debido a . Este comportamiento puede volver al anterior especificando la clave
MATERIALIZED.
Muchos «hechos» sobre el diccionario limitado
Tomemos una tarea aplicada bastante realista: necesitamos generar una lista de o tareas activas con sus remitentes:
25.01 | Ivanov I.I. | Preparar la descripción del nuevo algoritmo.
22.01 | Ivanov I.I. | Escribir un artículo en Habr: la vida sin JOIN.
20.01 | Petrov P.P. | Ayudar a optimizar la consulta.
18.01 | Ivanov I.I. | Escribir un artículo en Habr: JOIN considerando la distribución de datos.
16.01 | Petrov P.P. | Ayudar a optimizar la consulta.
En un mundo abstracto, los autores de las tareas deberían distribuirse uniformemente entre todos los empleados de nuestra organización, pero en realidad las tareas provienen, por lo general, de un número bastante limitado de personas — «de la dirección» arriba en la jerarquía o «de colegas» de departamentos adyacentes (analistas, diseñadores, marketing, …).
Supongamos que en nuestra organización de 1000 personas, solo 20 autores (normalmente incluso menos) asignan tareas a cada ejecutor en particular y , para acelerar la consulta «tradicional».
Generador de scripts
-- empleados
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "nombre"
, '2000-01-01'::date - (random() * 1e4)::integer fecha_nacimiento
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- tareas con la distribución indicada
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer fecha_tarea
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, fecha_tarea);
CREATE INDEX ON task(author_id);
Mostramos las últimas 100 tareas para un ejecutor específico:
SELECT
  task.*
, person.nombre
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  fecha_tarea DESC
LIMIT 100; 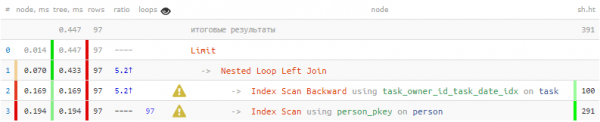
Resulta que 1/3 del total del tiempo y 3/4 de las lecturas páginas de datos se realizaron solo para buscar al autor 100 veces — para cada tarea que se muestra. Pero sabemos que entre esos cien hay solo 20 diferentes — ¿no podríamos utilizar ese conocimiento?
diccionario hstore
Hagamos uso de para generar un 'diccionario' clave-valor:
CREATE EXTENSION hstoreEn el diccionario, solo necesitamos colocar el ID del autor y su nombre, para luego poder extraer por esta clave:
-- formamos la selección objetivo
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    fecha_tarea DESC
  LIMIT 100
)
-- formamos el diccionario para valores únicos
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(nombre)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- obtenemos los valores relacionados del diccionario
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> clave
FROM
T; 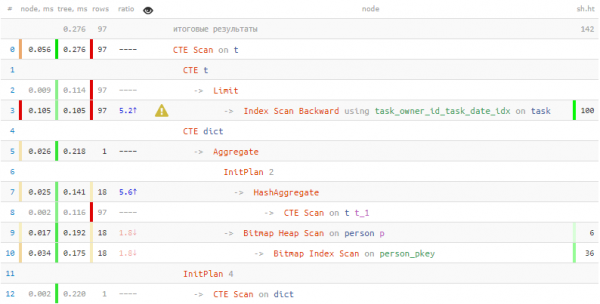
La obtención de información sobre las personas tomó 2 veces menos tiempo y 7 veces menos datos leídos! Además de la 'dictalización', estos resultados nos ayudaron a alcanzar también la extracción masiva de registros de la tabla en una sola pasada mediante = ANY(ARRAY(...)).
Registros de la tabla: serialización y deserialización
Pero, ¿qué hacer si necesitamos guardar en el diccionario no un solo campo de texto, sino un registro completo? En ese caso, PostgreSQL puede trabajar con el registro de la tabla como un solo valor:
...
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- magia #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- magia #2
FROM
  T;
Desglosamos lo que realmente sucedió aquí:
- Tomamos p como alias para el registro completo de la tabla person y recolectamos de ellos un array.
- Este array de registros ha sido convertido en un array de cadenas de texto (person[]::text[]), para colocarlo en un diccionario hstore como un array de valores.
- Al obtener el registro relacionado, lo extraímos del diccionario por la clave como una cadena de texto.
- Necesitamos convertir el texto en un valor de tipo tabla person (se crea automáticamente un tipo con el mismo nombre para cada tabla).
- Desplegamos el registro tipado en columnas utilizando
(...).*.
diccionario json
Pero un truco como el que aplicamos arriba no funcionará si no hay un tipo de tabla correspondiente para hacer la "conversión". La misma situación ocurrirá si intentamos usar una cadena CTE en lugar de una "tabla real".
En este caso, nos ayudarán :
...
, p AS ( -- esto ya es CTE
  SELECT
    *
  FROM
    person
  WHERE
    ...
)
, dict AS (
  SELECT
    json_object( -- ahora es json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- y dentro json para cada fila
    )
  FROM
    p
)
SELECT
  *
FROM
  T
, LATERAL(
    SELECT
      *
    FROM
      json_to_record(
        ((TABLE dict) ->> author_id::text)::json -- extraído del diccionario como json
      ) AS j(name text, birth_date date) -- llenamos la estructura que necesitamos
  ) j;
Cabe destacar que al describir la estructura objetivo, podemos enumerar no todos los campos de la fila original, sino solo aquellos que realmente necesitamos. Si tenemos una tabla "nativa", es mejor utilizar la función json_populate_record.
El acceso al diccionario sigue siendo único, pero los costos de [de]serialización json son bastante altos, por lo que este método es razonable utilizarlo solo en algunos casos, cuando un "honesto" CTE Scan resulta ser peor.
Probar el rendimiento
Así que obtuvimos dos maneras de serializar datos en un diccionario — hstore / json_object. Además, los propios arrays de claves y valores también se pueden generar de dos maneras, con transformación interna o externa a texto: array_agg(i::text) / array_agg(i)::text[].
Comprobemos la eficiencia de diferentes tipos de serialización con un ejemplo puramente sintético — serializando diferentes cantidades de claves:
CON dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Script estimativo: serialización
CON T COMO (
  SELECCIONAR
    *
  , (
      SELECCIONAR
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      DE
        (
          SELECCIONAR
            array_agg(el) ea
          DE
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              CON dict COMO (
                SELECCIONAR
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                DE
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TABLA dict
            $$) T(el text)
        ) T
    ) et
  DE
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  ORDENAR POR
    1, 2
)
SELECCIONAR
  v
, avg(et)::numeric(32,3)
DE
  T
GROUP BY
  1
ORDENAR POR
1; 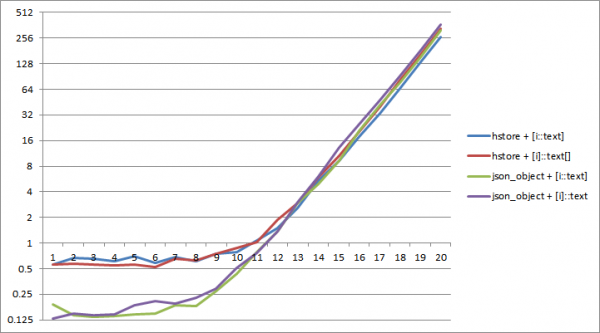
En PostgreSQL 11, aproximadamente hasta el tamaño del diccionario de 2^12 claves. la serialización a json requiere menos tiempo.. En este sentido, la combinación de json_object y la conversión de tipos 'internos' es la más eficiente. array_agg(i::text).
Ahora intentemos leer el valor de cada clave 8 veces, ya que si no se accede al diccionario, ¿para qué es útil?
Script de evaluación: lectura del diccionario.
CON T COMO (
  SELECCIONAR
    *
  , (
      SELECCIONAR
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      DE
        (
          SELECCIONAR
            array_agg(el) ea
          DE
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              CON dict COMO (
                SELECCIONAR
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                DE
                  generate_series(1, $$ || (1 < (i % ($$ || (1 << v) || $$) + 1)::text
              DE
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        ) T
    ) et
  DE
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  ORDENAR POR
    1, 2
)
SELECCIONAR
  v
, avg(et)::numeric(32,3)
DE
  T
GROUP BY
  1
ORDENAR POR
1; 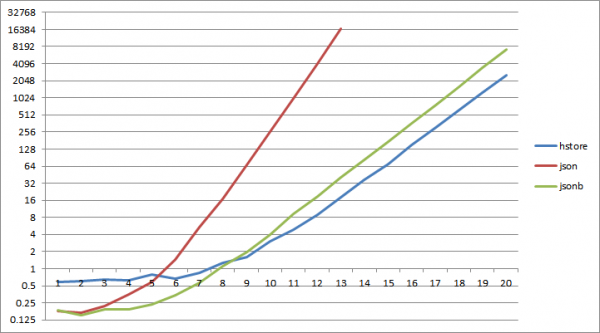
Y... ya aproximadamente con 2^6 claves, la lectura del diccionario json comienza a perder considerablemente frente a la lectura desde hstore, para jsonb lo mismo ocurre con 2^9.
Conclusiones finales:
- si tienes que realizar un JOIN con registros repetidos múltiples veces — es mejor usar 'diccionario' de la tabla.
- si tu diccionario es esperablemente pequeño y lo leerás solo unas pocas veces — puedes usar json[b].
- en todos los demás casos, hstore + array_agg(i::text) será más eficiente.
Fuente: habr.com
