

En RIT 2019, nuestro colega Alexander Korotkov hizo una presentación sobre la automatización del desarrollo en CIAN: para simplificar la vida y el trabajo, usamos nuestra propia plataforma Integro. Esta plataforma rastrea el ciclo de vida de las tareas, elimina operaciones rutinarias de los desarrolladores y reduce notablemente la cantidad de errores en producción. En esta publicación complementaremos la presentación de Alexander y contaremos cómo pasamos de simples scripts a integrar productos de código abierto a través de nuestra propia plataforma y qué hace un equipo separado de automatización.
Nivel cero
«No existe el nivel cero, no sé de eso»
Maestro Shifu de la película «Kung Fu Panda»
La automatización en CIAN comenzó 14 años después de la fundación de la empresa. En ese momento, había 35 personas en el equipo de desarrollo. Difícil de creer, ¿verdad? Por supuesto, de alguna manera existía la automatización, pero la dirección específica de integración continua y entrega de código comenzó a formarse precisamente en 2015.
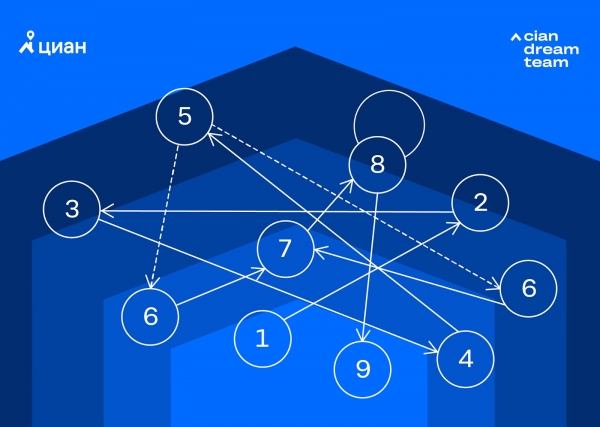
En ese momento, teníamos un enorme monolito hecho en Python, C# y PHP, desplegado en servidores Linux/Windows. Para desplegar este monstruo, teníamos un conjunto de scripts que ejecutábamos manualmente. También había la construcción del monolito, que traía dolor y sufrimiento debido a conflictos al fusionar ramas, corregir defectos y reconstruir «con otro conjunto de tareas en la construcción». Simplificando, el proceso se veía así:
No estábamos conformes con esto, y queríamos construir un proceso de construcción y despliegue repetible, automatizado y controlado. Para esto necesitábamos un sistema CI/CD, y estábamos eligiendo entre la versión gratuita de Teamcity y Jenkins gratuito, ya que habíamos trabajado con ambos y cumplían con nuestras necesidades funcionales. Elegimos Teamcity como el producto más reciente. En ese momento, aún no usábamos arquitectura de microservicios y no esperábamos un gran número de tareas y proyectos.
Llegamos a la idea de un sistema propio
La implementación de Teamcity eliminó solo una parte del trabajo manual: aún quedaba la creación de Pull Requests, el avance de las tareas en Jira y la selección de tareas para el lanzamiento. Con esto, el sistema Teamcity ya no podía manejarlo. Era necesario elegir un camino para una mayor automatización. Consideramos opciones de trabajo con scripts en Teamcity o la transición a sistemas de automatización de terceros. Pero al final decidimos que necesitábamos la máxima flexibilidad que solo una solución propia podría ofrecer. Así nació la primera versión de un sistema de automatización interno llamado Integro.
Teamcity se encarga de la automatización a nivel de inicio de procesos de compilación y despliegue, mientras que Integro se enfocó en la automatización de alto nivel de los procesos de desarrollo. Era necesario combinar el trabajo con las tareas en Jira con el procesamiento del código fuente relacionado en Bitbucket. En esta etapa, dentro de Integro comenzaron a aparecer sus propios flujos de trabajo para gestionar tareas de diferentes tipos.
Debido al aumento de la automatización en los procesos empresariales, creció el número de proyectos y ejecuciones en Teamcity. Así surgió un nuevo problema: un solo instancia gratuita de Teamcity ya no era suficiente (3 agentes y 100 proyectos), añadimos otra instancia (otros 3 agentes y 100 proyectos), y luego otra más. Como resultado, obtuvimos un sistema de varios clústeres que era difícil de gestionar:
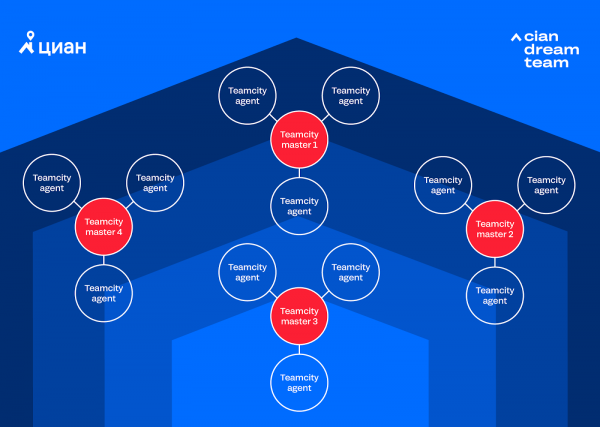
Cuando surgió la necesidad de una cuarta instancia, nos dimos cuenta de que no podíamos continuar así, ya que los costos totales de mantenimiento de 4 instancias ya no eran sostenibles. Surgió la pregunta sobre la compra de Teamcity de pago o optar por Jenkins gratuito. Realizamos cálculos sobre instancias y planes de automatización y decidimos que viviríamos con Jenkins. Pasadas unas semanas, cambiamos a Jenkins y nos libramos de parte del dolor de cabeza relacionado con el mantenimiento de varias instancias de Teamcity. Por lo tanto, pudimos centrarnos en el desarrollo de Integro y en adaptar Jenkins a nuestras necesidades.
Con el crecimiento de la automatización básica (en forma de creación automática de Pull Requests, recolección y publicación de cobertura de código y otras verificaciones) surgió un deseo persistente de renunciar al lanzamiento manual y dejar este trabajo a los robots. Además, dentro de la empresa comenzó la migración a microservicios, que requerían lanzamientos frecuentes, separados uno del otro. Así, poco a poco, llegamos a lanzamientos automáticos de nuestros microservicios (por ahora, seguimos lanzando el monolito manualmente debido a la complejidad del proceso). Pero, como suele suceder, surgió una nueva dificultad.
Automatizamos las pruebas
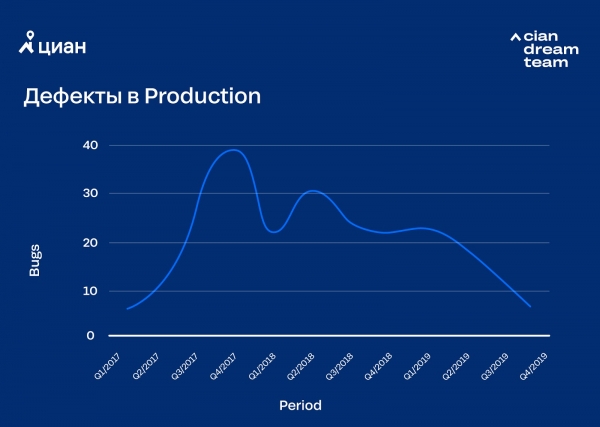
Debido a la automatización de los lanzamientos, los procesos de desarrollo se aceleraron parcialmente al omitir algunos pasos de prueba. Esto llevó a una pérdida temporal de calidad. Suena trivial, pero junto con la aceleración de los lanzamientos, también hubo que cambiar la metodología de desarrollo del producto. Era necesario considerar la automatización de las pruebas, fomentar la responsabilidad personal (se refiere a 'adoptar la idea en la mente', no a sanciones monetarias) del desarrollador por el código que produce y los errores en él, así como la decisión de publicar/no publicar tareas a través de un despliegue automático.
Al abordar los problemas de calidad, llegamos a dos decisiones importantes: comenzamos a realizar pruebas canarias e implementamos un monitoreo automático de errores con respuesta automática ante su aumento. La primera decisión permitió detectar errores evidentes antes de que el código llegara a producción, y la segunda redujo el tiempo de respuesta a problemas en producción. Por supuesto, los errores ocurren, pero dedicamos la mayor parte del tiempo y esfuerzo no a corregirlos, sino a minimizarlos.
Equipo de automatización
Actualmente contamos con un personal de 130 desarrolladores, y seguimos . El equipo de integración y entrega continua de código (en adelante, equipo de Deploy and Integration o DI) está compuesto por 7 personas y trabaja en 2 áreas: el desarrollo de la plataforma de automatización Integro y DevOps.
DevOps se encarga de los entornos Dev/Beta del sitio CIAN, del entorno Integro, ayuda a los desarrolladores a resolver problemas y desarrolla nuevos enfoques para escalar los entornos. La dirección de desarrollo de Integro trabaja tanto en Integro como en servicios relacionados, como complementos para Jenkins, Jira, Confluence, y también desarrolla utilidades y aplicaciones auxiliares para equipos de desarrolladores.
El equipo DI trabaja en conjunto con el equipo de la Plataforma, que se ocupa de desarrollar la arquitectura, bibliotecas y enfoques de desarrollo dentro de la empresa. Además, cualquier desarrollador dentro de CIAN puede contribuir a la automatización, por ejemplo, realizando microautomatizaciones para las necesidades del equipo o compartiendo una gran idea sobre cómo mejorar la automatización.
La tarta de capas de automatización en CIAN
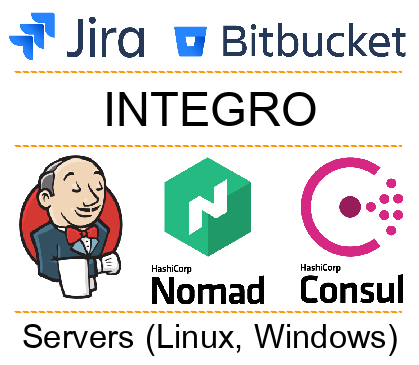
Todos los sistemas involucrados en la automatización se pueden dividir en varias capas:
- Sistemas externos (Jira, Bitbucket, etc.). Estos son los que utilizan los equipos de desarrollo.
- Plataforma Integro. A menudo, los desarrolladores no trabajan directamente con ella, pero es la que soporta toda la automatización.
- Servicios de entrega, orquestación y descubrimiento (por ejemplo, Jenkins, Consul, Nomad). Con ellos desplegamos código en servidores y aseguramos la operatividad de los servicios entre sí.
- Nivel físico (servidores, sistemas operativos, software relacionado). En este nivel opera nuestro código. Puede ser tanto un servidor físico como uno virtual (LXC, KVM, Docker).
Basándonos en este concepto, dividimos las áreas de responsabilidad dentro del equipo DI. Los dos primeros niveles están bajo la responsabilidad de la dirección de desarrollo de Integro, mientras que los dos últimos niveles son responsabilidad de DevOps. Esta división permite enfocarse en las tareas y no interfiere con la interacción, ya que estamos cerca unos de otros y constantemente compartimos conocimientos y experiencias.
Integro
Enfoquémonos en Integro y comencemos con la pila tecnológica:
- CentOs 7
- Docker + Nomad + Consul + Vault
- Java 11 (el viejo monolito de Integro permanecerá en Java 8)
- Spring Boot 2.X + Spring Cloud Config
- PostgreSql 11
- RabbitMQ
- Apache Ignite
- Camunda (embebida)
- Grafana + Graphite + Prometheus + Jaeger + ELK
- Interfaz Web: React (CSR) + MobX
- SSO: Keycloak
Mantenemos el principio de desarrollo de microservicios, aunque tenemos un legado en forma de un monolito de la versión temprana de Integro. Cada microservicio se ejecuta en su propio contenedor de Docker, y los servicios se comunican entre sí a través de solicitudes HTTP y mensajes de RabbitMQ. Los microservicios se encuentran entre sí a través de Consul y realizan solicitudes a él, autenticándose mediante SSO (Keycloak, OAuth 2/OpenID Connect).
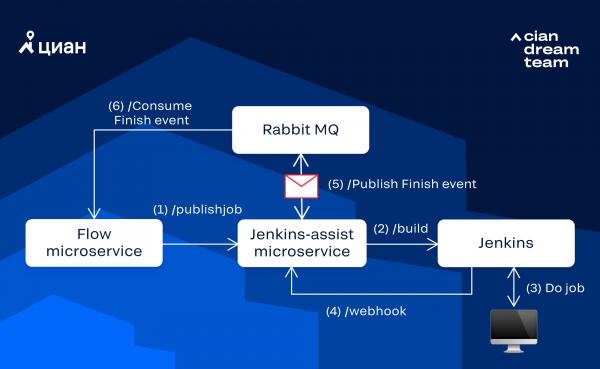
Como un ejemplo real, consideremos la interacción con Jenkins, que consta de los siguientes pasos:
- El microservicio de gestión del flujo de trabajo (en adelante, microservicio de flujo) desea iniciar una construcción en Jenkins. Para ello, encuentra a través de Consul la IP:PORT del microservicio de integración con Jenkins (en adelante, microservicio de Jenkins) y le envía una solicitud asíncrona para iniciar la construcción en Jenkins.
- El microservicio de Jenkins, tras recibir la solicitud, genera y devuelve un Job ID en respuesta, que luego se podrá utilizar para identificar el resultado de la ejecución. Al mismo tiempo, inicia la construcción en Jenkins a través de una llamada a la API REST.
- Jenkins ejecuta la construcción y, una vez finalizada, envía un webhook con los resultados de la ejecución al microservicio de Jenkins.
- El microservicio de Jenkins, al recibir el webhook, genera un mensaje de finalización del procesamiento de la solicitud y adjunta los resultados de la ejecución. El mensaje generado se envía a la cola de RabbitMQ.
- A través de RabbitMQ, el mensaje publicado llega al microservicio de flujo, que se entera del resultado de su tarea, comparando el Job ID de la solicitud con el Job ID del mensaje recibido.
Actualmente tenemos alrededor de 30 microservicios, que se pueden dividir en varios grupos:
- Gestión de configuraciones.
- Comunicación e interacción con los usuarios (mensajeros, correo).
- Trabajo con el código fuente.
- Integración con herramientas de despliegue (Jenkins, Nomad, Consul, etc.).
- Monitoreo (de lanzamientos, errores, etc.).
- Herramientas web (UI para gestión de entornos de prueba, recopilación de estadísticas, etc.).
- Integración con rastreadores de tareas y sistemas similares.
- Gestión del flujo de trabajo para diferentes tareas.
Flujo de trabajo de la tarea.
Integro automatiza las acciones relacionadas con el ciclo de vida de la tarea. Simplificando, por ciclo de vida de la tarea nos referimos al flujo de trabajo de la tarea en Jira. En nuestros procesos de desarrollo hay varias variaciones de flujo de trabajo según el proyecto, el tipo de tarea y las opciones seleccionadas en la tarea concreta.
Veamos el flujo de trabajo que utilizamos con más frecuencia:
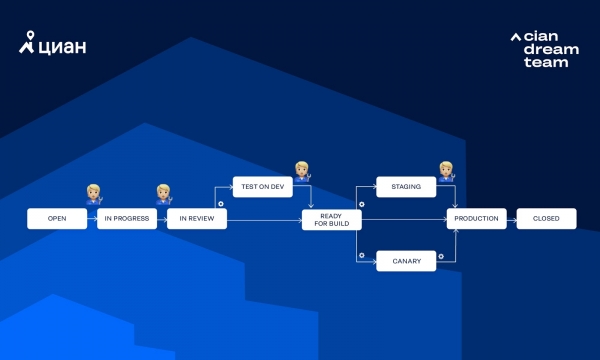
En el diagrama, el engranaje indica que la transición es invocada automáticamente por Integro, mientras que la figura de la persona significa que la transición es invocada manualmente por un ser humano. Veamos algunos caminos que la tarea puede seguir en este flujo de trabajo.
Pruebas completamente manuales en DEV+BETA sin tests canarios (así es como generalmente liberamos monolitos):
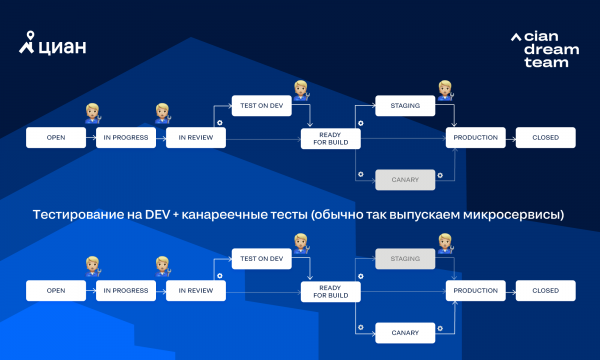
También pueden existir otras combinaciones de transición. A veces se puede elegir el camino que seguirá la tarea a través de las opciones en Jira.
Movimiento de la tarea
Veamos los pasos principales que se realizan al mover una tarea a través del flujo de trabajo 'Pruebas en DEV + tests canarios':
1. Un desarrollador o PM crea la tarea.
2. El desarrollador toma la tarea para trabajar. Al finalizar, la cambia a estado 'EN REVISIÓN'.
3. Jira envía un Webhook al microservicio de Jira (responsable de la integración con Jira).
4. El microservicio de Jira envía una solicitud al servicio Flow (responsable de los flujos de trabajo internos donde se realiza el trabajo) para iniciar el flujo de trabajo.
5. Dentro del servicio Flow:
- Se asignan revisores a la tarea (microservicio de Usuarios, que conoce todo sobre los usuarios + microservicio de Jira).
- A través del microservicio Source (que conoce los repositorios y ramas, pero no trabaja con el código en sí) se busca en los repositorios donde hay una rama de nuestra tarea (para simplificar la búsqueda, el nombre de la rama coincide con el número de la tarea en Jira). Generalmente, la tarea tiene solo una rama en un repositorio, lo que simplifica la gestión de la cola para el despliegue y reduce el acoplamiento entre repositorios.
- Para cada rama encontrada, se lleva a cabo la siguiente secuencia de acciones:
i) Se mezcla la rama master (microservicio de Git para trabajar con el código).
ii) La rama se bloquea de cambios por parte del desarrollador (microservicio de Bitbucket).
iii) Se crea una Pull Request para esta rama (microservicio de Bitbucket).
iv) Se envía un mensaje sobre la nueva Pull Request a los chats de desarrolladores (microservicio Notify para trabajar con notificaciones).
v) Se inician la construcción, pruebas y despliegue de la tarea en DEV (microservicio de Jenkins para trabajar con Jenkins).
vi) Si todos los pasos anteriores se completan con éxito, Integro coloca su aprobación en la Pull Request (microservicio de Bitbucket). - Integro espera la aprobación en la Pull Request de los revisores asignados.
- Tan pronto como se reciban todas las aprobaciones necesarias (incluidas las pruebas automatizadas que hayan pasado positivamente), Integro cambia la tarea al estado 'Prueba en Desarrollo' (microservicio de Jira).
6. Los testers realizan la prueba de la tarea. Si no hay problemas, la tarea se traslada al estado Listo para Construir.
7. Integro «ve» que la tarea está lista para el lanzamiento y inicia su despliegue en modo canario (microservicio Jenkins). La preparación para el lanzamiento se determina mediante un conjunto de reglas. Por ejemplo, la tarea debe estar en el estado correcto, no debe haber bloqueos en otras tareas, no debe haber implementaciones activas de este microservicio, etc.
8. La tarea se traslada al estado Canario (microservicio Jira).
9. Jenkins inicia el despliegue de la tarea en modo canario a través de Nomad (generalmente 1-3 instancias) y notifica sobre la implementación al servicio de monitoreo de lanzamientos (microservicio DeployWatch).
10. El microservicio DeployWatch recopila el fondo de errores y reacciona a él si es necesario. Si el fondo de errores supera el límite (el límite se calcula automáticamente), se notifica a los desarrolladores a través del microservicio Notify. Si después de 5 minutos el desarrollador no reacciona (presiona Revert o Stay), se inicia la reversión automática de las instancias canarias. Si el fondo no se ha excedido, el desarrollador debe iniciar manualmente el despliegue de la tarea en Producción (presionando un botón en la interfaz de usuario). Si en 60 minutos el desarrollador no ha iniciado el despliegue en Producción, las instancias canarias también se revertirán por razones de seguridad.
11. Después de iniciar el despliegue en Producción:
- La tarea se traslada al estado Producción (microservicio Jira).
- El microservicio Jenkins inicia el proceso de despliegue y notifica sobre la implementación al microservicio DeployWatch.
- El microservicio DeployWatch verifica que todos los contenedores en Producción se hayan actualizado (ha habido casos en los que no se actualizaron todos).
- A través del microservicio Notify se envía una notificación sobre los resultados del despliegue en Producción.
12. Los desarrolladores tendrán 30 minutos para iniciar la reversión de la tarea desde Producción en caso de detectar un comportamiento incorrecto del microservicio. Después de este tiempo, la tarea se integrará automáticamente en master (microservicio Git).
13. Después de una fusión exitosa en master, el estado de la tarea se cambiará a Cerrado (microservicio Jira).
El esquema no pretende ser exhaustivo (en realidad hay más pasos), pero permite evaluar el grado de integración en los procesos. No consideramos que este esquema sea ideal y mejoramos los procesos de soporte automático de lanzamientos y despliegues.
¿Qué sigue?
Tenemos grandes planes para el desarrollo de la automatización, como eliminar las operaciones manuales en los lanzamientos del monolito, mejorar la monitorización en el despliegue automático y optimizar la interacción con los desarrolladores.
Pero aquí nos detendremos por ahora. Hemos cubierto muchos temas sobre la automatización de forma superficial y no hemos tocado algunos en absoluto, así que estaremos encantados de responder a sus preguntas. Esperamos sus sugerencias sobre qué aspectos desarrollar en detalle, escríbanos en los comentarios.
Fuente: habr.com
