

Ocasionalmente surge la necesidad de buscar datos relacionados por un conjunto de claves, hasta que reunamos la cantidad total de registros requeridos.
El ejemplo más "vivo" es obtener las 20 tareas más antiguas, presentes en la lista de empleados (por ejemplo, dentro de un mismo departamento). Para diversos "dashboards" de gestión con resúmenes breves sobre áreas de trabajo, este tipo de información es bastante común.
En este artículo revisaremos la implementación en PostgreSQL de una versión "ingenua" de solución a esta tarea, así como un algoritmo "más inteligente" y uno completamente complejo de un "ciclo" en SQL con una condición de salida basada en los datos encontrados,que puede ser útil tanto para el desarrollo general como para su aplicación en otros casos similares.
Tomemos un conjunto de datos de prueba de . Para que los registros devueltos no "salten" de vez en cuando al coincidir los valores ordenados, extenderemos el índice temático agregando una clave primaria. Al mismo tiempo, esto le dará unicidad y nos garantizará la claridad del orden de clasificación:
CREATE INDEX ON task(owner_id, task_date, id);
-- y eliminamos el antiguo
DROP INDEX task_owner_id_task_date_idx;
Como se escucha, así se escribe
Primero esbozaremos la versión más simple de la consulta, pasando el ID de los ejecutores :
SELECT
  *
FROM
  task
WHERE
  owner_id = ANY('{1,2,4,8,16,32,64,128,256,512}'::integer[])
ORDER BY
  task_date, id
LIMIT 20; 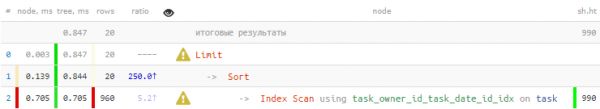
Es un poco triste: pedimos solo 20 registros, y el Index Scan nos devolvió 960 filas, las cuales luego también tuvimos que ordenar… ¿Y si intentamos leer menos?
unnest + ARRAY
El primer pensamiento que nos ayudará es que, si necesitamos solo 20 registros ordenados, es suficiente con leer no más de 20 ordenados en el mismo orden por cada clave. Afortunadamente, tenemos un índice adecuado (owner_id, task_date, id). Utilizaremos el mismo mecanismo de extracción y "despliegue en columnas"
de un registro completo de la tabla, como en. También aplicaremos la conversión a arreglo con la función ARRAY() WITH T AS ( SELECT unnest(ARRAY( SELECT t FROM task t WHERE owner_id = unnest ORDER BY task_date, id LIMIT 20 -- limitamos aquí... )) r FROM unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[]) ) SELECT (r).* FROM T ORDER BY (r).task_date, (r).id LIMIT 20; -- ... y aquí también:
¡Oh, ya es mucho mejor! 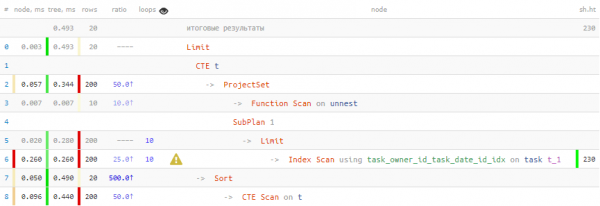
Un 40% más rápido, y 4.5 veces menos datos tuvimos que leer. Materialización de registros de tablas a través de CTE
Quiero señalar queen algunos casos en algunos casos Intentar trabajar directamente con los campos de registro después de buscarlos en una subconsulta, sin «embalar» en un CTE, puede llevar a la «multiplicación» de InitPlan proporcionalmente al número de esos mismos campos:
SELECT
  ((
    SELECT
      t
    FROM
      task t
    WHERE
      owner_id = 1
    ORDER BY
      task_date, id
    LIMIT 1
  ).*);
Resultado (coste=4.77..4.78 filas=1 ancho=16) (tiempo real=0.063..0.063 filas=1 bucles=1)
Buffers: hit compartido=16
InitPlan 1 (devuelve $0)
-> Límite (coste=0.42..1.19 filas=1 ancho=48) (tiempo real=0.031..0.032 filas=1 bucles=1)
Buffers: hit compartido=4
-> Escaneo de índice usando task_owner_id_task_date_id_idx en task t (coste=0.42..387.57 filas=500 ancho=48) (tiempo real=0.030..0.030 filas=1 bucles=1)
Condición del índice: (owner_id = 1)
Buffers: hit compartido=4
InitPlan 2 (devuelve $1)
-> Límite (coste=0.42..1.19 filas=1 ancho=48) (tiempo real=0.008..0.009 filas=1 bucles=1)
Buffers: hit compartido=4
-> Escaneo de índice usando task_owner_id_task_date_id_idx en task t_1 (coste=0.42..387.57 filas=500 ancho=48) (tiempo real=0.008..0.008 filas=1 bucles=1)
Condición del índice: (owner_id = 1)
Buffers: hit compartido=4
InitPlan 3 (devuelve $2)
-> Límite (coste=0.42..1.19 filas=1 ancho=48) (tiempo real=0.008..0.008 filas=1 bucles=1)
Buffers: hit compartido=4
-> Escaneo de índice usando task_owner_id_task_date_id_idx en task t_2 (coste=0.42..387.57 filas=500 ancho=48) (tiempo real=0.008..0.008 filas=1 bucles=1)
Condición del índice: (owner_id = 1)
Buffers: hit compartido=4"
InitPlan 4 (devuelve $3)
-> Límite (coste=0.42..1.19 filas=1 ancho=48) (tiempo real=0.009..0.009 filas=1 bucles=1)
Buffers: hit compartido=4
-> Escaneo de índice usando task_owner_id_task_date_id_idx en task t_3 (coste=0.42..387.57 filas=500 ancho=48) (tiempo real=0.009..0.009 filas=1 bucles=1)
Condición del índice: (owner_id = 1)
Buffers: hit compartido=4
El mismo registro fue «buscado» 4 veces… Hasta PostgreSQL 11, este comportamiento ocurre regularmente, y la solución consiste en «embalar» en un CTE, que es un límite incondicional para el optimizador en estas versiones.
Acumulador recursivo
En la versión anterior, leímos en total 200 filas por las necesarias 20. Ya no son 960, pero aún menos — ¿es posible?
Intentemos aprovechar el conocimiento de que necesitamos un total de 20 registros. Es decir, iteraremos la lectura de datos solo hasta alcanzar la cantidad necesaria.
Paso 1: lista inicial
Es obvio que nuestra lista «objetivo» de 20 registros debe comenzar con los «primeros» registros de una de nuestras claves owner_id. Por lo tanto, primero encontraremos tales «primeros» por cada una de las claves y los colocaremos en la lista, ordenándola en el orden que deseamos — (task_date, id).
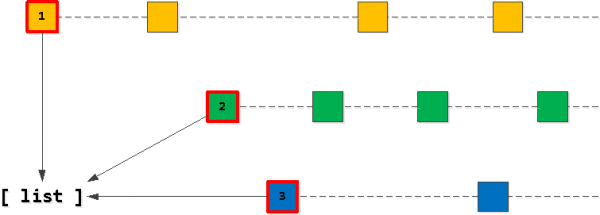
Paso 2: encontramos los «siguientes» registros
Ahora, si tomamos el primer registro de nuestra lista y comenzamos a «avanzar» por el índice manteniendo la clave owner_id, todos los registros encontrados son justo los siguientes en la selección resultante. Por supuesto, solo hasta que crucemos la clave aplicada segunda entrada en la lista.
Si resulta que hemos "cruzado" la segunda entrada, entonces la última entrada leída debe ser añadida a la lista en lugar de la primera (con el mismo owner_id), tras lo cual la lista se vuelve a ordenar.
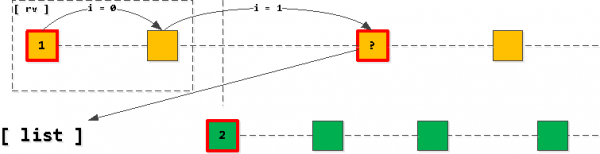
Es decir, siempre tenemos que en la lista hay como máximo una entrada por cada una de las claves (si se han agotado las entradas y no hemos "cruzado", simplemente la primera entrada de la lista desaparecerá y no se añadirá nada), y además siempre están ordenadas por orden ascendente de la clave aplicada (task_date, id).
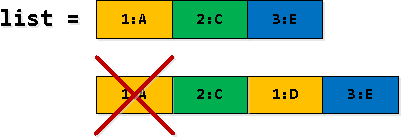
Paso 3: filtramos y "desplegamos" las entradas
En algunas líneas de nuestra selección recursiva, algunas entradas rv se duplican — primero encontramos las que "cruzan el límite de la segunda entrada de la lista", y luego las asignamos como la primera de la lista. Por lo tanto, la primera aparición debe ser filtrada.
Consulta final terrible
CON RECURSIÓN T COMO (
  -- #1: añadimos a la lista los registros "primeros" por cada una de las claves del conjunto
  CON wrap COMO ( -- "materializamos" los registros, para que el acceso a los campos no cause multiplicación de InitPlan/SubPlan
    CON T COMO (
      SELECCIONAR
        (
          SELECCIONAR
            r
          DE
            tarea r
          DONDE
            owner_id = unnest
          ORDENAR POR
            task_date, id
          LÍMITE 1
        ) r
      DE
        unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
    )
    SELECCIONAR
      array_agg(r ORDENAR POR (r).task_date, (r).id) lista -- ordenamos la lista en el orden deseado
    DE
      T
  )
  SELECCIONAR
    lista
  , lista[1] rv
  , FALSE not_cross
  , 0 tamaño
  DE
    wrap
UNIÓN TODO
  -- #2: leemos los registros de la primera clave por orden, hasta que superemos el registro de la segunda
  SELECCIONAR
    CASO
      -- si no se encuentra nada para la clave del primer registro
      CUANDO X._r NO ES DISTINTO DE NULL ENTONCES
        T.lista[2:] -- lo eliminamos de la lista
      -- si NO hemos cruzado la clave de aplicación del segundo registro
      CUANDO X.not_cross ENTONCES
        T.lista -- simplemente extendemos la misma lista sin modificaciones
      -- si ya no hay ningún segundo registro en la lista
      CUANDO T.lista[2] ES NULL ENTONCES
        -- simplemente devolvemos una lista vacía
        '{}'
      -- reorganizamos el diccionario, eliminando el primer registro y añadiendo el último encontrado
      OTRA:
        SELECCIONAR
          coalesce(T.lista[2] || array_agg(r ORDENAR POR (r).task_date, (r).id), '{}')
        DE
          unnest(T.lista[3:] || X._r) r
      FIN
  , X._r
  , X.not_cross
  , T.tamaño + X.not_cross::integer
  DE
    T
  , LATERAL(
      CON wrap COMO ( -- "materializamos" el registro
        SELECCIONAR
          CASO
            -- si de hecho hemos "cruzado" el segundo registro
            CUANDO NO T.not_cross
              -- entonces el registro necesario es el primero de la lista
              ENTONCES T.lista[1]
            OTRA ( -- si no hemos cruzado, entonces la clave permanece como en el registro anterior - nos basamos en él
              SELECCIONAR
                _r
              DE
                tarea _r
              DONDE
                owner_id = (rv).owner_id Y
                (task_date, id) > ((rv).task_date, (rv).id)
              ORDENAR POR
                task_date, id
              LÍMITE 1
            )
          FIN _r
      )
      SELECCIONAR
        _r
      , CASO
          -- si ya no hay un segundo registro en la lista, pero encontramos algo
          CUANDO lista[2] ES NULL Y _r NO ES DISTINTO DE NULL ENTONCES
            VERDADERO
          OTRA -- no encontramos nada o "cruzamos"
            coalesce(((_r).task_date, (_r).id) < ((lista[2]).task_date, (lista[2]).id), FALSE)
        FIN not_cross
      DE
        wrap
    ) X
  DONDE
    T.tamaño < 20 Y -- limitamos aquí la cantidad
    T.lista NO ES DISTINTO DE '{}' -- o mientras la lista no se acabe
)
-- #3: "desplegamos" los registros - el orden está garantizado por la construcción
SELECCIONAR
  (rv).*
DE
  T
DÓNDE
not_cross; -- tomamos solo los registros "no cruzados" 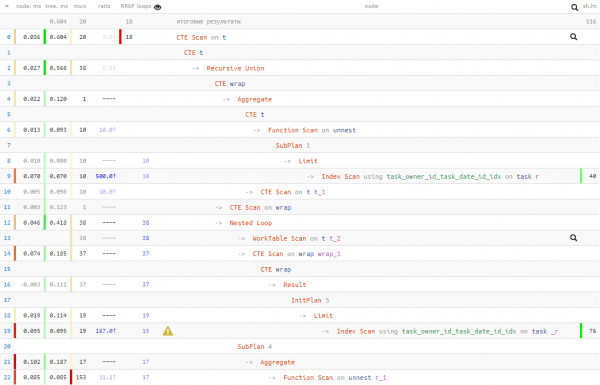
Por lo tanto, cambiamos el 50% de lecturas de datos por un 20% en tiempo de ejecuciónEs decir, si tienes razones para creer que la lectura puede ser larga (por ejemplo, los datos a menudo no están en caché y es necesario recuperarlos del disco), entonces de esta manera se puede depender menos de la lectura.
En cualquier caso, el tiempo de ejecución resultó mejor que en la primera versión 'naïve'. Pero cuál de estas 3 opciones utilizar, depende de ti.
Fuente: habr.com
