

A nuestro equipo le encantan los experimentos. Cada Slurm no es una repetición estática de los anteriores, sino una reflexión sobre la experiencia y un paso del bueno al mejor. Pero con , decidimos aplicar un formato completamente nuevo: proporcionar a los participantes condiciones lo más cercanas posibles a un entorno real.
Si resumimos brevemente lo que estuvimos haciendo en el intensivo: "Construimos, rompemos, arreglamos,
estudiamos". SRE no tiene mucho sentido en teoría pura; solo la práctica, soluciones reales y problemas reales.
Los participantes se dividieron en equipos para que un espíritu competitivo animado no dejara que nadie se durmiera o abriera "Angry Birds" en el iPhone como Dmitry Anatolyevich.
Los problemas, errores, fallos y tareas fueron proporcionados a los participantes por cuatro mentores. Ivan Kruglov, Desarrollador Principal en Booking.com (Países Bajos). Ben Tyler, Desarrollador Principal en Booking.com (EE. UU.). Eduard Medvedev, CTO en Tungsten Labs (Alemania). Evgeny Varava, desarrollador de amplio perfil en Google (San Francisco).
Y además, los participantes se dividieron en equipos y compiten entre sí. ¿Interesante?
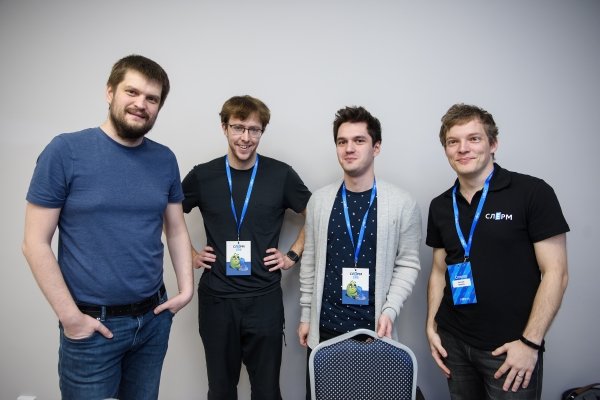
Ivan, Ben, Eduard y Evgeny miran con una mirada benigna de Lenin a los desafortunados participantes de Slurm SRE antes del comienzo de la competencia.
Así que la tarea es:
Nosotros, construiremos un nuevo mundo...
Hay un sitio agregador de boletos para el cine. Los incidentes son ideados por los mentores en un guion previamente elaborado (aunque nadie descarta una improvisación especialmente elaborada y astuta), la operatividad del sitio se describe con diversas métricas. Los problemas pueden ser muy variados: los boletos para el teatro "Moulin Rouge" no se cargan en la base; los carteles de las películas y espectáculos tardan más de 10 segundos en cargar en la base; la descripción de una película se congela; el 0,1% de los pedidos llega a ubicaciones ya reservadas; ocasionalmente, el sistema de procesamiento de pagos se cae durante uno o dos minutos. Y muchas, muchas, muchas cosas molestas que pueden caer sobre un participante de Slurm SRE en su trabajo real.
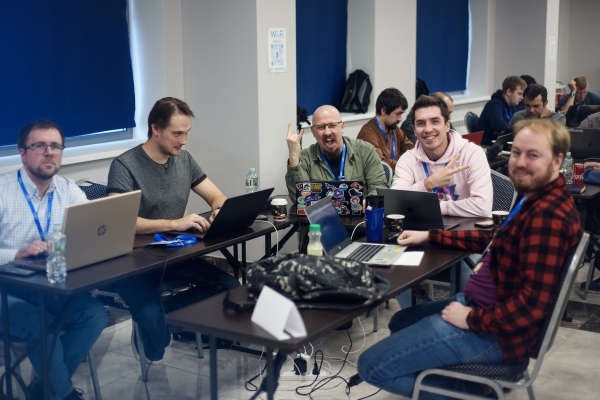
Estamos listos para enfrentar todo... y a todos.
Nuestro sufrido sitio web está compuesto por varios microservicios. Su tarea es agregar datos sobre sesiones, precios y disponibilidad de todos los cines, muestra tráileres de películas, permite elegir cine, sesión, sala y asiento, así como reservar y pagar entradas. En resumen, todo lo que un espectador podría soñar. Sin embargo, el usuario ni siquiera se imagina la titánica lucha por la estabilidad y disponibilidad del sitio que se libra en su interior.
Para el sitio en el intensivo, hemos establecido métricas SLO, SLI, SLA, desarrollado la arquitectura y la infraestructura, desplegado el sitio, y configurado la monitorización y las alertas. Y así comenzó.
SLO, SLI, SLA
SLI — indicadores de nivel de servicio. SLO — objetivos de nivel de servicio. SLA — acuerdos de nivel de servicio.
SLA — término de la metodología ITIL, que designa un contrato formal entre el cliente del servicio y su proveedor, que incluye una descripción del servicio, derechos y deberes de las partes y, lo más importante, el nivel de calidad acordado para la prestación de dicho servicio.
SLO — es un objetivo de nivel de servicio: un valor objetivo o rango de valores para el nivel de servicio, que se mide mediante SLI. El valor normal para SLO es "SLI ≤ valor objetivo" o "límite inferior ≤ SLI ≤ límite superior".
SLI es un indicador de nivel de servicio — una medida cuantitativa cuidadosamente definida de uno de los aspectos del nivel de servicio proporcionado. Para la mayoría de los servicios, el SLI clave se considera el tiempo de respuesta: cuánto tiempo se necesita para devolver la respuesta a una solicitud. Otros SLI comunes incluyen la tasa de errores, a menudo expresada como la proporción de todas las solicitudes recibidas, y el rendimiento del sistema, normalmente medido en solicitudes por segundo.
Primero romperemos aviones, y luego a las chicas, a las chicas después...
Factores internos y externos comenzaron a "estropear" el SLO desde los primeros minutos. Los administradores fueron bombardeados con todo: errores de los desarrolladores, fallos de infraestructura, un aumento en el número de visitantes y ataques DDoS. Todo lo que deteriora el SLO.
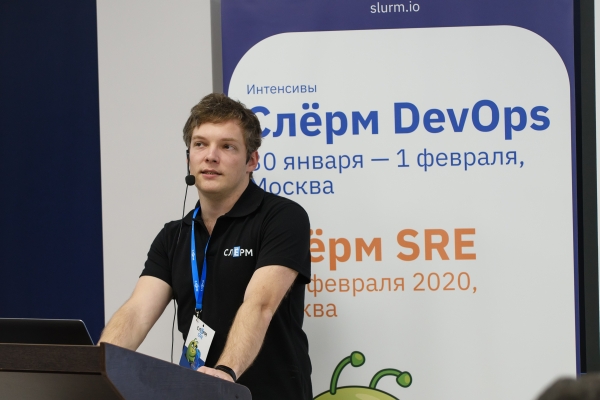
"- Queridos participantes, me apresuro a alegrarles, lo primero que se caerá es... ¡todo!"
A lo largo del camino, los ponentes discutieron la resiliencia, el presupuesto de errores, las prácticas de prueba, la gestión de interrupciones y la carga operativa.
No somos fogoneros ni carpinteros...
Aquí los participantes comenzaron a arreglar, lo principal es entender por dónde empezar primero.
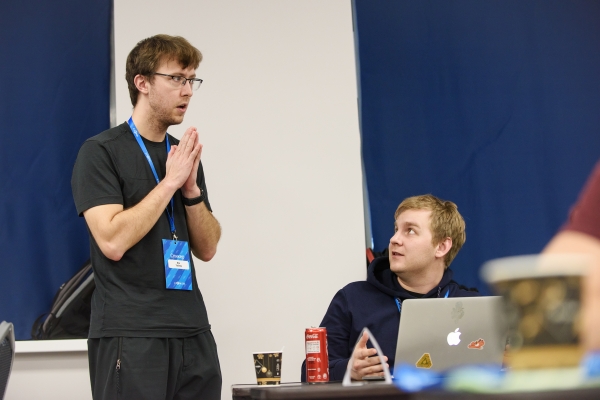
«¡Dios mío, nunca he visto algo romperse así, en esta forma y en esta posición!»
Así que ocurrió un accidente. El servicio de procesamiento de pagos se cayó. ¿Cómo actuar para restaurar la operatividad en el menor tiempo posible?
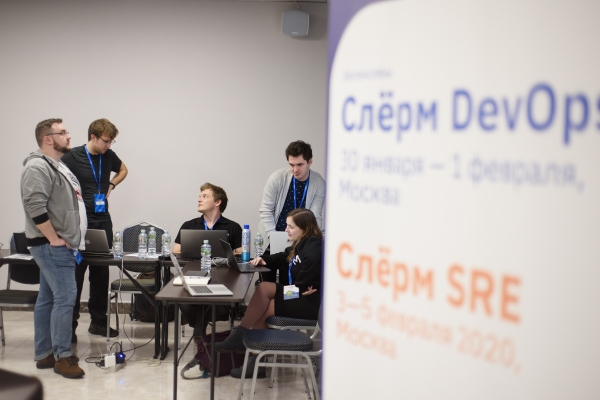
Los expertos, mirando con ternura a los participantes, preparan otra trampa.
Cada equipo organiza el trabajo del grupo para eliminar el accidente: involucra a colegas, notifica a los interesados (stakeholders). A la vez, se establecen prioridades. Así, los participantes practicaron trabajar bajo presión en condiciones de tiempo extremadamente limitado.
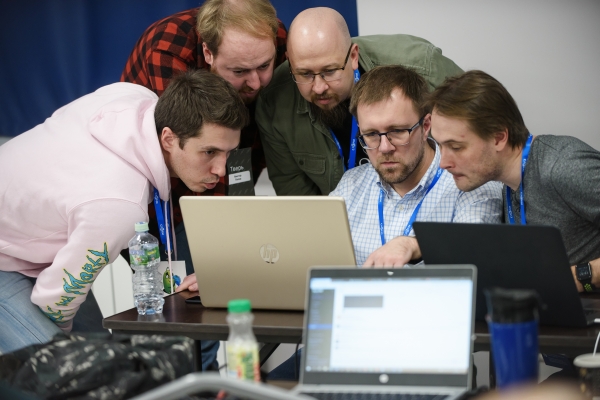
«¿¡Qué horror es este!?»
Soplaron… y terminaron el ejercicio.
Junto con los ponentes, después de cada problema resuelto y del sitio temporalmente estabilizado, los equipos estudiaron los incidentes desde la perspectiva de SRE. Analizaron detalladamente los problemas: las causas de su aparición y el proceso de resolución. Después, tanto a nivel de equipo como colectivamente, tomaron decisiones sobre su prevención futura: cómo mejorar la supervisión, cómo cambiar acertadamente la arquitectura, cómo corregir el enfoque de desarrollo y operación, cómo ajustar los reglamentos. Los ponentes demostraron la práctica de realizar un análisis post-mortem.
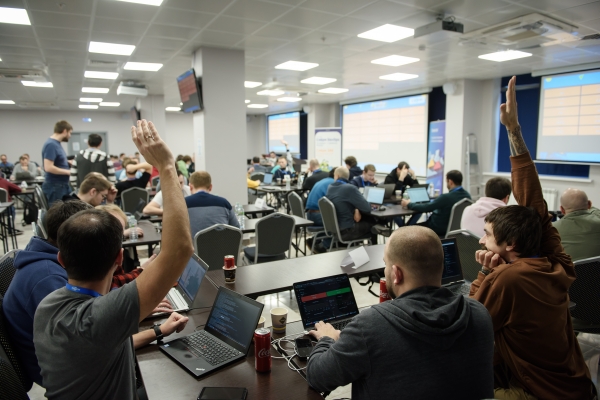
«¡¿Quién más quiere sufrir?! — ¡Yo!»
En el tablero electrónico se registraban con precisión y claridad los éxitos de los equipos.
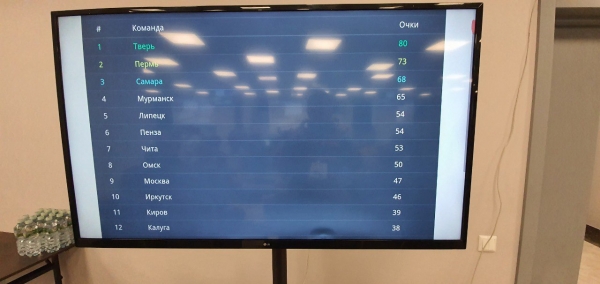
Por los primeros lugares, hay un premio de los stakeholders.
Fuente: habr.com
